

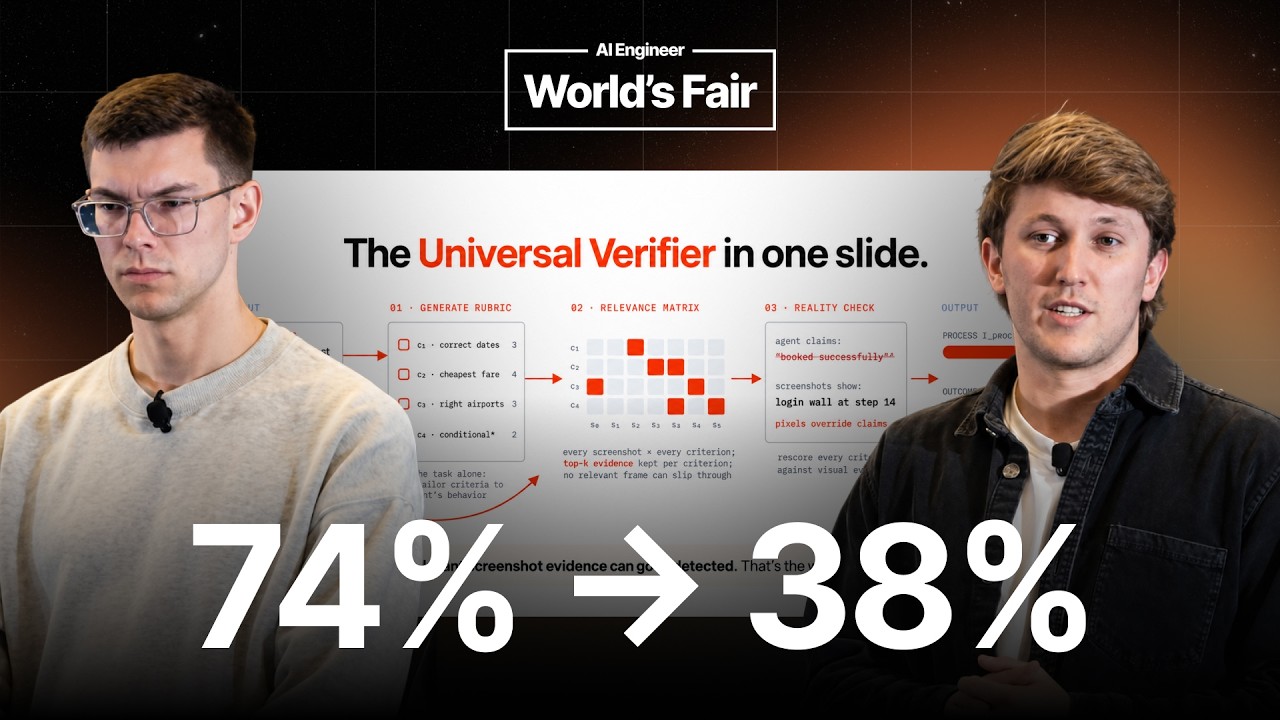
LLM Judge ให้ผ่าน แต่งานอาจยังไม่สำเร็จ: บทเรียนจาก Universal Verifier
กรณี Fara-7B แสดงให้เห็นว่าตัวตรวจเปลี่ยนภาพความสำเร็จของ AI ได้อย่างไร พร้อมหลักการของ Universal Verifier ที่จับคู่เกณฑ์กับหลักฐานและแยกคะแนนกระบวนการจากผลลัพธ์
ลงมือประกอบ ทดลอง และแก้ปัญหาสินค้า แอป ชิ้นงาน เอเยนต์ และ workflow รวมการติดตั้ง เชื่อมระบบ ออกแบบ context/evaluation และทำต้นแบบ
กรณี Fara-7B แสดงให้เห็นว่าตัวตรวจเปลี่ยนภาพความสำเร็จของ AI ได้อย่างไร พร้อมหลักการของ Universal Verifier ที่จับคู่เกณฑ์กับหลักฐานและแยกคะแนนกระบวนการจากผลลัพธ์
เรียนรู้จากเดโม Claude ที่ทำหน้าเว็บ สไลด์ และเอกสารในบทสนทนาเดียว ตั้งแต่เขียนโจทย์ให้ตรงผู้รับสาร ไปจนถึงตรวจช่องรอเติมข้อมูลและร่างก่อนส่งจริง
คลิป Ling 3.1 Flash เสนอ 5 งานสำหรับทีมเล็ก ตั้งแต่ศึกษาคู่แข่ง ร่างหน้าขาย ตอบผู้สนใจ วางแผน 30 วัน และสรุปประชุม พร้อมจุดที่ต้องตรวจเอง
สำรวจเดโม StarNet ตั้งแต่บทบาทของ agent ไปจนถึงความจำและจุดรออนุมัติ พร้อมแนวทางทดลองทีมเล็กก่อนขยายงาน และข้อจำกัดของคำว่าฟรี
บทเรียนจาก Willem Pienaar แห่ง Cleric: แยกอาการจากต้นเหตุ ตรวจหลายสมมติฐานกับค่าปกติของระบบ และวัดผลหลังแก้ก่อนเชื่อคะแนนความมั่นใจของ AI
อ่านสถาปัตยกรรม Joey จากสไลด์ของ AssemblyAI ทั้งเอกสาร Markdown การค้นสองระดับ และวงจรแก้ไข พร้อมข้อจำกัดของผลปิดเคส 80% ที่บริษัทนำเสนอ
บทเรียนจาก Nick Nisi และ Zack Proser เรื่องการสั่งงานด้วยเสียง จัดการหลายเอเจนต์ แยก Goal กับ Loop และตรวจผลงานจริงก่อนตั้งเวลาอัตโนมัติ
อ่านสามสถานการณ์จากเดโม OpenAI: checkout ผิดพลาดหลังอัปเดต คอนเทนเนอร์ OOM และคำขอรายงานแย่งทรัพยากร พร้อมแยกผลที่แสดงจริงจากแนวคิดอัตโนมัติ


