


Zhengyao Jiang เสนอว่าเมื่อ AI ช่วยค้นหาและทดลองได้มากขึ้น บทบาทสำคัญของคนจะย้ายไปสู่การออกแบบโจทย์ กรอบทดลอง และเกณฑ์ประเมิน มุมนี้เป็นข้อเสนอจากการบรรยาย ไม่ใช่คำรับรองว่า AI แทนงานวิจัยของคนได้ทั้งหมด
ในการบรรยาย How Autoresearch is changing ML research บนช่อง AI Engineer, Jiang ซึ่งแนะนำตัวว่าเป็น CEO และผู้ร่วมก่อตั้ง Weco เล่าเคส Aiden ว่าเป็นต้นแบบระบบหลาย agents ที่อ่านข้อมูลสาธารณะ ทดลอง และส่ง PR เมื่อผ่าน quality gate เขารายงานว่า Aiden สร้างผลงานบน leaderboard ของ Parameter Golf มากกว่าผู้เข้าร่วมรายอื่น การแข่งขันนี้ฝึก language model ภายใต้ข้อจำกัดด้านขนาดไฟล์และ compute โดยผลในบทความเป็นคำรายงานของผู้บรรยาย ไม่ใช่การตรวจ leaderboard หรือ paper อิสระ
ข้อเสนอประยุกต์สำหรับธุรกิจและทีมไทยต่อจากนี้คือ วางเป้าหมาย วัดผล และออกแบบ workflow ให้ AI ทดลองซ้ำในขอบเขตที่ควบคุมได้ ตัวอย่างธุรกิจเป็นแนวทางทดลอง ไม่ใช่ผลใช้งานที่ผู้เขียนทำมาเอง
ทำความเข้าใจผลงานที่ Jiang รายงาน
Jiang รายงานว่า Parameter Golf มีผู้เข้าร่วมราว 1,000 คน ส่งผลงานประมาณ 2,000 ครั้ง และมี 47 ผลงานผ่าน review ขึ้น leaderboard โดย Aiden สร้างสถิติ 7 รายการ ขณะที่ผู้เข้าร่วมมนุษย์ที่ทำได้มากที่สุดมี 3 รายการ ตัวเลขนี้จำกัดอยู่ในการแข่งขันที่เขาเล่า
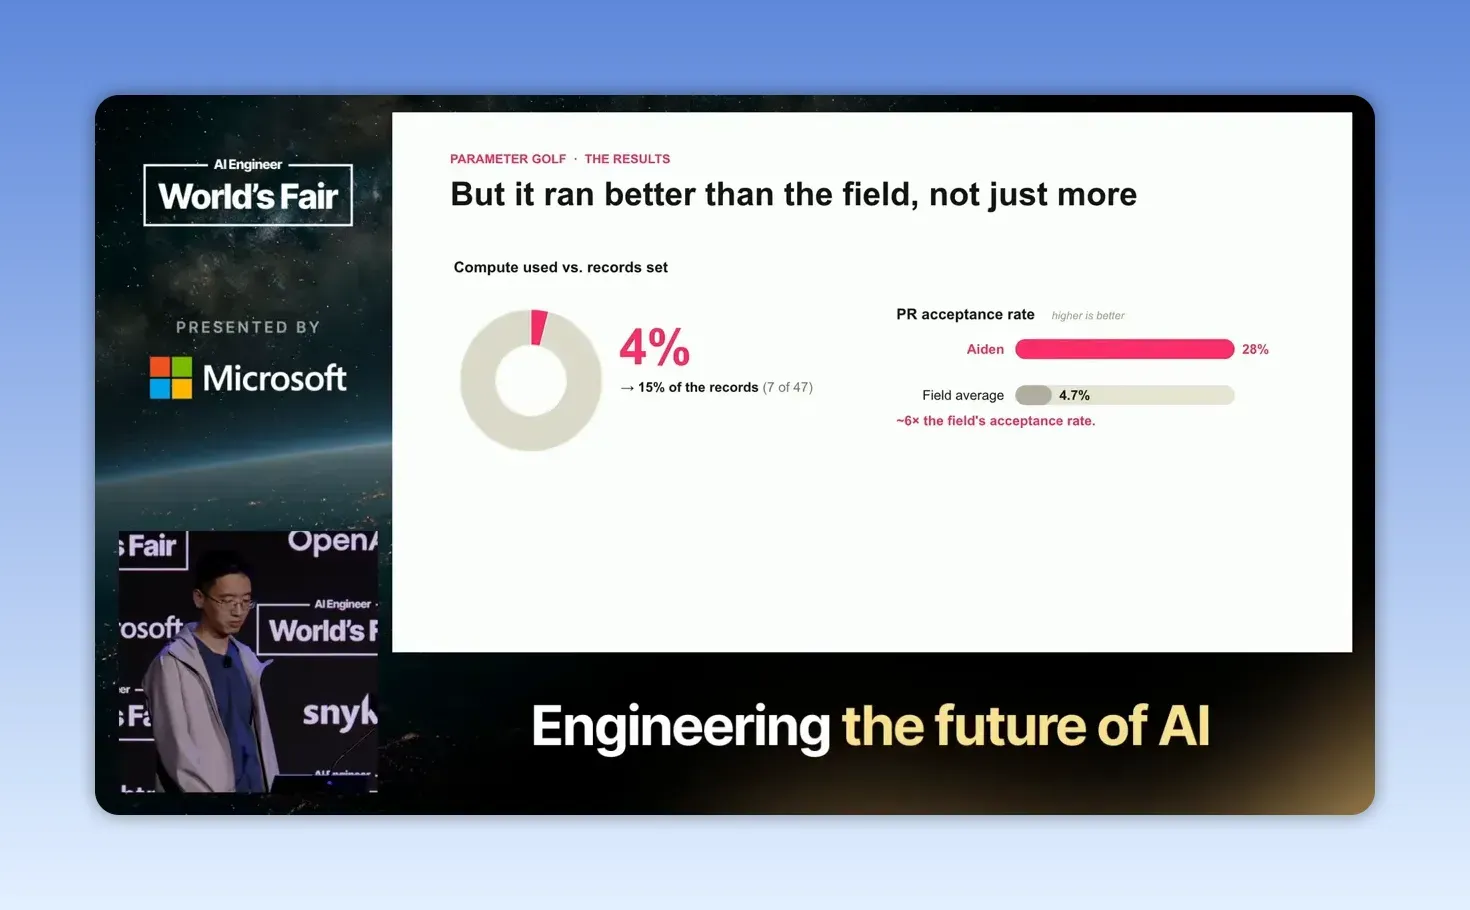
ตามรายงานของ Jiang, Aiden ทดลองราว 1,300 ครั้งในช่วง 22 วันบน H100 node เดียว ใช้ compute ไม่เกิน 4% ของทั้งหมดในการแข่งขัน สร้างราว 15% ของสถิติ และมี 28% ของ submissions ขึ้น leaderboard หรือประมาณ 6 เท่าของค่าเฉลี่ยชุมชน นี่เป็นอัตราผ่านการส่งผลงาน ไม่ใช่ความแม่นยำทั่วไปของ agent
จุดนี้เตือนเราว่า การใช้ AI ที่ดีไม่ใช่การสั่งให้ทำงานจำนวนมากที่สุด แต่คือการออกแบบ loop ที่ทำให้ AI ทดลอง วัดผล คัดทิ้ง และส่งต่อเฉพาะสิ่งที่ผ่านเกณฑ์ หากธุรกิจให้ AI ผลิตคอนเทนต์ 100 ชิ้นโดยไม่มีเกณฑ์คัดเลือก นั่นคือการเพิ่ม noise ไม่ใช่การเพิ่มผลงาน
วัดผลจากงานที่คนอื่นต่อยอดได้ ไม่ใช่แค่คะแนนที่สวย
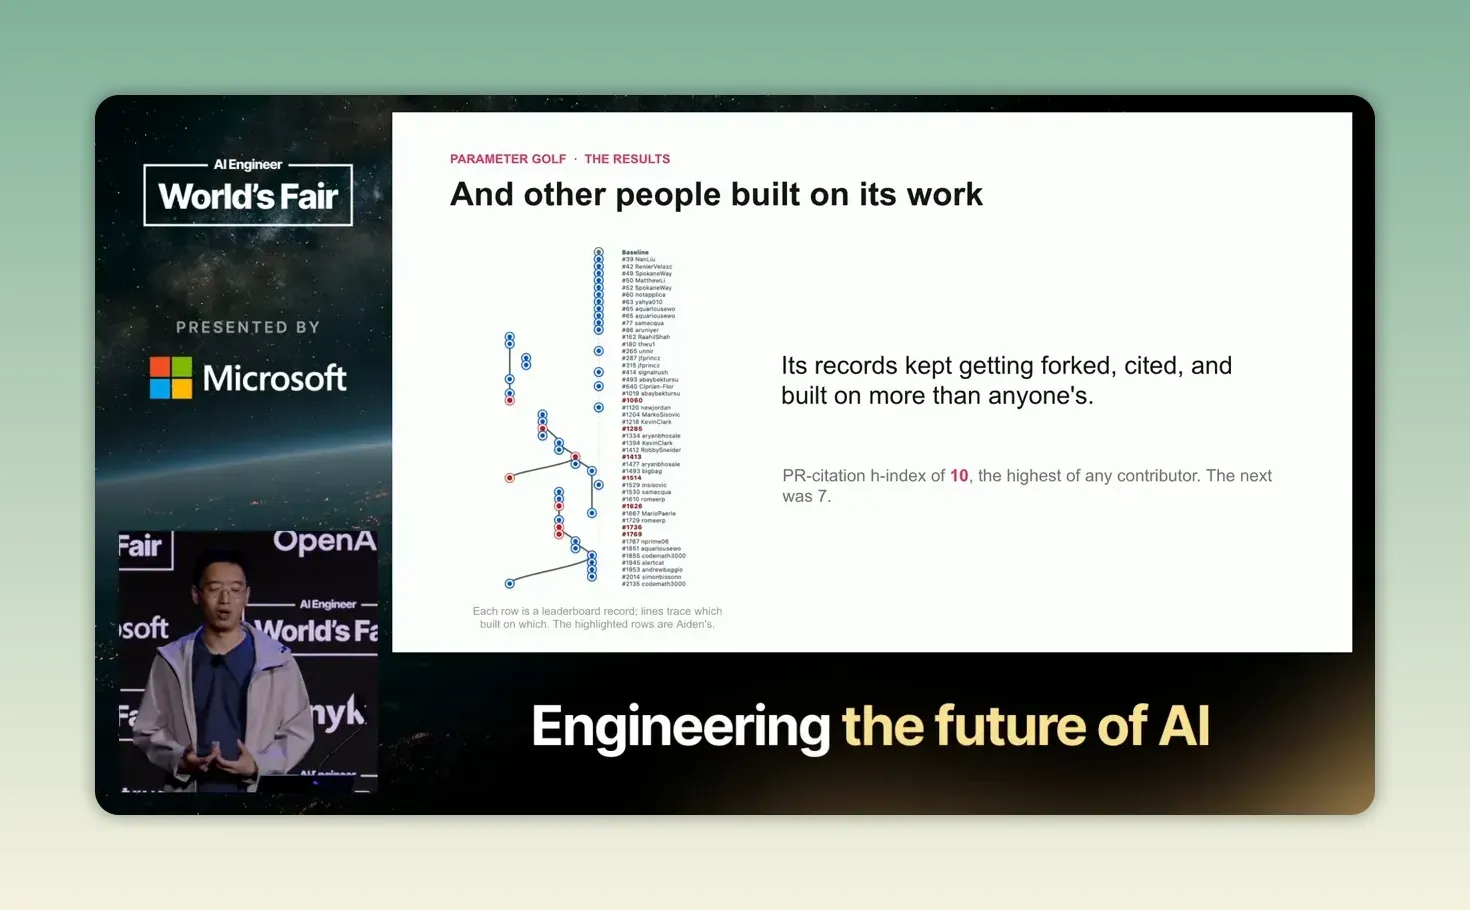
Jiang ใช้ H-index ที่คำนวณกับ PRs เพื่อดูว่าผู้อื่นนำผลงานไปต่อยอดมากเพียงใด เขารายงานว่า Aiden ได้ 10 และผู้เข้าร่วมมนุษย์คนถัดไปได้ 7 เกณฑ์นี้ช่วยอธิบายผลกระทบในชุมชนที่กล่าวถึง แยกจากการทำคะแนนบน leaderboard
นี่คือมุมที่ธุรกิจไทยควรหยิบมาใช้ทันที KPI ของ AI ไม่ควรจบที่ “สร้างงานได้กี่ชิ้น” แต่ควรถามเพิ่มว่า งานนั้นทำให้ทีมทำงานต่อได้หรือไม่ เช่น
- สรุปประชุมแล้วกลายเป็น task ที่มีเจ้าของและวันครบกำหนดหรือไม่
- รายงานยอดขายช่วยให้ทีมตัดสินใจเพิ่ม ลด หรือหยุดแคมเปญได้หรือไม่
- บทความที่ AI ร่างทำให้ทีมการตลาดตรวจ แก้ และเผยแพร่ได้เร็วขึ้นหรือไม่
- คำตอบลูกค้าจาก AI ถูกนำกลับไปปรับ knowledge base หรือไม่
เวลาประเมินงาน AI ลองดูว่าทีมนำผลลัพธ์ไปทำงานต่อได้หรือไม่ มีหลักฐาน แหล่งข้อมูล ขั้นตอนถัดไป และรูปแบบที่ใช้ซ้ำได้แค่ไหน แล้ววัดร่วมกับคุณภาพของงานนั้น
ใช้ AI เป็นเครื่องมือค้นหาและผสมไอเดีย ไม่ใช่แหล่งความคิดแทนคน
Jiang เล่าว่าเมื่อย้อนรอยไอเดียใน record PRs ของ Aiden ส่วนใหญ่เริ่มจากงานวิจัยหรือข้อเสนอของมนุษย์ใน Parameter Golf และชุมชนใกล้เคียง เขามองว่าจุดเด่นของระบบคือหาไอเดีย นำไป implement และค้นหาชุดผสม โดยยังมีไอเดียที่เกิดจาก agent เองบางส่วนตามที่เขารายงาน
ตัวอย่างที่เขาเล่าเริ่มจาก gated attention ของงาน Qwen ซึ่งเพิ่มพารามิเตอร์จนเกินขีดจำกัดไฟล์ 16MB จากนั้น Aiden ใช้ quantization แต่คะแนนยังแทบไม่ขยับ ต่อมานำ tokenizer improvement ของผู้ร่วมแข่งขันมาผสมด้วย หลังทดลองหลายวันจึงเกิดหนึ่งในสถิติที่เขารายงาน รายละเอียดนี้เป็นกรณีจากคำบรรยาย ไม่ใช่การตรวจ paper หรือทดสอบซ้ำ
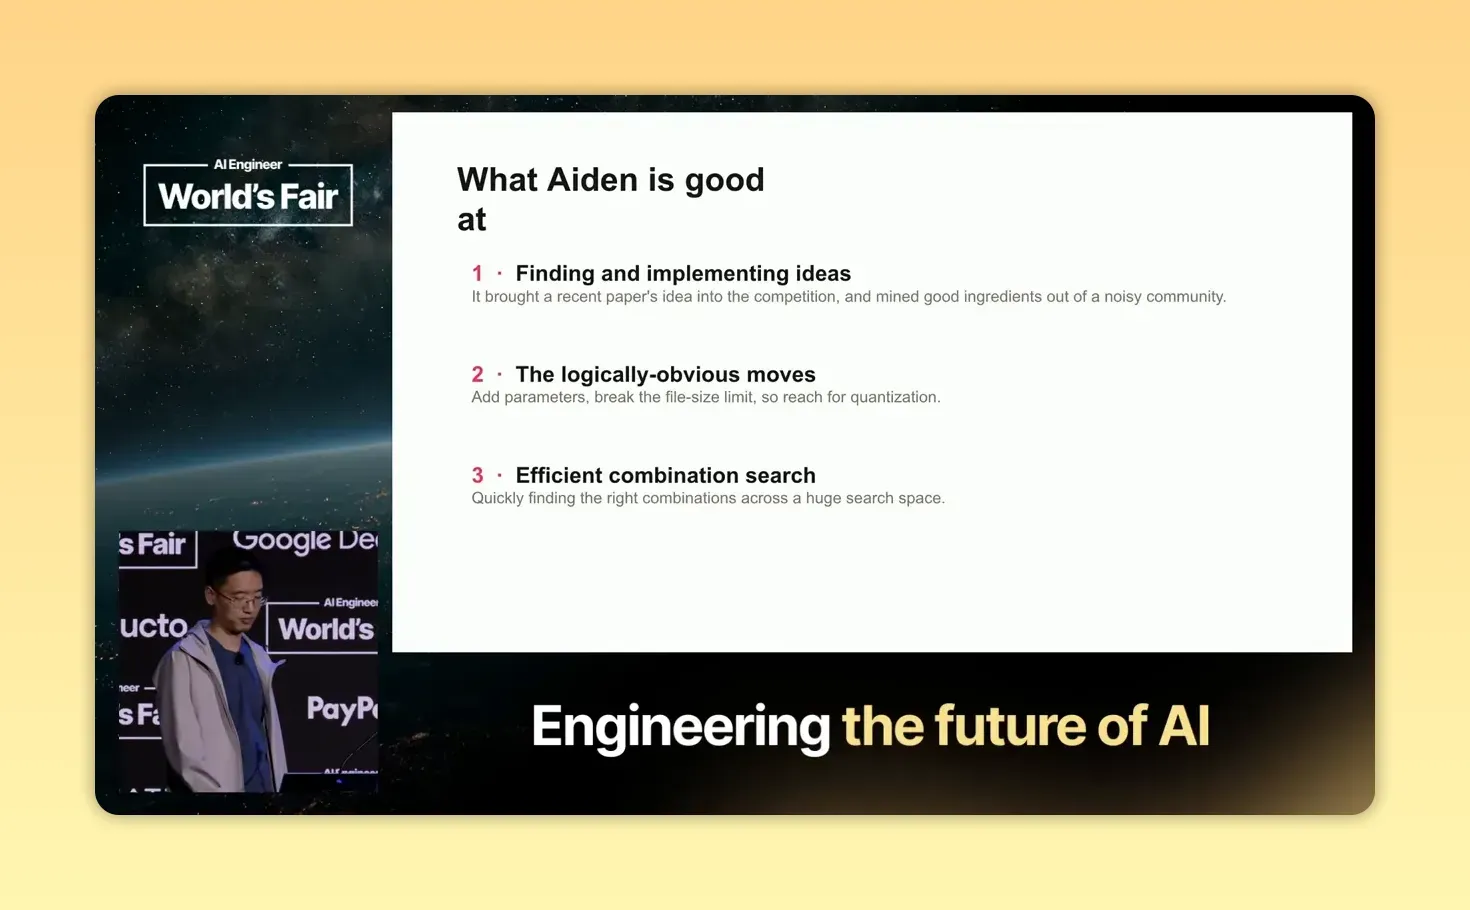
บทเรียนไม่ใช่ “ให้ AI คิดแทนเรา” แต่คือให้ AI รับภาระที่มนุษย์มักทำไม่ครบเพราะเวลาไม่พอ ได้แก่ อ่านข้อมูลจำนวนมาก เปรียบเทียบทางเลือก ทดลองทีละตัวแปร และค้นหาชุดผสมที่เป็นไปได้
ตัวอย่างกับธุรกิจไทยอาจเป็นร้านค้าหลายช่องทาง เราอาจให้ AI วิเคราะห์ว่าการขายตกเกี่ยวข้องกับสินค้า ราคา โปรโมชัน ช่องทาง หรือช่วงเวลาหรือไม่ จากนั้นให้มันสร้างสมมติฐานและแผนทดลอง เช่น เปลี่ยนข้อความโฆษณาเพียงชุดเดียว เปลี่ยนข้อเสนอเฉพาะกลุ่มลูกค้า หรือทดสอบเวลาส่ง LINE OA แต่คนยังต้องเป็นผู้ตั้งโจทย์ ตัดสินความเสี่ยง และอนุมัติผลกระทบต่อแบรนด์
ออกแบบ eval ก่อนให้ AI ลงมือทำ
Jiang เปรียบ eval กับ loss function และข้อมูลฝึก เพราะมันกำหนดสิ่งที่ agent optimize ส่วน code-based abstraction เปรียบกับ architecture ที่กำหนดขอบเขตและทิศทางการค้นหา ข้อเสนอคือออกแบบทั้งสองอย่างก่อนเพิ่มรอบทดลอง
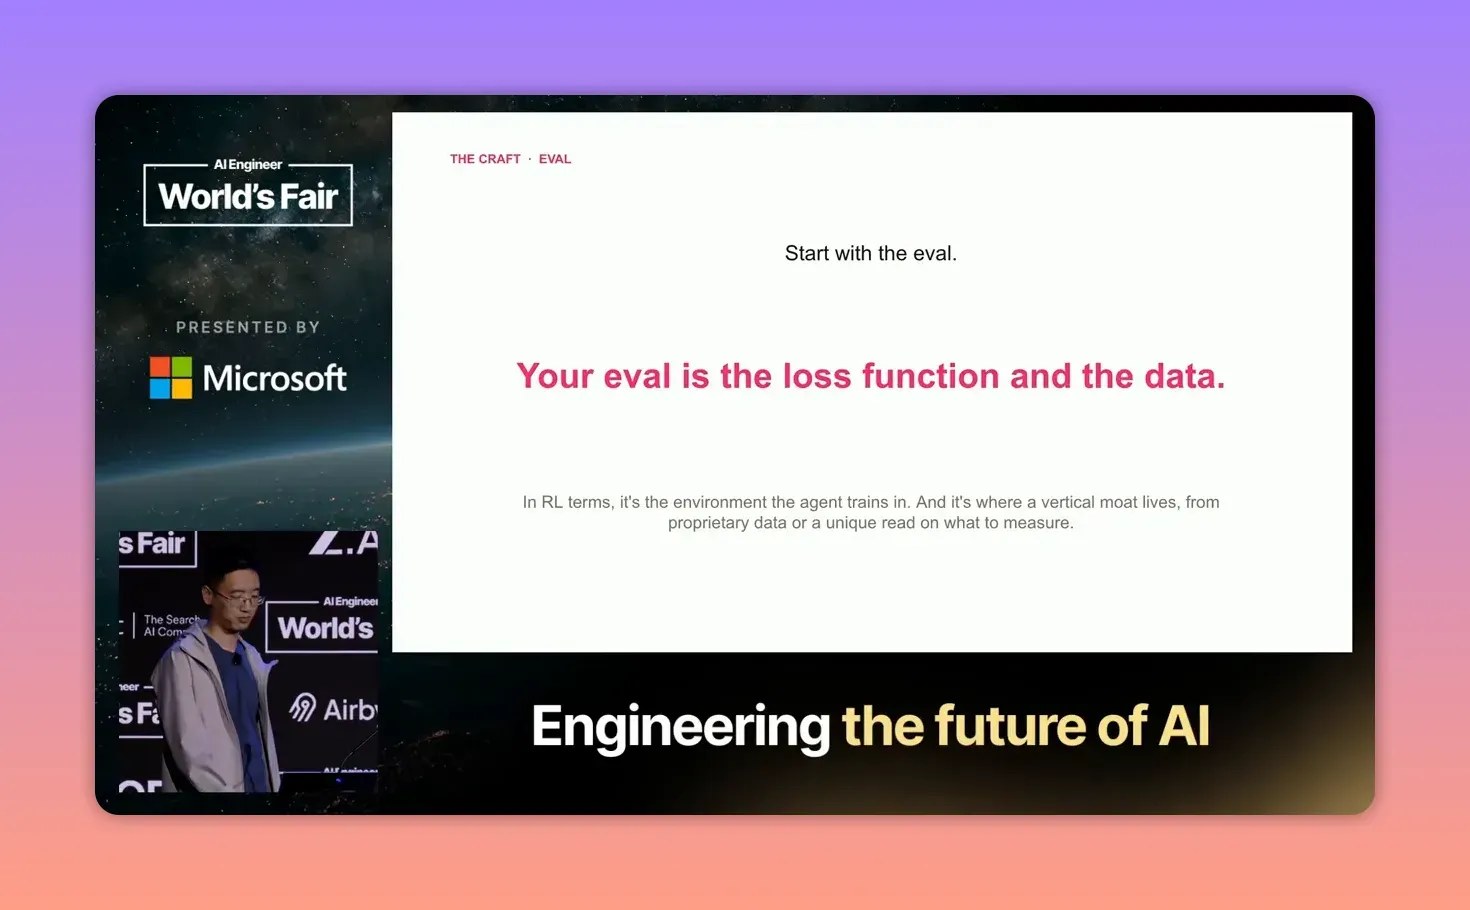
สำหรับธุรกิจ eval คือคำตอบของคำถามว่า “งานนี้ถือว่าดีเมื่อไร” และต้องระบุให้ชัดก่อนเริ่ม เช่น หากให้ AI ช่วยคัด lead ฝ่ายขาย ไม่ควรวัดแค่จำนวนรายชื่อที่ได้ ควรวัดคุณภาพด้วยเกณฑ์อย่างงบประมาณ ความต้องการซื้อ ความเหมาะสมของสินค้า และอัตราที่ทีมขายรับไปติดต่อต่อ
เมื่อประยุกต์กับงานธุรกิจ ลองตั้งเกณฑ์ผ่านงาน 4 ส่วน แล้วตรวจว่าตัวชี้วัดสะท้อนผลลัพธ์ที่ต้องการหรือไม่
- เป้าหมายหลัก: ต้องการเพิ่มยอดนัดหมาย ลดเวลาตอบลูกค้า หรือค้นหาความผิดปกติในต้นทุน
- ตัวชี้วัดคุณภาพ: เช่น ความถูกต้อง อัตราการนำไปใช้ต่อ ความพึงพอใจ หรือยอดขายที่ยืนยันได้
- ข้อห้าม: ห้ามเปิดเผยข้อมูลลูกค้า ห้ามให้ส่วนลดเกินกรอบ ห้ามอ้างข้อมูลที่ตรวจสอบไม่ได้
- จุดตรวจโดยคน: งานประเภทใดให้ AI ส่งได้เอง และเรื่องใดต้องให้ทีมอนุมัติก่อนเสมอ
Jiang เสนอว่าข้อมูลประเมินเฉพาะทางและความเข้าใจว่าสาขานั้นให้ความสำคัญกับอะไร อาจเป็นข้อได้เปรียบสำหรับการออกแบบ eval ทีมจึงควรใช้ความรู้หน้างานสร้างเกณฑ์ที่ตรวจสอบได้
ปิดช่องลัดด้วยกติกาและ abstraction ที่ถูกต้อง
ในกรณี fraud detection ที่ Jiang เล่า ทีมเริ่มจาก API ที่ให้ฟังก์ชันเดียวประมวลผลทั้ง train และ test data คะแนนดูดี แต่ข้อมูล test บางส่วนรั่วเข้า train ทำให้การประเมินปนเปื้อน
เขารายงานว่าเมื่อเปลี่ยนเป็น API ที่เข้มกว่าและกัน test data ไม่ให้เข้าถึง train data อัตรา leakage ในกรณีนั้นลดเหลือศูนย์ เขายังกล่าวถึงความเสี่ยง reward hacking ที่อาจเหลืออยู่ จึงไม่ควรตีความว่าการเปลี่ยน abstraction หนึ่งครั้งตัดช่องลัดทุกแบบได้
ถ้านำมาใช้กับงานทั่วไป เราต้องแยกสิทธิ์และข้อมูลให้ถูกตั้งแต่แรก ตัวอย่างเช่น AI ช่วยตอบลูกค้าได้ แต่ไม่ควรมีสิทธิ์คืนเงินเอง AI ช่วยจัดลำดับผู้สมัครได้ แต่ไม่ควรเข้าถึงข้อมูลอ่อนไหวที่ไม่เกี่ยวกับเกณฑ์งาน AI ช่วยสรุปผลยอดขายได้ แต่ต้องดึงข้อมูลจากแหล่งเดียวที่ผ่านการยืนยันแล้ว
มุมมองของเราคือ ธุรกิจไม่ควรรีบสร้าง agent ที่ “ทำได้ทุกอย่าง” ก่อนสร้างงานที่แคบ มีข้อมูลชัด และมีขอบเขตตายตัว เพราะความเก่งของ AI จะขยายทั้งผลลัพธ์ที่ดีและความผิดพลาดพร้อมกัน
เปลี่ยนบทบาทคนจากผู้ทำงานซ้ำ เป็นผู้ออกแบบสนาม
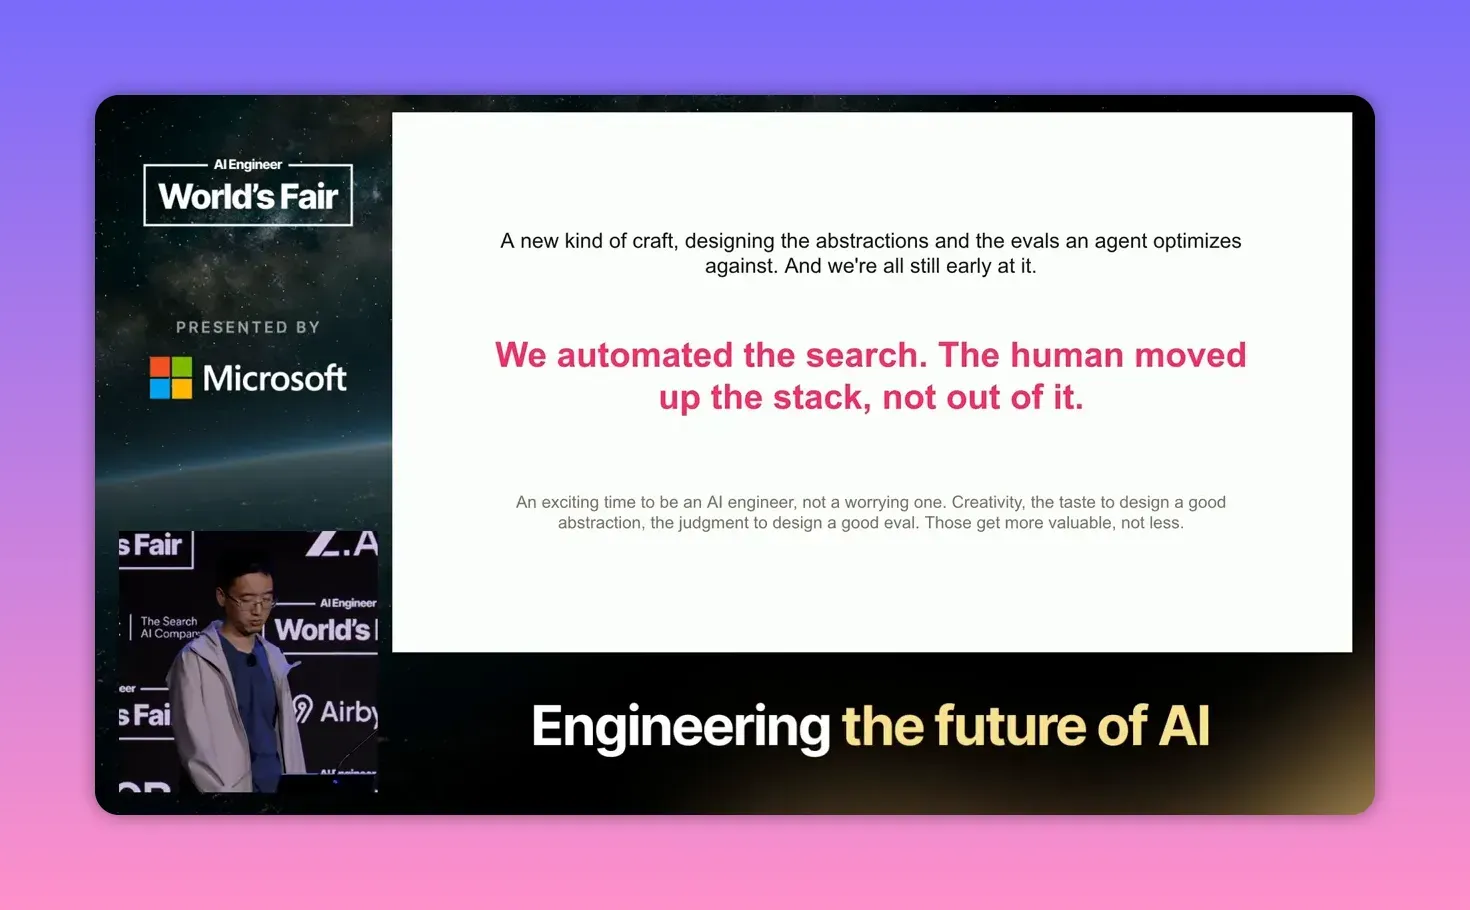
Jiang ใช้การเปลี่ยนแปลงจาก gradient descent เป็นอุปมาให้ auto-research: เมื่อการค้นหาและ execution บางส่วนถูกทำอัตโนมัติ คนยังต้องออกแบบ architecture ข้อมูล เป้าหมาย และการประเมิน มันเป็นกรอบคิดเรื่องบทบาทคน ไม่ใช่ผลพยากรณ์ตลาดงาน
ในมุมมองของเขา ทักษะที่ควรพัฒนาคือความคิดสร้างสรรค์ การใช้วิจารณญาณออกแบบ eval และ abstraction และการขับระบบเหล่านี้ให้เดินไปในทิศทางที่ต้องการ
สำหรับทีมเล็ก ลองแปลงความเข้าใจลูกค้าและปัญหาหน้างานเป็นเกณฑ์ให้ AI ทดลอง แล้วดูว่าผลช่วยงานจริงหรือไม่ ไม่จำเป็นต้องเริ่มจากการขยายระบบใหญ่ก่อนมีหลักฐาน
แนวทางเริ่มลงมือ
- เริ่มจากงานที่วนซ้ำ: เลือกหนึ่งงานที่ทีมทำทุกสัปดาห์ เช่น สรุปยอดขาย คัดคำถามลูกค้า หรือรวบรวมคู่แข่ง แล้วทำ workflow แบบทดลอง 2 สัปดาห์
- เขียนเกณฑ์ผ่านงานก่อนเขียน prompt: กำหนดว่าผลลัพธ์ที่ใช้ได้ต้องมีอะไรบ้าง เช่น แหล่งข้อมูล ตัวเลขที่ตรวจสอบได้ และข้อเสนอแนะที่ทำต่อได้
- ให้ AI เสนอสมมติฐาน ไม่ใช่ตัดสินใจแทน: โดยเฉพาะงานราคา เครดิต การเงิน บุคลากร และข้อมูลลูกค้า
- เก็บ log ของสิ่งที่ AI ทำ: บันทึก input ผลลัพธ์ การแก้ไขของคน และผลจริง เพื่อหาว่า workflow ส่วนใดควรปรับ
- วัด adoption ควบคู่คุณภาพ: หากทีมไม่ใช้ผลลัพธ์ AI ต่อ ให้ย้อนตรวจว่า output ไม่ตรงรูปแบบงานจริงหรือกำลังวัด KPI ผิด
ตรวจปัญหา เมื่อ AI ทำงานแล้วผลไม่ตรงคาด
- หาก AI ส่งงานมากแต่ทีมไม่ใช้ต่อ ให้ตรวจรูปแบบและโจทย์งาน ลองเก็บตัวอย่างที่ทีมใช้จริงแล้วสร้าง template จากนั้นทดสอบว่างานที่ส่งต่อใช้ง่ายขึ้นหรือไม่
- หากตัวเลขหรือบทสรุปดูน่าเชื่อแต่ผิด ให้ตรวจความครบของข้อมูลและแหล่งอ้างอิง จำกัดข้อมูลที่ใช้และตั้งจุดตรวจตัวเลขสำคัญก่อนส่งต่อ
- หาก KPI ดีขึ้นแต่ผลธุรกิจแย่ลง ให้ตรวจว่าตัวชี้วัดแคบเกินไปหรือไม่ เช่น เน้นตอบเร็วแต่ไม่แก้ปัญหา ลองเพิ่มเกณฑ์ความถูกต้อง การจบเคส และ feedback ที่สัมพันธ์กับเป้าหมายจริง
- หากทีมใช้ AI ไม่สม่ำเสมอ ให้ตรวจขอบเขตและผู้รับผิดชอบของ workflow เริ่มจากงานที่ตรวจผลได้และอธิบายให้ชัดว่าใครตัดสินใจขั้นสุดท้าย
การต่อยอดหลังจาก workflow แรกเริ่มนิ่ง
- สร้างคลังความรู้ภายในจากคำถามลูกค้า เอกสารขาย และวิธีแก้ปัญหาที่ทีมยืนยันแล้ว เพื่อให้ AI ตอบงานในบริษัทได้ตรงขึ้น
- ทำ dashboard ที่ติดตามทั้งคุณภาพของ AI เวลาที่ประหยัดได้ และผลธุรกิจจริง แทนการดูจำนวนงานที่สร้าง
- ตั้งวงจรปรับปรุงรายเดือน ให้ทีมรวบรวมข้อผิดพลาดและคำตอบที่ดีเป็นตัวอย่างใหม่สำหรับปรับ prompt, policy และ eval
บทเรียนจากกรณีที่ Jiang รายงานคือควรวัดทั้งผลการทดลองและการนำงานไปต่อยอด แล้วออกแบบ eval กับ abstraction ให้ agent สำรวจในทิศทางที่ต้องการ ทีมสามารถเริ่มจากโจทย์แคบ เก็บหลักฐาน และขยายเมื่อผลผ่านเกณฑ์ของงานจริง
แหล่งที่มา: How Autoresearch is changing ML research — Zhengyao Jiang, Weco โดย AI Engineer · อัปโหลด 17/07/2026 เวลาไทย 01:08:16 น. วันอัปโหลดแยกจากวันจัดงานและวันเผยแพร่บทความนี้
