


ประเด็นที่น่าสนใจที่สุดจากคลิป The Golden Age of AI Engineering ของช่อง AI Engineer ไม่ใช่แค่เรื่อง model เก่งขึ้นหรือเร็วขึ้น แต่คือวิธีคิดใหม่ว่า “งานสร้างซอฟต์แวร์” กำลังเปลี่ยนจากการลงมือทำทุกอย่างเอง ไปเป็นการออกแบบระบบงานที่มี AI agents ช่วยรับช่วงต่อ
Alexander Embiricos, Romain Huet และ Peter Steinberger ใช้เวทีนี้เล่าทั้งแนวคิดผลิตภัณฑ์ stack ของ Codex และวิธีจัดงานกับ agents ส่วนตัว Peter โดยมีข้อเสนอสำคัญว่าคอขวดใน workflow ของเขาย้ายจาก token และ compute มาสู่ attention ของคน รายละเอียด product ตัวเลข และแผนงานในบทความเป็นคำกล่าวในต้นฉบับที่อัปโหลดเดือนกรกฎาคม ไม่ใช่การรับรองราคา ความเร็ว หรือ availability ปัจจุบัน
ข้อเสนอประยุกต์สำหรับธุรกิจและทีมไทยคือจัดงานให้ AI รับช่วงบางส่วน โดยกำหนดผลลัพธ์ จุดตรวจ และต้นทุนให้วัดได้ ตัวอย่างในบทความเป็นแนวทางทดลองจากการบรรยาย ไม่ใช่ประสบการณ์ใช้งานหรือผลทดสอบของผู้เขียน
มุมมองของผู้บรรยายต่องานวิศวกรรม
หนึ่งในแกนหลักของคลิปคือการโต้กลับความเชื่อที่ว่า เมื่อการเขียนโค้ดถูก abstract มากขึ้น วิศวกรจะสำคัญน้อยลง OpenAI เสนอภาพตรงกันข้าม พวกเขามองว่างานวิศวกรรมไม่เคยมีแก่นแท้อยู่ที่ “การพิมพ์โค้ด” แต่คือการแก้ปัญหาให้คนใช้งานจริง
เมื่อนำมาประยุกต์กับธุรกิจไทย ลองเริ่มจากปัญหาที่ต้องแก้ เช่น ลูกค้าติดตรงไหน การขายช้าตรงใด หรือข้อมูลส่งต่อไม่ครบ แล้ววัดว่า AI ช่วยเปลี่ยนขั้นตอนนั้นได้จริงหรือไม่
ในกรอบคิดของผู้บรรยาย เวลาของคนควรถูกจัดสรรให้การกำหนดโจทย์ วิจารณญาณ และการตรวจผล โดยอาจเริ่มจากรายการนี้
- กำหนดเป้าหมายที่ถูกต้อง
- ตัดสินใจว่าอะไรควรทำก่อน
- รีวิวงานที่ AI สร้างขึ้น
- เชื่อมงานหลายส่วนให้เกิดผลลัพธ์ทางธุรกิจ
คำว่า “ยุคทองของ AI Engineering” เป็นมุมมองของผู้บรรยายต่อโอกาสการสร้างและแก้ปัญหา ไม่ใช่ข้อสรุปว่าผลกระทบต่อทุกอาชีพหรือทุกธุรกิจจะเหมือนกัน
มองให้เห็นว่าความเร็วของ model เปลี่ยนวิธีทำงาน ไม่ใช่แค่เพิ่มความสะดวก
ผู้บรรยายเล่าว่ารอบการปล่อย model ของทีมเปลี่ยนจากประมาณ 15 เดือนเป็นราว 6 สัปดาห์ในช่วงที่พูด ข้อเสนอสำหรับทีมใช้งานคือทบทวน workflow เมื่อเครื่องมือเปลี่ยน โดยไม่ถือช่วงเวลานี้เป็นกำหนดเปิดตัวรุ่นถัดไป
Alexander เล่าประสบการณ์พัฒนาการจาก autocomplete และ inline prediction ไปสู่การสั่งแก้ ทดสอบงาน และรับเป้าหมายหลายขั้น ประสบการณ์นี้อธิบายทิศทางที่เขาเห็น ไม่ได้หมายความว่าทุกงานจบเองได้โดยไม่ต้องตรวจ
ถ้ามองในมุมธุรกิจ ความต่างระหว่าง “AI ตอบเก่ง” กับ “AI ทำงานต่อเนื่องได้” ห่างกันมาก เช่น
- ร้านค้าออนไลน์: จากเดิมให้ AI ช่วยเขียนข้อความสินค้า กลายเป็นให้ AI ตรวจคำผิด จัดหมวดหมู่ และสร้างเวอร์ชัน A/B หลายแบบ
- ทีมการตลาด: จากเดิมให้ AI ช่วยคิดแคมเปญ กลายเป็นช่วยสรุป insight, ร่าง landing page, ตรวจ consistency และเตรียมงานส่งต่อ
- ทีม operation: จากเดิมให้ AI สรุปรายงาน กลายเป็นให้ช่วยติดตาม issue และแจ้งคนที่เกี่ยวข้องอัตโนมัติ
สารสำคัญคือ เมื่อ AI ทำ loop ได้เองมากขึ้น งานของเราต้องขยับจาก “ขอคำตอบทีละคำถาม” ไปเป็น “ออกแบบวงจรงาน”
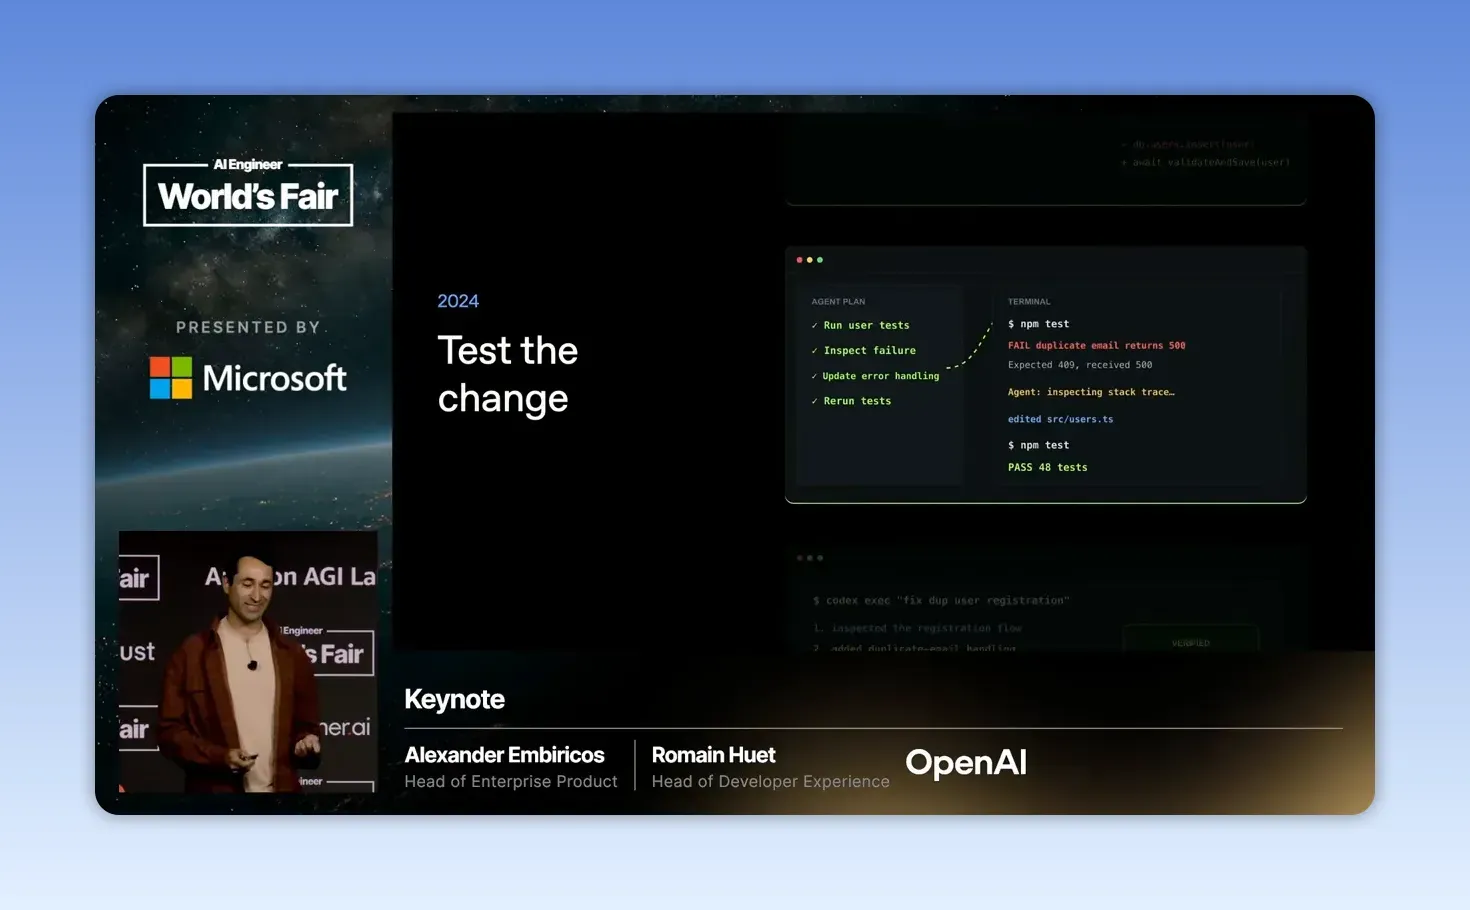
เปลี่ยนจากการใช้ AI เป็นเครื่องมือเดี่ยว ไปสู่การใช้ agent ที่ทำงานก่อนและหลังโค้ดได้
ผู้บรรยายเสนอให้ agents เชื่อมกับงานก่อนเขียนโค้ด เช่น เหตุผลที่ต้องทำ และงานหลังเขียน เช่น review และ deploy เพื่อให้ภารกิจเดินตั้งแต่เริ่มจนส่งมอบ
ตรงนี้เป็น insight ที่เจ้าของธุรกิจไทยเอาไปใช้ได้ทันที แม้ไม่ได้ทำ software product เองก็ตาม เพราะในทุกธุรกิจมี “งานก่อนงาน” และ “งานหลังงาน” อยู่เสมอ
ตัวอย่างเช่น ถ้าเรามีทีมขาย งานจริงไม่ใช่แค่ตอบลูกค้า แต่มีทั้ง
- สรุปความต้องการจากแชต
- จัดลำดับความร้อนแรงของ lead
- ร่างใบเสนอราคา
- ติดตามสถานะ
- สรุปเหตุผลที่ปิดการขายไม่ได้
หากทดลองให้ AI รับช่วงหลายขั้น ให้ดูทั้งเวลา คุณภาพ และงานแก้มือเทียบกับกระบวนการเดิม เพื่อแยกว่าช่วยส่วนใดจริงและยังติดส่วนใดอยู่
จุดที่คลิปพยายามชี้คือ อย่าวัดความสามารถของ AI จาก task สั้นๆ แยกส่วน ควรวัดจากความสามารถในการรับภารกิจที่มีหลายขั้นตอนและส่งมอบงานที่จบเป็นชิ้น
เลือก product experience ให้ถูก ระหว่าง chat กับการลงมือควบคุมเอง
Alexander เสนอประสบการณ์ผลิตภัณฑ์ 2 แบบที่ทำงานร่วมกัน
- Chat สำหรับคุย เป้าหมาย คำสั่ง การขอความช่วยเหลือ
- Hands on interface สำหรับตรวจ ดูรายละเอียด ควบคุม และแก้ด้วยตัวเอง
เขามองว่า chat ยังสำคัญสำหรับคุยเป้าหมายและมอบหมายงาน ส่วน hands-on interface ใช้ตรวจ ชี้นำ และลงรายละเอียดเมื่อจำเป็น เป็นกรอบออกแบบผลิตภัณฑ์ที่เขาเสนอ
หากใช้ AI แล้วรู้สึกต้องคุมทุกการเคลื่อนไหว ลองตรวจว่าสื่อสารเป้าหมายและข้อจำกัดชัดหรือยัง และจุดใดจำเป็นต้องเข้าไปดูรายละเอียด แยกการส่งงานกับการตรวจงานให้ตรงกับความเสี่ยง
แต่ก็ต้องระวังอีกด้าน ถ้าปล่อยยาวเกินไปโดยไม่มีจุดตรวจ งานก็อาจหลุดเป้าได้ ดังนั้น product หรือ workflow ที่ดีควรตอบคำถามนี้ให้ได้
- จุดไหนให้ AI ลุยเอง
- จุดไหนให้คนเข้ามา approve
- จุดไหนต้องเปิดให้แก้ไขเชิงลึก
เข้าใจว่าทำไม Codex app และ collaborative UI ถึงสำคัญ
Alexander อธิบายเหตุผลที่ทีมสร้าง Codex app ว่าต้องการรวม chat กับ collaborative interface สำหรับตรวจและแก้งาน เขามองว่า CLI เน้น chat ส่วน IDE เริ่มจากโค้ดก่อน ข้อนี้เป็นมุมมองออกแบบของทีม ไม่ใช่ข้อห้ามว่า CLI หรือ IDE ใช้ร่วมงานแบบอื่นไม่ได้
นี่ไม่ใช่เรื่องของนักพัฒนาเท่านั้น ในโลกธุรกิจ เครื่องมือ AI ที่ดีไม่ควรเริ่มจาก “หน้าจอแก้ไข” เสมอไป บางครั้งควรเริ่มจาก “หน้าจอคิดร่วมกัน” เช่น
- สรุปเป้าหมายของแคมเปญ
- ระบุข้อจำกัดของแบรนด์
- ชี้จุดที่อยากให้ AI แก้
- เปิดให้คนเข้ามาตรวจเฉพาะส่วนสำคัญ
แนวคิดที่ทีมอาจนำไปทดสอบคือมีทั้งพื้นที่คุยเป้าหมายและพื้นที่ตรวจงานใน workflow เดียวกัน แล้วดูว่าการส่งต่อและการแก้รายละเอียดชัดขึ้นหรือไม่
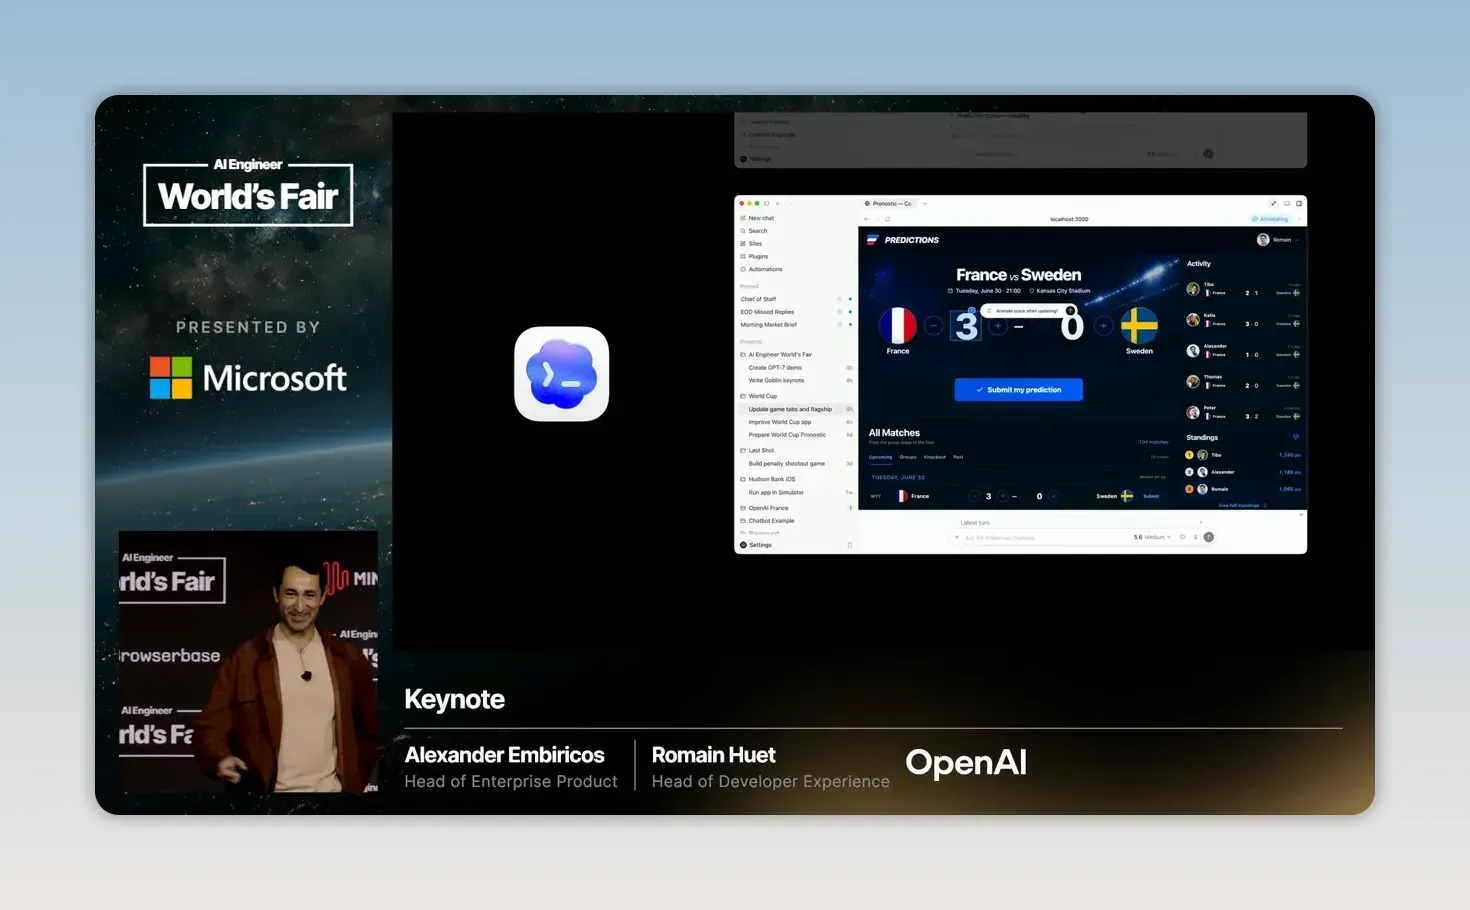
มอง stack แบบเปิดให้ออก ว่าทำไมเรื่องนี้มีผลต่อคนทำธุรกิจ
Romain อธิบาย stack ในช่วงที่บรรยาย ตั้งแต่ model ผ่าน Responses API, Codex Harness, AGENTS.md, App Server และ plugins โดยกล่าวว่าทีมใช้ชั้นฐานเดียวกับที่ให้ developers ต่อเครื่องมือของตนเอง
ตามคำอธิบายของ Romain, Codex app ใช้ model ผ่าน API เดียวกัน และ App Server เป็นเส้นทางที่ทีมใช้กับผลิตภัณฑ์ด้วย การพิจารณาเชื่อมระบบจริงยังต้องตรวจรุ่น เอกสาร สิทธิ์ และขอบเขตของช่องทางที่เลือก
สำหรับเจ้าของธุรกิจ ความหมายคือ
- ถ้าจะลงทุนกับ AI platform ควรถามว่าเปิดให้เชื่อมกับระบบอื่นได้แค่ไหน
- มีมาตรฐานกลางหรือไม่
- ย้ายงานไปใช้ที่อื่นได้หรือเปล่า
- มี ecosystem รองรับจริงหรือยัง
เขากล่าวถึงการเปิด source ของ harness, App Server และ plugins รวมถึงตัวอย่าง role-specific plugins สำหรับ data science และ design ในฐานะแนวทางให้ชุมชนต่อยอด นี่เป็นคำอธิบายต้นฉบับ ไม่ใช่การรับรองว่า components ทุกชั้นมี license หรือสิทธิ์เหมือนกัน
ข้อเสนอประยุกต์คือประเมินว่าชั้นที่เปิดให้ต่อยอดเชื่อมกับงานเดิมของทีมได้แค่ไหน พร้อมต้นทุนดูแลและข้อจำกัดของการย้ายระบบ
วัด AI แบบ value maxing ไม่ใช่ token maxing
อีกคำที่น่าจำจากคลิปคือ value maxing แทนที่จะหมกมุ่นกับจำนวน token หรือแค่ดูว่า model ไหน benchmark สูงกว่า ควรกลับมาถามว่า AI ช่วยสร้างมูลค่าอะไรได้จริง
ช่วง cost efficiency ผู้บรรยายเปรียบเทียบความสามารถกับต้นทุนของ model ใน eval ที่ยกมา ข้อเสนอที่นำไปใช้คือวัดคุณภาพงานคู่ต้นทุนต่อผลลัพธ์ โดยไม่ย้ายคำเปรียบเทียบในคลิปมาเป็นราคาและ benchmark ปัจจุบัน
แต่ตรงนี้เราขอเสริมมุมที่ควรระวังด้วย ตัวเลขต้นทุนต่อ million tokens แม้ดูน่าตื่นเต้น แต่ต้นทุนจริงในธุรกิจไม่ได้มีแค่นั้น ยังมีต้นทุนแฝง เช่น
- เวลาคนตรวจงาน
- เวลา setup workflow
- ความผิดพลาดที่เกิดจาก prompt ไม่ชัด
- การเชื่อมข้อมูลหลายระบบ
ดังนั้นเวลาคิดความคุ้ม อย่าคิดแค่ค่า model ให้คิดเป็น ต้นทุนต่อผลลัพธ์ธุรกิจ เช่น ต้นทุนต่อ lead ที่ปิดได้ ต้นทุนต่อเคสบริการที่จบไวขึ้น หรือเวลาที่ทีมประหยัดได้ต่อสัปดาห์
ใช้ความเร็วให้เป็นประโยชน์ ไม่ใช่แค่รอคำตอบเร็วขึ้น
ผู้บรรยายรายงานการรัน GPT-5.6 Sol บนระบบที่เขาเรียกว่า Cerebras ที่ความเร็ว 750 tokens ต่อวินาที และเสนอให้ใช้ความเร็วทดลองหลายแนวทางแล้วคัดผล ตัวเลขนี้เป็นคำกล่าวของเขาในบริบทที่ยกมา ไม่ใช่ความเร็วที่รับประกันทุกงานหรือทุกช่องทาง
ในมุมมองของผู้บรรยาย ความเร็วอาจเปลี่ยนจากการรอคำตอบเดียวไปสู่การทดลองหลายทาง แต่ความถูกต้องและเวลาในการตรวจผลยังต้องวัดร่วมด้วย
สำหรับธุรกิจไทย ความเร็วแบบนี้มีผลในงานที่ต้อง iterate บ่อย เช่น
- สร้างข้อความโฆษณาหลายเวอร์ชัน
- ทดสอบหัวข้ออีเมลหลายแบบ
- สรุปรายงานหลายชุดจากหลายแหล่ง
- ร่างข้อเสนอหลายรูปแบบตาม segment ลูกค้า
ถ้า AI ทำงานพวกนี้ได้เร็วพอ เราจะเปลี่ยนจาก mindset แบบ “ทำเวอร์ชันเดียวให้ดี” ไปเป็น “ลองหลายเวอร์ชันแล้วคัดเอาที่ดีที่สุด” ซึ่งเป็นวิธีคิดที่ใกล้กับการทำ product และ marketing สมัยใหม่มากขึ้น
เตรียมรับโลกที่ไม่มีเส้นแบ่งชัดระหว่าง local กับ cloud
ผู้บรรยายยกภาพคนเปิด laptop ค้างไว้เพื่อให้ agents ทำงาน เป็นโจทย์เรื่องการผูกงานกับเครื่องและ session
วิสัยทัศน์ที่ทีมเสนอคือให้ agent เลือก environment ที่เหมาะระหว่าง local กับ cloud โดยคนไม่ต้องตัดสินทุกครั้ง ส่วนนี้เป็นทิศทางที่ยังต้องพัฒนา ไม่ใช่คำประกาศว่าระบบทั้งหมดทำได้แล้ว
เมื่อนำแนวคิดนี้ไปประเมิน workflow ของทีม ให้แยกว่างานใดต้องใช้ข้อมูลหรือเครื่อง local และงานใดทำใน environment แยกได้ พร้อมเงื่อนไขการส่งงานและสิทธิ์ที่ตรวจสอบได้
ในเชิงธุรกิจ สิ่งที่ควรเก็บไปคิดคือ หากเราจะใช้ AI จริงจัง เราไม่ควรออกแบบกระบวนการที่ผูกกับอุปกรณ์ของคนใดคนหนึ่งมากเกินไป งานควรวิ่งต่อได้แม้คนไม่อยู่หน้าจอ
เรียนรู้บทเรียนสำคัญจาก Peter Steinberger เรื่องการบริหารทีมของ agents
ช่วงของ Peter Steinberger คือส่วนที่ใช้งานได้จริงที่สุด เขาเล่าว่าเมื่อก่อนตัวเองเปิด terminal หลายหน้าต่างและคอยสลับไปสั่งงาน agent ทีละตัว ตอนนั้นดูเหมือน productive แต่พอมองย้อนกลับไป มันคือการเป็น scheduler เองทั้งหมด
จุดเปลี่ยนของเขาคือการเปลี่ยนจากการ pair กับ agent ตัวเดียว มาเป็นการคุยกับ “manager” ที่คอยมอบหมายงานให้ worker agents อีกที
ตัวอย่างของ Peter ชวนให้ทดสอบชั้นจัดงานที่รวมเป้าหมายและ context แล้วมอบหมายงานให้ worker เมื่อจำเป็น ทีมยังต้องเปรียบเทียบกับวิธีที่ง่ายกว่า ไม่ใช่ทุก workflow ต้องมี manager agent
สำหรับ workflow ที่มีงานหลายส่วน แนวทางหนึ่งคือคุยกับ manager แล้วลงไปทำงานร่วมกับ worker ในจุดที่ซับซ้อน เหมือนวิธีที่ Peter เล่า
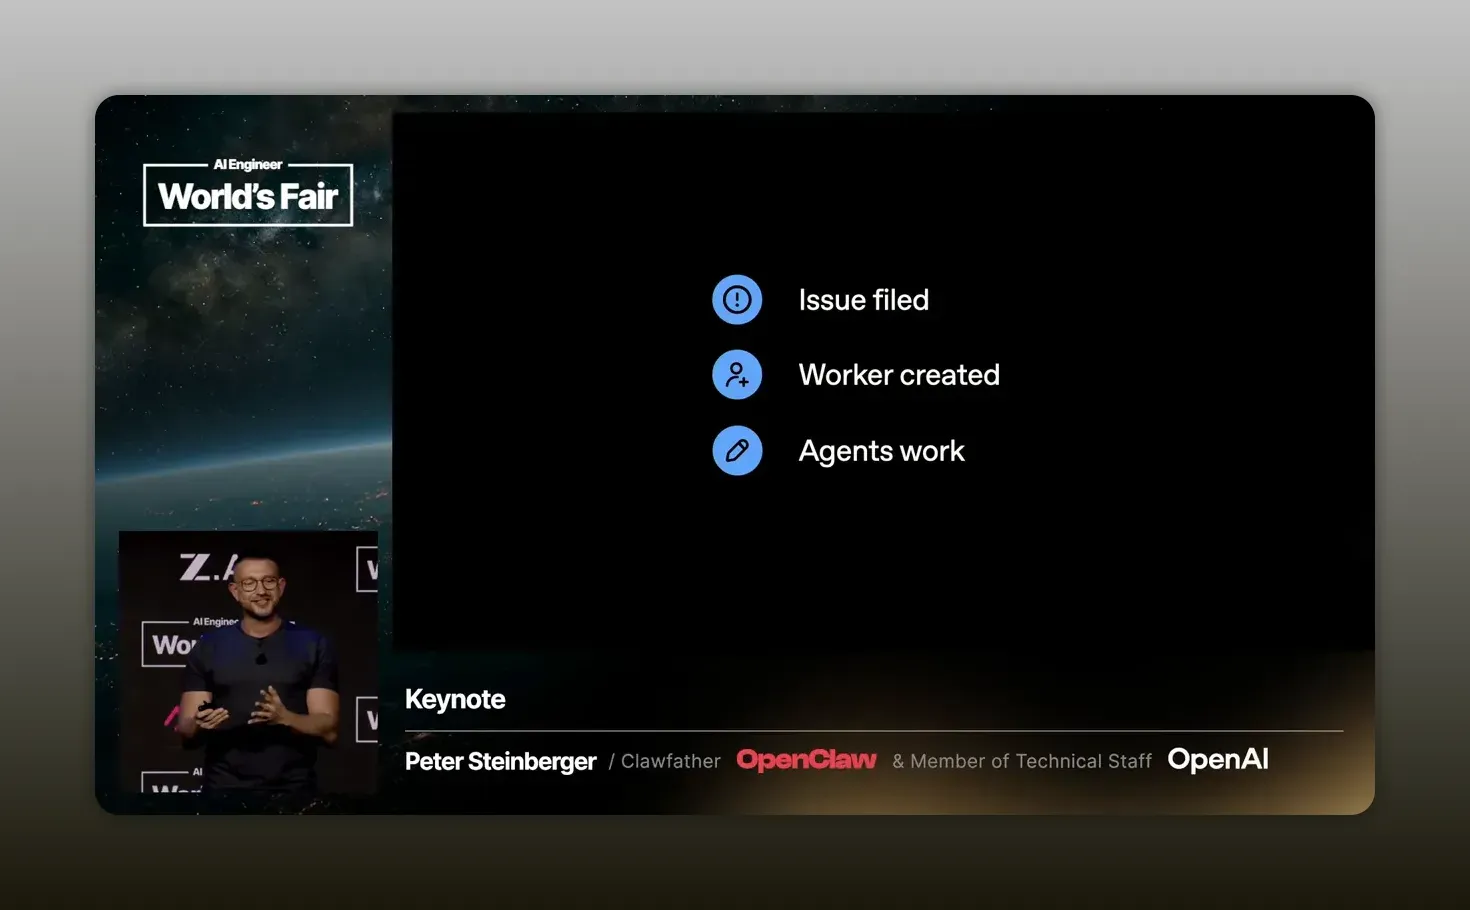
สามองค์ประกอบของ loop ใน workflow ของ Peter
Peter สรุปองค์ประกอบ 3 อย่างจาก workflow ของเขา ได้แก่ server-side compaction สำหรับ context ต่อเนื่อง การมอบหมายงาน และ automation ที่ปลุก manager เมื่อมีเหตุการณ์
- Persistent context คือมีความจำต่อเนื่อง ไม่ต้องเริ่มใหม่ทุกครั้ง
- Delegation คือมีการมอบหมายงานจาก manager ไปยัง worker
- Triggers คือมีเหตุการณ์ที่ปลุกระบบให้เริ่มทำงานเอง
ทีมที่นำแนวคิดนี้มาประยุกต์อาจลองกับ workflow ที่มีข้อมูลต่อเนื่อง งานส่งต่อ และเหตุการณ์เริ่มงาน เช่น
- บริหารลูกค้า: เก็บ context ของลูกค้า, ให้ AI มอบหมายงานติดตาม, ปลุกระบบเมื่อมีข้อความใหม่
- งานบัญชี: เก็บเงื่อนไขเอกสาร, มอบหมายการตรวจเบื้องต้น, trigger เมื่อมีไฟล์ใหม่เข้า
- งาน HR: เก็บข้อมูลตำแหน่งงาน, ให้ AI คัดกรองรอบแรก, trigger เมื่อมีผู้สมัครใหม่
จุดที่ดีของ framework นี้คือมันบังคับให้เราเลิกคิดแบบ prompt เดี่ยว แล้วหันมาคิดเป็นระบบงานต่อเนื่อง
จัดเวลา review เมื่อ attention เป็นคอขวด
นี่คือประโยคที่คมที่สุดช่วงท้าย Peter บอกว่าเมื่อก่อนข้อจำกัดหลักคือ token ต่อมาคือ compute แต่ตอนนี้ข้อจำกัดหลักคือ attention ของตัวเขาเอง
ข้อเสนอประยุกต์คือเมื่อระบบสร้างงานได้มากขึ้น ให้ตรวจว่าความสามารถในการอ่านและตัดสินใจของคนเริ่มเป็นคอขวดหรือไม่ แล้วออกแบบหลักฐานและจุด review ให้เหมาะกับงาน
ดังนั้นทักษะสำคัญจึงไม่ใช่แค่เขียน prompt เก่ง แต่คือ
- รู้ว่าจุดไหนควรอ่านละเอียด
- รู้ว่าจุดไหนพอสุ่มตรวจได้
- รู้ว่าจุดไหนต้องมีเกณฑ์อนุมัติ
- รู้ว่าจุดไหนควรปล่อยให้ระบบเดินต่อเอง
กำหนดว่าจุดใดตรวจทั้งหมด จุดใดสุ่มตรวจได้ และจุดใดต้องมีคนอนุมัติ พร้อมเกณฑ์แจ้งข้อผิดพลาดที่ชัด ไม่ใช้การลดเวลาตรวจเป็นเหตุผลข้ามงานที่มีความเสี่ยงสูง
แนวทางเริ่มลงมือ
- เริ่มจาก workflow ที่มีหลายขั้นตอนชัดเจน เช่น รับเรื่อง ตรวจข้อมูล ส่งต่อ แทนการเริ่มจากงาน creative ล้วนๆ
- ออกแบบจุด approve ให้คนเข้าแค่ตอนสำคัญ ไม่ต้องคุมทุกการเคลื่อนไหวของ AI
- วัดผลเป็นมูลค่าธุรกิจ เช่น เวลาที่ลดลง อัตราปิดงาน หรือคุณภาพงานหลังแก้ ไม่ใช่วัดแค่จำนวน prompt
- เลือกเครื่องมือที่เชื่อมกับระบบเดิมได้ และมี ecosystem รองรับ ไม่ใช่ดูแค่เดโมสวย
- หากจะใช้หลาย agents ให้ทดลองว่าชั้นจัดงานกลางช่วยเก็บ context และส่งงานหรือไม่ พร้อมตรวจจุดล้มเหลวและความซับซ้อนที่เพิ่มขึ้น
ตรวจปัญหา
ปัญหา: AI ทำงานได้ แต่ต้องคอยเฝ้าตลอด
จุดที่ควรตรวจ: การมอบหมายงาน จุดรายงานผล และขอบเขตที่ agent ตัดสินใจเองได้ชัดหรือยัง
ลองกำหนดผลลัพธ์สุดท้ายและ checkpoint ตามความเสี่ยง แล้วให้กลับมารายงานเมื่อถึงเงื่อนไข ทดสอบว่างานยังตรงเป้าหมายโดยใช้เวลาเฝ้าน้อยลงหรือไม่
ปัญหา: ใช้ AI แล้วประหยัดเวลาไม่จริง
จุดที่ควรตรวจ: AI ช่วยส่วนใด และขั้นตอนอื่นยังใช้เวลาหรืองานแก้มือเท่าเดิมหรือไม่
ลองวาด workflow เดิมทั้งเส้น แล้วเลือกจุดก่อน ระหว่าง หรือหลังงานที่ให้ AI ทดลองรับช่วงได้ วัดผลก่อนขยาย
ปัญหา: ผลลัพธ์ไม่สม่ำเสมอ
จุดที่ควรตรวจ: ข้อมูลอ้างอิง context และเวอร์ชันคำสั่งในแต่ละรอบต่างกันหรือไม่
ลองจัดเอกสารกลาง เช่น policy, brand note, project goals หรือ instruction file ให้มีเจ้าของและเวอร์ชัน แล้วทดสอบผลซ้ำ
ปัญหา: ทีมเริ่มสับสนว่า AI ตัวไหนทำอะไร
จุดที่ควรตรวจ: ขอบเขตงาน สิทธิ์ และรูปแบบส่งต่อระหว่าง agents ชัดหรือยัง
กำหนดบทบาท เช่น วิเคราะห์ ร่าง ตรวจ หรือสรุป พร้อมเงื่อนไขส่งต่อและหยุดงาน เลือกใช้ตัวกลางเมื่อช่วยลดความสับสนได้จริง
การต่อยอด
- สร้าง AI manager สำหรับงานขาย ที่คอยสรุป lead, มอบหมาย follow up และเตรียมข้อเสนออัตโนมัติ
- ทำ workflow ฝ่ายบริการลูกค้าที่มี trigger จาก LINE, email หรือ ticket system แล้วให้ AI คัดประเภทปัญหาก่อนคน
- ทดลองระบบ review 2 ชั้น โดยให้ agent หนึ่งสร้างงาน และอีก agent หนึ่งตรวจงานก่อนถึงมือทีม
ข้อเสนอร่วมจากการบรรยายคือออกแบบ loop ให้รับโจทย์ ทำงาน และส่งหลักฐานกลับมาเพื่อให้คนตัดสินใจ จุดเริ่มต้นคือทดลอง workflow ที่ชัด วัดคุณภาพและต้นทุน แล้วใช้ผลจริงเลือกว่าจะเพิ่ม context, delegation หรือ triggers ตรงไหน
แหล่งที่มา: The Golden Age of AI Engineering — Alexander Embiricos & Romain Huet & Peter Steinberger, OpenAI โดย AI Engineer · อัปโหลด 10/07/2026 เวลาไทย 01:53:34 น. วันอัปโหลดแยกจากวันจัดงานและวันเผยแพร่บทความนี้
