

เมื่อระบบเริ่มมีปัญหา ทีมต้องรู้ทั้งว่าอะไรเสีย อะไรเพิ่งเปลี่ยน และหลักฐานอยู่ที่ไหน ก่อนจะตัดสินใจแก้ วิดีโอ Production Monitoring with Codex: Grafana, Kubernetes, & Security จาก OpenAI สาธิตการให้ Codex ช่วยรวบรวมข้อมูลและเสนอแพตช์ในสามสถานการณ์
ทั้งสามตัวอย่างมีคนอนุมัติก่อนใช้ชุดแก้ไข แล้วตรวจผลหลังเปลี่ยนระบบ สิ่งที่คลิปมีให้ศึกษาจึงเป็นวิธีเชื่อมการเฝ้าระวังเข้ากับการวิเคราะห์และแก้ปัญหา ไม่ใช่หลักฐานว่าระบบจริงทุกประเภทจะซ่อมตัวเองได้อย่างปลอดภัยหรือเร็วเท่ากัน
สารบัญ
- ให้ Codex ช่วยรวบรวมหลักฐานก่อนเสนอทางแก้
- เดโม 1: ข้อผิดพลาดเพิ่มหลังออกรุ่นใหม่
- เดโม 2: ผ่าน CI/CD แต่คอนเทนเนอร์ยังล้ม
- เดโม 3: คำขอรายงานแย่งทรัพยากรของระบบ
- เริ่มตรวจอัตโนมัติ กับปล่อยแพตช์อัตโนมัติ เป็นคนละขอบเขต
- สิ่งที่ควรเตรียมก่อนทดลองกับระบบของทีม
ให้ Codex ช่วยรวบรวมหลักฐานก่อนเสนอทางแก้
แดชบอร์ดอาจบอกได้ว่าอัตราความผิดพลาดเพิ่มขึ้น แต่ทีมยังต้องเชื่อมข้อมูลกับประวัติการนำระบบขึ้นใช้งานและโค้ดที่เปลี่ยนไป แนวทางในคลิปคือให้ Codex ทำงานผ่าน skill ที่เตรียมไว้สำหรับตรวจหลักฐานของสถานการณ์นั้น แล้วเสนอการแก้ไขให้คนพิจารณา
ผู้บรรยายเรียกกระบวนการในตัวอย่างแรกว่า bounded evidence workflow ซึ่งใช้หลักฐานที่เกี่ยวข้องกับระบบและความแตกต่างของโค้ดระหว่างรุ่น คลิปไม่ได้แจกแจงการตั้งค่า สิทธิ์ และข้อจำกัดทางเทคนิคทั้งหมด จึงไม่ควรตีความว่าเพียงพิมพ์คำขอให้แก้เว็บล่มก็จะได้กระบวนการแบบเดียวกัน
เดโม 1: ข้อผิดพลาดเพิ่มหลังออกรุ่นใหม่
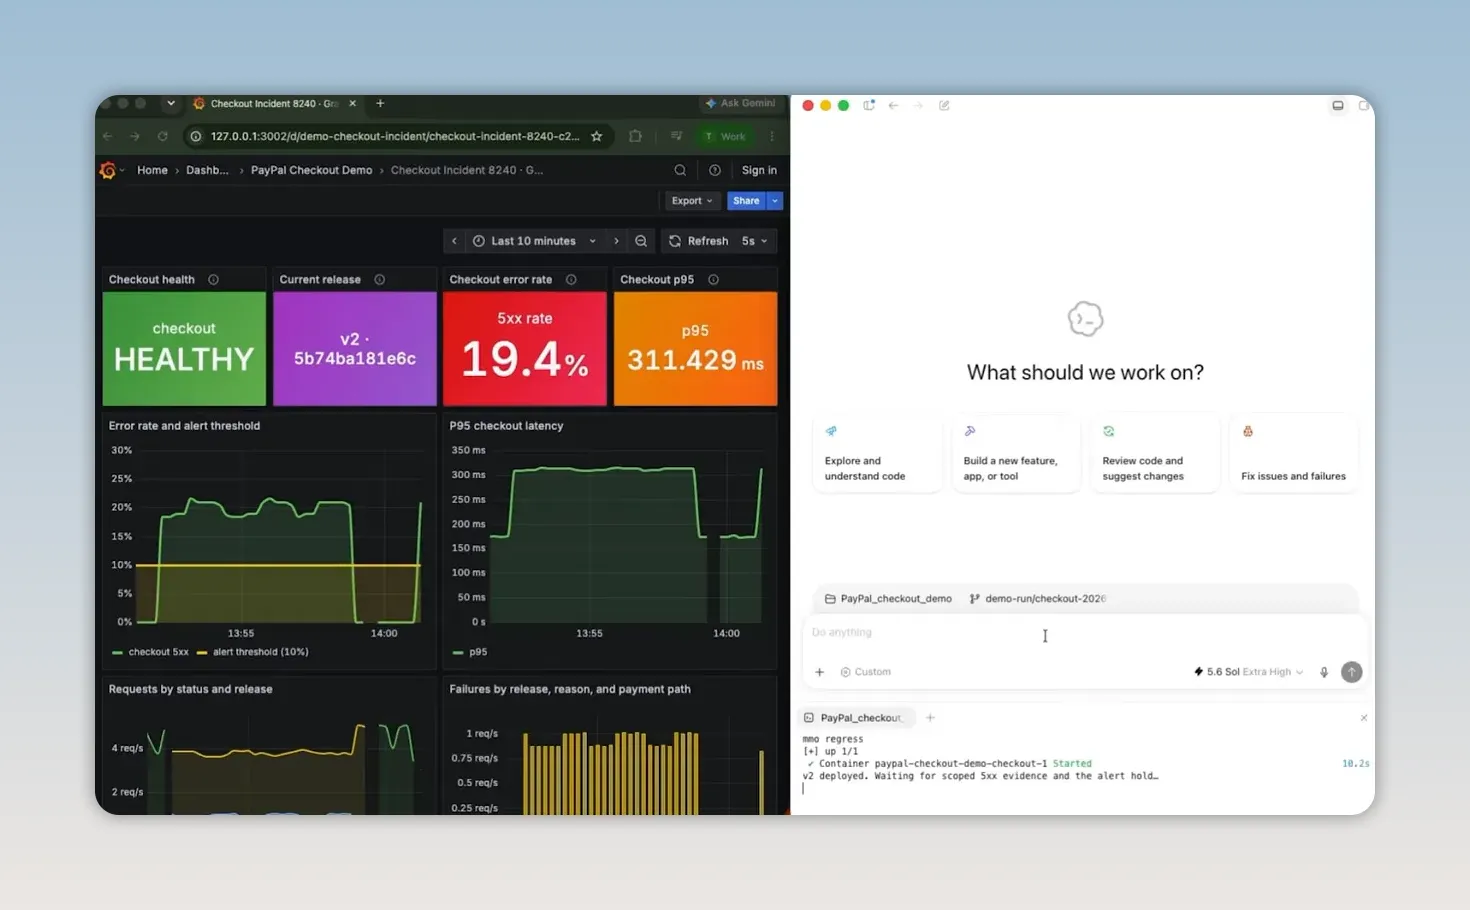
ตัวอย่างแรกนำแอปรุ่น v2 ขึ้นใช้งาน แล้วอัตราความผิดพลาดของขั้นตอน checkout เพิ่มเป็นราว 20% ผู้สาธิตเรียก Codex พร้อม custom skill ให้ตรวจข้อมูลจากระบบและการเปลี่ยนแปลงของรุ่น
ที่มาภาพ: Production Monitoring with Codex: Grafana, Kubernetes, & Security จากช่อง OpenAI
ข้อมูลที่กล่าวถึงมีทั้งรายการที่สำเร็จ เวลาตอบสนอง สถานะบริการ รุ่นที่กำลังใช้งาน และความแตกต่างของโค้ด หลัง Codex เสนอแพตช์และคนอนุมัติ ค่า error rate ที่แสดงในเดโมกลับเป็น 0% โดยระบบยังอยู่บน v2 ไม่ได้ย้อนกลับไปใช้รุ่นเก่า
ผลนี้ยืนยันได้เพียงสิ่งที่แสดงในสถานการณ์สาธิต ไม่ได้บอกอัตราสำเร็จของ Codex ต่อเหตุขัดข้องทั่วไป หรือยืนยันว่าปัญหาจะไม่กลับมาอีก และ error rate ราว 20% ก็ไม่ควรถูกแปลงเป็นยอดขายหาย 20% เพราะเป็นคนละตัวชี้วัด
เดโม 2: ผ่าน CI/CD แต่คอนเทนเนอร์ยังล้ม
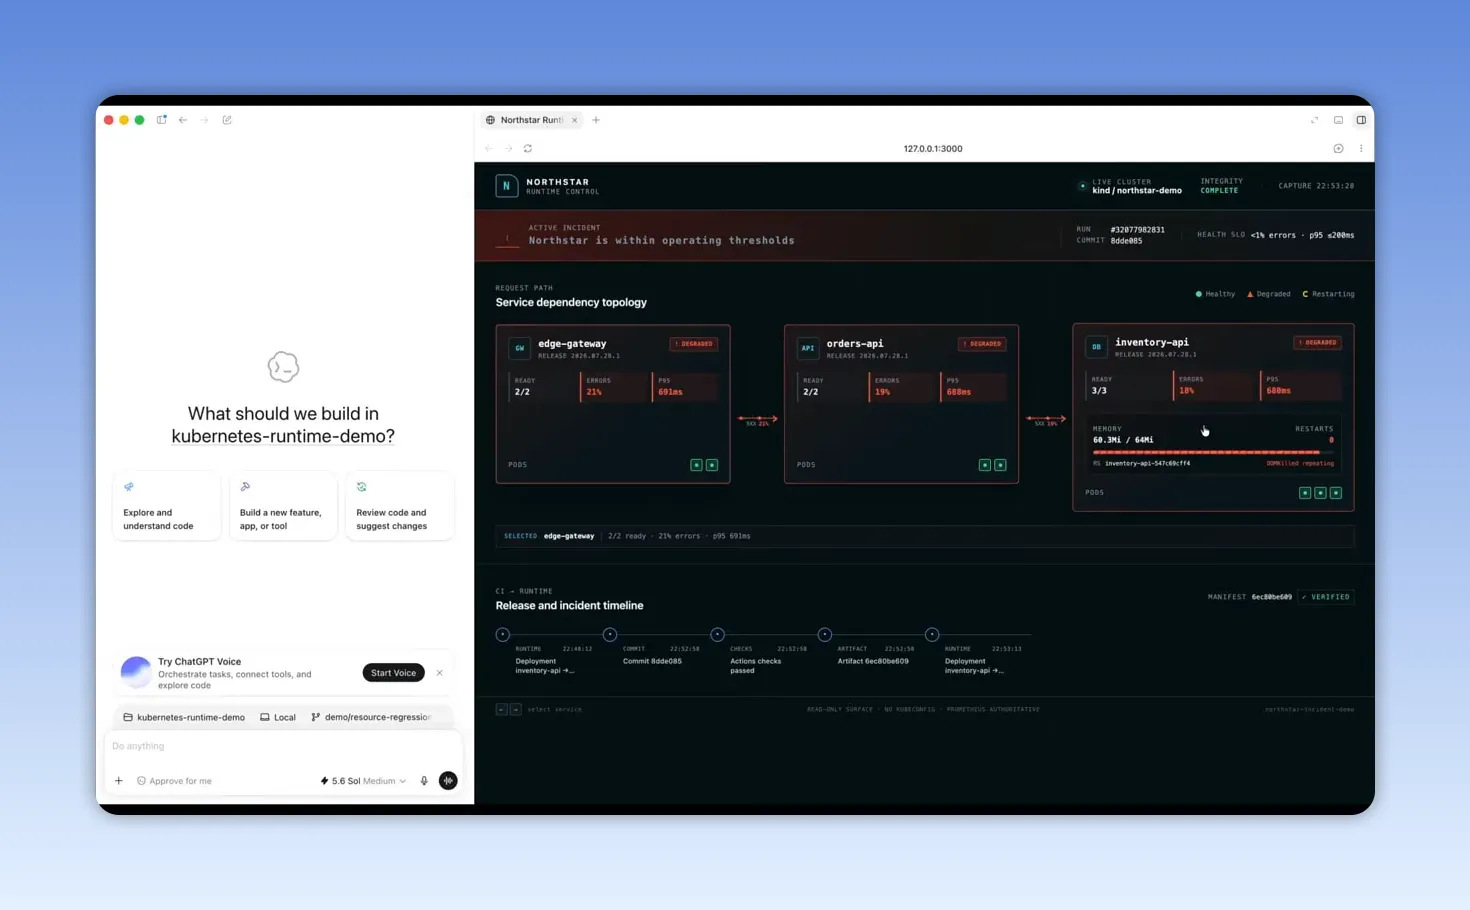
ระบบในตัวอย่างที่สองประกอบด้วย inventory API, orders API และ edge gateway เมื่อออกรุ่นใหม่ของ inventory API กระบวนการ CI/CD ผ่าน แต่คอนเทนเนอร์ถูกหยุดด้วยอาการ OOM killed หรือหน่วยความจำไม่พอ และปัญหาลามไปกระทบบริการอื่น
ที่มาภาพ: Production Monitoring with Codex: Grafana, Kubernetes, & Security จากช่อง OpenAI
ผู้สาธิตใช้ Kubernetes rollout investigator skill ให้ Codex ตรวจการเปลี่ยนรุ่นและลำดับเหตุที่เชื่อมปัญหาเข้าด้วยกัน จากนั้นอนุมัติแพตช์และนำ inventory API รุ่นแก้ไขขึ้นใช้งาน เดโมแสดงว่า orders API และ gateway กลับมาทำงานได้
บทเรียนของตัวอย่างนี้คือการผ่านการทดสอบก่อนปล่อยรุ่นไม่ได้รับประกันว่าจะไม่มีปัญหาในสภาพแวดล้อมใช้งานจริง แต่คลิปไม่ได้อธิบายรายละเอียดแพตช์มากพอให้สรุปว่าวิธีแก้คือ “เพิ่มหน่วยความจำ” อาการ OOM จึงเป็นจุดเริ่มตรวจสอบ ไม่ใช่คำตอบสำเร็จรูป
เดโม 3: คำขอรายงานแย่งทรัพยากรของระบบ
กรณีสุดท้ายไม่มีการปล่อยรุ่นใหม่ล่าสุด แต่คำขอสร้างรายงานหนึ่งรายการใช้ทรัพยากรมากจนแย่งกำลังของ shared worker pool ซึ่งใช้ร่วมกับงาน checkout ทำให้บริการมีปัญหา
ผู้สาธิตใช้การเฝ้าระวังระบบร่วมกับปลั๊กอิน Codex Security เพื่อเสนอแพตช์ แล้วให้คนอนุมัติ จากนั้นส่งคำขอเดิมซ้ำและแสดงว่าคำขอที่ใช้ทรัพยากรสูงถูกบล็อกได้
คลิปนี้แสดงความเกี่ยวข้องระหว่างข้อจำกัดด้านทรัพยากรกับความพร้อมใช้งานของบริการ แต่ไม่ได้พิสูจน์ว่าคำขอเกิดจากผู้โจมตี หรือว่าแพตช์ครอบคลุมทุกกรณีที่เป็นไปได้ การทดสอบกับระบบจริงยังควรตรวจทั้งคำขอที่สร้างปัญหาและงานปกติที่ต้องทำต่อได้
เริ่มตรวจอัตโนมัติ กับปล่อยแพตช์อัตโนมัติ เป็นคนละขอบเขต
สองเดโมแรกเริ่มจากคนได้รับแจ้งเตือนแล้วเรียก Codex ผู้บรรยายเสนอเพิ่มเติมว่าอาจจัดเตรียม runner เชื่อมกับ Kubernetes, Grafana หรือระบบสังเกตการณ์อื่น เพื่อให้เหตุแจ้งเตือนเริ่มงานตรวจสอบและเสนอแพตช์ได้อัตโนมัติ
อีกทางเลือกที่กล่าวถึงคือให้หลายเอเจนต์ตรวจและนำแพตช์ขึ้นระบบแทนคน แต่คลิปไม่ได้สาธิตกระบวนการแบบไม่ต้องมีคนอนุมัติครบตั้งแต่ต้นจนจบ จึงไม่ควรนำตัวเลือกที่พูดถึงไปปะปนกับผลที่เดโมแสดงจริง
สำหรับการทดลองของทีม การอ่านหลักฐาน การเสนอแพตช์ และการเปลี่ยนระบบจริงควรถูกกำหนดสิทธิ์แยกกัน ความสามารถในการวิเคราะห์ไม่ได้แปลว่าควรได้สิทธิ์นำการแก้ไขขึ้นระบบโดยอัตโนมัติ ข้อนี้เป็นข้อเสนอในการออกแบบการใช้งานของบทความ ไม่ใช่ข้อกำหนดผลิตภัณฑ์ที่พิสูจน์จากคลิป
สิ่งที่ควรเตรียมก่อนทดลองกับระบบของทีม
สามตัวอย่างมีจุดร่วมคือรวบรวมหลักฐาน เสนอทางแก้ อนุมัติ และตรวจผล หากจะทดลองแนวทางคล้ายกัน บทความเสนอรายการเตรียมงานสั้นๆ ดังนี้:
- เลือกบริการหนึ่งส่วนและสถานการณ์ทดสอบที่ควบคุมได้ พร้อมกำหนดว่าค่าใดบอกว่าระบบปกติ
- เตรียมแดชบอร์ด บันทึกเหตุการณ์ ประวัติรุ่น โค้ด และความสัมพันธ์ระหว่างบริการที่จำเป็น
- ระบุว่าเอเจนต์อ่านอะไรได้ แก้อะไรได้ และใครอนุมัติการเปลี่ยนแปลง
- ให้ข้อเสนอแยกหลักฐาน สาเหตุที่คาด และสิ่งที่ยังไม่ทราบ พร้อมวิธีทดสอบแพตช์
- ตรวจอาการเดิม งานปกติ และบริการที่เกี่ยวข้องหลังแก้ ไม่ใช้เพียงแดชบอร์ดสีเขียวเป็นข้อสรุป
- วัดเวลาหาข้อมูล วิเคราะห์ ตรวจอนุมัติ และกู้ระบบจากงานของทีมเอง แทนการใช้ความเร็วในเดโมเป็นคำรับรอง
แหล่งอ่านเพิ่มเติมที่ต้นฉบับอ้างไว้คือ คู่มือการแจ้งเตือนของ Grafana และ คู่มือทรัพยากรคอนเทนเนอร์ของ Kubernetes ซึ่งอธิบายองค์ประกอบของระบบ ไม่ใช่ชุดติดตั้ง workflow ในคลิปโดยตรง
ที่มา: Production Monitoring with Codex: Grafana, Kubernetes, & Security จากช่อง OpenAI เรียบเรียงจากบทถอดเสียงและภาพที่แนบกับต้นฉบับ VideoToBlog บทความรายงานเดโมโดยไม่ได้ทดสอบกับระบบใช้งานจริงอย่างอิสระ
