

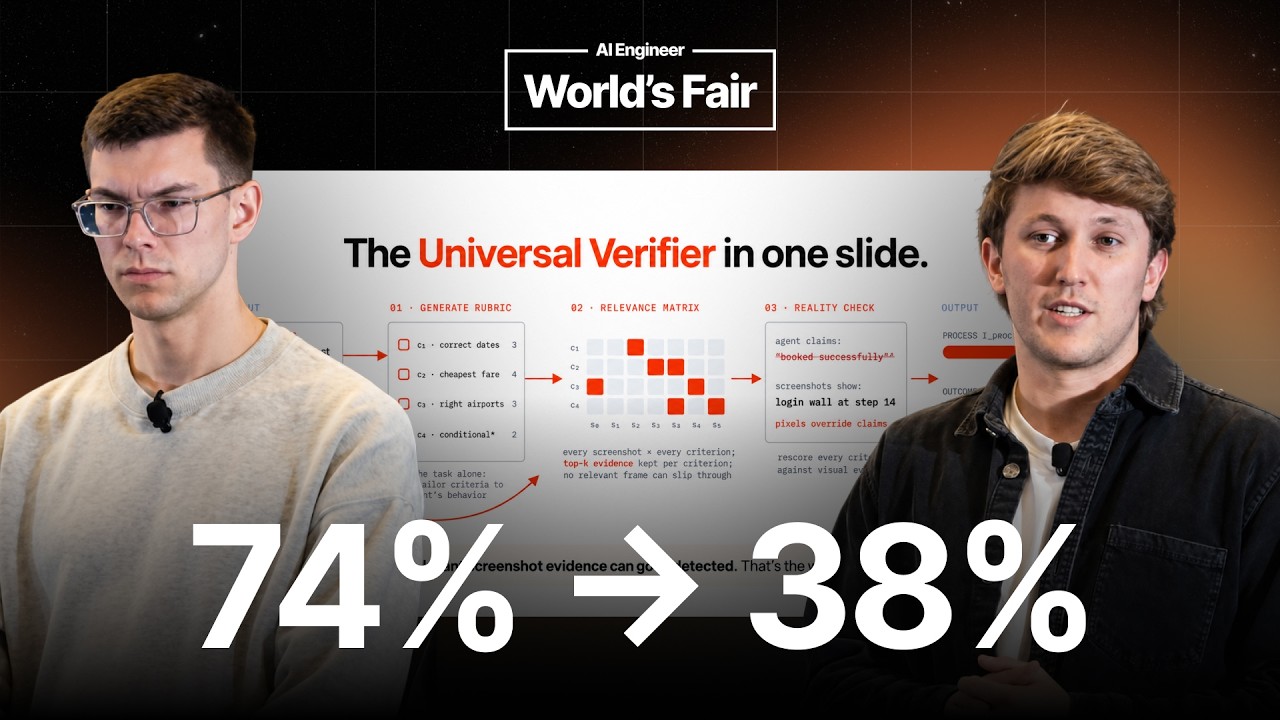
เมื่อ agent ตัวเดิมได้คะแนน 74.6% และ 37.9% จากการตรวจคนละแบบ คำถามจึงอยู่ที่หลักฐานซึ่งใช้ตัดสินว่า “งานเสร็จ”
AI agent ตัวเดิม ทำงานชุดเดิม แต่ได้อัตราความสำเร็จต่างกันเกือบเท่าตัว สไลด์ในการบรรยายของ Browserbase และ Microsoft ระบุว่า Fara-7B ได้คะแนน 74.6% บน WebVoyager เมื่อใช้ตัวตรวจ GPT-4o ของชุดทดสอบ และเหลือ 37.9% เมื่อตรวจการทำงานชุดเดียวกันด้วยคนร่วมกับ Universal Verifier
ตัวเลขนี้เป็นผลที่ทีมผู้พัฒนารายงานในการทดลองหนึ่ง ไม่ได้บอกว่า AI ทุกระบบมีคะแนนสูงเกินจริงในสัดส่วนเดียวกัน แต่ทำให้เห็นปัญหาที่ควรถามก่อนนำคะแนนไปใช้ตัดสินใจ: ระบบรู้ได้อย่างไรว่างานสำเร็จ และตรวจจากสิ่งที่เกิดขึ้นจริงมากน้อยแค่ไหน
การบรรยาย Your LLM Judge Is a Confident Liar: Building Better Verifiers — Browserbase บนช่อง AI Engineer โดย Miguel González Fernández จาก Browserbase และ Corby Rosset จาก Microsoft Research อธิบายการสร้าง Universal Verifier เพื่อประเมินงานของ agent ที่ใช้เว็บ ตั้งแต่การนิยามความสำเร็จ ไปจนถึงการตรวจว่าตัวตรวจเองเชื่อถือได้เพียงใด
ทำไมคะแนนจาก LLM Judge จึงคลาดเคลื่อนได้
LLM Judge คือการใช้โมเดลภาษาประเมินคำตอบหรือการทำงานของ AI อีกระบบ ส่วน verifier ในงานนี้หมายถึงระบบตรวจสอบที่ประกอบด้วยเกณฑ์ หลักฐาน และกระบวนการตัดสิน การเลือกโมเดลที่เก่งขึ้นจึงเป็นเพียงส่วนหนึ่งของการออกแบบตัวตรวจ
Miguel เล่าว่าทีมเริ่มสร้างชุดประเมินให้ Stagehand ซึ่งเป็นเครื่องมือทำงานอัตโนมัติบนเว็บ โดยใช้สภาพแวดล้อมที่ตรวจผลได้ด้วยเงื่อนไขตายตัว เมื่อ agent ทำงานซับซ้อนขึ้น ทีมต้องคอยแก้เว็บไซต์จำลอง เพิ่มลำดับงาน และสร้างจุดตรวจจำนวนมาก การดูแลชุดประเมินแบบเดิมจึงยากขึ้นตามไปด้วย
เว็บจริงยังเปลี่ยนอยู่ตลอด สินค้าที่เคยมีอาจหมด หน้าเว็บอาจเปลี่ยน หรือ agent อาจติดข้อจำกัดระหว่างทาง อีกทั้งงานเดียวกันอาจมีหลายวิธีที่ทำให้สำเร็จได้ การกำหนดว่าต้องเดินผ่านจุดตรวจใดบ้างจึงอาจแคบกว่าสิ่งที่ผู้ใช้ต้องการจริง
ทีมจึงหันมาใช้ LLM Judge ที่มากับชุดทดสอบเว็บ แต่เมื่อให้คนตรวจซ้ำ กลับพบกรณีที่ตัวตรวจให้คำตัดสินอย่างมั่นใจทั้งที่ผิด การเปรียบเทียบ Fara-7B บน WebVoyager เป็นตัวอย่างสำคัญของช่องว่างนี้
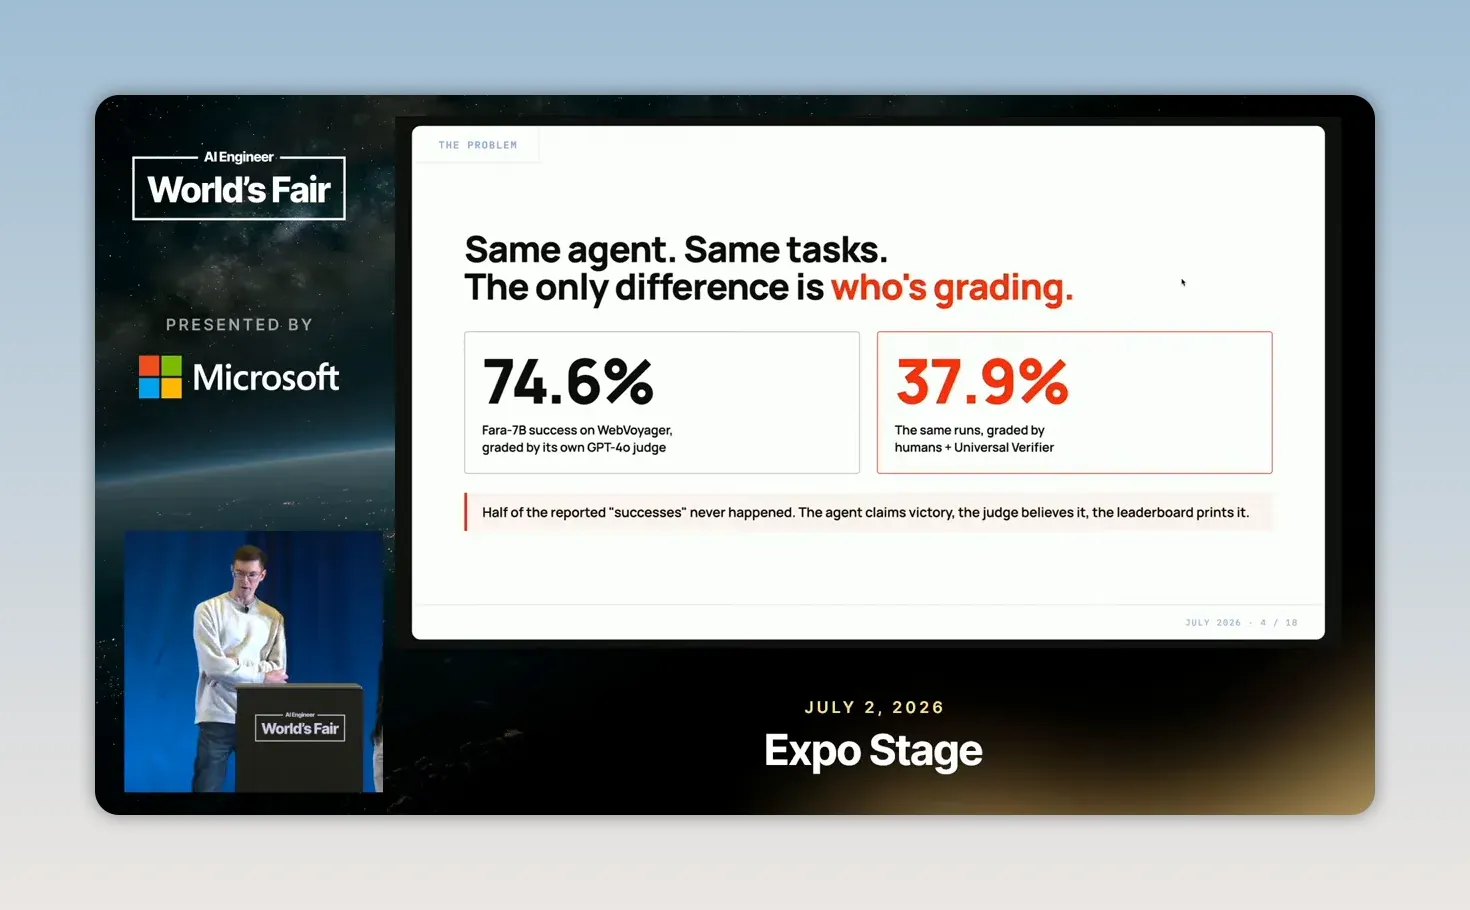
เรื่องนี้สำคัญกว่าการจัดอันดับโมเดล หากนำคะแนนจากตัวตรวจไปเป็นรางวัลระหว่างฝึก agent หรือใช้เลือกว่าการปรับระบบครั้งใดดีขึ้น ความผิดพลาดของตัวตรวจอาจกลายเป็นเป้าหมายที่ระบบพยายามทำตาม ผู้บรรยายเตือนว่า agent อาจเก่งขึ้นในการทำให้ผู้ตรวจเชื่อ โดยที่ความสามารถทำงานจริงไม่ได้ดีขึ้นตามคะแนน
ในทำนองเดียวกัน รายงานที่บอกว่างานอัตโนมัติสำเร็จจำนวนมากจะมีประโยชน์จำกัด หากคำว่า “สำเร็จ” มาจากการที่ agent บอกว่าตัวเองทำเสร็จ การตรวจสถานะปลายทางจึงเป็นส่วนหนึ่งของการวัดผล ไม่ใช่งานเสริมหลังดูคะแนนแล้ว
Universal Verifier จับคู่เกณฑ์กับหลักฐานอย่างไร
Universal Verifier เริ่มจาก rubric หรือรายการเกณฑ์ที่ระบุว่างานนั้นต้องทำอะไรสำเร็จ จากนั้นอ่านลำดับการทำงานของ agent ซึ่งในงานวิจัยเรียกว่า trajectory แล้วเลือกภาพหน้าจอที่เกี่ยวข้องกับเกณฑ์แต่ละข้อมาใช้ตรวจ
- สร้างเกณฑ์จากคำสั่งงาน แยกสิ่งที่ผู้ใช้ต้องการออกเป็นข้อที่ตรวจสอบได้
- หาหลักฐานที่เกี่ยวข้องกับแต่ละข้อ จัดอันดับภาพหน้าจอจากลำดับการทำงาน แทนการส่งทุกภาพให้โมเดลตัดสินพร้อมกัน
- ตรวจคำกล่าวอ้างเทียบกับสถานะจริง ใช้ภาพที่เกี่ยวข้องมากที่สุดจำนวนหนึ่งพิจารณาว่าเกณฑ์นั้นผ่านหรือไม่ และสิ่งที่ agent รายงานขัดกับหลักฐานตรงไหน
- ให้คะแนนพร้อมเหตุผล รายงานคะแนนกระบวนการเป็นรายเกณฑ์ และตัดสินแยกอีกครั้งว่าเป้าหมายรวมสำเร็จหรือไม่
ขั้นตอนเลือกหลักฐานมีความสำคัญ เพราะการส่งภาพมากที่สุดไม่ได้รับประกันว่าจะตรวจได้ดีที่สุด ผู้บรรยายพบทั้งตัวตรวจที่ละเลยภาพสำคัญ และตัวตรวจที่พยายามอ่านทุกภาพจนข้อมูลล้นความจุบริบทของโมเดล นอกจากนี้ การมองข้ามประวัติการกระทำหรือคำตอบสุดท้ายก็ทำให้ตรวจไม่ครบได้
เกณฑ์ต้องไม่เพิ่มงานที่ผู้ใช้ไม่ได้สั่ง
ตัวอย่างหนึ่งในคลิปให้ agent หาโรงแรมราคาถูกในจาการ์ตาตามวันที่กำหนด แล้วใช้ที่อยู่โรงแรมหาร้านกาแฟที่ใกล้ที่สุด พร้อมรายงานชื่อและที่อยู่ร้านกาแฟ แต่ rubric ที่สร้างขึ้นกลับเพิ่มข้อให้รายงานราคารวมของการพักโรงแรมด้วย
การใช้ราคาเลือกโรงแรมเป็นส่วนหนึ่งของงาน ส่วนการแสดงราคารวมในคำตอบเป็นอีกเรื่องหนึ่ง หากคำสั่งไม่ได้ขอให้ส่งข้อมูลนั้น การหักคะแนนเพราะไม่รายงานย่อมทำให้คะแนนต่ำลงโดยไม่สะท้อนความผิดพลาดตามโจทย์ ทีมจึงกำหนดหลักว่าทุกข้อใน rubric ต้องย้อนกลับไปหาความต้องการในคำสั่งได้
ตัวเลขที่ดูเป็นไปได้ก็ต้องเทียบต้นทาง
อีกกรณีเป็นงานค้นข้อมูลโมเดลสร้างคำบรรยายภาพ agent รายงานว่าคะแนน CIDEr เพิ่มขึ้น 6.2% แต่ตามตัวอย่างที่ผู้บรรยายแสดง บทคัดย่อของงานวิจัยระบุ 2.8% ความคลาดเคลื่อนลักษณะนี้อาจหลุดรอดได้ง่ายเมื่อผู้ตรวจอ่านเพียงคำตอบที่เรียบเรียงมาดี
วิธีตรวจจึงต้องลงไปถึงหลักฐานของคำตอบแต่ละข้อ ไม่ใช่ดูว่าคำตอบโดยรวมสมเหตุสมผลหรือไม่ ทั้งตัวเลขและคำยืนยันว่า “ดำเนินการเรียบร้อยแล้ว” ยังเป็นสิ่งที่ต้องพิสูจน์ด้วยข้อมูลอื่น รายละเอียดระบบและตัวอย่าง rubric อยู่ในช่วง 04:59–09:13 ของวิดีโอ
ทำหลายขั้นตอนถูก ไม่ได้แปลว่าบรรลุเป้าหมาย
Universal Verifier แยกผลเป็นสองส่วน ได้แก่ process score หรือคะแนนกระบวนการ ซึ่งให้คะแนนบางส่วนได้ กับ outcome ซึ่งตัดสินว่างานสำเร็จหรือไม่ตามความคาดหวังที่สมเหตุสมผลของผู้ใช้ การแยกสองส่วนนี้ช่วยให้เห็นสาเหตุของปัญหา โดยไม่เอาคะแนนระหว่างทางไปแทนผลลัพธ์สุดท้าย
ไม่ลงโทษซ้ำทุกขั้นจากความผิดพลาดเดียว
ในตัวอย่างที่ให้เลือกสมาชิก NSYNC หรือ Backstreet Boys ที่มีนามสกุลยาวที่สุด แล้วรายงานมูลค่าทรัพย์สินสุทธิ agent เลือก Timberlake ทั้งที่ Kirkpatrick มีนามสกุลยาวกว่า ความผิดพลาดอยู่ที่การเลือกบุคคลตั้งแต่ต้น
หากขั้นต่อมา agent ค้นข้อมูลของ Timberlake และรายงานตรงกับแหล่งที่อ่าน ทีมเสนอว่าเกณฑ์การค้นข้อมูลของบุคคลที่เลือกไม่ควรถูกหักโดยอัตโนมัติเพราะความผิดในข้อก่อนหน้า คะแนนรายข้อควรช่วยบอกว่าระบบเลือกคนผิด แต่ยังค้นข้อมูลของคนที่เลือกได้ถูกต้อง
อย่างไรก็ตาม งานโดยรวมยังไม่ตอบโจทย์ เพราะรายงานข้อมูลของคนผิดคน คะแนนบางส่วนมีไว้แยกวิเคราะห์ความสามารถแต่ละขั้น ไม่ใช่รับรองผลลัพธ์ที่คลาดเคลื่อนจากคำสั่ง
แยกข้อจำกัดภายนอกออกจากสิ่งที่ agent ทำพลาด
อีกตัวอย่างคือการซื้อตุ๊กตาจาก Amazon agent ค้นพบสินค้าที่ถูกต้อง แต่สินค้าหมด จึงซื้อไม่ได้ ผู้บรรยายอธิบายว่าระบบอาจให้คะแนนกระบวนการเต็มสำหรับสิ่งที่ agent ทำได้ภายใต้เงื่อนไขนั้น ขณะที่ผลลัพธ์รวมยังเป็นไม่สำเร็จ เพราะผู้ใช้ไม่ได้รับสินค้าตามเป้าหมาย
ทีมยังพิจารณาสถานการณ์ที่มีสินค้าทดแทนหรือมีวิธีทำงานอื่น แต่การนำหลักนี้ไปใช้จริงต้องระบุขอบเขตให้ชัดว่าผู้ใช้ยอมรับทางเลือกใดบ้าง ตัวอย่างในงานวิจัยไม่ได้เป็นเหตุผลให้ agent เปลี่ยนสินค้าเองได้เสมอ
เมื่อแยกคะแนนเช่นนี้ ทีมพัฒนาจะเลือกวิธีแก้ได้ตรงกว่าเดิม การเลือกสินค้าผิด การค้นข้อมูลผิด และการพบว่าสินค้าหมด อาจทำให้ผลลัพธ์ไม่สำเร็จเหมือนกัน แต่ไม่ได้ต้องการการแก้ไขแบบเดียวกัน ดูตัวอย่างการให้คะแนนในช่วง 07:52–10:23
ใครเป็นคนตรวจตัวตรวจ
เหตุผลที่อ่านแล้วน่าเชื่อยังไม่เพียงพอจะพิสูจน์ว่าตัวตรวจตัดสินถูก ทีมจึงสร้างกระบวนการให้ผู้ตรวจที่เป็นคนอ่านหลักฐานตลอดลำดับงานและตัดสินก่อน จากนั้นจึงเปิดผลของ Universal Verifier ให้พิจารณาว่าเห็นด้วยหรือไม่
ตามที่ทีมรายงาน ตัวตรวจช่วยชี้รายละเอียดที่คนมองข้ามได้ และลดกรณีที่ตัดสินว่าสำเร็จทั้งที่งานไม่สำเร็จ หรือ false positive ลงอย่างมากในชุดทดลอง ผลนี้สนับสนุนประโยชน์ของการใช้ตัวตรวจช่วยอ่านหลักฐาน แต่ไม่ได้แปลว่าทุกคำตัดสินของระบบจะถูกต้อง
ทีมใช้ Cohen’s kappa วัดความสอดคล้องของคำตัดสิน และรายงานค่าประมาณ 0.58 โดยกล่าวว่าระดับที่ Universal Verifier เห็นตรงกับคนใกล้เคียงกับระดับที่ผู้ตรวจสองคนเห็นตรงกันเอง ค่านี้ไม่ใช่ความแม่นยำ 58% เพราะ kappa เป็นตัววัดความสอดคล้องที่คำนึงถึงโอกาสเห็นตรงกันโดยบังเอิญด้วย
อีกคำถามสำคัญคือ ทีมปรับตัวตรวจจนจำลักษณะของชุดประเมินไปแล้วหรือไม่ ในช่วงถามตอบ Corby อธิบายว่ามีลำดับงานประมาณ 150 ชุด ใช้ประมาณ 50 ชุดปรับระบบ ส่วนอีกประมาณ 100 ชุดกันไว้ประเมินภายหลัง โดยแต่ละชุดที่กันไว้มีผู้ตรวจสองคน
การกันข้อมูลไว้ช่วยลดความเสี่ยงที่ผลดีจะมาจากการปรับระบบให้เข้ากับตัวอย่างเดิม แต่ยังต้องอ่านตัวเลขภายใต้ขอบเขตของข้อมูลและวิธีประเมินนั้น การเห็นตรงกับคนในชุดทดสอบหนึ่งไม่ใช่การรับประกันว่างานทุกประเภทจะได้ผลเท่ากัน
สำหรับการนำไปใช้กับงานขององค์กร หลักที่ถ่ายโอนได้คือแยกงานที่ใช้ปรับ prompt ออกจากงานที่ใช้ประเมินระบบ และให้คนมีคำตัดสินเบื้องต้นก่อนเห็นคำตอบของ AI กระบวนการตรวจด้วยคนอยู่ในช่วง 10:26–12:16 ส่วน การแบ่งชุดข้อมูลอธิบายในช่วง 19:03–20:34
ผลต่อข้อมูลฝึกและการทดลองด้วย AI
ทีมทดสอบต่อว่าตัวตรวจที่ดีขึ้นส่งผลต่อโมเดลที่ฝึกตามมาหรือไม่ โดยเปรียบเทียบการฝึกแบบเรียนรู้จากตัวอย่าง หรือ supervised fine-tuning (SFT) ที่ใช้จำนวนลำดับงานเท่ากันในแต่ละเงื่อนไข คือ 3,000 หรือ 9,000 ชุด แต่เปลี่ยนตัวตรวจที่ใช้คัดว่าตัวอย่างใดเป็นงานที่สำเร็จ
ผู้บรรยายรายงานว่า การคัดข้อมูลด้วยคะแนนกระบวนการของ Universal Verifier ให้โมเดลที่มีคุณภาพดีกว่าการใช้ตัวตรวจพื้นฐานในการทดลองนี้ จึงเป็นหลักฐานอีกด้านหนึ่ง นอกเหนือจากความสอดคล้องกับคน ว่าคุณภาพการตรวจมีผลต่อคุณภาพข้อมูลที่นำไปฝึก
แม้ทีมที่นำ AI ไปใช้จะไม่ได้ฝึกโมเดลเอง หลักการนี้ก็ใช้กับคลังตัวอย่างงานได้ ตัวอย่างที่เก็บไว้สอนวิธีทำงานหรือใช้ปรับ prompt ควรตรวจผลลัพธ์ก่อน ไม่ควรเลือกเพียงเพราะคำตอบอ่านลื่นหรือมีข้อความว่างานเสร็จแล้ว ข้อนี้เป็นแนวทางประยุกต์จากผลทดลอง ไม่ใช่ผลวัดจากธุรกิจที่ใช้ระบบจริงในคลิป
AI เร่งรอบทดลองได้ แต่จุดตั้งต้นยังมีผล
อีกการทดลองให้ AI ช่วยพัฒนาตัวตรวจผ่าน autoresearch หรือวงรอบเสนอการปรับระบบ ทดลอง และประเมินผล ทีมมนุษย์ใช้เวลาประมาณสามสัปดาห์กับการทดลองราว 30 ครั้ง ส่วนระบบ AI ทำจำนวนการทดลองใกล้เคียงกันได้ในประมาณหนึ่งวัน
ความเร็วไม่ได้ทำให้ผลเท่ากันทันที เมื่อถอดโค้ดและ prompt ที่ทีมสร้างออกแล้วให้ AI เริ่มใหม่ ผู้บรรยายรายงานว่าระบบไปถึงประมาณ 70% ของระดับความสอดคล้องกับคนที่ตัวตรวจของทีมทำได้ ตัวเลขนี้เป็นการเทียบกับระดับของระบบที่ทีมสร้าง ไม่ใช่ความแม่นยำ 70%
เมื่อให้ AI เริ่มจากข้อค้นพบที่มนุษย์ได้จากการทดลองก่อนหน้า ทีมกลับรายงานว่าการปรับระบบไปได้สูงกว่าผลที่มนุษย์ทำไว้ บทเรียนของการทดลองจึงอยู่ที่การใช้ความเข้าใจปัญหาของคนร่วมกับความเร็วในการทดลองของ AI มากกว่าข้อสรุปว่า AI สามารถพัฒนาตัวตรวจที่น่าเชื่อถือได้เองทุกกรณี ผลด้านข้อมูลฝึกและ autoresearch อยู่ในช่วง 12:20–16:12
นำหลักการไปใช้กับงานจริง
ข้อเสนอสำหรับเริ่มทดลองกับงานของทีมคือ เลือกหนึ่งงานที่นิยามผลลัพธ์ได้และเก็บหลักฐานระหว่างทางได้ครบ แล้วออกแบบการตรวจให้ตอบคำถามต่อไปนี้
- คำสั่งต้องการผลลัพธ์อะไรแน่ แยกงานที่ต้องทำ ข้อจำกัด และสิ่งที่ต้องส่งมอบ ตรวจทุกข้อใน rubric ว่ามาจากคำสั่งจริง
- อะไรพิสูจน์ว่าแต่ละข้อสำเร็จ ระบุภาพหน้าจอ ข้อมูลต้นทาง หรือสถานะปลายทางที่ต้องเห็น พร้อมเก็บประวัติการกระทำและคำตอบสุดท้ายไว้ให้ตรวจย้อนกลับได้
- คำตอบของ agent ตรงกับหลักฐานหรือไม่ ตรวจตัวเลข ชื่อ รายการที่เลือก และคำยืนยันว่าดำเนินการแล้ว หากหลักฐานไม่พอ ควรแยกไว้ให้คนตรวจ แทนการสรุปว่าผ่าน
- พลาดที่ขั้นไหน และงานสำเร็จหรือยัง แยกคะแนนรายขั้นจากผลลัพธ์รวม พร้อมระบุว่าเป็นความผิดของ agent หรือข้อจำกัดภายนอก
- ตัวตรวจทำงานได้กับกรณีใหม่หรือไม่ กันชุดงานสำหรับประเมินไว้ล่วงหน้า และอย่านำชุดนั้นกลับไปใช้ปรับ prompt ระหว่างพัฒนา
- งานที่ให้ผ่านมีอะไรหลุดบ้าง สุ่มให้คนตรวจงานที่ระบบตัดสินว่าสำเร็จด้วย เพราะถ้าดูเฉพาะงานที่ระบบแจ้งว่าล้มเหลว จะมองไม่เห็นกรณีที่ผ่านอย่างผิด ๆ
หากเจอ rubric เพิ่มเงื่อนไขเอง ให้ย้อนเทียบกับคำสั่งต้นฉบับ หากภาพมีครบแต่ตัวตรวจข้ามรายละเอียด ให้ตรวจการเลือกหลักฐานรายเกณฑ์ และหากผลดีเฉพาะชุดที่ใช้ปรับระบบ ให้ทบทวนการแยกข้อมูลประเมิน ปัญหาเหล่านี้ต้องแก้คนละจุด การเปลี่ยนโมเดลอย่างเดียวอาจไม่แตะสาเหตุ
เกณฑ์ที่มีประโยชน์จึงไม่จบที่คำว่า “ผ่าน” แต่ต้องช่วยตอบต่อได้ว่า ผ่านเพราะหลักฐานใด มีส่วนไหนยังไม่บรรลุเป้าหมาย และควรแก้ที่ตัว agent สภาพแวดล้อม หรือวิธีตรวจ
ขอบเขตของผลทดลองและแหล่งที่มา
การบรรยายนี้เน้นงานของ agent บนเว็บ ในช่วงถามตอบทีม Microsoft กล่าวว่ากำลังนำแนวทางไปทดลองกับงานบนเดสก์ท็อป ซึ่งมีข้อมูลจาก terminal บันทึกเหตุการณ์ และข้อมูลระบบให้ใช้เพิ่มเติม ข้อความนั้นเป็นแผนงานในช่วงที่บรรยาย ไม่ใช่การยืนยันว่าโครงการต่อยอดเผยแพร่แล้วในปัจจุบัน
ทีมยังตั้งข้อสังเกตว่าชุดทดสอบสาธารณะบางชุดเริ่มแยกความสามารถของโมเดลได้ยาก และกังวลว่างานในชุดทดสอบอาจใกล้เคียงกับข้อมูลที่ใช้ฝึก นี่เป็นข้อสังเกตของผู้บรรยาย ไม่ใช่หลักฐานว่าทุกโมเดลปนเปื้อนข้อมูลทดสอบ ประเด็นที่นำไปใช้ได้คือการประเมินบนงานใหม่ซึ่งสะท้อนสิ่งที่ผู้ใช้ต้องทำจริง
ผลทดลองของ Universal Verifier ชี้ให้เห็นว่าการตรวจงานสมควรได้รับความใส่ใจพอ ๆ กับการทำให้ agent ทำงานได้มากขึ้น คะแนนที่สูงขึ้นจะบอกอะไรได้ก็ต่อเมื่อเกณฑ์ตรงกับโจทย์ และคำตัดสินตรวจย้อนกลับไปถึงหลักฐานได้
แหล่งที่มา: เรียบเรียงจากวิดีโอ Your LLM Judge Is a Confident Liar: Building Better Verifiers — Browserbase ช่อง AI Engineer บรรยายโดย Miguel González Fernández และ Corby Rosset ต้นฉบับแนบลิงก์ บทความวิจัยบน arXiv และ คลังโค้ด Fara ของ Microsoft สำหรับอ่านรายละเอียดเพิ่มเติม
ตัวเลข ผลการทดลอง และแผนพัฒนาในบทความเป็นสิ่งที่ผู้บรรยายรายงานในวิดีโอต้นทาง ส่วนแนวทางนำไปใช้กับงานของทีมเป็นข้อเสนอเชิงประยุกต์จากหลักการในคลิป
