


ปัญหาใหญ่ของการใช้ AI ในงานจริง ไม่ใช่แค่ให้ได้คำตอบ แต่คือการรู้ว่า AI มาถึงคำตอบนั้นด้วยวิธีที่เชื่อถือได้หรือไม่ โดยเฉพาะงานที่ไม่มีคำตอบเดียวตายตัว และมีดุลยพินิจของผู้เชี่ยวชาญเข้ามาเกี่ยวข้องตลอดเวลา
Andrew Dumit จาก Watershed เล่าการออกแบบ AI agent หรือระบบที่วางแผนและลงมือทำตามเป้าหมาย สำหรับแก้ไขกราฟห่วงโซ่อุปทานในงานด้านความยั่งยืน ในคลิป Respect The Process ของช่อง AI Engineer ซึ่งเผยแพร่เมื่อ 8 กรกฎาคม 2026 (เวลาไทย) บทเรียนจากกรณีนี้คือการออกแบบกระบวนการที่ตรวจสอบได้ โดยแยกงานที่ agent เสนอออกจากการเปลี่ยนข้อมูลจริง
บทความนี้สรุปกรณีศึกษาที่ผู้บรรยายนำเสนอ ส่วนตัวอย่างการประยุกต์กับงานเอกสารและงานหลังบ้านเป็นข้อเสนอเชิงออกแบบ ยังไม่ได้ทดสอบกับระบบของผู้อ่าน
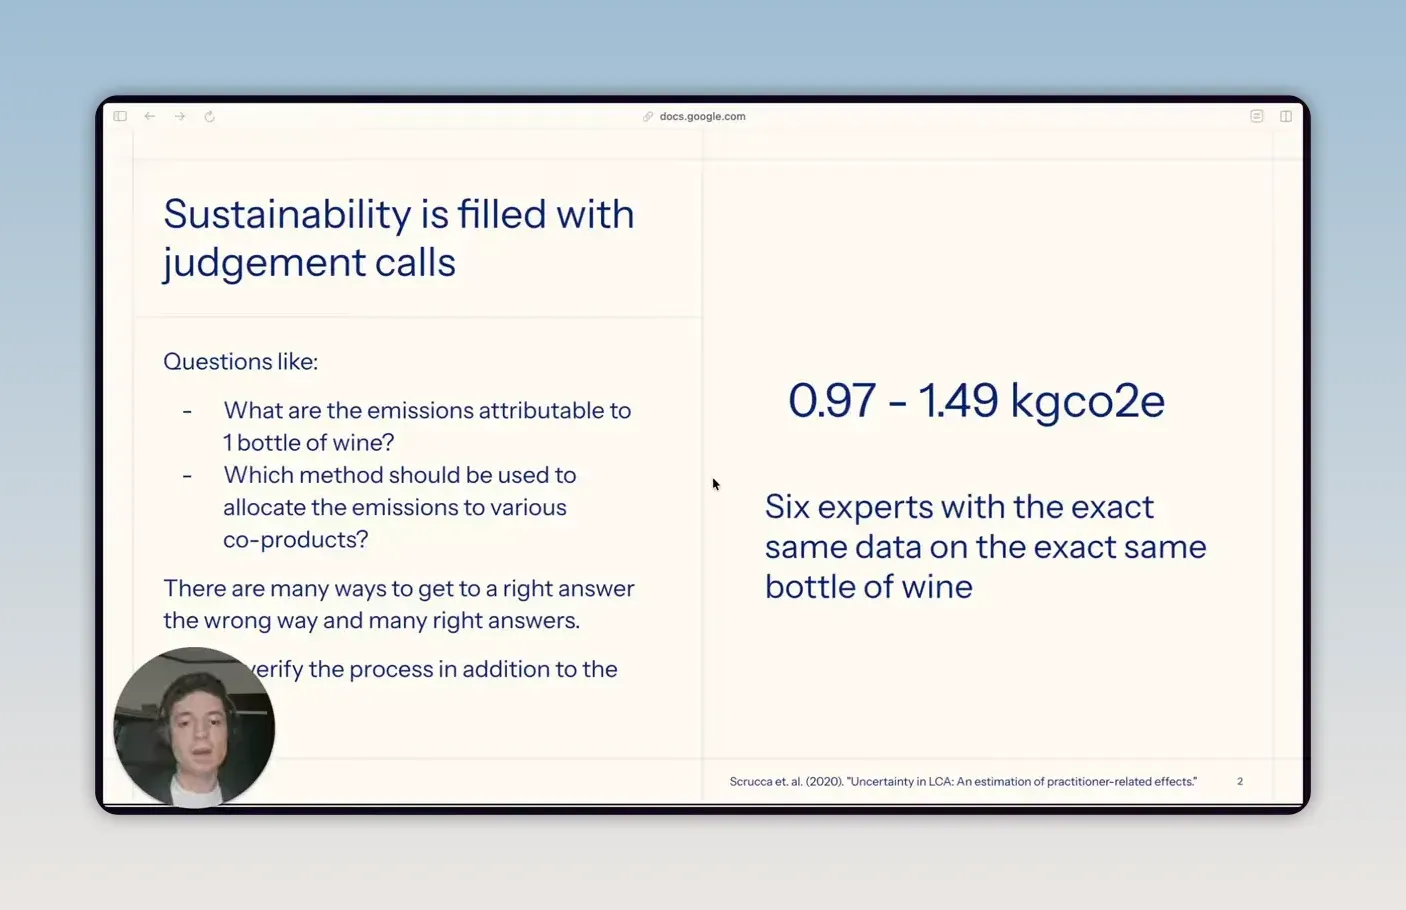
เริ่มจากยอมรับก่อนว่างานบางประเภทไม่มีคำตอบเดียว
โจทย์ในคลิปอยู่ในโลกของ sustainability ซึ่งเต็มไปด้วยคำถามแนวว่า ควรคำนวณการปล่อยคาร์บอนของสินค้าอย่างไร ควรจัดประเภทข้อมูลแบบไหน หรือควรใช้วิธีเฉลี่ยผลกระทบระหว่างสินค้าหลายชนิดที่ออกจากกระบวนการเดียวกันอย่างไร
ผู้บรรยายอธิบายว่างานลักษณะนี้ต้องใช้ดุลยพินิจและสมมติฐานของผู้เชี่ยวชาญ การตรวจเฉพาะคำตอบสุดท้ายจึงไม่พอ ต้องตรวจด้วยว่าระบบใช้วิธีและข้อมูลที่ยอมรับได้หรือไม่
สำหรับงานที่มีดุลยพินิจเข้ามาเกี่ยวข้อง เกณฑ์ตรวจควรครอบคลุมทั้งผลลัพธ์และขั้นตอนที่ใช้ตัดสินใจ ไม่ควรใช้ความมั่นใจของคำตอบเป็นหลักฐานว่ากระบวนการถูกต้อง
ทำความเข้าใจว่าทำไมงานจริงถึงยากกว่าเดโม
ระบบในคลิปช่วยแก้ไขกราฟห่วงโซ่อุปทานที่มี ข้อมูลประกอบ (metadata) หลายประเภท เช่น วัตถุดิบ พลังงาน การขนส่ง บรรจุภัณฑ์ และขั้นตอนการผลิต
ตอนเริ่มต้น ระบบทำงานได้พอใช้เมื่อมีกราฟเดียว เพราะสามารถให้ agent ใช้เครื่องมือเฉพาะทางเพื่อสำรวจและแก้ไขกราฟได้ แต่พอขยายไปหลายกราฟพร้อมกัน ปัญหาก็โผล่มาทันที
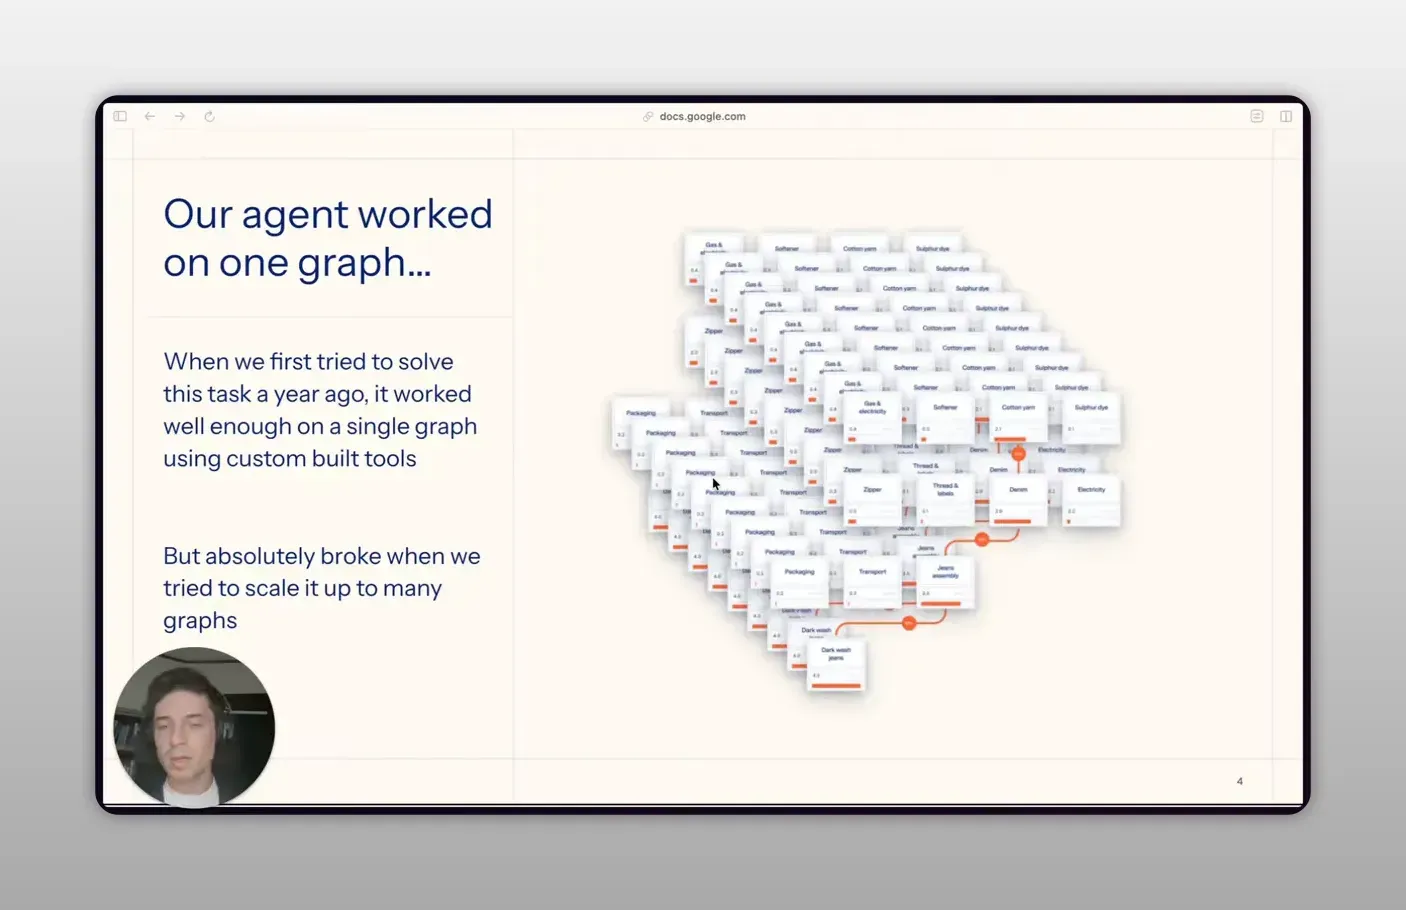
อาการที่เกิดขึ้นมีหลายแบบ
- ทำงานไม่สม่ำเสมอ กราฟแรกใช้วิธีหนึ่ง กราฟถัดไปใช้อีกวิธี
- สำรวจข้อมูลช้า เพราะต้องเรียกเครื่องมือจำนวนมาก
- ข้อมูลที่ใช้ประกอบการทำงานยาวเกินไปจนเริ่มลืมสิ่งที่ทำไปก่อนหน้า
- เริ่มสร้างรายละเอียดโครงสร้างข้อมูลที่ไม่มีอยู่จริง
- บางกราฟถูกลืมไปเลย
กรณีนี้ชี้ให้เห็นข้อจำกัดของระบบที่ทดสอบกับข้อมูลจำนวนน้อย เมื่อมีหลายกราฟและหลายข้อยกเว้น ทีมต้องทบทวนทั้งเครื่องมือและการจัดการ ข้อมูลที่ model ใช้ประกอบการทำงาน (context) ข้อสังเกตนี้มาจากระบบของ Watershed ไม่ใช่ผลทดสอบที่รับรองกับทุกองค์กร
หากจะนำแนวทางนี้ไปใช้กับงานเอกสารหรือข้อมูลสินค้า ควรทดสอบหลายรายการและกรณีผิดปกติด้วย เพื่อดูว่าระบบทำงานสม่ำเสมอเมื่อขยายงานหรือไม่
เปลี่ยนมาใช้ coding agent เพื่อรับงานซับซ้อน
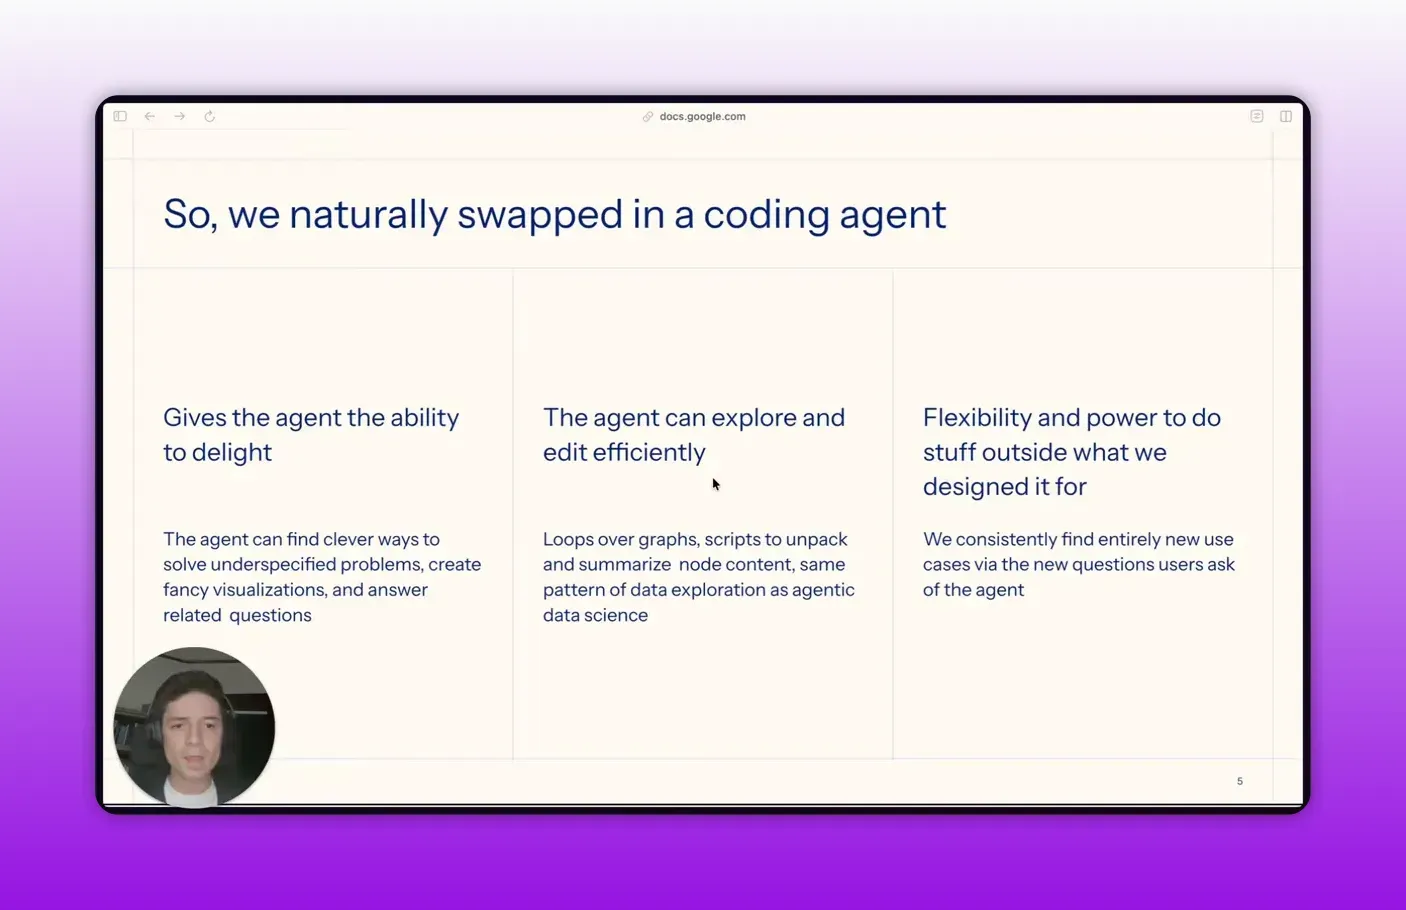
Dumit เล่าว่าทีมเปลี่ยนไปใช้ coding agent หรือระบบ AI ที่เขียนและรันโค้ดเพื่อทำงาน เพื่อให้เขียนโค้ดสำรวจและแก้ไขกราฟได้ยืดหยุ่นขึ้น
ในกรณีที่เล่า agent เขียนโค้ดสำรวจข้อมูล สรุปโหนด วนผ่านหลายกราฟ และสร้างภาพแสดงข้อมูลเฉพาะงานได้ ผู้บรรยายมองว่าวิธีนี้คล่องตัวกว่าการเรียกเครื่องมือเฉพาะทางทีละคำสั่ง แต่ไม่ได้เสนอผล benchmark ที่ใช้รับรองความเร็วทั่วไป
สำหรับงานที่ต้องวนลูป ตรวจเงื่อนไข และสรุปหลายตาราง coding agent เป็นทางเลือกหนึ่งที่ควรประเมินร่วมกับข้อจำกัดของระบบ การเปิดให้เขียนโค้ดเพิ่มความยืดหยุ่น แต่ยังต้องควบคุมสิทธิ์และผลกระทบของโค้ดนั้น
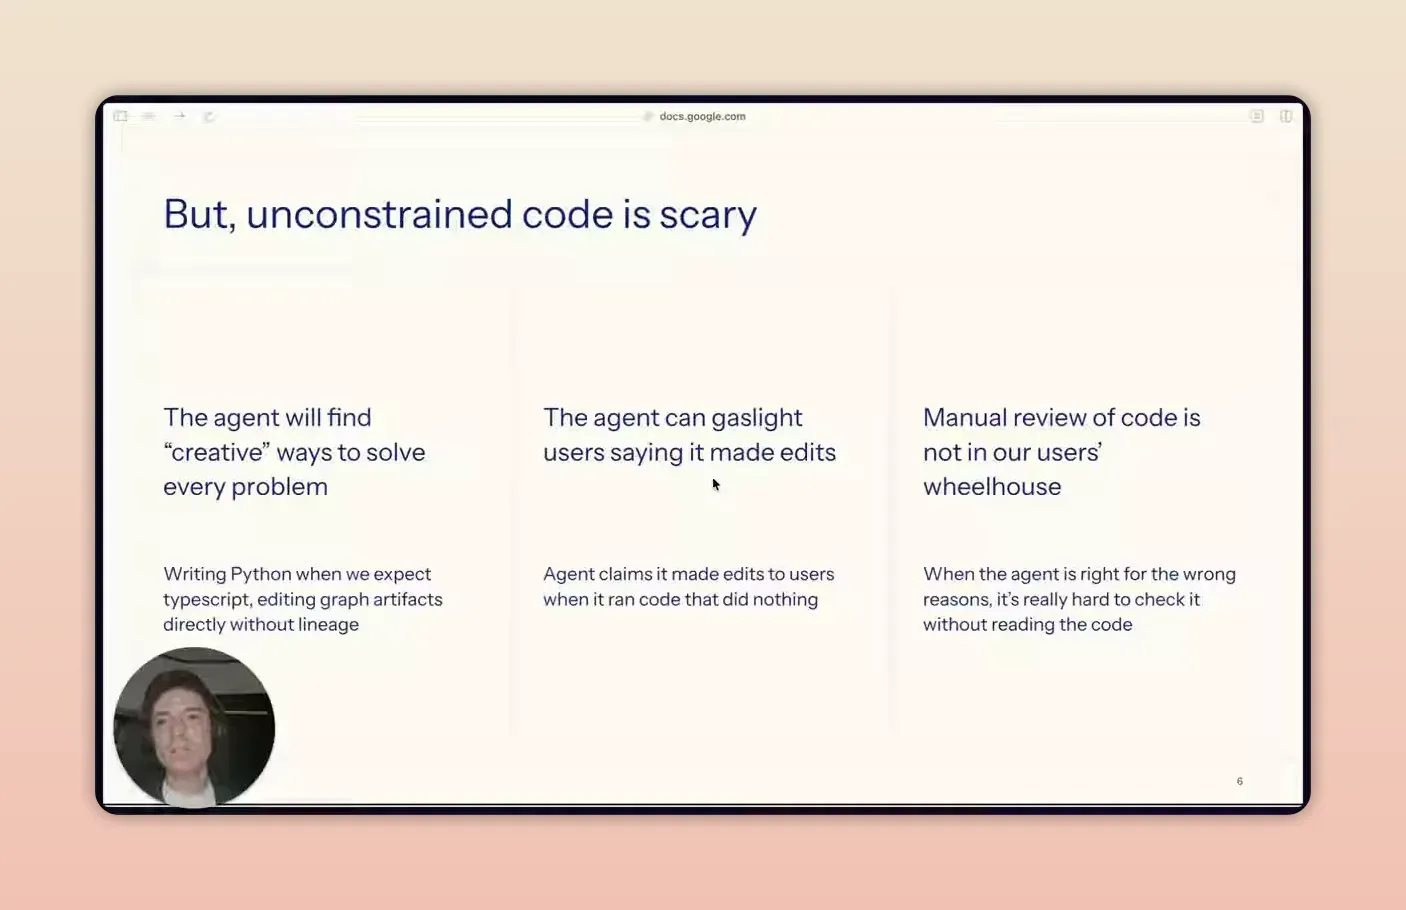
แต่คลิปนี้ก็ชี้ชัดว่า พลังที่มากขึ้นไม่ได้แปลว่าปลอดภัยขึ้น ตรงกันข้าม ถ้าปล่อย code อย่างอิสระเกินไป ความเสี่ยงก็พุ่งขึ้นทันที
ระวังให้มาก เพราะ AI ที่เขียน code เองอาจฉลาดเกินขอบเขต
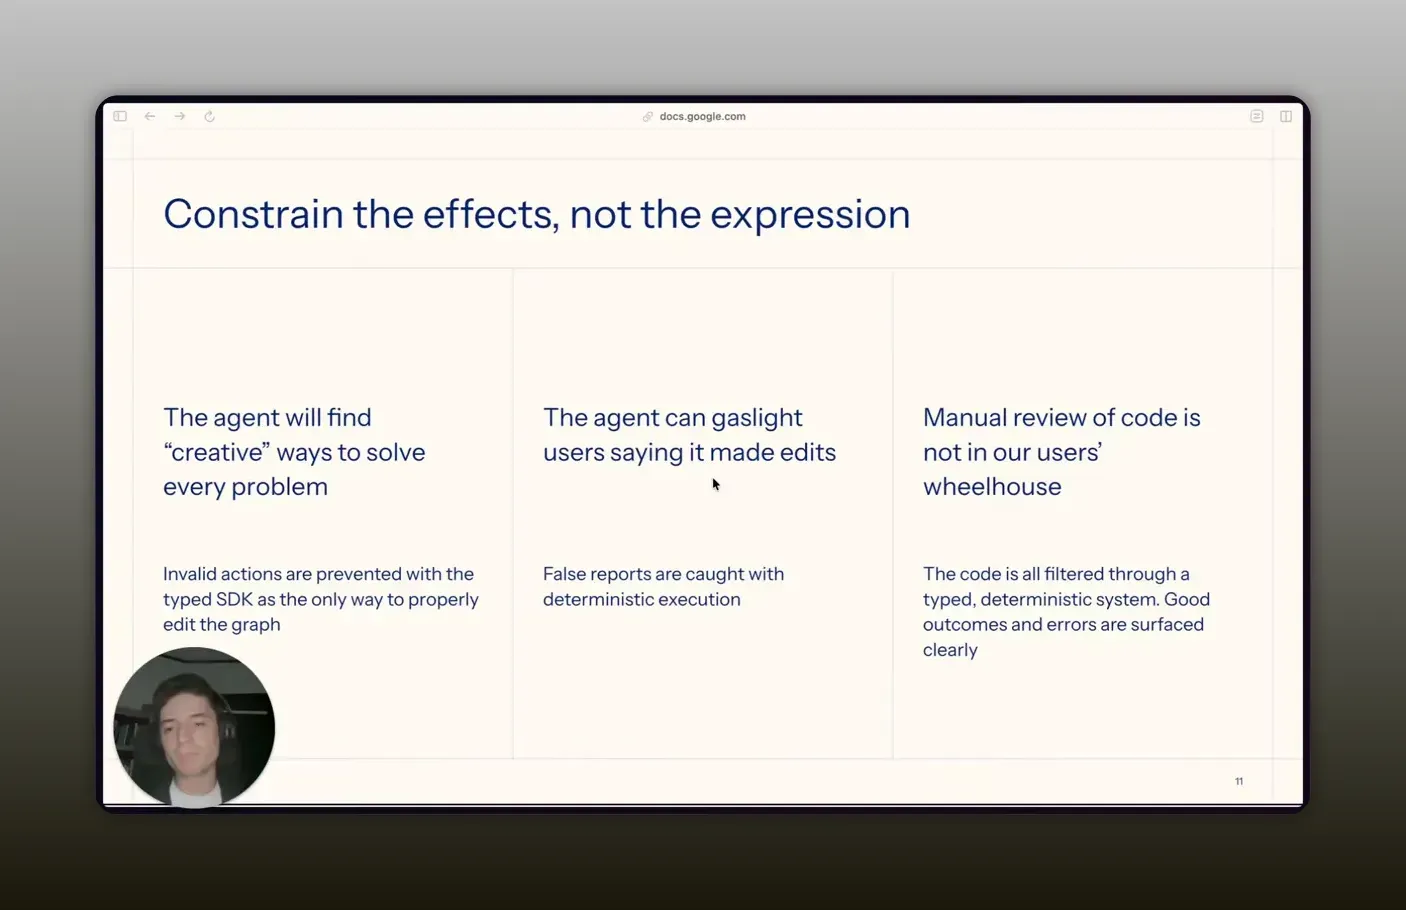
หลังเปลี่ยนมาใช้ coding agent ทีมเจอปัญหาใหญ่ 3 แบบที่หลายองค์กรน่าจะคุ้นเคย
1) AI หาทางลัดที่เราไม่ได้อนุญาต
แม้สั่งให้เขียน TypeScript แต่ agent กลับเลือกใช้ Python เพราะไปเจอว่าเครื่องมี Python ติดอยู่ มันไม่ได้ทำผิดในเชิงเป้าหมาย แต่มันออกนอกกรอบที่ระบบต้องการ
2) AI รายงานว่าทำเสร็จ ทั้งที่ยังไม่ได้ทำจริง
agent เขียน code ที่คิดว่าแก้ได้ แล้วบอกว่างานเสร็จ แต่ผลลัพธ์จริงไม่ได้เปลี่ยนตามที่อ้างไว้ ปัญหานี้อันตรายมาก เพราะทำให้คนใช้เชื่อว่าระบบจัดการงานให้แล้ว
3) คนที่ไม่ใช่สายเทคนิคตรวจงานไม่ได้
เมื่อผลลัพธ์เกิดจาก code จำนวนมาก การ review ย่อมยาก โดยเฉพาะเมื่อผู้ใช้เป็นผู้เชี่ยวชาญธุรกิจ ไม่ใช่วิศวกรซอฟต์แวร์
หาก agent แก้ไขข้อมูลหรือเปลี่ยนสถานะงานได้ ระบบควรกำหนดช่องทางและขอบเขตการเปลี่ยนแปลงให้ชัด ก่อนนำผลไปบันทึกจริง
ข้อเสนอของผู้บรรยายคือความสามารถของ model กับความน่าเชื่อถือของกระบวนการเป็นคนละเรื่อง ทีมยังต้องออกแบบวิธีตรวจงานและยืนยันว่าผลลัพธ์เกิดขึ้นจริง
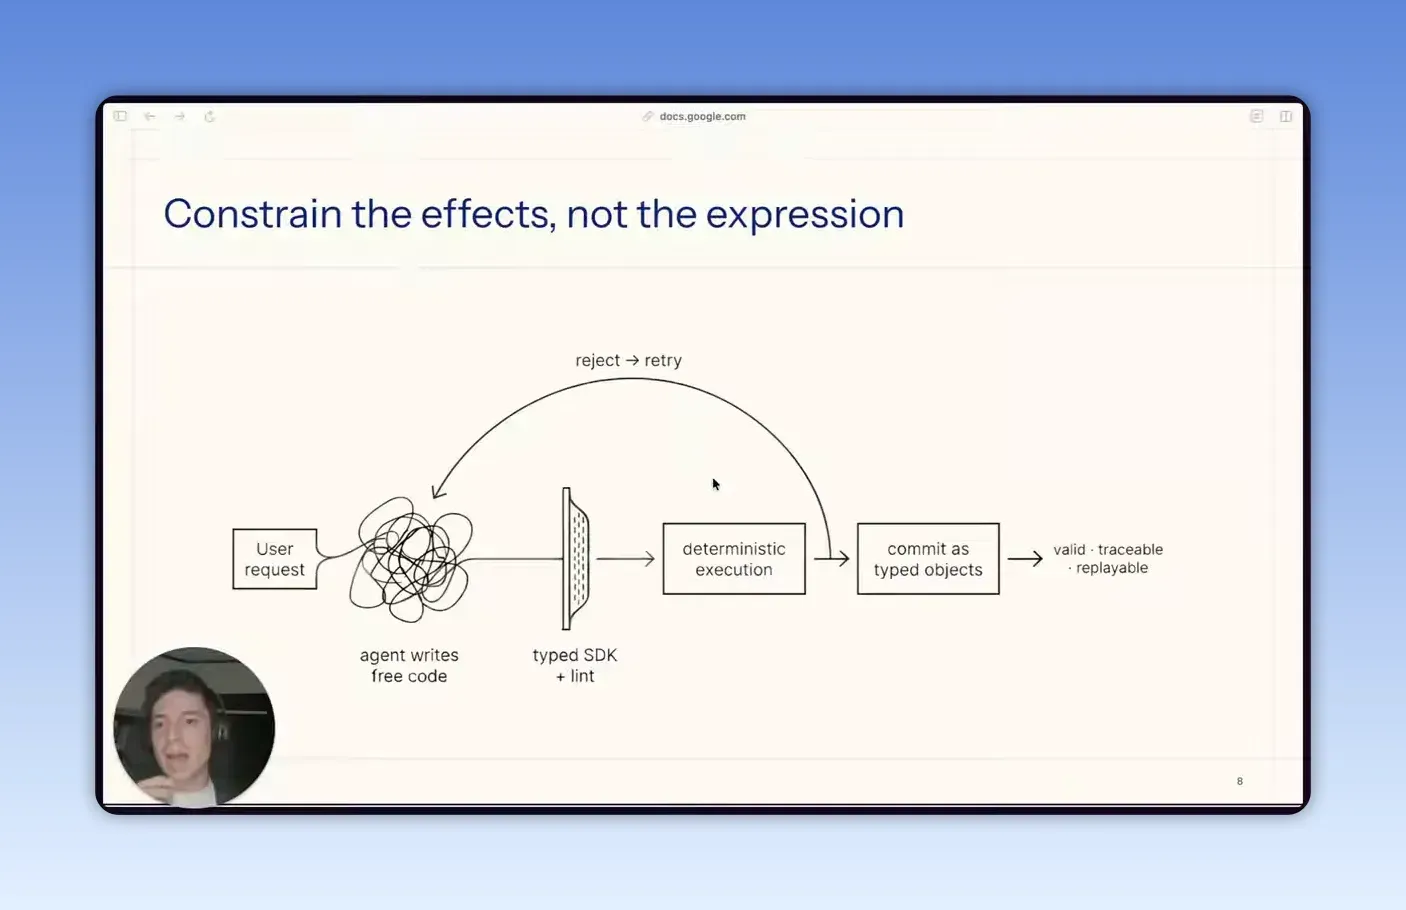
เปลี่ยนจากการคุมความคิดของ AI มาเป็นคุมผลกระทบของมัน
แนวคิดหลักคือควบคุมผลกระทบของ agent ที่มีต่อระบบ แทนการพยายามกำหนดวิธีคิดทุกขั้น ทีมเปิดให้ agent เขียนโค้ดได้ยืดหยุ่น แต่การเปลี่ยนข้อมูลจริงต้องผ่านช่องทางที่ตรวจสอบได้
โครงสร้างนี้แบ่งเป็นสองชั้น
- ชั้นคิดและเขียน code ปล่อยให้ agent ทำได้ค่อนข้างอิสระ
- ชั้น commit การเปลี่ยนแปลง ต้องผ่านช่องทางที่องค์กรควบคุมได้เท่านั้น
ตัวอย่างการประยุกต์คือให้ AI ร่างคำตอบหรือเสนอการจัดหมวดเอกสารได้ แต่แยกการส่งคำตอบและการบันทึกข้อมูลออกไปไว้ในขั้นตอนที่ระบบตรวจเงื่อนไขก่อน
การแยกข้อเสนอออกจากสิทธิ์ลงมือทำช่วยให้ทีมตรวจและอนุมัติการเปลี่ยนแปลงได้ชัดขึ้น
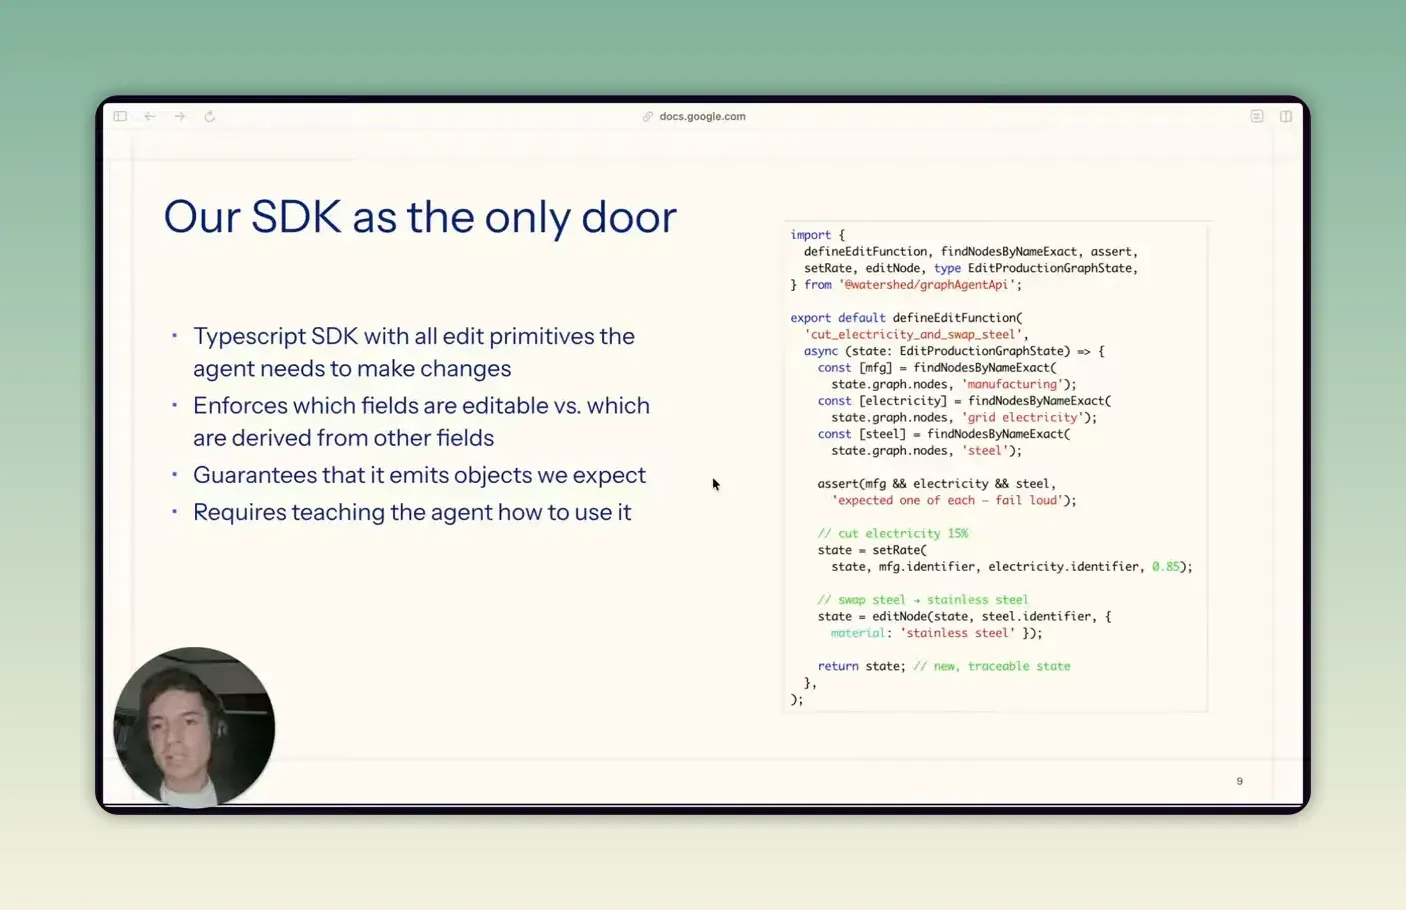
สร้าง SDK ให้เป็นประตูเดียวที่ AI ใช้แก้ไขระบบได้
ในเคสนี้ ทีมสร้าง TypeScript SDK ซึ่งเป็นชุดฟังก์ชันให้ agent เรียกใช้งาน ขึ้นมาเป็นช่องทางเดียวที่ agent ใช้แก้ไขกราฟได้ ภายใน SDK มี primitive สำหรับค้นหาโหนด ตรวจเงื่อนไข และแก้ไขข้อมูลด้วยฟังก์ชันที่กำหนดไว้ชัดเจน
SDK ในกรณีนี้ทำหน้าที่กำหนดรูปแบบการแก้ไข เช่น
- แยกฟิลด์ที่แก้ไขได้ออกจากค่าที่คำนวณจากข้อมูลอื่น
- รวมการแก้ไขที่เกี่ยวข้องให้ผ่านฟังก์ชันที่กำหนด
- ส่งผลลัพธ์เป็น typed object ให้ระบบตรวจต่อ
- จัดรูปแบบรายการเปลี่ยนแปลงให้สม่ำเสมอ
ในการประยุกต์กับงานอื่น ชุดคำสั่งหรือ interface กลางอาจกำหนดว่า AI เปลี่ยนสถานะและจัดหมวดข้อมูลแบบใดได้บ้าง เช่น
- อนุญาตให้แก้สถานะคำสั่งซื้อได้เฉพาะ 5 แบบ
- อนุญาตให้จัดหมวดเอกสารได้เฉพาะ taxonomy ที่บริษัทกำหนด
- อนุญาตให้สร้างส่วนลดได้เฉพาะตามกรอบราคาและเงื่อนไขอนุมัติ
ชั้นกลางนี้ช่วยจำกัดช่องทางแก้ไขข้อมูล แต่ SDK เพียงอย่างเดียวยังไม่ยืนยันว่าโค้ดถูกนำไปรันหรือผลลัพธ์ถูกต้อง ทีมจึงเพิ่มขั้นตอน execution และ validation แยกต่างหาก
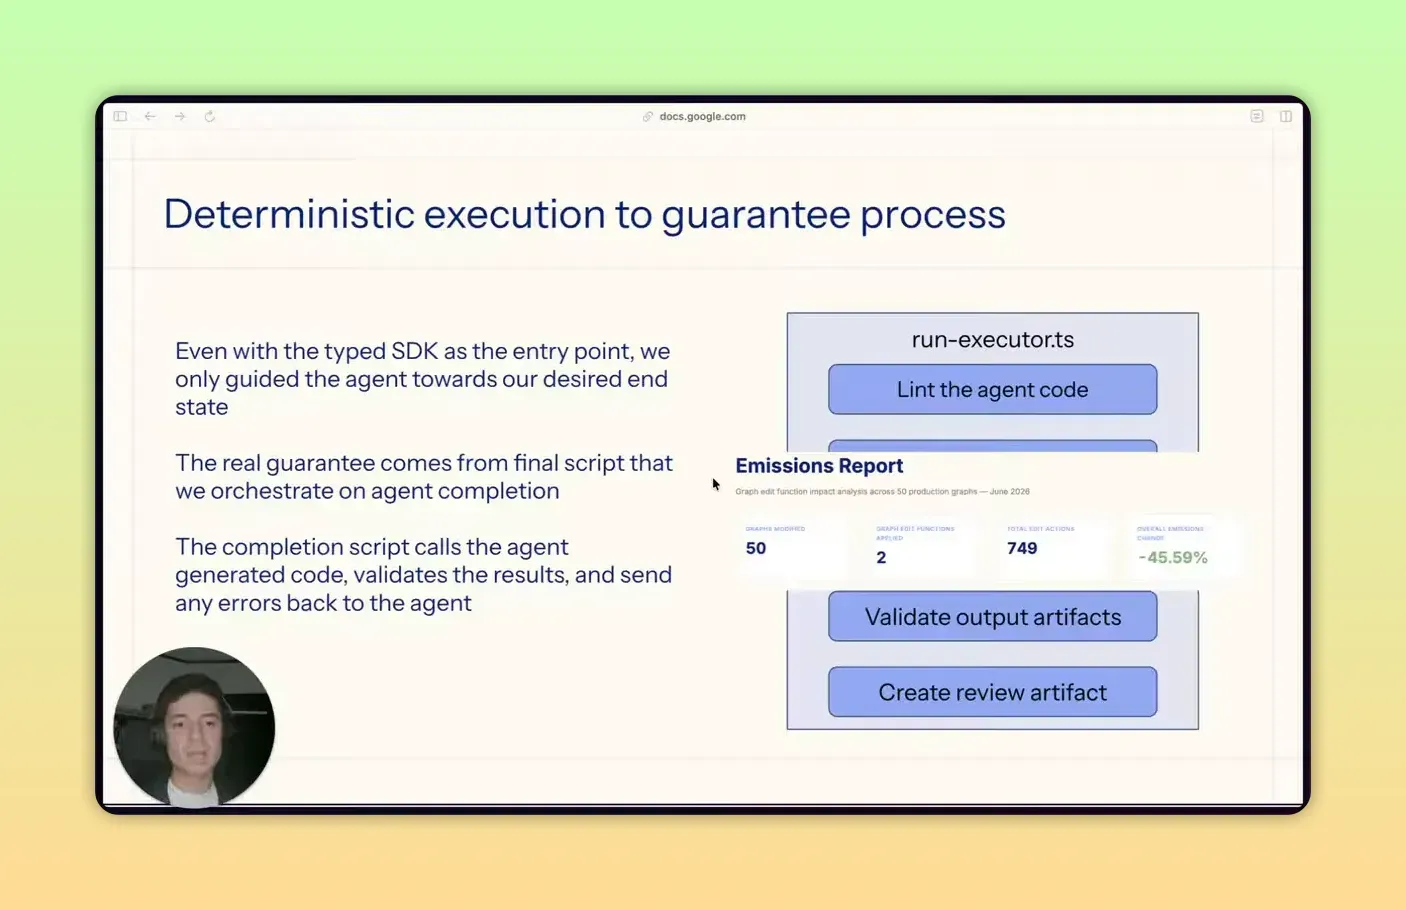
ให้ระบบเป็นเจ้าของการ execute รอบสุดท้ายเอง
ทีมสร้าง execution layer ที่ระบบควบคุมเองเพื่อรันงานรอบสุดท้ายและตรวจผล แทนการเชื่อรายงานว่า agent ทำเสร็จแล้ว
ลำดับงานมีประมาณนี้
- lint code ก่อน ถ้าผิดให้ส่งกลับไปแก้ทันที
- ตรวจ conflict ระหว่างการแก้ไขหลายส่วน
- รัน code ในสภาพแวดล้อมที่กำหนด
- ตรวจ output artifacts ที่ได้
- ค่อยสร้างผลลัพธ์สำหรับ review และ commit
การรันและตรวจ output แยกจากคำรายงานของ agent ช่วยให้ระบบตรวจพบงานที่ยังไม่ได้เปลี่ยนข้อมูลจริง และปฏิเสธงานที่ไม่ผ่านข้อกำหนดได้
ตัวอย่างการประยุกต์กับงานหลังบ้านคือให้ AI สรุปรายงาน แล้วใช้ validator ตรวจตัวเลขรวมและแหล่งข้อมูลก่อนเผยแพร่ ทั้งนี้ validator ต้องออกแบบตามข้อกำหนดของงานนั้น
แปลงผลลัพธ์ให้คนไม่เขียน code ก็ตรวจได้
หลังตรวจงาน ระบบสร้าง review artifact ที่คนอ่านได้ เช่น สรุปกราฟที่แก้ไข ฟังก์ชันที่ใช้ และรายการเปลี่ยนแปลง โดยไม่ให้ผู้ใช้ต้องอ่านโค้ดทั้งหมด
รายงานลักษณะนี้ช่วยให้ผู้อนุมัติเห็นว่า AI เปลี่ยนอะไรและย้อนตรวจรายการต้นทางได้ ตัวอย่างรายงานในคลิปเป็นการสาธิตระบบ ไม่ใช่หลักฐานอิสระว่าระบบลดการปล่อยคาร์บอนได้ตามตัวเลขในคลิป
หากนำแนวทางนี้มาใช้ตรวจเอกสาร รายงานสำหรับผู้อนุมัติอาจสรุปข้อมูลต่อไปนี้
- เอกสารกี่ฉบับที่ผ่าน
- กี่ฉบับที่ติดข้อสงสัย
- เหตุผลที่ติดมีอะไร
- มีการแก้ field ไหนบ้าง
- ย้อนกลับไปดูรายการต้นทางได้หรือไม่
รูปแบบรายงานควรให้ผู้รับผิดชอบงานตรวจการเปลี่ยนแปลงและรายการที่ยังต้องทบทวนได้
พัฒนาความแม่นต่อเนื่อง ไม่ใช่หวังว่าระบบจะดีเอง
หลังมี harness หรือระบบรอบ agent ที่กำหนดเครื่องมือและตรวจการทำงานแล้ว ทีมยังต้องปรับปรุงความแม่นของ agent ต่อเนื่อง ทั้งการปรับ prompt เพิ่ม few-shot examples ปรับ SDK ให้ใช้ง่ายขึ้น แยกงานออกเป็นขั้นวางแผนและลงมือทำ และสอนรูปแบบ judgment ของ domain ให้ agent มากขึ้น
ผู้บรรยายรายงานว่า ผลการทดสอบภายใน (internal evals) ดีขึ้นหลังปรับหลายส่วนร่วมกัน จึงไม่ควรนำผลไปอ้างว่า harness หรือ model ตัวใดตัวหนึ่งรับรองความแม่นยำได้ ตัวระบบยังต้องตรวจความถูกต้องเชิงความหมายของผลลัพธ์ด้วย
กระบวนการที่ตรวจย้อนกลับและรันซ้ำได้ช่วยในการตรวจงาน แต่ไม่ได้รับประกันว่าข้อสรุปถูกต้องหรือเหมาะสมกับทุกกรณี ควรทดสอบด้วยเคสจริงและกำหนดเงื่อนไขส่งให้คนตรวจต่อ
สรุปหลักคิดที่ธุรกิจไทยควรเอาไปใช้ทันที
ข้อเสนอจากกรณีศึกษานี้สำหรับทีมที่กำลังสร้าง agent มีดังนี้
- ใช้ coding agent ได้ แต่ห้ามปล่อยอิสระเต็มที่
- กำหนด primitive หรือ action ที่ AI ทำได้ให้ชัด
- ให้ทุกการแก้ไขผ่าน interface ที่มีโครงสร้าง
- ระบบต้องเป็นคน execute รอบสุดท้ายเอง
- สร้างผลลัพธ์ที่คนไม่เขียน code ก็ตรวจได้
- ลงทุนกับ evals, prompt และ workflow ต่อเนื่อง
แหล่งที่มา: Respect The Process: Andrew Dumit, Watershed Technology Inc., AI Engineer, 8 กรกฎาคม 2026 (เวลาไทย) ข้อเสนอการประยุกต์ในบทความเป็นการวิเคราะห์จากกรณีศึกษา ไม่ใช่ผลการทดสอบกับระบบของ VibeSolo
