


AI อธิบายเรื่องทั่วไปได้คล่อง แต่พอถามว่าทำไมบริษัทเราจึงยอมรับเงื่อนไขพิเศษให้ลูกค้ารายหนึ่ง คำตอบอาจต้องอาศัยอีเมลหลายฉบับ บันทึกประชุม และข้อยกเว้นที่คนในทีมจำได้ การค้นเอกสารเจอกับการเข้าใจงานจนประยุกต์ใช้ได้เป็นคนละเป้าหมาย เราจึงต้องเลือกให้ชัดว่าอยากให้ AI ช่วยค้นหลักฐาน หรืออยากให้มันเรียนรู้ทักษะเฉพาะงาน
Jack Morris จาก Engram ตั้งคำถามนี้ใน Scaling Compute on Context บนช่อง AI Engineer วิดีโอเผยแพร่เมื่อ 12 สิงหาคม 2026 เขาเสนอกรอบคิดเรื่องการใช้การประมวลผลเพิ่มเติมกับข้อมูลเฉพาะชุดหนึ่ง เพื่อเพิ่มความรู้เชิงลึก แต่ระบุไว้ตั้งแต่ต้นว่าเป็นการอธิบายปัญหาวิจัยในภาพรวม ไม่ใช่รายงานผลทดลองอย่างละเอียดหรือคู่มือระบบที่รับรองผลแล้ว
ความรู้กว้างยังไม่ใช่ความชำนาญเรื่องงานเรา
ช่วง 1:14–2:23 Morris เปรียบเทียบความรู้กว้างของ AI กับความรู้ลึกที่ผู้เชี่ยวชาญสะสมจากการทำงานเฉพาะด้าน ความต่างที่เขาสนใจคือการเรียนรู้ข้อเท็จจริงและทักษะใหม่จากข้อมูลของเรา จนใช้กับคำถามที่ไม่ได้เขียนคำตอบไว้ตรง ๆ ในเอกสารได้
ในช่วง 2:35–4:16 เขายกข้อมูลใหม่ ทักษะที่มีตัวอย่างน้อย และบริบทส่วนตัวหรือบริษัทเป็นช่องว่างที่การฝึกโมเดลเดิมอาจไม่ครอบคลุม ประเด็นนี้ควรอ่านว่าโมเดลไม่ได้รู้ข้อมูลเหล่านั้นโดยอัตโนมัติ ไม่ใช่ข้อสรุปว่าเครื่องมือ AI ทุกวันนี้ค้นข้อมูลใหม่หรือรับบริบทเพิ่มเติมไม่ได้
สำหรับทีมที่กำลังทำระบบช่วยงาน ลองแยกสองโจทย์ก่อน ถ้าต้องการคำตอบตามนโยบายล่าสุด เราต้องรู้ว่าเอกสารฉบับใดเป็นแหล่งจริงและให้ระบบอ้างหลักฐานได้ แต่ถ้าต้องการให้ AI ตัดสินกรณีใหม่อย่างคนชำนาญงาน เราต้องทดสอบการประยุกต์ใช้ด้วย การตอบได้จากเอกสารหนึ่งฉบับยังไม่พิสูจน์ทักษะอย่างหลัง
เมื่อข้อมูลเฉพาะงานมีจำกัด เราจะใช้ compute เพิ่มอย่างไร
ช่วง 5:10 Morris วางกรอบการขยายโมเดลไว้สามแกน ได้แก่ข้อมูล การประมวลผล และขนาดโมเดล จากนั้นสมมติโจทย์ที่เริ่มด้วยโมเดลซึ่งผ่านการฝึกแล้วกับคลังข้อมูลเฉพาะชุดหนึ่ง เขาจึงถามว่า จะใช้ compute เพิ่มให้โมเดลรู้ข้อมูลชุดเดิมลึกขึ้นได้อย่างไร โดยไม่ต้องเริ่มฝึกโมเดลใหม่จากศูนย์
เขาปรับข้อสมมตินี้เองในช่วง 8:12–9:05: ในโลกจริงข้อมูลไม่ได้ตายตัวเสมอไป เราอาจหาแหล่งอื่นหรือถามคนที่รู้เรื่องเพิ่มได้ จึงไม่ควรตีความชื่อแนวคิดว่าบริษัทต้องหยุดเพิ่มข้อมูล แล้วแก้ทุกปัญหาด้วยการเพิ่มเวลาประมวลผลเท่านั้น
สามแนวทางที่เขาหยิบมาพิจารณา
Morris สำรวจหลายวิธี พร้อมอธิบายว่าทำไมแต่ละวิธียังไม่ตอบเป้าหมายทั้งหมด ตารางนี้ย่อเฉพาะแนวทางและข้อจำกัดที่เขากล่าว ไม่ใช่อันดับว่าเครื่องมือใดดีที่สุด
| แนวทาง | สิ่งที่พยายามทำ | ข้อจำกัดในคำอธิบายของผู้บรรยาย |
|---|---|---|
| KV compaction | บีบตัวแทนของบริบทให้เล็กลง เพื่อให้โมเดลใช้ข้อมูลนั้นได้ | แนวทางที่ยกมาต้องเริ่มจากข้อมูลที่ใส่ใน context ได้ และไม่ได้เท่ากับการปรับน้ำหนักโมเดล |
| Distillation / self-study | ถ่ายทอดความรู้จากบริบท เช่น สร้างคำถามและคำตอบอิงเอกสารแล้วฝึกให้ตอบ | ต้องเลือกว่าจะสร้างโจทย์ฝึกอะไร เอกสารดิบเพียงอย่างเดียวไม่ได้กำหนดพฤติกรรมที่ต้องการ |
| Continued pretraining ด้วยข้อมูลสังเคราะห์ | สร้างข้อมูลจากคลังเดิมแล้วฝึกต่อ | ผู้บรรยายชี้ถึงโอกาสกระทบความสามารถเดิม ความยากในการขยาย และความต่างระหว่าง base model กับโมเดลที่ผ่าน post-training แล้ว |
ช่วง 10:27–11:55 เขายังยกตัวอย่างการฝึกทำนาย token ถัดไปบนเอกสารซ้ำ ๆ เพื่ออธิบายว่า loss ที่ต่ำไม่ได้รับรองการตอบคำถามใหม่ได้ดี บทความนี้ไม่ใช้ตัวเลข loss ในคลิปเป็น benchmark เพราะไม่มีรายละเอียดการทดลองเพียงพอให้เทียบกับระบบอื่น
ปัญหาอยู่ที่จุดอิ่มตัวของโจทย์ฝึกด้วย
ช่วง 16:20–17:23 Morris อธิบายข้อกังวลว่า เมื่อกำหนดชุดข้อมูลแล้วฝึกจนเรียนรู้สิ่งที่อยู่ในชุดนั้น การเพิ่ม compute อาจไม่เพิ่มความรู้ลึกต่อไป เขาเรียกโจทย์นี้ว่า synthetic data wall และชวนคิดถึงวิธีสร้างรอบการเรียนรู้ถัดไป
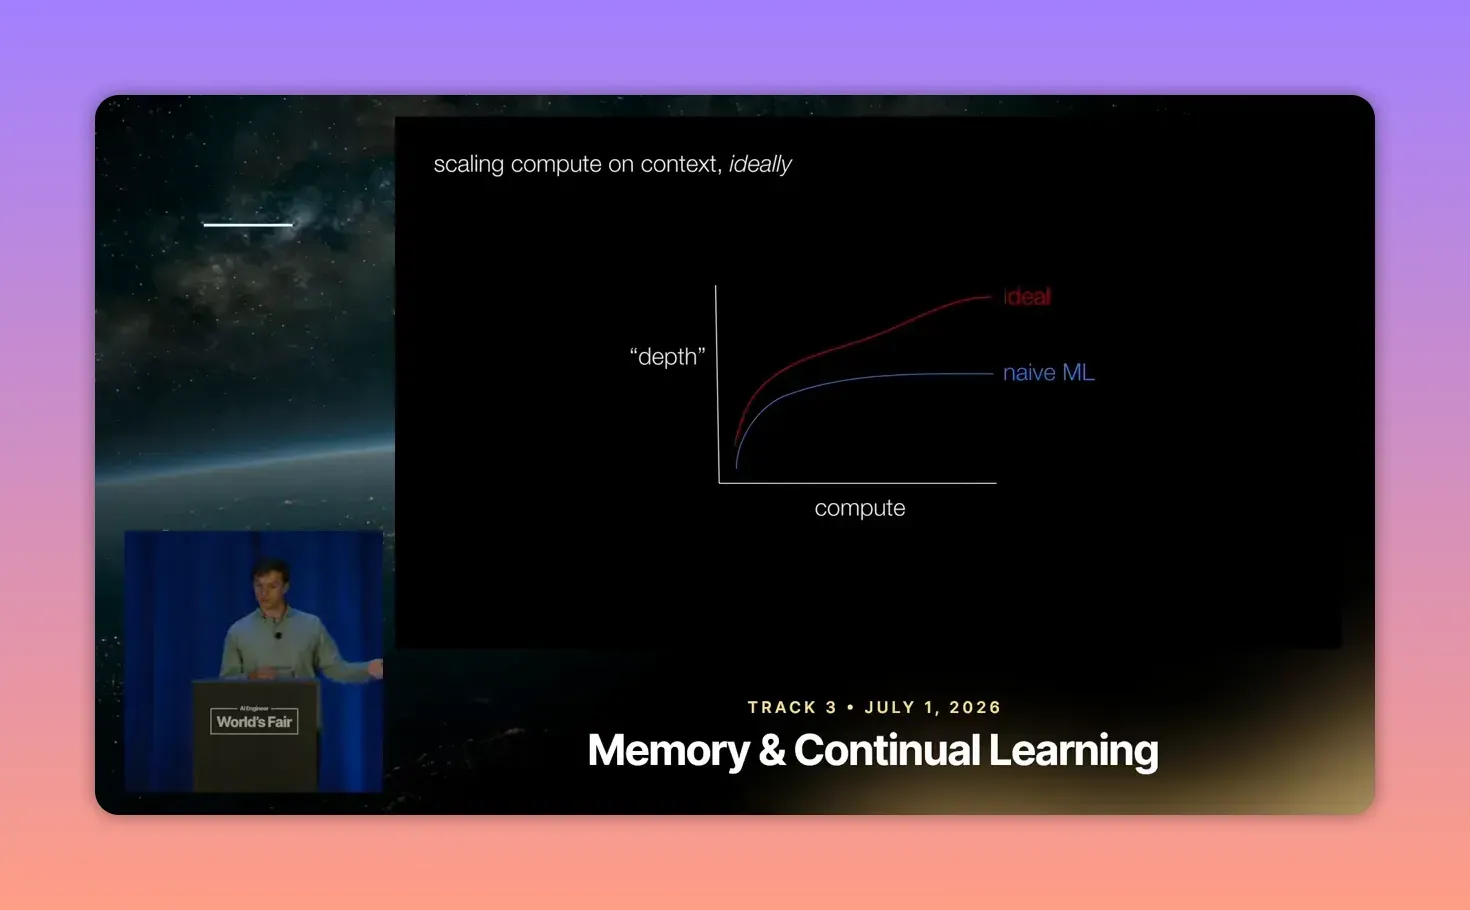
คำถามในช่วง 17:27–18:47 คือ โมเดลที่ดีขึ้นจะช่วยสร้างโจทย์เรียนรู้ที่ยากขึ้นได้หรือไม่ จนการเพิ่มการประมวลผลยังเพิ่มความสามารถต่อไปได้ นี่เป็นทิศทางที่เขาสนใจ ไม่ใช่หลักฐานว่าทุกระบบจะพัฒนาตัวเองได้ไม่จำกัด หรือว่าองค์กรควรเปลี่ยนมาใช้วิธีนี้ทันที
สิ่งที่ทีมเล็กทำได้ก่อนเลือกวิธีฝึกใหม่
ข้อเสนอสำหรับการนำไปใช้คือ เริ่มจากงานหนึ่งประเภทและแยกหลักฐานออกจากความสามารถ ตัวอย่างเช่น งานตรวจร่างข้อเสนอขายต้องมีนโยบายราคาที่ถูกฉบับ และต้องทดสอบกรณีที่มีข้อยกเว้นด้วย เราอาจได้ผลที่ต้องการจากการค้นข้อมูลและจัด workflow ให้ดีขึ้น โดยยังไม่ต้องฝึกโมเดลใหม่
เก็บโจทย์ที่ระบบทำพลาด พร้อมเอกสารที่ควรใช้และผลลัพธ์ที่ทีมยอมรับ จากนั้นใช้โจทย์เหล่านั้นตรวจรอบถัดไป โดยมีโจทย์ใหม่แยกไว้เพื่อดูว่า AI ประยุกต์ใช้ได้จริงหรือเพียงจำชุดทดสอบเดิม แนวทางนี้เป็นข้อเสนอของผู้เรียบเรียง ไม่ใช่วิธีทดลองที่ Morris รับรองในคลิป
ถ้าผู้ให้บริการเสนอว่าฝึกข้อมูลบริษัทแล้ว AI จะรู้ลึกขึ้น ให้ขอดูผลบนงานใหม่ที่ทีมกำหนด วิธีรักษาความสามารถเดิม และวิธีอัปเดตเมื่อข้อมูลเปลี่ยน เราจะตัดสินใจได้ชัดกว่าการดูเพียงจำนวนเอกสารที่ป้อน หรือกราฟที่ไม่มีนิยามของความสามารถกำกับ
ที่มา: Jack Morris, Engram บนช่อง AI Engineer วิดีโอเผยแพร่ 12 สิงหาคม 2026 บทความเรียบเรียงจากการบรรยายและแยกข้อเสนอประยุกต์ออกจากคำอธิบายของผู้บรรยาย
