

วันที่บทความต้นทางใน VideoToBlog: 2026-04-09 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว สเปก ความเร็ว tokens ต่อวินาทีและอัตราเร่ง TTFT เป็นผลที่ผู้บรรยายรายงานภายใต้ชุดทดลองในคลิป ไม่ใช่การทดสอบอิสระหรือคำรับประกันความเร็วสำหรับทุกโมเดลและ workload ตัวเลขควรอ่านพร้อมเงื่อนไข environment และ quantization เดิม · วิดีโอต้นทาง
บางครั้งปัญหาของทีม AI ไม่ได้อยู่ที่ “โมเดลเก่งไหม” แต่เป็นคำถามที่ดูเล็กจนปวดหัวเมื่อเข้าใกล้การใช้งานจริง เช่น โมเดลที่รันได้บนคลาวด์แล้ว ทำไมกลับรันในเครื่องแล้วลื่นไม่เท่าเดิม? ทำไม latency ที่ควรนิ่งกลับแกว่ง? และที่หนักสุดคือ เวลาที่เสียไปกับการดีบักสแตกซอฟต์แวร์ให้ตรงกับสภาพแวดล้อมการผลิต
คลิปที่เพิ่งจบไม่ได้เล่าด้วยภาษาสวยๆ แต่ใช้แนวคิดแบบ “เอาของจริงมาทดสอบ” ผ่านการรัน LLMs ในเครื่องด้วย DGX Spark พร้อม vLLM และการวัดผลที่เน้นประสบการณ์ผู้ใช้จริง ได้แก่ throughput (tokens ต่อวินาที) และ time to first token จากการสตรีมผลลัพธ์ นี่คือแก่นที่ทำให้บทความนี้อยากหยิบมาขยาย: ไม่ใช่เพื่อทำให้ตัวเลขดูดี แต่เพื่อช่วยให้ทีมตัดสินใจได้ว่า “ควรใช้ local เมื่อไหร่” และ “ต้องเลือก quantization แบบไหนถึงจะคุ้ม”
ทำไมต้องคิดเรื่อง “LLM ในเครื่อง” ทั้งที่คลาวด์ก็มีอยู่แล้ว
การย้ายงาน LLM จากคลาวด์หรือดาต้าเซนเตอร์มาสู่ระบบในเครื่องไม่ได้เป็นเพราะไม่อยากใช้คลาวด์ แต่เป็นเพราะโจทย์ด้านวิศวกรรมเริ่มกดดันทีมให้ต้อง “เร็วขึ้น, คาดการณ์ต้นทุนได้, และควบคุมข้อมูลได้”
ประเด็นที่คลิปหยิบขึ้นมามีอยู่สองแรงหลักสำหรับนักพัฒนา
- ข้อจำกัดด้านหน่วยความจำ (memory) จนรันโมเดลที่ต้องการไม่ได้ หรือรันได้แต่ช้า
- การเข้าถึงสแตกซอฟต์แวร์ที่ถูกต้อง ไม่ว่าจะเป็นเวอร์ชันไลบรารี, runtime, หรือ stack ที่เหมือนกับการผลิต ทำให้พอจะย้ายไป production จริงก็ต้องแก้หนัก
เมื่อโมเดลย้ายจาก “งานทดลอง” ไปสู่ “งานผลิต” น้ำหนักของคำถามอื่นๆ จะเพิ่มขึ้นทันที เช่น ความคาดการณ์ค่าใช้จ่าย, ถิ่นที่อยู่ข้อมูล (data residency), และ latency แบบกำหนดได้ (deterministic latency) อีกทั้งการพัฒนาจริงยังถูกแทรกด้วยปัจจัยภายนอก เช่น การแชร์ทรัพยากรกับ workload อื่น ทำให้การรันซ้ำเพื่อทดลองไอเดียใหม่ช้าลง
คำถามจึงไม่ใช่ “จะรัน local ได้ไหม” แต่เป็น “เราจะนำ workflow ใกล้จุดที่ทีมพัฒนาทำงานจริงแค่ไหน”
DGX Spark: local workstation ที่พยายามทำให้ workflow “เหมือน production”
แกนของแนวคิดในคลิปคือการทำให้การพัฒนา LLM เกิดบนเครื่องที่ “พอใจกับงานจริง” ไม่ใช่เครื่องที่เอาไว้เปิดความเป็นไปได้แบบผ่านๆ
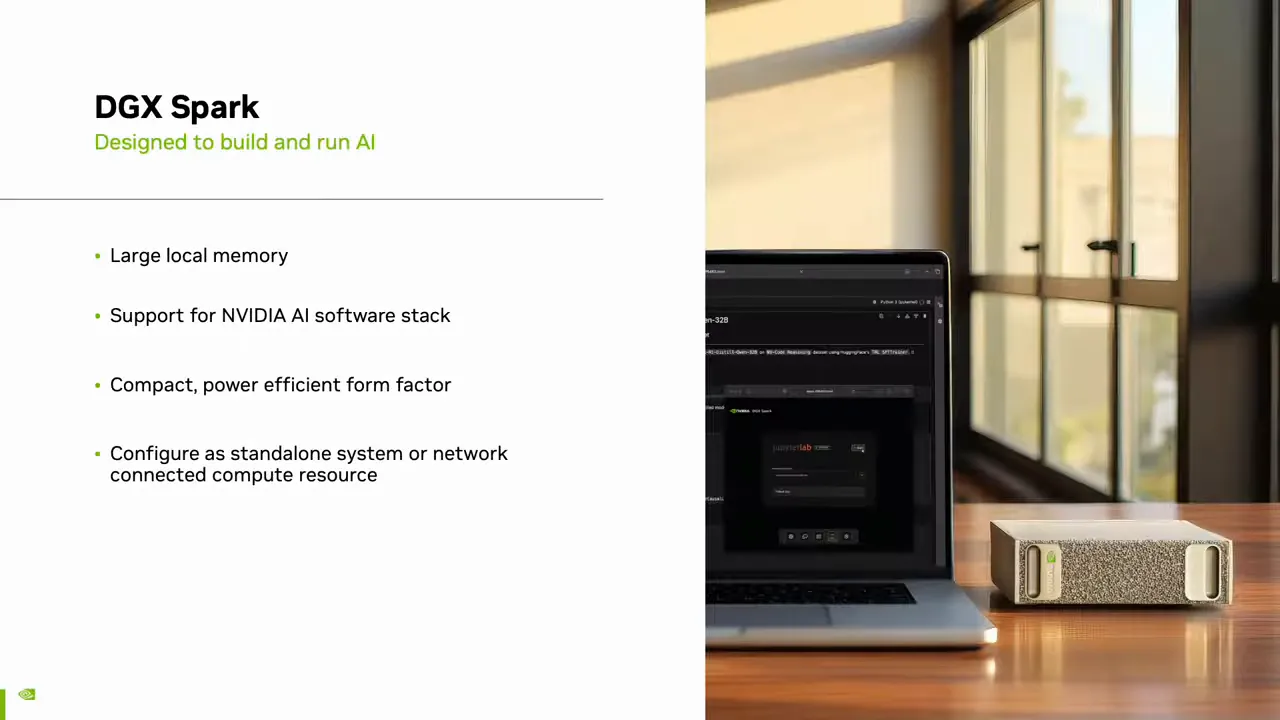
DGX Spark ถูกออกแบบให้เป็นระบบสำหรับสร้างและรัน AI แบบ standalone และขับเคลื่อนด้วยชิป GB10 Grace Blackwell Superchip ซึ่งรวม CPU และ GPU เข้าด้วยกันบน unified memory architecture
สเปกที่ปรากฏในคลิปมีสาระต่อการตัดสินใจโดยตรง
- Unified memory 128GB
- รองรับ FP4
- ช่วยให้ทำงานกับโมเดลได้ถึงราว 200B parameters ในสภาพการใช้งานที่เหมาะสม
- ขนาดเป็นไปได้กับการวางบนโต๊ะหรือใต้โต๊ะ
แต่สิ่งที่สำคัญไม่แพ้สเปกก็คือ “ความเหมือนกันของ stack” ในคลิประบุว่ามันรัน NVIDIA AI software stack ที่ใช้กับ environment ระดับ production ดังนั้น workflow ที่สร้างบนเครื่องจึงมีแนวโน้มย้ายไป cloud หรือ data center ได้โดยมีการเปลี่ยนแปลงน้อย
พูดแบบตรงๆ แนวคิดคือไม่ต้องเลือกว่าจะเอาความสะดวกของ local หรือเอาความเหมือน production ไปใช้กับทีมพัฒนาตลอดเวลา ต้องการทั้งสองอย่างพร้อมกัน
ตั้งค่าการรันให้ “เทียบได้” ด้วย vLLM และคอนเทนเนอร์ที่ทำให้สภาพแวดล้อมเหมือนกัน
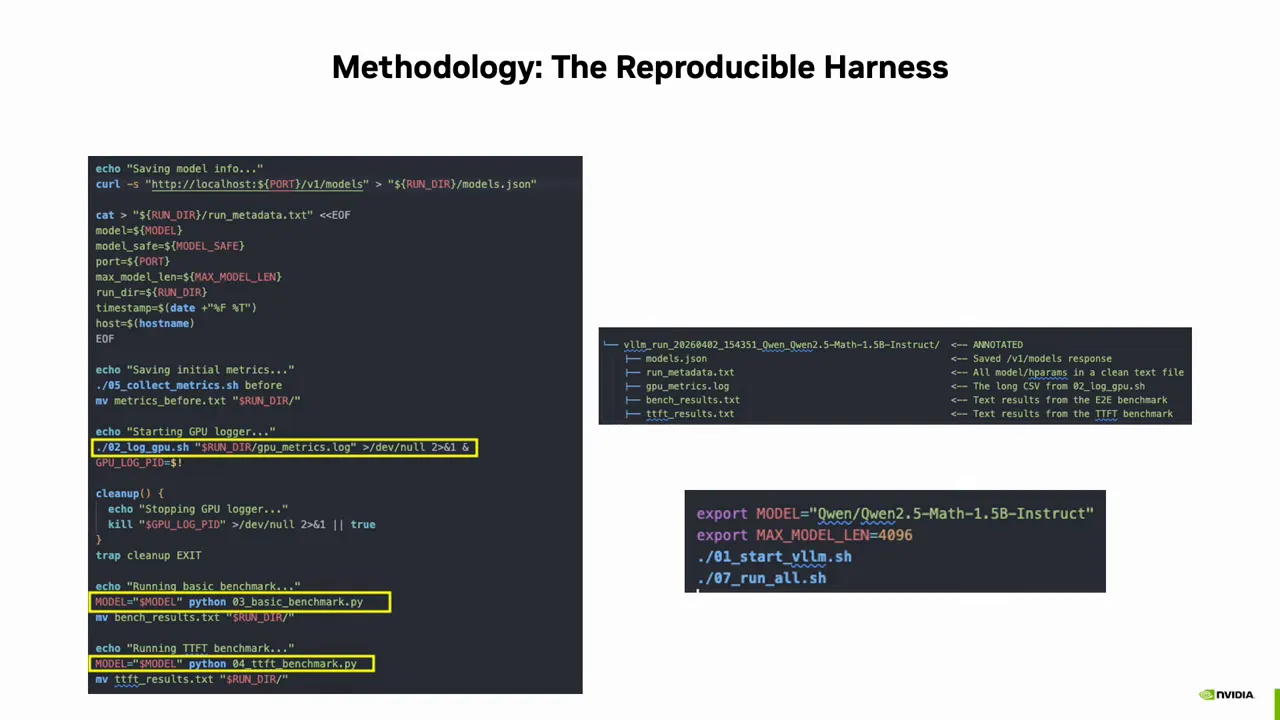
การ benchmark ที่ดีไม่ใช่แค่รันแล้วดูตัวเลข แต่ต้องทำให้ “รันซ้ำแล้วเทียบได้” และ “ทำให้ตัวแปรอื่นไม่มารบกวน” ในคลิปจึงวางชุดการทำงานที่เน้นการทำให้ผลลัพธ์ reproducible
การ serve โมเดลทำด้วย vLLM โดยเลือกกลุ่มโมเดลจากขนาดเล็กไปจนถึงขนาดใหญ่และเปลี่ยน precision format ตามแนวคิดการวัด trade-offs
สิ่งที่ถูกเน้นคือการรันทั้งหมดใน optimized container ของ NVIDIA เพื่อให้สภาพแวดล้อมใกล้เคียงกับการนำไปใช้งานจริงมากที่สุด วิธีนี้ลด “ความต่างจาก environment” ที่ทำให้ผลลัพธ์หลอกตัวเลขได้
มุมมองส่วนตัวจากการอ่านตรรกะนี้คือ ถ้า benchmark ไม่ล็อก environment ตั้งแต่ต้น ต่อให้ตัวเลขจะออกมาดีแค่ไหน สุดท้ายก็จะกลายเป็นตัวเลขที่ “อธิบายยาก” ตอนทีมต้องตัดสินใจเชิงวิศวกรรม
เบื้องหลังความน่าเชื่อถือ: automated benchmarking harness ที่บังคับโปรโตคอลเดียวกันทุกครั้ง
หัวใจของคลิปอีกส่วนหนึ่งคือการสร้าง automated benchmarking harness เพื่อให้ทุกการรันมี protocol เหมือนกัน ตั้งแต่การแยกสภาพแวดล้อมไปจนถึงการเก็บเมตริก
สิ่งที่ระบุในคลิปมีความเป็นระเบียบและจับต้องได้
- Docker-based environment isolation เพื่อกันผลกระทบจากงานอื่นหรือ dependency แปลกปลอม
- warm-up runs 3 รอบ ก่อนวัดจริง เพื่อให้ระบบเข้าสู่สภาวะเสถียร
- logging เมตริก GPU ทุก 1 วินาที เพื่อให้เห็นพฤติกรรมระหว่างการทำงาน
- สำหรับแต่ละ execution จะสร้าง directory แบบไม่ซ้ำ ด้วย time step และ sanitized model id
- บันทึก endpoint response รวมถึง metrics ที่จำเป็น
- เก็บเป็น versioned artifact ที่ตรวจสอบย้อนกลับได้
แนวคิดที่น่าชื่นชมคือไม่ได้จบแค่กราฟ แต่ทำให้ผลลัพธ์มีหลักฐานพอให้ “ตรวจแหล่งที่มา” ได้ในภายหลัง ซึ่งเป็นสิ่งที่ทีมผลิตมักต้องการมากกว่าตัวเลขที่สวยงาม
ตัวชี้วัดที่ไม่ควรพลาด: throughput vs time to first token
LLM ในแอปจริงไม่ได้ถูกวัดด้วยความเร็วในการผลิตประโยคยาวเท่านั้น เพราะผู้ใช้รู้สึกกับ “ช่วงเวลาแรก” ที่โมเดลเริ่มตอบ
คลิปแยกเมตริกอย่างชัดเจน
- end-to-end latency เป็นภาพรวม แต่
- time to first token (TTFT) คือเมตริกสำคัญที่กำหนดการรับรู้ความเร็วของผู้ใช้
ถ้า time to first token มาเร็ว แอปจะให้ความรู้สึกตอบสนอง แม้ว่าความเร็วในการสร้าง token ถัดๆ ไปจะไม่ได้สูงที่สุด
ในคลิปยังระบุวิธีวัดแบบละเอียด เพราะไม่ได้ “เรียก API แล้วรอผล” เฉยๆ แต่จัดการ streaming response และ timestamp ตั้งแต่ “chunk แรก” ที่ผู้ตอบเริ่มปล่อย
เหตุผลเชิงวิศวกรรมที่เรามองเห็นได้คือ TTFT สะท้อนคอขวดช่วง initialization, การโหลด/เตรียม state, และความสามารถในการประมวลผลช่วงแรกของ pipeline ถ้า quantization หรือการจัดการหน่วยความจำช่วยลดภาระช่วงนี้ แอปก็จะรู้สึกเร็วขึ้นแม้ throughput ไม่ได้พุ่งแบบสุดขั้ว
ทดลองอะไรใน DGX Spark: โมเดลตั้งแต่ 1.5B ถึง 14B ภายใต้ setup เดียวกัน
เพื่อให้การเปรียบเทียบไม่หลอกกัน ตัวแปรถูกคุมให้อยู่ในชุดที่หมายถึง “สิ่งที่ต้องเทียบ” เท่านั้น คลิประบุว่ารันด้วยชุดโมเดลหลายขนาด ตั้งแต่ instruction models ขนาดเล็ก ไปจนถึงโมเดลขนาดใหญ่ที่เป็น optimized variants โดยทุกอย่างถูก serve ในเครื่องเดียว
สิ่งที่ต้องการไม่ใช่การทำสถิติสุดขีด แต่เป็นการเห็น “พฤติกรรมจริงใน workflow ของนักพัฒนา” นี่เป็นมุมที่สำคัญ เพราะในงานจริง เราไม่ได้อยากรู้แค่ว่าเครื่องทำได้สูงสุดเมื่อไร เราอยากรู้ว่าเครื่องทำได้ดีพอสำหรับการ iterating อย่างรวดเร็วหรือไม่
Throughput: ทำไมโมเดลใหญ่ขึ้นแล้ว tokens ต่อวินาทีตกลง แต่ quantization ช่วยให้กลับมามีชีวิต
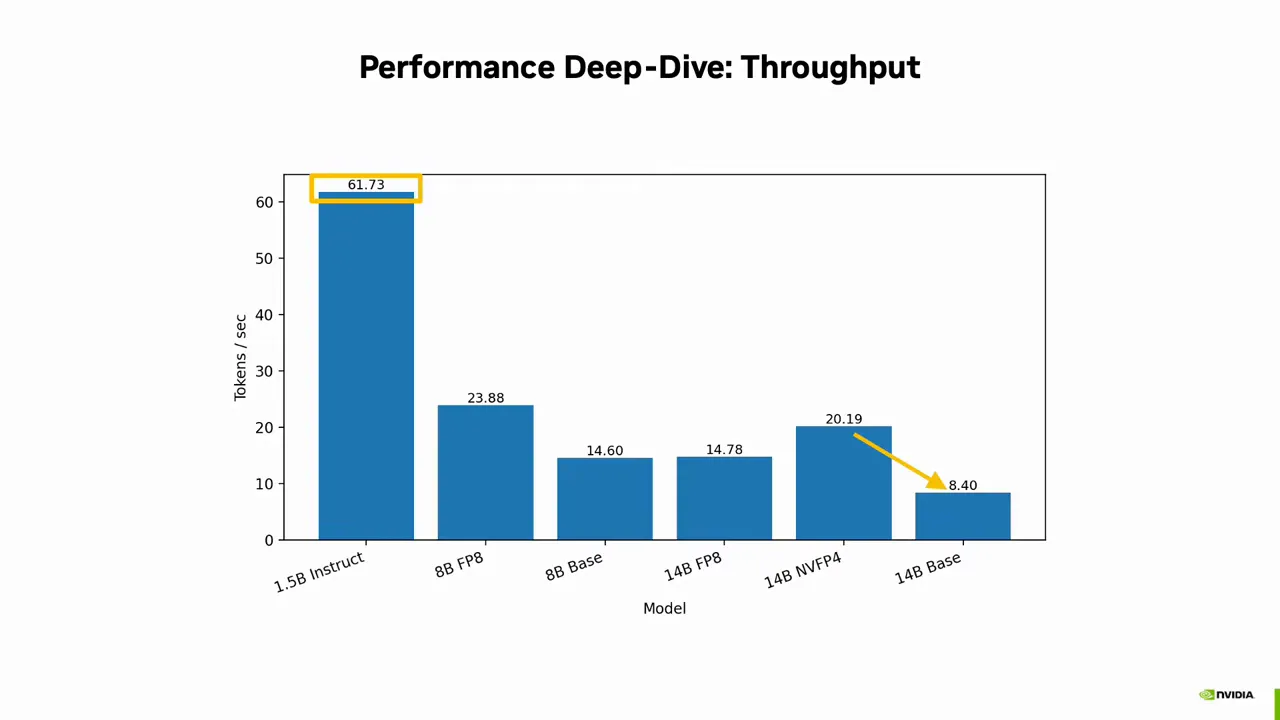
กราฟในคลิปชี้ภาพชัดเจนว่า completion tokens per second ลดลงตามขนาดโมเดลที่เพิ่มขึ้น
ตัวเลขที่ถูกยกมาเป็นตัวแทนมีทั้งฝั่งโมเดลเล็กและโมเดลใหญ่
- 1.5B instruct model ให้ throughput ราว 61.73 tokens/second
- 14B NVFP4 model แม้ใหญ่ขึ้นเกือบ 10 เท่า แต่ยังได้ 20.19 tokens/second
คลิปมองจุดนี้ว่าเป็น engineering sweet spot เพราะใช้ NVFP4 (4-bit floating-point quantization) เพื่อรักษาความซับซ้อนของความสามารถเชิงภาษา ขณะเดียวกันทำให้ throughput ยังอยู่ในระดับที่เหนือการอ่านของมนุษย์โดยเฉลี่ยได้
และที่ทำให้เข้าใจ “ความสำคัญของ quantization” มากขึ้นคือการเทียบกับ base model ขนาดเดียวกัน
- 14B base model ลดลงเหลือราว 8.40 tokens/second
สรุปเชิงวิศวกรรมที่คลิปชี้ให้เห็นตรงๆ คือ บน Blackwell hardware การเลือก format ของ quantization ไม่ได้เป็นรายละเอียด แต่เป็นตัวกำหนดความสามารถจริงของระบบ การ “พอดี” ของโมเดลกับหน่วยความจำและแบนด์วิธ จะตัดสินว่าความเร็วใช้งานได้หรือไม่
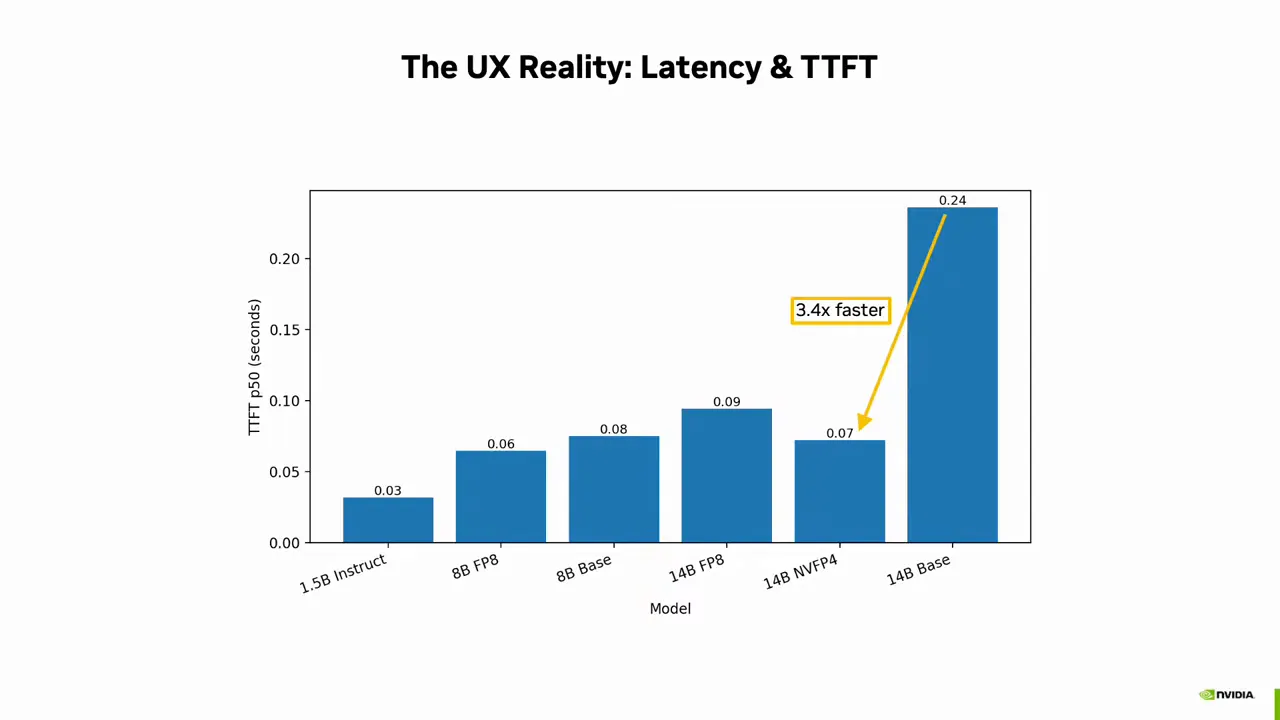
Time to First Token: ความรู้สึกผู้ใช้ไม่ได้สนใจว่า throughput จะสูงแค่ไหน
เมื่อมอง TTFT ภาพก็ย้ายไปคนละมุม
คลิปอธิบายว่าการเพิ่มขึ้นของ TTFT ในโมเดลใหญ่เป็นเรื่องคาดหวัง เพราะต้องทำ computation มากขึ้นก่อนเริ่มปล่อย token ตัวแรก และสิ่งที่น่าสนใจกลับเป็นการเทียบกันระหว่าง 14B ที่มีการ quantize กับ 14B base ที่ไม่มีการ optimize
ผลที่ถูกชี้ชัดในคลิปคือ
- 14B NVFP4 เร็วต่อ time to first token มากกว่า 14B base ราว 3.4 เท่า
ตรงนี้มีนัยสำคัญต่อการออกแบบ UX ของแอป LLM: หากเราต้องการให้ผู้ใช้รู้สึกว่าแอป “เริ่มตอบเร็ว” การเลือก quantization ที่ช่วยลดภาระการเคลื่อนย้ายข้อมูลและภาระ computation ช่วงเริ่มต้นย่อมส่งผลโดยตรงต่อความรู้สึก
หน่วยความจำไม่เท่ากับแบนด์วิธ: ทำไม 128GB ยังไม่การันตี throughput
หนึ่งในประโยคที่คลิปทิ้งไว้ให้คิดคือ ความแตกต่างระหว่าง memory capacity และ memory bandwidth
แม้ DGX Spark มี unified memory 128GB ที่ทำให้สามารถ “fit” โมเดลขนาดใหญ่อย่าง 200B parameters ได้ในระดับหนึ่ง แต่ throughput ยังคงถูกควบคุมโดยวิธีที่ระบบเคลื่อนย้ายข้อมูล
นี่อาจเป็นเหตุผลที่คนจำนวนไม่น้อยเข้าใจผิดตอนเริ่มรัน LLM ในเครื่อง เพราะพอมี capacity มาก ก็คิดว่าสามารถวิ่งเร็วได้โดยอัตโนมัติ แต่ในทางปฏิบัติ throughput ถูกจำกัดด้วยอัตราการป้อนข้อมูลเข้าสู่หน่วยประมวลผล และด้วยประสิทธิภาพของการจัดการ data movement
คลิปเลยชี้ว่า NVFP4 ทำหน้าที่เป็นตัวช่วยเพิ่ม “intelligence per byte” กล่าวคือให้ความสามารถเชิงภาษาได้มากขึ้นในขนาดข้อมูลที่ต้องขน ส่งผลให้ความรู้สึกทั้ง throughput และ TTFT ดีขึ้น
ดังนั้นควรใช้ DGX Spark หรือ compute แบบ local เมื่อไหร่
จากการรันและวิเคราะห์ทั้งหมด คลิปปิดด้วย “สามกรณี” ที่เห็นว่าเหมาะกับการใช้ DGX Spark
- steady state workloads ที่ต้องรันต่อเนื่องและต้องการความสม่ำเสมอของ performance
- งานที่เกี่ยวข้องกับข้อมูลที่ต้องการความเป็นส่วนตัวสูง ซึ่งต้องการควบคุมการเข้าถึงและการจัดเก็บมากขึ้น
- rapid prototyping เพราะการ iterating เร็วขึ้นจะทำให้วงจรคิด - ทดสอบ - ตัดสินใจสั้นลง
และเหตุผลเชิงระบบที่ทำให้สามข้อนี้ไม่ใช่แค่คำสวยคือการที่ local สามารถรันด้วย software stack เดียวกับที่ใช้ใน DGX Cloud ทำให้ workflow ของทีมมีเส้นทางชัดเจน: เริ่มต้น local, iterate ให้แน่ใจ, จากนั้นค่อย scale ไป data center หรือ cloud เมื่อพร้อม
มุมมองส่วนตัวของเราเชื่อว่า “เส้นทางการย้ายงาน” คือจุดชี้ขาดจริงๆ หลายทีมเคยเจ็บจากการสร้างต้นแบบที่รันได้แค่ในเครื่องตัวเอง แต่พอย้ายขึ้น production แล้วทุกอย่างเปลี่ยน ความพยายามซ้ำจึงกินเวลาและงบประมาณไปโดยไม่จำเป็น
Framework สำหรับทีมที่อยากเริ่มรัน LLM ในเครื่องแบบไม่เดา
สิ่งที่ได้จากคลิปมากกว่าตัวเลขคือกรอบการคิดที่ทำให้การตัดสินใจเรื่อง local model sizing ไม่ใช่เรื่องความเชื่อ
1) ตั้งเป้าหมาย UX ก่อน: วัด time to first token ให้เป็น
ถ้าแอปต้องตอบแบบ streaming การวัด TTFT คือสิ่งที่ช่วยชี้ว่าระบบเริ่ม “ทำงานจริง” เมื่อไร วิธี timestamp ที่จัดการ streaming response โดยตรงทำให้เห็นความต่างได้ชัดกว่าการดูแค่ end-to-end แบบรวมๆ
2) ใช้ throughput เป็นตัวบอกเพดานความยืดหยุ่นของระบบ
throughput ทำให้เราเข้าใจว่าเมื่อผู้ใช้ต้องการข้อความยาว ระบบยังคงไหลลื่นแค่ไหน จุดสำคัญคือการเห็นแนวโน้มว่าโมเดลใหญ่ขึ้นจะทำให้ throughput ตกลง และ quantization ช่วยคุมผลกระทบได้
3) คุม environment และเก็บ artifact ให้ตรวจสอบย้อนกลับได้
warm-up runs, Docker isolation, และ logging เมตริก GPU เป็นรายละเอียดที่ฟังดูเยอะ แต่ช่วยให้ benchmark เชื่อถือได้พอจะใช้ในการตัดสินใจ
4) อย่าตัดสินจาก capacity อย่างเดียว
ให้มองแบนด์วิธและ data movement พร้อมกัน เพราะ capacity ที่ทำให้ “fit” ไม่เท่ากับ performance ที่ทำให้ “ใช้งานได้จริง”
คำศัพท์เฉพาะทางเพิ่มเติม
vLLM
ซอฟต์แวร์สำหรับ serving LLM โดยเน้นประสิทธิภาพในการรันและการทำงานร่วมกับการสตรีมผลลัพธ์ ในบทความนี้ใช้เพื่อให้การเทียบ performance มีความสม่ำเสมอ
Quantization และ NVFP4
Quantization คือการลดความละเอียดของตัวเลขในน้ำหนักโมเดล เพื่อให้ประหยัดหน่วยความจำและเพิ่มความเร็วการประมวลผล NVFP4 ในที่นี้หมายถึงการใช้ 4-bit floating-point quantization ที่ช่วยให้ทั้ง throughput และ time to first token ดีขึ้นเมื่อเทียบกับ base ที่ไม่ถูก optimize ในสภาพเดียวกัน
Time to First Token (TTFT)
เวลาตั้งแต่เริ่มส่งคำถามจนถึงโมเดลปล่อย token ตัวแรกในรูปแบบ streaming เมตริกนี้สัมพันธ์โดยตรงกับความรู้สึกของผู้ใช้ว่าแอปตอบ “เร็ว” หรือ “เหมือนค้าง”
Throughput
ความเร็วในการสร้าง tokens ต่อวินาที โดยรวมแล้วบอกว่าเมื่อเริ่มตอบแล้ว ระบบสามารถรักษาความลื่นไหลได้แค่ไหน
Embed เพื่ออ้างอิงเนื้อหาเชิงภาพรวม
หากต้องการดูบริบทการตั้งค่า benchmark และกราฟที่ใช้ตัดสินใจ องค์ประกอบเหล่านี้ถูกนำเสนอด้วยภาพในสื่อวิดีโอด้านบน
บทสรุปส่งท้ายจากทีมงาน Insiderly
- local AI ไม่ได้แค่ “รันได้” แต่ต้องวัดผลแบบที่เชื่อมกับ UX โดยเฉพาะ time to first token
- throughput บอกเพดานความลื่นไหล แต่จะเห็นจริงเมื่อเทียบ base กับ quantized model ภายใต้สภาพแวดล้อมเดียวกัน
- quantization (เช่น NVFP4) คือคีย์สำหรับทำให้โมเดลใหญ่ยังมี performance ที่ใช้งานได้ ไม่ใช่แค่ลดหน่วยความจำ
- แม้ unified memory จะช่วยให้ fit โมเดลได้ แต่ performance ยังถูกจำกัดด้วย memory bandwidth และ data movement
- สิ่งที่ทำให้ benchmark เชื่อถือคือ protocol ที่ทำซ้ำได้ เช่น warm-up runs, container isolation, และ logging
