

วันที่บทความต้นทางใน VideoToBlog: 2026-03-24 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว ตัวอย่างเครื่องมือ ฮาร์ดแวร์ ราคา โปรโมชันและความเร็วอ้างตามต้นทาง ไม่ใช่ราคาหรือข้อเสนอปัจจุบัน คำว่า open source ในบทความครอบคลุมโมเดลเปิดน้ำหนักด้วย จึงต้องตรวจ license ของแต่ละโมเดล การรันบน cloud หรือใช้ API ไม่ทำให้ข้อมูลอยู่ภายในเครื่อง และไม่มีการรับรองความเป็นส่วนตัวหรือ compliance แบบเหมารวม · วิดีโอต้นทาง
มีช่วงหนึ่งที่วงการเริ่มพูดเหมือนกันว่าการรัน Open Source AI Models นั้นยากเหลือเกิน ต้องมีเครื่องแรงแบบเฉพาะทาง ต้องรู้การเขียนโค้ดละเอียดๆ และถ้าทำไม่ได้ก็ไม่รู้จะเริ่มตรงไหน
แต่พอได้ไล่แนวคิดทั้งหมดตั้งแต่ “โหลดมาก่อน” ไปจนถึง “โฮสต์ให้คนอื่นใช้” ภาพรวมก็ชัดขึ้นมาก จุดเปลี่ยนสำคัญคือเทคโนโลยีชุดใหม่ทำให้ต้นทุนด้านการเริ่มต้นลดลงจริง เช่น เครื่องทั่วไปก็ไหวกับโมเดลขนาดเล็ก และฝั่งอีโคซิสเต็มก็ทำอินเทอร์เฟซหรือบริการที่เชื่อมต่อให้ง่ายขึ้น
บทความนี้สรุปและวิเคราะห์วิธีรัน Open Source AI Models แบบเป็นระบบ โดยจัดเป็น 4 หมวดหลักจากง่ายไปยาก พร้อม 2 หมวดโบนัสสำหรับคนที่อยากอยู่ข้างหน้า และจะลงรายละเอียดเชิงปฏิบัติให้เห็นว่าแต่ละทางเลือกเหมาะกับใคร ความยากอยู่ตรงไหน และควรคิดเรื่องความเป็นส่วนตัวกับต้นทุนอย่างไร
ก่อนเริ่ม: “Open Source AI Models” คืออะไร และทำไมถึงน่าลงมือ
Open Source AI Models โดยแนวคิดหลักคือโมเดลที่ส่วนประกอบสำคัญอย่างใดอย่างหนึ่งหรือหลายส่วนถูกเผยแพร่สาธารณะ เช่น สถาปัตยกรรม (architecture), น้ำหนักโมเดล (model weights), โค้ดการฝึกหรือโค้ดการอินเฟอร์ (training/inference code) และมาพร้อม ไลเซนส์ ที่อนุญาตให้ใช้งาน ปรับปรุง และกระจายต่อได้ตามเงื่อนไข
เรื่องที่ทำให้คนสนใจมากขึ้นคือปัจจุบันโมเดลโอเพนซอร์สจำนวนมาก “ใช้งานได้จริง” ใกล้เคียงโมเดลปิดในหลายงาน และให้ประโยชน์ 3 ด้านที่จับต้องได้:
- คุมได้ว่าจะรันที่ไหน (เครื่องเรา, อุปกรณ์ขอบเครือข่าย, หรือระบบคลาวด์)
- ปรับแต่งได้ ตั้งแต่การปรับพฤติกรรม ไปจนถึงการ fine-tune และกำหนด guardrails
- ต้นทุนระยะยาวมักต่ำกว่า โดยเฉพาะเมื่อปริมาณการใช้งานโตขึ้น
ในทางปฏิบัติ แปลเป็นภาษาคนทำงานได้ว่า เราไม่ได้ติดอยู่กับผู้ให้บริการรายเดียว และเมื่อธุรกิจหรือโปรเจกต์เติบโต เราออกแบบสถาปัตยกรรมเพื่อ “จ่ายแบบที่คุมได้” มากขึ้น
ภาพรวม 6 ทางเลือก: 4 หมวดหลัก + 2 หมวดโบนัส (ง่ายไปยาก)
แนวทางทั้งหมดจัดเป็นลำดับความยากดังนี้
- หมวด 1: รันในเครื่อง (Local) จุดเริ่มต้นที่เร็วที่สุด
- หมวด 2: เล่นในเบราว์เซอร์/บริการโฮสต์ (Browser-hosted Playground) ไม่ต้องตั้งค่าโครงสร้างเอง
- หมวด 3: Managed Inference API ใช้ผ่าน API เพื่อพัฒนาแอปและบริการได้ไว
- หมวด 4: VPS จัดสรรพื้นที่และคุมระบบด้วยตัวเองมากขึ้น
ส่วนโบนัส:
- โบนัส 1: Managed Cloud Solutions สำหรับการสเกลหนักและงานที่ต้องการ compliance สูง
- โบนัส 2: On-device / Edge ฝังโมเดลในแอปให้เครื่องผู้ใช้รัน
หมวด 1: รัน Open Source AI Models แบบ Local ในเครื่องตัวเอง (ง่ายที่สุด)
หมวดนี้คือการ “ดาวน์โหลดโมเดลมาไว้ที่เครื่อง” แล้วรันบนเครื่องนั้นเอง ข้อดีหลักคือความเป็นส่วนตัว เพราะข้อมูลไม่ต้องส่งไปยังเซิร์ฟเวอร์ภายนอก และยังทำงานแบบออฟไลน์ได้
อีกประเด็นที่คนมักกังวลคือ สเปกเครื่อง จะไหวไหม แต่ตอนนี้โมเดลขนาดเล็กที่เรียกกันราวๆ ว่า 4B หรือ 8B ทำให้เราลองได้จากเครื่องที่ใช้งานได้จริงในชีวิตประจำวัน
วิธีที่ง่ายสุด: ใช้ Desktop Model Management App
แนวคิดคือใช้โปรแกรมจัดการโมเดลแบบเดสก์ท็อป เช่น Ollama แล้วเลือกโมเดลที่ต้องการ ดาวน์โหลดลงเครื่อง จากนั้นเริ่มคุยหรือใช้งานได้ทันที
ข้อสังเกตจากมุมมองเชิงปฏิบัติคือ ความยากลดลงมากเพราะทุกอย่างถูกซ่อนอยู่หลังอินเทอร์เฟซแล้ว เราไม่ต้องกังวลเรื่องการตั้งค่ารันไทม์หรือการเรียกอินเฟอร์ให้ซับซ้อนตั้งแต่เริ่ม
แล้วเครื่องแบบไหน “พอ” สำหรับโมเดลขนาดเล็ก?
ในบริบทของแนวทางนี้ ตัวอย่างการใช้งานจริงชี้ว่าเครื่องทั่วไปก็ไหว เช่น MacBook Air รุ่น M4 ปี 2025 ที่มี แรม 16GB สามารถรันโมเดลตระกูลประมาณ 4B ได้แบบสบาย และรันโมเดลใหญ่ขึ้นราว 8B ได้ในเคสทั่วไป โดยไม่ควรทำงานหนักอื่นๆ ไปพร้อมกันมากนัก เช่น ตัดต่อวิดีโอหรือไลฟ์สตรีมพร้อมกัน
สิ่งที่ควรเข้าใจคือ “ความไหว” ไม่ได้หมายถึงคุณภาพดีที่สุดเสมอไป แต่หมายถึงคุณเริ่มสร้างต้นแบบและทดลองได้เร็ว และนั่นมักสำคัญที่สุดสำหรับคนที่ยังไม่แน่ใจว่าอยากทำอะไรกับโมเดล
อัประดับ: เรียก Local Model จากโค้ดของตัวเอง
เมื่ออยากเอาโมเดลไปต่อกับแอปอื่นหรือสร้างเอเจนต์ เราจะย้ายจาก “คุยผ่านแอป” ไปสู่ “เรียกโมเดลผ่าน localhost”
แนวทางที่พบได้บ่อยคือ Ollama เปิดบริการให้เรียกผ่าน localhost ที่พอร์ต 11434 ดังนั้นโค้ดฝั่งแอปเพียงแค่ส่งคำขอไปยังพอร์ตนั้น ระบบจะตอบกลับด้วยเอาต์พุตของโมเดล
การทำแบบนี้เป็นเหมือนเปลี่ยนโมเดลให้กลายเป็น “ส่วนประกอบ” ของซอฟต์แวร์เรา ไม่ใช่แค่เครื่องมือคุยเล่น
ทำไมบางคนใช้ Mac mini แทนแล็ปท็อป?
เหตุผลไม่ใช่เพราะ workflow ต่างกัน แต่เป็นเรื่องความเสถียรระยะยาว หากใช้แล็ปท็อปแล้วไปทำงานหนักอื่นหรือปิดเครื่อง อาจทำให้ระบบที่รันโมเดลสะดุด
ดังนั้นการมีเครื่องแยกอย่าง Mac mini ไว้รันต่อเนื่อง 24/7 ช่วยลดการหยุดชะงัก และยังใช้สเปกที่จัดได้ดีกว่าได้ด้วย
ขั้นสุดท้ายในหมวด Local: Fine-tune โมเดลในเครื่องตัวเอง (ยากขึ้นมาก)
การ fine-tune ในเครื่องจริงมักต้องใช้ GPU และมีเครื่องมือช่วย เช่นแนวทางที่ยกขึ้นมามักเกี่ยวกับเครื่องมืออย่าง Unsloth เพื่อทำให้ขั้นตอนบางส่วนง่ายขึ้น
ตรงนี้คือจุดที่คนเริ่มรู้สึกว่าการรัน “ไม่ยาก” แล้ว แต่การ “ฝึก/ปรับแต่ง” คืออีกระดับที่ต้องคิดเรื่องฮาร์ดแวร์และกระบวนการมากขึ้น
คำแนะนำเชิงมุมมองส่วนตัวคือ หากเป้าหมายคือทำแอปและทดลองความคิด fine-tune อาจไม่ใช่ขั้นแรก ควรเริ่มจาก prompt และ workflow ก่อน แล้วค่อย fine-tune เมื่อมีข้อมูลชัดว่าอยากให้โมเดลทำอะไรเฉพาะทาง
หมวด 2: Browser-hosted Playground (ง่ายแบบไม่ต้องตั้งค่า)
หมวดนี้เหมาะกับคนที่ไม่ได้อยากดาวน์โหลดโมเดล ไม่อยากจัดการความเข้ากันของระบบ ไม่อยากจ่ายค่าเครื่อง แต่ยังอยากทดลองโมเดลโอเพนซอร์ส
หลักการคือมีคนอื่นโฮสต์โมเดลให้แล้ว เราเข้าผ่านเว็บเพื่อคุยและทดสอบได้ทันที
เว็บตัวอย่าง: Arena หรือ Hugging Face Spaces
แนวทางที่ยกขึ้นมาคือการใช้เว็บไซต์ที่มี interface ให้เลือกโมเดลแล้วเริ่มแชทได้เลย เช่นกลุ่มแพลตฟอร์มที่เรียกแนวๆ ว่า Arena และโมดูลที่โฮสต์บน Hugging Face Spaces
สำหรับงานการศึกษา การทำเดโมให้คนดูลองเล่นเป็นเรื่องที่สะดวกมาก เพราะแชร์ลิงก์แล้วเริ่มได้ทันที
ระดับถัดไปสำหรับการสอน: Google Colab Notebook (มี GPU ให้ยืม)
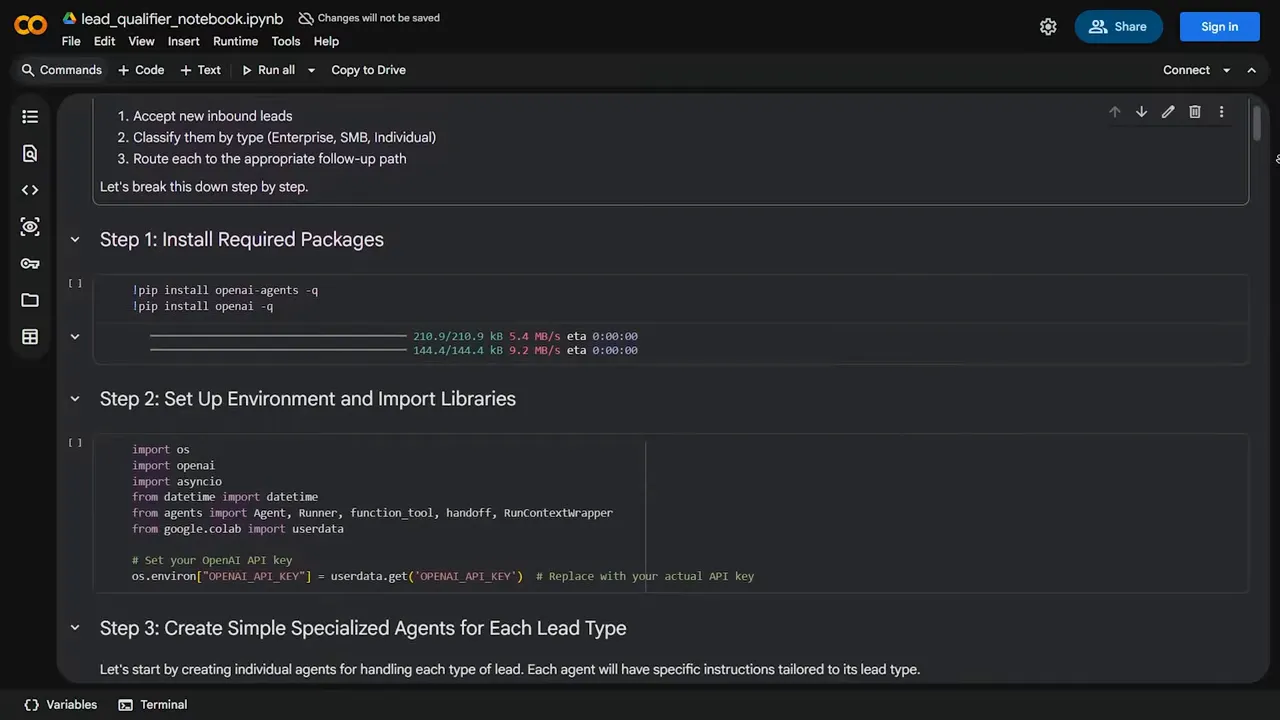
ถ้าต้องการไม่ใช่แค่แชท แต่ต้องให้ผู้เรียนรันโค้ดเองทีละบรรทัด การใช้ Google Colab เป็นทางเลือกที่ใช้งานจริงมาก
แนวทางคือเปิด runtime แบบ GPU จะได้ GPU ชั่วคราว เช่น T4 จาก Google จากนั้นติดตั้งแพ็กเกจอย่าง transformers และรันตัวอย่างหรือแม้กระทั่ง fine-tune ได้โดยใช้ GPU นั้น
จุดที่ต้องระวังคือ Colab เป็นระบบที่ “หมดอายุ” session จะหายไป ทำให้โมเดล fine-tune หรือผลการทดลองถ้าไม่เซฟไว้จะหาย และเรื่องความเป็นส่วนตัวก็ไม่ใช่แนว Local เพราะข้อมูลที่ป้อนจะไปที่ผู้ให้บริการคลาวด์
อีกข้อเสียที่พบได้คือมีการ rate limit ทำให้บางช่วงช้า หรืออาจต้องจ่ายเพื่อให้ใช้ GPU ต่อเนื่อง
หมวด 3: Managed Inference API (พัฒนาแอปได้ไวเหมือนใช้บริการปิด แต่ใช้โมเดลโอเพนซอร์ส)
หมวดนี้คือการ “ยอมจ่ายเงินแบบบริการ” เพื่อไม่ต้องโฮสต์โมเดลเอง ผู้ให้บริการจะโฮสต์โมเดลไว้ แล้วเราเรียกใช้ผ่าน API เหมือนการใช้ LLM แบบ closed source
เหมาะกับ indie hackers, สตาร์ทอัป, หรือทีมที่อยาก ship เร็ว ไม่อยากแตะ infrastructure มาก
หลักคิด: ได้ API key แล้วเรียกภายในโค้ด
ตัวอย่างแนวทางที่กล่าวถึงคือผู้ให้บริการ inference เช่นกลุ่มที่โฮสต์โมเดลโอเพนซอร์สอย่าง Together AI และ Fireworks AI ซึ่งทำงานในรูปแบบ API key
เมื่อได้ key ก็เริ่มเรียกจากโค้ดได้ด้วยจำนวนบรรทัดไม่มาก จากนั้นเอาแอปไป deploy ผ่านแพลตฟอร์มอย่าง Railway, Vercel, หรือ Heroku ได้
มุมมองเชิงกลยุทธ์: API เหมาะกับ “สร้าง product” มากกว่า “สร้างโมเดล”
ถ้าเป้าหมายคือทำผลิตภัณฑ์หรือเครื่องมือที่ต้องใช้งานจริง API เป็นหนทางที่ลดความเสี่ยงด้านระบบมาก และทำให้เราทดสอบคุณค่าทางธุรกิจได้เร็ว
แต่ต้องยอมรับ trade-off คือความเป็นส่วนตัวและการคุมต้นทุนละเอียดๆ จะน้อยกว่าแบบ Local หรือ VPS เพราะต้นทุนจะขึ้นกับจำนวนคำขอและเงื่อนไขผู้ให้บริการ
ในงานจริง ทีมที่โตขึ้นมักใช้ API ช่วงแรกเพื่อหาทิศทาง แล้วค่อยย้ายไป VPS หรือโครงสร้างที่คุมได้มากขึ้นเมื่อ usage สม่ำเสมอและต้องการ margin ที่ดีขึ้น
หมวด 4: VPS (คุมได้มากขึ้น เหมาะกับความจริงจังและทีม)
VPS คือการเช่าคอมพิวเตอร์เสมือน (virtual machine) ที่เราได้ทรัพยากรแบบแยกสัดส่วนเพื่อรันบริการของตัวเอง
เทียบให้เห็นภาพ: Local คือรันในบ้าน แต่ VPS คือเช่าพื้นที่ “เหมือนมีเครื่องของเรา” อยู่บนอินเทอร์เน็ต
ทำไมควรเลือก VPS เมื่อ “ต้องการทำเป็นระบบ”?
เหตุผลหลักที่เหมาะคือ
- รันหลายโมเดล/หลายบริการพร้อมกัน จากเครื่องเดียว
- คุมความเป็นส่วนตัวและข้อมูล เหมาะกับงานในสายที่กังวลเรื่องข้อมูล เช่น healthcare, legal, finance
- เตรียมสเกลสำหรับทีม เพราะระบบที่เติบโตมักต้องมีมาตรฐานการ deploy และการดูแลที่เป็นระบบ
ค่าใช้จ่ายมักเริ่มจากระดับหลักหลายดอลลาร์ต่อเดือน และการเข้าถึงทำผ่าน SSH เพื่อจัดการเหมือนเครื่องตัวเอง
ข้อจำกัดสำคัญ: VPS ส่วนมากเป็น CPU และต้องเช่า GPU เพิ่มถ้าจะรันโมเดลใหญ่
ในหลายเคส VPS จะมาพร้อม CPU เท่านั้น หากต้องการรันโมเดลขนาดใหญ่หรือทำ fine-tune จำเป็นต้องมี GPU
แต่แนวทางคือเช่า GPU เพิ่มแบบรายชั่วโมงจากผู้ให้บริการเฉพาะทาง เช่น Runpod หรือ Vast.ai แล้วค่อยเรียกใช้งานร่วมกับแอปที่เรากำลังทำ
ยกระดับอีกขั้น: ใช้ Containers เพื่อรันหลายแอปไม่ชนกัน
เมื่อเริ่มมีหลายบริการในเครื่องเดียว ปัญหาหนึ่งคือ dependency ของแต่ละแอปอาจชนกัน เครื่องมืออย่าง Docker ช่วยแพ็กแอปเป็น environment แยก ทำให้รันพร้อมกันได้โดยไม่พังกันเอง
เคสยอดนิยม: รันโมเดล Local แต่ให้เว็บแอปโฮสต์บน VPS
นี่คือทางสายกลางที่น่าสนใจมาก แนวคิดคือ
- โมเดลและข้อมูลหลักยังอยู่ในเครื่องเรา (เช่น Mac mini)
- ส่วนแอปหรือบริการที่คนเข้าผ่านอินเทอร์เน็ตอยู่บน VPS
วิธีเชื่อมที่ถูกพูดถึงคือการใช้ Tailscale ช่วยเชื่อมต่ออุปกรณ์ภายในเครือข่ายแบบส่วนตัว ให้แอปบน VPS ติดต่อกับโมเดลที่รันอยู่ Local ได้ โดยไม่ต้องเปิดพอร์ตแบบเสี่ยงๆ
มุมมองส่วนตัวคือแนวทางนี้เหมือน “แบ่งบทบาท” ของโครงสร้าง เราให้ VPS เป็นประตูบนอินเทอร์เน็ต แต่ให้ Local เป็นห้องเก็บโมเดลและข้อมูล
โบนัส 1: Managed Cloud Solutions (สเกลและ compliance หนักๆ)
หมวดนี้เป็นระดับที่คนส่วนใหญ่ยังไม่ต้องใช้ แต่ถ้าต้องทำโปรดักชันระดับองค์กร มันกลายเป็นตัวเลือกที่มีเหตุผลมาก
ลักษณะคือโมเดลโอเพนซอร์สถูกโฮสต์บนคลาวด์ และระบบจะจัดการ infrastructure และสเกลอัตโนมัติให้ เราเน้นที่แอปและความต้องการธุรกิจ
สิ่งที่เหมาะคือ
- ต้องสเกลเพราะทราฟฟิกคาดเดายาก เช่นรองรับผู้ใช้จำนวนมาก
- ต้องรองรับ deployment ของโมเดลที่ปรับแต่งแล้ว
- อยู่ในอุตสาหกรรมที่ compliance เข้มงวด
โบนัส 2: On-device / Edge (โมเดลอยู่ในแอปของผู้ใช้)
On-device / Edge คือขั้นที่ “ผู้ใช้เป็นคนรัน” โมเดลภายในอุปกรณ์ของตัวเอง โดยโมเดลถูกแพ็กอยู่ในแอปและทำงานบนเครื่องของผู้ใช้พร้อมทั้งแอป
แนวทางนี้เจอมากในงานมือถือ เช่นแนวคิดที่เห็นจากระบบอย่าง Apple Intelligence และ Gemini Nano ของฝั่ง Android
แต่ความยากอยู่ตรงการทำให้โมเดล
- ถูกบรรจุและรันได้จริงในข้อจำกัดเครื่อง
- ยังให้ผลลัพธ์ตามที่ผู้ใช้งานคาดหวัง
- รักษาสมดุลเรื่องเวลาในการตอบและทรัพยากร
มองในเชิงเทรนด์ นี่คือทิศทางที่น่าจับตามอง เพราะถ้าทำได้ จะลด latency และเพิ่มความเป็นส่วนตัวในแบบที่โครงสร้างเซิร์ฟเวอร์ทำได้ยาก
จัดลำดับทางเลือกให้เลือกง่าย: ใช้อะไรเมื่อไหร่?
ต่อไปนี้เป็นกรอบคิดที่ช่วยตัดสินใจได้ไว (ใช้เป็น checklist ในการวางแผนโปรเจกต์)
ถ้าเป้าหมายคือทดลองเร็วและรักษาความเป็นส่วนตัวสูง
เริ่มจาก หมวด Local แบบใช้งานผ่าน desktop app จากนั้นค่อยไปเรียกผ่าน localhost หากอยากผูกกับซอฟต์แวร์อื่น
ถ้าเป้าหมายคือสอนหรือเดโมแบบไม่อยากตั้งค่าเครื่องทุกคน
ใช้ Browser-hosted Playground หรือ Colab Notebook แล้วออกแบบโน้ตบุ๊กให้รันตามขั้นตอน
ถ้าเป้าหมายคือสร้างผลิตภัณฑ์ให้ใช้งานได้ไว
เลือก Managed Inference API เพื่อโฟกัสที่ feature และประสบการณ์ผู้ใช้ แล้วค่อยย้ายเมื่อ usage จริงคุ้มกับการโฮสต์เอง
ถ้าเป้าหมายคือระบบที่คุมข้อมูลได้และต้องรองรับทีม
เลือก VPS และเสริม GPU หรือ containers ตามความซับซ้อนของระบบ
ถ้าเป้าหมายคือองค์กร สเกลใหญ่ และ compliance หนัก
ไปที่ Managed Cloud Solutions เพราะช่วยลดภาระด้าน infrastructure
ถ้าเป้าหมายคือ latency ต่ำและความเป็นส่วนตัวสุดทางฝั่งผู้ใช้
พิจารณา On-device / Edge แต่ควรเริ่มจากงานที่ขนาดโมเดลและข้อจำกัดอุปกรณ์เหมาะสม
สองเรื่องที่มักถูกมองข้าม: Prompting และ “การออกแบบต้นทุน”
ในสาระของการรันโมเดล หลายคนจะโฟกัสที่ฮาร์ดแวร์และแพลตฟอร์ม แต่มีอีกสองเรื่องที่ทำให้ผลลัพธ์ “ดีขึ้นแบบเห็นได้” โดยไม่ต้องเปลี่ยนวิธีรันมาก
1) Prompting คือทักษะแกนกลาง
หาก prompt สื่อสารไม่ชัด โมเดลจะเดา และผลลัพธ์จะสวิงมาก ระยะห่างระหว่าง prompt แบบ “พิมพ์สั้นๆ” กับ prompt แบบ “ชัดเจนมีบริบท” มักมีผลชัดเจนกับคุณภาพงาน
ในทางปฏิบัติ หลายคนไม่อยากเสียเวลาเขียนละเอียด จึงหันไปใช้วิธีป้อนด้วยเสียงหรือเครื่องมือช่วยจัดการ prompt เพื่อให้ได้บริบทมากขึ้นโดยไม่เหนื่อย เช่นแนวทางที่ยกตัวอย่างคือ WhisperFlow ซึ่งให้การป้อน prompt ด้วยเสียงและใช้งานได้ข้ามแอป
ถึงแม้เครื่องมือจะเป็นเพียง “ตัวช่วย” แต่ผลลัพธ์ที่ได้มาจากการให้บริบทชัดขึ้น ซึ่งคือปัจจัยจริงของคุณภาพ
2) ออกแบบต้นทุนตั้งแต่วันแรก
Local อาจดูเหมือนฟรี เพราะค่าใช้จ่ายรายเดือนน้อยกว่า แต่เรายังต้องคิดถึงค่าเครื่อง ค่าไฟ และเวลาในการดูแลระบบ
API/บริการ hosted ดูเหมือนไม่ต้องลงทุน แต่ค่าใช้จ่ายจะเพิ่มตาม usage ดังนั้นควรประเมิน “จุดที่คุ้ม” ในการย้ายจาก API ไปเป็น VPS หรือ Local
วิธีง่ายที่สุดคือบันทึกต้นทุนต่อ 1,000 คำขอหรือ 1,000 การตอบ แล้วค่อยเทียบกับต้นทุนโครงสร้างของทางเลือกอื่น
คำศัพท์เฉพาะทางเพิ่มเติม
Ollama
เครื่องมือจัดการโมเดลและรันแบบ local ที่ช่วยให้ดาวน์โหลดโมเดลและเริ่มใช้งานได้เร็ว พร้อมรองรับการเรียกผ่าน localhost
Fine-tune
การปรับน้ำหนักโมเดลให้เข้ากับข้อมูลหรือรูปแบบงานเฉพาะ ใช้เพื่อเพิ่มความแม่นยำในงานที่โมเดลฐานอาจยังไม่ตรง
มักต้องใช้ GPU และมีต้นทุนด้านเวลาและกระบวนการเพิ่มขึ้น
VPS
เซิร์ฟเวอร์เสมือนที่เราเช่าจากผู้ให้บริการ เพื่อรันแอปและบริการของเราเอง เหมาะเมื่ออยากคุมระบบและความปลอดภัยมากขึ้น
Managed Inference API
บริการที่ผู้ให้บริการโฮสต์โมเดลและให้เราเรียกใช้งานผ่าน API ด้วย API key เหมาะกับการสร้างแอปและทำโปรดักชันไว
Container (เช่น Docker)
แพ็กแอปและ dependency ให้อยู่ใน environment แยก ช่วยให้รันหลายบริการในเครื่องเดียวได้โดยไม่ชนกัน
บทสรุปส่งท้าย
- การรัน Open Source AI Models ในสมัยนี้ “ไม่ได้ต้องเริ่มจากฮาร์ดแวร์เทพ” เสมอไป เพราะหมวด Local และเครื่องมือเดสก์ท็อปทำให้เริ่มใช้งานได้เร็ว
- การเลือกทางที่เหมาะขึ้นอยู่กับเป้าหมายหลัก: ทดลองเร็ว ใช้ Local หรือ Playground, สร้างผลิตภัณฑ์ใช้ API, ต้องคุมระบบและข้อมูลใช้ VPS
- Fine-tune เป็นขั้นที่ต้องยอมรับความยากและต้นทุนเพิ่มขึ้น ส่วนใหญ่ควรเริ่มจาก prompt และ workflow ก่อน แล้วค่อย fine-tune เมื่อมีข้อมูลพอ
- สองตัวแปรที่เปลี่ยนผลลัพธ์ได้จริงคือคุณภาพ prompt และการคำนวณต้นทุนต่อการใช้งาน ไม่ใช่แค่ความแรงของเครื่อง
- ถ้าวางแผนระยะยาว การเริ่มด้วย API หรือ Playground ไม่ผิด เพราะช่วยหาทิศทางก่อน แล้วค่อยย้ายไปโครงสร้างที่คุมได้มากขึ้นเมื่อใช้งานโต
