

บทความต้นทางวันที่ 18 มีนาคม 2026 อธิบายแนวคิด API ของ Perplexity และตัวอย่างที่ผู้จัดทำต้นทางนำเสนอ ข้อความบุรุษที่หนึ่งและประสบการณ์ส่วนตัวเป็นถ้อยคำของต้นทาง ไม่ใช่ประสบการณ์ที่กองบรรณาธิการทดสอบเอง ภาพประกอบเป็นหน้าสาธิตและตัวจำลองงานที่ต้นทางแสดง ยังไม่ได้ยืนยันว่าเป็นหน้าบริการจริงหรือผลการรันงานจริง คำว่า “Vidya” คงไว้ตามต้นฉบับเพราะยังยืนยันการถอดชื่อผู้ให้บริการไม่ได้ ข้อความ Sandbox API “กำลังจะมา” เป็นสถานะที่ต้นทางรายงานในวันดังกล่าว ไม่ใช่การยืนยันสถานะปัจจุบัน การรวมสแต็กเป็น API เดียวเป็นข้อวิเคราะห์ของต้นทาง ไม่ได้รับประกันว่าทดแทนระบบทุกส่วนหรือทำงานโดยปราศจากความเสี่ยง ข้อความ “No Risk” ในภาพไม่ใช่การรับรองความปลอดภัย ต้นทางไม่มี iframe วิดีโอ จึงอ้างอิงหน้าบทความและยังไม่ได้ยืนยันตัวตนวิดีโอต้นฉบับ · แหล่งอ้างอิงในบทความต้นทาง
มีข่าวสาย AI หลายอย่างที่ดังเร็วและผ่านเร็ว แต่ครั้งนี้รู้สึกว่ามันแรงจริง เพราะ Perplexity ไม่ได้แค่ “ทำให้แชทตอบดีขึ้น” หรือ “ค้นหาเก่งขึ้น” อีกแล้ว เขากำลังกระโดดไปเป็นแพลตฟอร์มสำหรับการสร้าง AI agents แบบใช้งานได้จริง ผ่าน API เดียว ครอบตั้งแต่การค้นเว็บ การใช้โมเดล การทำ embeddings ไปจนถึงตรรกะของเอเจนต์
ประเด็นที่ทำให้หลายคนเริ่มเงียบกับมันทั้งที่น่าจับตา คือแนวคิดที่ว่า ชุดเครื่องมือที่เคยต้องประกอบจากหลายบริการ และต้องปะติดปะต่อให้ยุ่งยาก ตอนนี้ถ้าพอใจในแนวทางของ Perplexity อาจยุบเหลือ “ระบบเดียว” ที่เรียกผ่าน API ทางเดียว
บทความนี้สรุปและวิเคราะห์สิ่งที่แพลตฟอร์มใหม่ของ Perplexity ตั้งใจทำ รวมถึงมองแบบตรงไปตรงมาว่ามันเหมาะกับใครบ้าง และควรระวังอะไรเมื่อย้ายจากโลกของแชทบอท ไปสู่โลกของเอเจนต์ที่ทำงานเอง
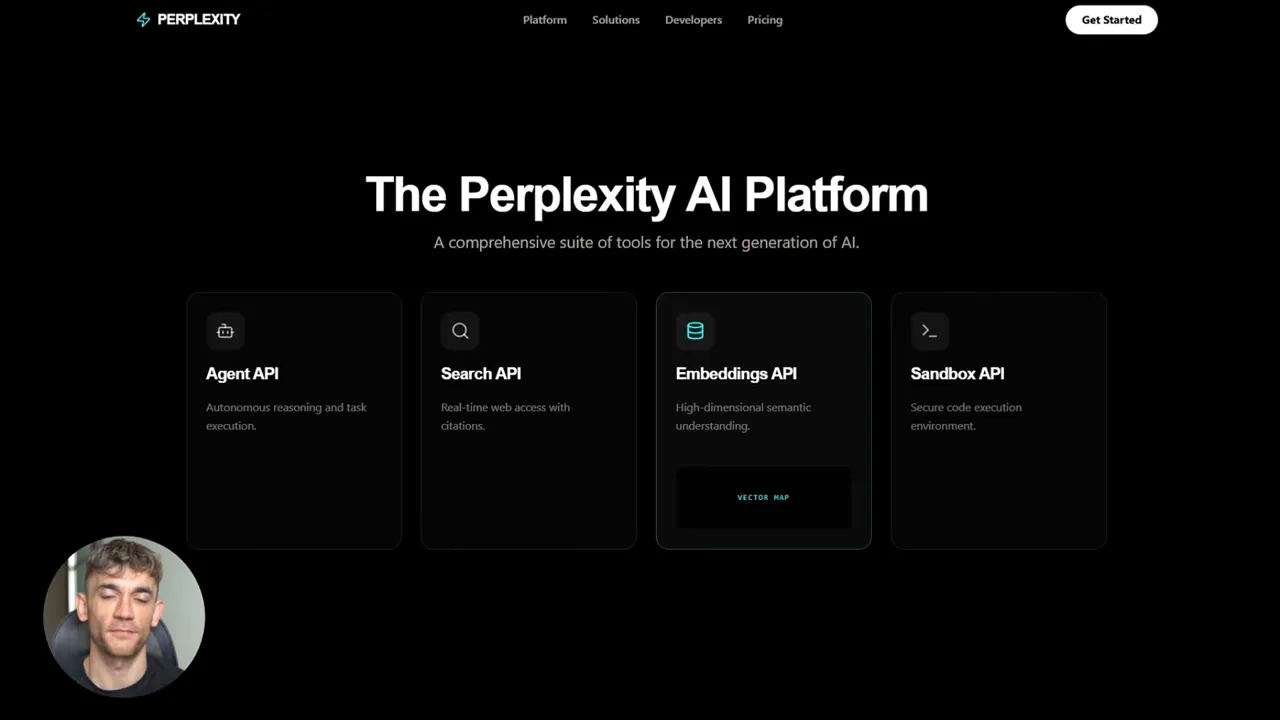
แหล่งอ้างอิงที่มีในต้นฉบับ: Agent API Search API Sandbox API
แหล่งอ้างอิงที่มีในต้นฉบับ: model agnostic
จากเครื่องมือค้นหา สู่ “โครงสร้างพื้นฐาน” ของ AI agents
ถ้าไล่ภาพใหญ่ Perplexity เดินมาไกลจากบทบาทเดิมที่เป็น AI search engine ซึ่งถูกใช้งานเพื่อคำตอบและการอ้างอิง แต่การเปิดตัวแพลตฟอร์มเอเจนต์ทำให้เขาพยายามเปลี่ยนสถานะเป็นสิ่งที่นักพัฒนาติดตั้งแล้ว “สร้างงานต่อยอดได้ทันที”
ในโลกปัจจุบัน การทำ AI ให้ใช้งานในธุรกิจไม่ใช่แค่ต้องมีโมเดลภาษา (LLM) ที่เขียนเก่งพอ แต่ต้องมีองค์ประกอบอื่น เช่น การค้นข้อมูลสด การเข้าใจความหมายของเอกสาร การเก็บและค้นคืนข้อมูลแบบ semantic และสุดท้ายคือ “ตัวประสาน” ที่ทำให้ระบบทำงานเป็นขั้นตอน
สิ่งที่ Perplexity พยายามขายคือความเรียบง่ายแบบสถาปัตยกรรม ไม่ใช่แค่คุณภาพคำตอบ
สี่แกนหลักของ Perplexity AI Super Agent Platform
แพลตฟอร์มใหม่นี้ถูกวางไว้ด้วยองค์ประกอบหลัก 4 ส่วน ซึ่งแต่ละส่วนมีคุณค่าในตัวเอง แต่เมื่อรวมกันจะกลายเป็น “ชิ้นเดียวที่ทำงานครบ”
1) Agent API: จุดที่ทำให้เป็น “เอเจนต์จริง”
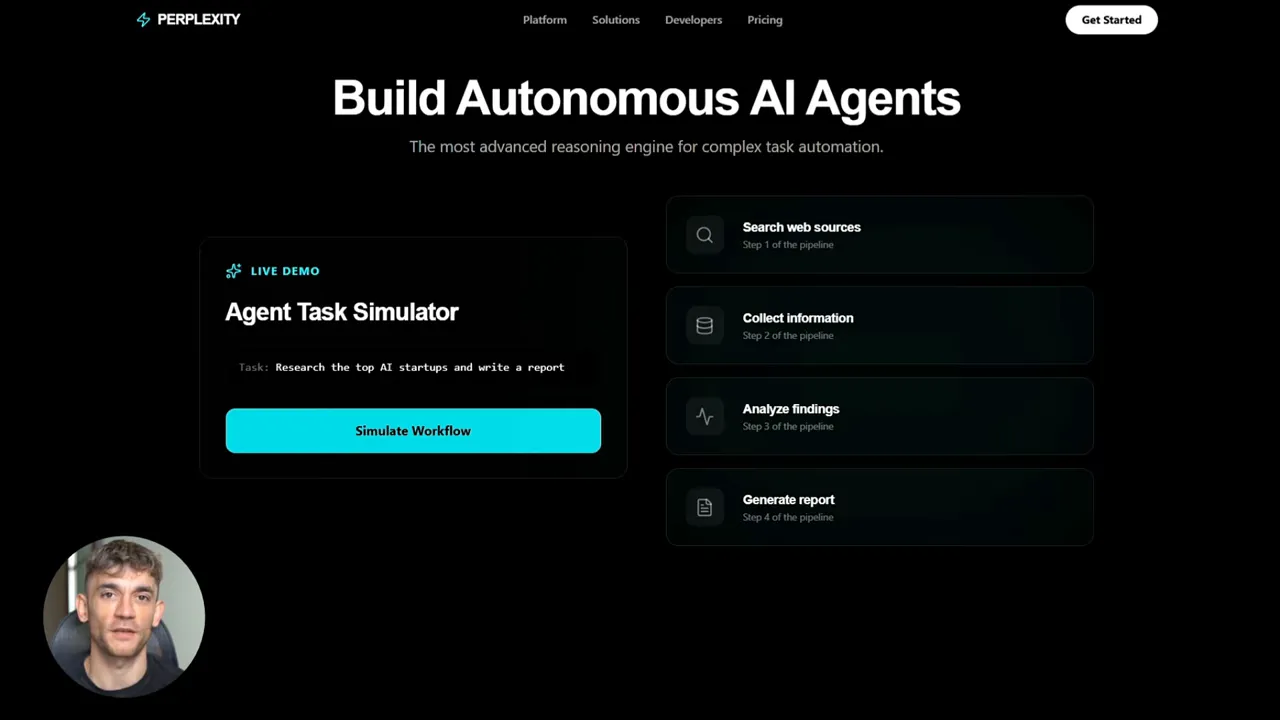
หัวใจของเรื่องนี้คือ Agent API เพราะนี่คือส่วนที่ให้สร้างเอเจนต์ที่ทำงานหลายขั้นตอนได้ เช่น การค้นเว็บ การอ่านเอกสาร การใช้เครื่องมือ และการคิดเป็นลำดับ
ภาพที่เข้าใจง่ายคือ เราบอกโจทย์เดียว เช่น “ทำรายงานหัวข้อ X: หาอย่างน้อย 10 แหล่ง สรุปแต่ละแหล่ง แล้วเขียนรายงานเต็ม” เอเจนต์ควรเดินกระบวนการนี้ตั้งแต่ต้นจนจบโดยไม่ต้องให้คนมานั่งคอยส่งคำสั่งทีละนิด
สิ่งที่ทำให้ดูเหนือกว่าการ “ให้โมเดลตอบ” คือเอเจนต์ถูกออกแบบให้มีเครื่องมือและความสามารถในการทำงานตามขั้นตอน ไม่ใช่แค่ทายคำต่อคำ
มุมมองส่วนตัว: สิ่งที่คนส่วนใหญ่เจอเมื่อเริ่มทำเอเจนต์ คือคำสั่งที่ดูเหมือนง่าย แต่เบื้องหลังมันต้องจัดการหลายอย่าง เช่น เลือกแหล่งข้อมูล ตรวจความถูกต้อง ทำหลายรอบ และสรุปให้เป็นโครงสร้าง ถ้าแพลตฟอร์มลดภาระตรงนี้ได้จริง มันจะลด “เวลาจากไอเดียถึงของใช้ได้” ลงได้เยอะ
2) Model agnostic: ไม่ล็อกอินอยู่กับโมเดลเดียว
อีกจุดที่ทำให้แพลตฟอร์มนี้น่าติดตาม คือแนวคิด model agnostic หมายถึงระบบไม่ได้ผูกกับโมเดลใดโมเดลหนึ่ง
ในกรอบของแพลตฟอร์มนี้ สามารถเลือกใช้โมเดลจากหลายผู้ให้บริการผ่าน API เดียว ตัวอย่างที่ถูกกล่าวถึง ได้แก่ OpenAI, Anthropic, Google, xAI และ Vidya
เหตุผลที่มันสำคัญในเชิงปฏิบัติ คือทีมพัฒนามักอยาก “แยกบทบาทของโมเดล” เช่น ใช้โมเดลหนึ่งเก่งเรื่องการค้นและวิเคราะห์ อีกโมเดลเก่งเรื่องการเขียน หรือใช้โมเดลที่คุมงบประมาณได้ดีกว่าในขั้นตอนหนึ่ง
ถ้าแพลตฟอร์มทำให้สลับได้ง่าย มันก็ทำให้การทดลอง (iteration) เร็วขึ้น และทำให้ระบบไม่ผูกติดกับผู้ให้บริการรายใดรายหนึ่งมากเกินไป
3) Search API: ดึงข้อมูลสดจากเว็บแบบต่อให้เอเจนต์
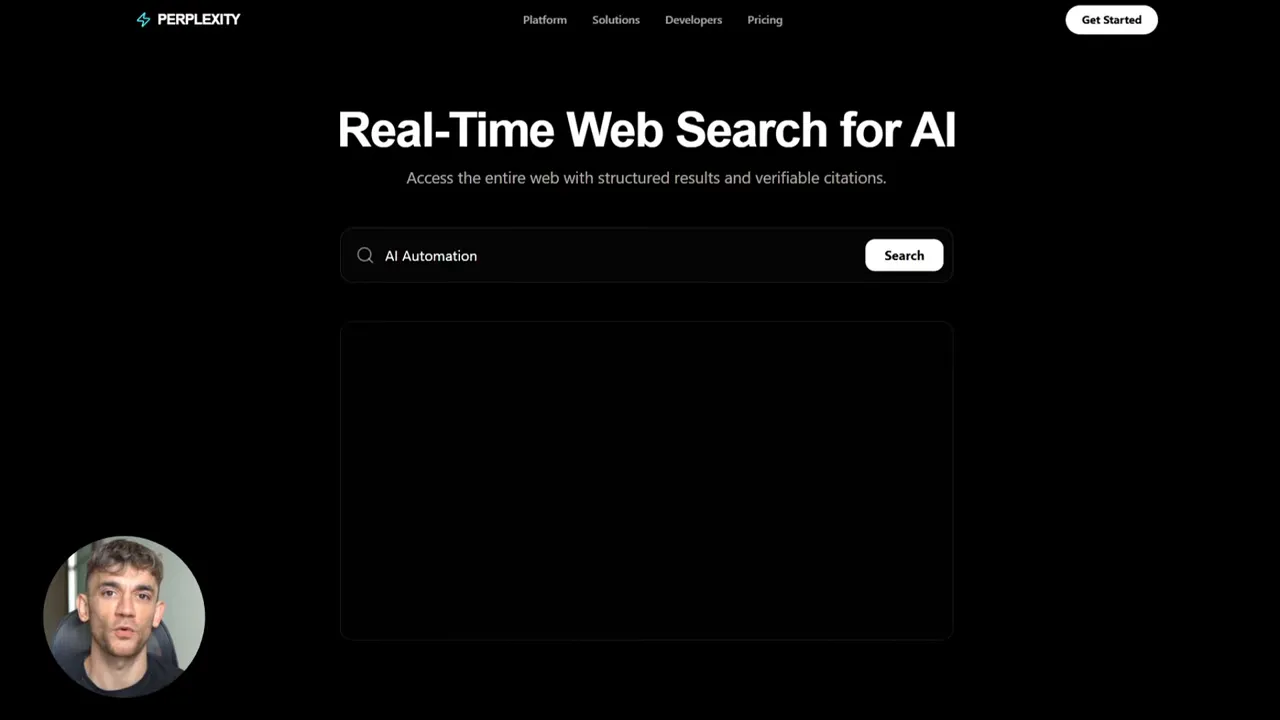
ส่วนที่สองคือ Search API ซึ่งเปิดให้เรียกด้วยนักพัฒนา โดยใช้พลังงานจากเครื่องมือค้นหาที่อยู่เบื้องหลังผลิตภัณฑ์ของ Perplexity เอง
ภาพการใช้งานคือเอเจนต์หรือแอปสามารถดึงข้อมูลแบบเรียลไทม์จากอินเทอร์เน็ตได้ ไม่ใช่พึ่งข้อมูลในเทรนแบบเดิม
แนวคิดที่ถูกเน้น ได้แก่ ผลลัพธ์แบบใหม่ มีการกรองตามโดเมน และสามารถส่งคำถามหลายรายการได้ในคราวเดียว
สิ่งที่น่าคิดคือ “ความสด” ของข้อมูลไม่ใช่เรื่องเล็ก ถ้าเอเจนต์ถูกใช้ทำ market analysis หรือ competitive intelligence ข้อมูลที่ล้าหลังไม่ใช่แค่ทำให้ตอบช้า แต่ทำให้ตัดสินใจผิดได้
4) Embeddings API: ทำให้เอเจนต์เข้าใจความหมายและค้นคืนได้ดี
อีกแกนหนึ่งที่คนเริ่มทำ AI มักต้องเจอ คือ embeddings
embeddings คือการแปลงข้อความให้อยู่ในพื้นที่เชิงความหมาย เพื่อให้ระบบจับ “ความเหมือน” และ “ความเกี่ยวข้อง” ได้ดีกว่าการค้นด้วยคำตรงตัว
ในงานที่เกี่ยวกับเอกสารจำนวนมาก การมี embeddings ช่วยให้เอเจนต์สามารถค้นหาข้อมูลที่เกี่ยวข้องกับบริบทได้ เช่น ค้นเอกสารที่คล้ายกับคำถาม ดูว่าชิ้นส่วนไหนควรถูกหยิบมาอ้าง หรือจำบริบทเดิมเพื่อไม่ให้ตอบหลุด
ในแพลตฟอร์มนี้ มีการกล่าวถึง embeddings ที่สร้างขึ้นสำหรับการทำงานระดับใหญ่ (large-scale) เหมาะกับงานที่มีข้อมูลจำนวนมาก
มุมมองส่วนตัว: คนชอบมอง embeddings เป็นเรื่อง “ขั้นเทคนิค” แต่ในระบบเอเจนต์ที่ทำงานเป็นหลายขั้น ตอนที่ต้องอ้างอิงหลักฐานหรือกลับมาทบทวนความรู้เดิม embeddings มักเป็นตัวช่วยให้ระบบมีความต่อเนื่องและลดการหลงประเด็น
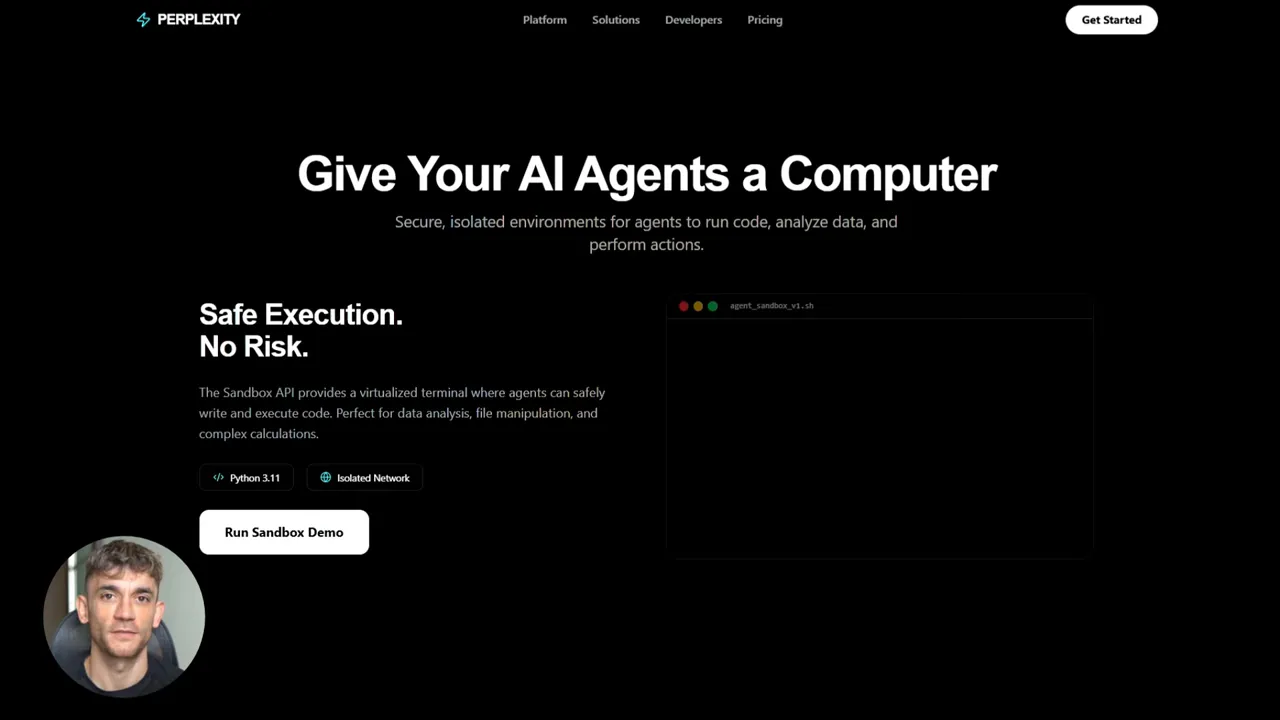
5) Sandbox API: เอเจนต์จะได้ “รันโค้ด” ในสภาพแวดล้อมที่ปลอดภัย
ส่วนที่สี่ระบุว่าเป็น Sandbox API ซึ่งกำลังจะมา และตั้งใจให้เอเจนต์สามารถรันโค้ด ทดสอบ และทำงานในสภาพแวดล้อมที่ปลอดภัย
การมี sandbox สำคัญมาก เพราะถ้าเอเจนต์ทำ “การทดลอง” ได้โดยไม่กระทบระบบจริง ก็ช่วยลดความเสี่ยงของการรันคำสั่งผิดพลาด
ในเชิงเปรียบเทียบ sandbox คือ “คอมพิวเตอร์ของเอเจนต์” ที่ทำให้เขาลองผิดลองถูกได้อย่างมีกรอบ
ทำไม “หนึ่ง API” ถึงน่ากังวลแบบดี และน่ากลัวแบบดี
คำว่า “แทนสแต็ก AI ทั้งกอง” ฟังดูแรง แต่สิ่งที่ทำให้คนสนใจคือ pain point ที่แทบทุกทีมเจอเมื่อต้องทำ agent หรือระบบ AI ขึ้นมา
ก่อนหน้านี้ ถ้าจะทำเอเจนต์ให้ทำงานได้ ต้องประกอบหลายบริการ เช่น ผู้ให้บริการโมเดล, API สำหรับค้นเว็บ, service สำหรับ embeddings, ตัวจัดการ orchestration อย่าง LangChain และยังต้องทำโค้ด glue เองเพื่อเชื่อมส่วนต่างๆ
ผลลัพธ์คือมีหลายบัญชี หลายเอกสาร หลายขั้นตอน และเมื่อระบบโตขึ้น การดีบักก็ยิ่งยากขึ้น
แนวคิดของ Perplexity คือให้เรียกผ่าน API เดียวเพื่อรวม “model, search, embeddings, agent logic” เข้าไว้ด้วยกัน
มุมมองแบบตรงไปตรงมา: การรวมสแต็กให้เหลือ API เดียวจะช่วยลดความยุ่ง แต่ก็แลกกับการยอมรับรูปแบบการทำงานของแพลตฟอร์มนั้น หากงานของทีมต้องการความยืดหยุ่นสูงมากหรือมีระบบ legacy ที่ผูกกับเครื่องมืออื่นอยู่ การย้ายทั้งก้อนไม่ได้ง่ายเสมอ
อย่างไรก็ตาม ถ้าเป้าหมายคือสร้างต้นแบบอย่างรวดเร็ว หรือทำ workflow ที่ไม่ซับซ้อนเกินไป การรวมเป็นแพลตฟอร์มเดียวมักชนะในเชิงเวลา
ตัวอย่าง Use Cases ที่เห็นภาพทันที
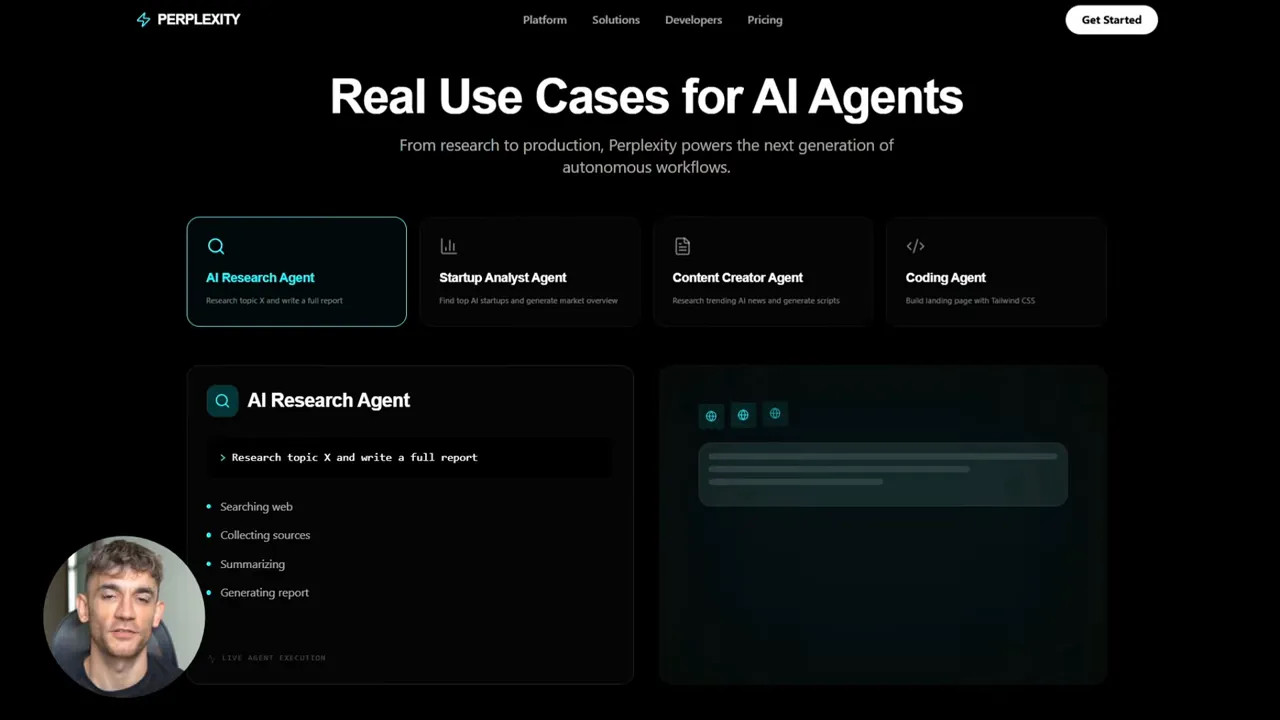
ส่วนที่น่าติดตามคือการยกตัวอย่างการใช้งาน ซึ่งสอดคล้องกับสิ่งที่เอเจนต์ควรทำได้ดี คือ งานที่ต้อง “ค้นหา อ่าน สรุป และลงมือทำตามขั้นตอน”
Use Case 1: AI research agent
โจทย์ให้เอเจนต์ทำงานวิจัย เช่น หัวข้อหนึ่งต้องค้นเว็บ หาหลักฐาน หลายแหล่ง อ่านและสรุป แล้วเขียนรายงานเต็ม
สิ่งที่ถูกเน้นคือเวลาที่ลดลง จากงานที่เคยกินเวลาหลายชั่วโมง เหลือไม่กี่นาที และเพราะใช้ search แบบเรียลไทม์ รายงานจึงไม่ติดอยู่กับข้อมูลเก่า
สำหรับคนทำคอนเทนต์หรือทำงานวิเคราะห์ ผลกระทบมีชัดมาก เพราะความสดของข้อมูลและความเร็วของการสรุปคือแรงขับหลัก
Use Case 2: Startup analyst agent
อีกกรณีคือเอเจนต์วิเคราะห์วงการสตาร์ทอัป เช่น หา top startups ที่เปิดตัวในรอบ 1 ปี เปรียบเทียบสิ่งที่พวกเขาสร้าง ดูเทคโนโลยี และสรุปภาพรวมตลาด
นี่เป็นงานที่นอกจากต้องค้นแล้ว ยังต้องจัดหมวดหมู่และเปรียบเทียบ ไม่ใช่แค่รวบรวมลิงก์
เอเจนต์จึงต้องมีตรรกะในการทำงานหลายขั้น และต้องอาศัยทั้ง search และการเรียบเรียง
Use Case 3: Content creator agent
สำหรับสายคอนเทนต์ เอเจนต์ถูกวางให้ทำทั้งกระบวนการ เช่น ค้นข่าว AI แนวโน้มในสัปดาห์นี้ เสนอไอเดียวิดีโอ และเขียนสคริปต์
ความน่าสนุกอยู่ตรงที่ workflow หนึ่งชิ้นถูกปิดได้ในตัวเดียว ไม่ต้องสลับเครื่องมือหลายชุดให้เสียสมาธิ
และเพราะใช้ real-time search จึงหลีกเลี่ยงการสรุป “จากความจำเดิม” ที่อาจไม่ตรงกับสถานการณ์ล่าสุด
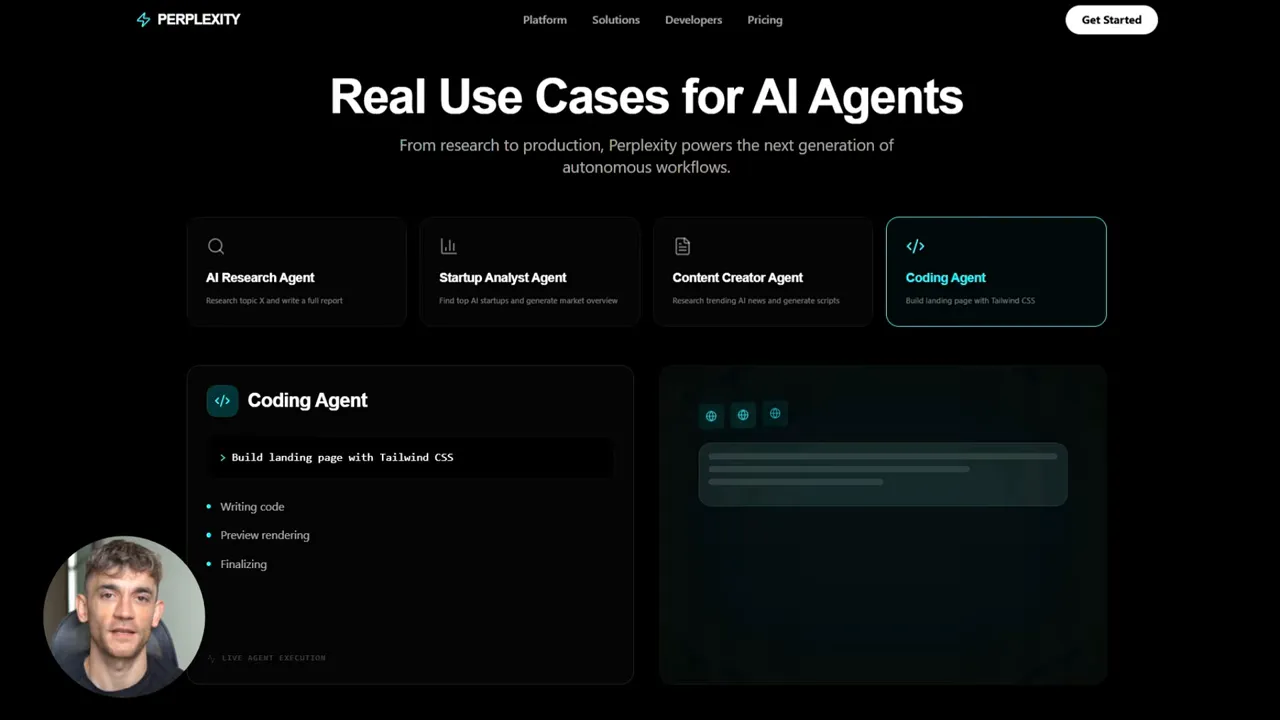
Use Case 4: Coding agent สำหรับทำ landing page
ตัวอย่างด้านโค้ด คือให้เอเจนต์สร้าง landing page ตามสเปก เช่น Tailwind CSS และคุณสมบัติต่างๆ แล้วให้ได้โค้ดเต็ม ไม่ใช่แค่ snippet
กรณีนี้ยิ่งเห็นภาพว่าทำไม sandbox API ถึงสำคัญ เพราะการสร้างโค้ดมักต้องทดสอบ ทำให้การันตีผลลัพธ์เร็วขึ้นถ้าเอเจนต์สามารถรันในสภาพแวดล้อมที่ปลอดภัย
ภาพใหญ่ของอุตสาหกรรม: จาก chatbot ไปสู่ agent
จุดที่ผู้คนจำนวนมากเริ่มพูดตรงกัน คือ AI กำลังขยับจาก “การตอบคำถามเมื่อถูกถาม” ไปสู่ “การลงมือทำเมื่อถูกกำหนดเป้าหมาย”
แชทบอทส่วนใหญ่ทำหน้าที่รอคำถามใหม่ แก้ปัญหาเป็นรอบๆ แต่ agent พยายามเดินงานให้เสร็จด้วยตัวเอง
Perplexity วางบทบาทตัวเองไว้ตรงกลางการเปลี่ยนนี้ เขาไม่ได้โฟกัสแค่ “แข่งขันกับ Google ในเรื่องค้นหา” แต่กำลังสร้างแพลตฟอร์มที่นักพัฒนาสร้าง agent ได้
ในมุมนี้ เป้าหมายคือการเป็นที่ที่ developer ไปวางโครงสร้าง ไม่ใช่แค่เป็นปลายทางที่ผู้ใช้ค้นคำถามแล้วได้คำตอบ
การคุมพฤติกรรมเอเจนต์: ทำให้ไม่หลุดและไม่เสียงบ
อีกเรื่องที่พูดถึงในแพลตฟอร์มคือการมี “built-in tools” และโหมดการคิดหลายแบบ เช่น การค้นแบบรวดเร็ว การเจาะลึก และการเจาะลึกขั้นสูง
รวมถึงการ “คุม tokens” เพื่อไม่ให้เอเจนต์หลุดออกนอกเส้นทาง
สิ่งนี้สำคัญเพราะเอเจนต์ที่ให้ทำงานเองมีความเสี่ยงตามธรรมชาติ เช่น ใช้เวลาวนหาไม่จบ หรือใช้งบเกินจำเป็น
ถ้าแพลตฟอร์มมีระบบควบคุมตั้งแต่ต้น มันจะทำให้ต้นทุนและคุณภาพคาดเดาได้มากขึ้นสำหรับการใช้งานจริง
เป้าหมายฝั่ง Enterprise: เอเจนต์ที่ทำงานแทนคนใน workflow จริง
Perplexity ยังผลักดันการใช้งานในระดับองค์กร โดยมองว่าเอเจนต์ไม่ใช่แค่เครื่องมือเล่น แต่ต้องเข้ากับงานที่ซับซ้อน เช่น การทำ customer research, market analysis, competitive intelligence
นี่เป็นแนวคิดที่น่าจะโดนใจองค์กร เพราะงานพวกนี้มี “ขั้นตอนและผลลัพธ์” ที่ชัดเจน ต่อให้คนทำยังไงก็ต้องมีการค้นข้อมูลจากหลายแหล่ง แล้วสรุปเป็นรายงาน
พอเปลี่ยนเป็นเอเจนต์ที่ทำซ้ำได้ ระบบจะกลายเป็นเครื่องจักรสำหรับวิเคราะห์ที่ทำงานอย่างสม่ำเสมอมากขึ้น
แน่นอน องค์กรยังต้องระวังเรื่องการตรวจสอบแหล่งข้อมูล การกำกับความถูกต้อง และนโยบายความปลอดภัย แต่ทิศทางนี้เห็นชัดว่ากำลังจะเกิด “การย้ายงานเอกสารและงานค้นข้อมูล” ไปอยู่ในระบบอัตโนมัติ
AWS ของ AI agents: ทำไมการเป็นโครงสร้างพื้นฐานถึงสำคัญ
มีการเปรียบเทียบที่น่าจำ คือ AWS กลายเป็น backbone ของอินเทอร์เน็ต แอปและสตาร์ทอัปจำนวนมากต้องวิ่งบน AWS
Perplexity พยายามทำบทบาทคล้ายกันกับ AI agents คือเป็นชั้นโครงสร้างพื้นฐานที่หลายทีมสร้างของต่อได้
เมื่อแพลตฟอร์มทำได้ครบในจุดที่นักพัฒนาต้องใช้บ่อย จะมีโอกาสเกิดระบบนิเวศ (ecosystem) และผู้ใช้งานจำนวนมากจะค่อยๆ ยึดติดกับ flow เดียวกัน
ภาพที่ตามมาคือ หากในอนาคต workflow ของเอเจนต์กลายเป็นมาตรฐาน ทีมที่มี infrastructure ที่เชื่อมทุกอย่างเข้าด้วยกันอาจได้เปรียบ
ข้อควรคิดก่อนเริ่มย้าย: สิ่งที่คนทำระบบควรถามตัวเอง
ถึงแพลตฟอร์มจะดูครบและเรียบง่าย แต่การตัดสินใจควรมาจากข้อเท็จจริงของงาน ไม่ใช่ความตื่นเต้นอย่างเดียว
คำถามที่ควรตั้งให้ชัด ได้แก่ งานที่ต้องทำมีความเฉพาะทางแค่ไหน และจะยอมผูกกับแนวทางของ Perplexity ได้ระดับไหน ถ้าต้องการควบคุมรายละเอียดเชิงลึกมาก เช่น โครงสร้างข้อมูลเอกสารเฉพาะทาง การจัดการเวิร์กโฟลว์ที่ซับซ้อน หรือระบบ compliance ที่เข้มงวดมาก อาจต้องทดสอบแบบค่อยเป็นค่อยไป
อีกประเด็นคือคุณภาพของ output และการอ้างอิงข้อมูลต้องตรวจสอบได้เสมอ เพราะเมื่อเอเจนต์ทำงานเอง ความเสี่ยงที่ไม่เห็นจะโตขึ้น การออกแบบกระบวนการยืนยัน (verification) ใน workflow ยังจำเป็น
และสุดท้ายคือเรื่องต้นทุน ถ้าเอเจนต์ใช้ search และคิดหลายรอบ ต้นทุนจะสัมพันธ์กับ token และจำนวนการเรียกใช้เครื่องมือ การคุมโหมดและการจำกัด token จึงเป็นเรื่องที่ไม่ควรมองข้าม
แนวทางเริ่มต้นใช้งาน: ทำให้เป็นโปรเจกต์ทดลองที่มีเป้าหมาย
ถ้ามองแบบที่ช่วยให้ลงมือได้เร็ว วิธีที่เหมาะคือเริ่มจากงานที่ “จับผลลัพธ์ได้” และต้องใช้ข้อมูลสดหรือเอกสารจริง เช่น
- ทำรายงานวิจัยหัวข้อเดียวต่อวันหรือสัปดาห์ แล้วเทียบกับวิธีทำแบบเดิม
- ทำสรุปข่าวอุตสาหกรรมพร้อมหมวดหมู่และแหล่งอ้างอิง
- ทำ workflow วิเคราะห์คู่แข่ง โดยกำหนดโครงสร้างเอาต์พุตให้ชัด
- ทำ landing page จากสเปกที่กำหนด แล้วให้ระบบสร้างโค้ดเต็ม จากนั้นให้ตรวจสอบด้วยขั้นตอนทดสอบของทีม
สิ่งสำคัญคือกำหนด “นิยามความสำเร็จ” ตั้งแต่ต้น ไม่เช่นนั้นจะกลายเป็นการลองแล้วไม่รู้ว่าควรปรับตรงไหน
มุมมองส่วนตัว: เคยเจอสถานการณ์ที่ทีมเอา AI agent ไปทำงานกว้างๆ จนสุดท้ายคนไม่แน่ใจว่า output ดีขึ้นจริงหรือแค่ “ดูยาวขึ้น” เมื่อกลับมาจัดระเบียบใหม่และกำหนดฟอร์แมตผลลัพธ์ให้ชัด เช่น ต้องมีหัวข้อ, ต้องมีแหล่งอ้างอิง, ต้องมีสรุปสั้นท้ายรายงาน ผลลัพธ์ดีขึ้นทันที
คำศัพท์เฉพาะที่น่าสนใจ
AI agents
ระบบที่ไม่ได้ตอบแค่ข้อความ แต่พยายามทำงานตามเป้าหมาย โดยอาจค้นข้อมูล ใช้เครื่องมือ อ่านเอกสาร และทำหลายขั้นจนจบ เช่น “ทำรายงาน” หรือ “สร้างโค้ดตามสเปก”
Agent API
API ที่ใช้สร้างและสั่งเอเจนต์ให้ทำงานหลายขั้น เช่น ค้นเว็บ อ่านแหล่งข้อมูล และสรุปเป็นผลลัพธ์ตามคำสั่ง
Model agnostic
แนวทางที่ช่วยให้สลับโมเดล AI ได้โดยไม่ต้องเปลี่ยนสถาปัตยกรรมทั้งหมด เช่น เลือกโมเดลหนึ่งสำหรับ research และอีกโมเดลสำหรับเขียน
Embeddings
การแปลงข้อความให้เป็นเวกเตอร์ เพื่อให้ระบบเข้าใจความหมายและค้นคืนความเกี่ยวข้องได้ดี เช่น ค้นเอกสารที่ “ใกล้เคียงความหมาย” กับคำถาม
Sandbox API
สภาพแวดล้อมจำลองหรือพื้นที่ปลอดภัยสำหรับให้เอเจนต์รันโค้ดและทดสอบงาน โดยไม่กระทบระบบจริง
สิ่งที่ได้จากคลิปนี้
เมื่อรวมกันแล้ว แพลตฟอร์มใหม่ของ Perplexity ทำให้เราเห็นทิศทางที่ชัดมากว่า เอเจนต์กำลังจะกลายเป็นผลิตภัณฑ์ที่ “ต้องมี infrastructure” ไม่แพ้โมเดลภาษา
จุดที่ควรเก็บไว้คือ
- Agent API คือแกนสำหรับเอเจนต์ที่ทำงานหลายขั้นและใช้งานจริงได้
- Search API ทำให้ข้อมูลเป็นปัจจุบัน ซึ่งมีผลต่องานวิเคราะห์และคอนเทนต์อย่างชัดเจน
- Embeddings API ช่วยให้ระบบเข้าใจความหมายของเอกสารและค้นคืนได้ดีในงานที่มีข้อมูลจำนวนมาก
- Sandbox API จะยกระดับเอเจนต์ให้ทำงานทดลองหรือรันโค้ดอย่างปลอดภัย
- การรวมหลายส่วนให้เหลือ หนึ่ง API ลดภาระการประกอบสแต็กและเร่งต้นแบบได้เร็ว
สำหรับทีมที่ทำงานด้าน AI เพื่อผลลัพธ์ทางธุรกิจ แนวคิดนี้น่าสนใจมาก เพราะมันย้ายศูนย์กลางจาก “ทำให้แชทตอบเก่ง” ไปสู่ “ทำให้ระบบทำงานจบ” ซึ่งเป็นสิ่งที่องค์กรต้องการจริงๆ
