

วันที่บทความต้นทางใน VideoToBlog: 2026-04-08 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว กรณีเครดิตและตัวเลขความผิดพลาดเป็นตัวอย่างที่ผู้บรรยายรายงานเพื่ออธิบายปัญหาระบบ ไม่ใช่การตรวจสอบอิสระหรือคำแนะนำให้ตัดสินสินเชื่อ สถาปัตยกรรม Databricks เป็นแนวทางในต้นทางและต้องทดสอบตามข้อจำกัดของงานจริง ตัวอย่างการซื้อขายในแผนภาพเป็นภาพประกอบกระบวนการ ไม่ใช่คำแนะนำลงทุนหรือการรับประกันว่าจะย้อนกลับธุรกรรมจริงได้ · วิดีโอต้นทาง
หลายคนเริ่มต้นด้วยหนึ่งเอเจนต์ เพราะมัน “เดโม่” ได้ง่าย ใส่พรอมต์ เติมเครื่องมือ (tools) หรือทำ RAG แล้วระบบตอบได้สวยงาม เราเห็นผลเร็ว ทีมมั่นใจ ลูกค้าประทับใจ
แต่เมื่อธุรกิจเริ่มขยายจากหนึ่งเอเจนต์ไปเป็นหลายเอเจนต์ จุดเปลี่ยนเกิดขึ้นทันที สิ่งที่เคยเป็นปัญหาเชิงโมเดล กลายเป็นปัญหาเชิงสถาปัตยกรรมและการประสานงาน (coordination) แบบ distributed systems และนั่นคือเหตุผลที่โปรเจกต์ multi-agent บางทีม “ดูเหมือนเดินหน้า” แต่กลับจบด้วยดีเลย์ การตัดสินใจผิดพลาด และการดีบักที่มองไม่เห็นต้นเหตุ
บทความนี้สรุปและวิเคราะห์มุมมองสำคัญจากประสบการณ์การทำ production-grade distributed systems สำหรับ multi-agent AI โดยเน้นสิ่งที่มักถูกมองข้าม: การเลือก choreography vs orchestration, การจัดการ state แบบ versioned, data contracts, และรูปแบบการรับมือความล้มเหลว เช่น circuit breaker และ compensation (Saga pattern) พร้อมแนวทางสถาปัตยกรรมที่รวมทุกชิ้นเข้าด้วยกันแบบเป็นระบบ
เมื่อ “หนึ่งเอเจนต์” ทำงานดี แล้วทำไม “ห้าเอเจนต์” ถึงพัง?
หนึ่งเอเจนต์ทำงานเหมือนฟีเจอร์เดี่ยว: รับอินพุตจากคนหรือระบบ สร้างคำตอบ เรียกเครื่องมือเท่าที่จำเป็น และส่งผลลัพธ์กลับไปจบในรอบเดียว ความซับซ้อนส่วนใหญ่ถูกซ่อนอยู่ในโมเดล
แต่พอเพิ่มเป็นห้าเอเจนต์ เราไม่ได้เพิ่ม “ฟีเจอร์” ห้าอย่าง เรากำลังเพิ่ม “ความสัมพันธ์” ระหว่างกัน และความสัมพันธ์แต่ละจุดคือโอกาสเกิดปัญหา เช่น
- Agent A ผลิตข้อมูลที่ Agent B ต้องใช้ ถ้า B เริ่มทำงานก่อนข้อมูลพร้อม ก็เกิด stale หรือ race
- Agent C ต้องรอทั้ง A และ B ทำให้มี dependency graph ที่เริ่มซับซ้อนขึ้น
- มี shared state หรือ shared cache แล้วไม่มีการประสานการอัปเดตหรือ invalidation
- แต่ละ call คือ failure point ไม่ว่าจะเป็น LLM timeout, rate limit, network, หรือ tool error
มุมมองที่น่าจดคือความซับซ้อนจะโตแบบทวีคูณ ไม่ใช่เชิงเส้น จากมุมมองแบบ distributed systems ความเชื่อมโยง (connections) เพิ่มจำนวนความเสี่ยงอย่างรวดเร็ว และแต่ละความเชื่อมโยงกลายเป็นพื้นที่สำหรับ race condition, state synchronization bug และ cascading failure
เรื่องจริงที่เห็น pattern ชัด: เครดิตดีไซชันที่เสี่ยงผิดเพี้ยน
ตัวอย่างที่สะท้อนที่สุดคือระบบ credit decisioning ในอุตสาหกรรมการเงิน ซึ่งเริ่มจากเอเจนต์เดียวสำหรับคำนวณเครดิตสกอร์ ทุกอย่างเดโม่ผ่านและขึ้นโปรดักชันอย่างราบรื่นเพียงสองสัปดาห์
จากนั้นธุรกิจต้องการเพิ่มอีกสี่เอเจนต์: income verification, risk assessment, fraud detection, และ final approval จัดวางเป็นชุด multi-agent แล้วปล่อยพร้อมกัน
ผลคือในสามวันเริ่มเห็นความผิดปกติ อนุมัติที่ควรถูก flag กลับถูกอนุมัติ และมีประมาณ 20% ของ decision ที่ risk rating ไม่ถูกต้อง
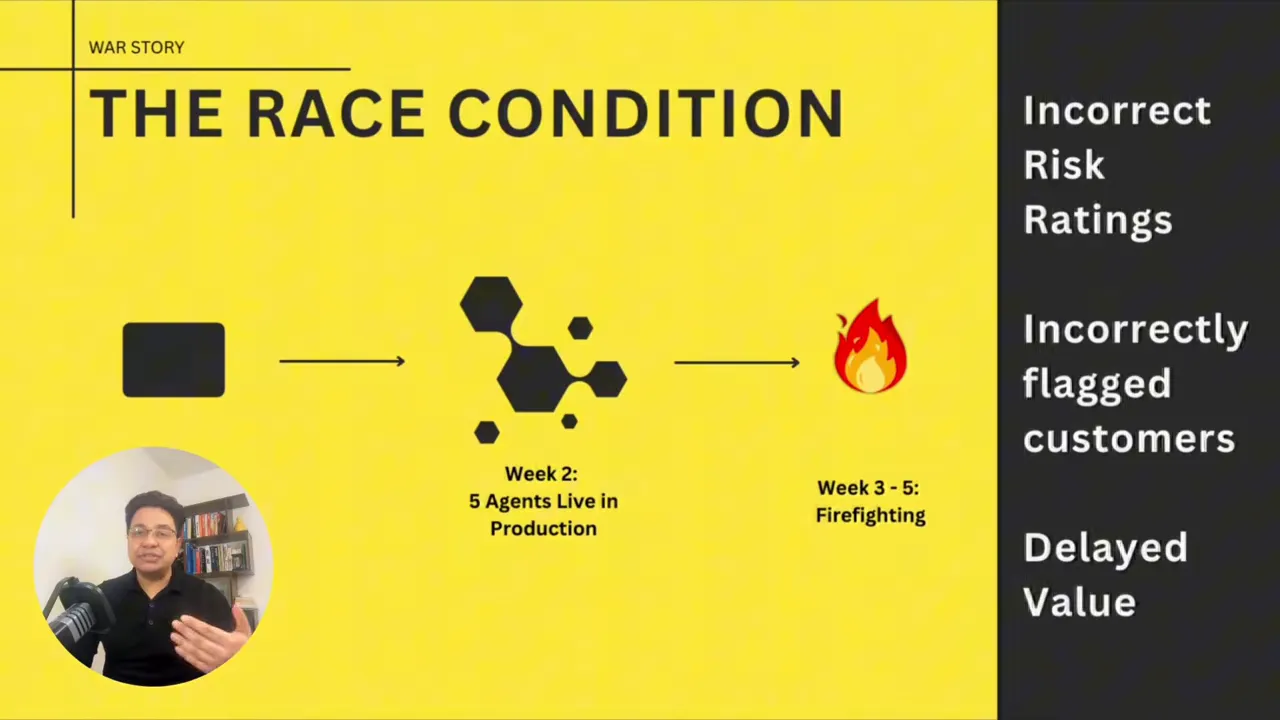
ทีมใช้เวลาสองวันกว่าจะหาต้นเหตุได้ ข้อค้นพบคือ credit score agent คำนวณและเขียนลงฐานข้อมูล แต่ risk assessment agent อ่านค่าในเวลาเพียง 500 มิลลิวินาทีถัดมาแล้วได้ค่าคะแนนที่ต่างกันสำหรับลูกค้าคนเดียวกัน
คำตอบไม่ได้อยู่ที่ความผิดพลาดในฐานข้อมูลโดยตรง แต่เป็น คาเช่ (caching layer) ที่อยู่คั่นระหว่างเอเจนต์กับ Postgres ค่า “ขวา” ในฐานข้อมูลถูกเขียนสำเร็จ แต่แคชไม่ถูก invalidated ทำให้ risk agent อ่านข้อมูลเก่าจนทำ decision จาก stale data
นี่คือบทเรียนที่เจ็บแต่จำเป็น: ปัญหาไม่ได้เป็น “AI problem” หรือ “prompting problem” เป็น distributed systems problem โดยเฉพาะเมื่อมี shared cache และไม่มี coordination logic สำหรับ invalidation
สิ่งที่ทำให้โปรเจกต์สะดุดไม่ใช่ความสามารถของโมเดล แต่คือการออกแบบสถาปัตยกรรมที่ไม่รองรับความไม่แน่นอนของการทำงานแบบพร้อมกัน (concurrency) และความล่าช้า (latency) ระหว่างส่วนประกอบต่างๆ
ทำไม complexity โตเร็ว: จาก “เอเจนต์” กลายเป็น “ระบบประสานงาน”
เมื่อเพิ่มเอเจนต์จากหนึ่งเป็นหลายตัว ความคิดแบบ “เพิ่มอีกสักตัว” ไม่พอ เพราะสิ่งที่เพิ่มคือจำนวนความสัมพันธ์และจุดล้มเหลวที่ต้องประสานกัน
หนึ่งเอเจนต์มี coordination เป็นศูนย์ สองเอเจนต์เริ่มมีอย่างน้อยหนึ่งความเชื่อมโยง ห้าเอเจนต์สร้างความเชื่อมโยงได้อย่างน้อยหลายสิบเส้น และแต่ละเส้นสัมพันธ์มีโอกาสกลายเป็นปัญหา เช่น race condition หรือ state synchronization bug
ดังนั้นการพยายามแก้ด้วยการเพิ่มจำนวน agent ไม่ต่างจากการเพิ่มฟีเจอร์บนเครื่องที่ยังไม่มีกลไกควบคุมการทำงานร่วมกัน
สองทางเลือกหลัก: Choreography หรือ Orchestration
จุดเริ่มที่สำคัญที่สุดในการออกแบบ multi-agent workflow คือ เลือกรูปแบบการประสานงาน ซึ่งมีสองแนวหลักที่เทียบเคียงได้กับ distributed coordination:
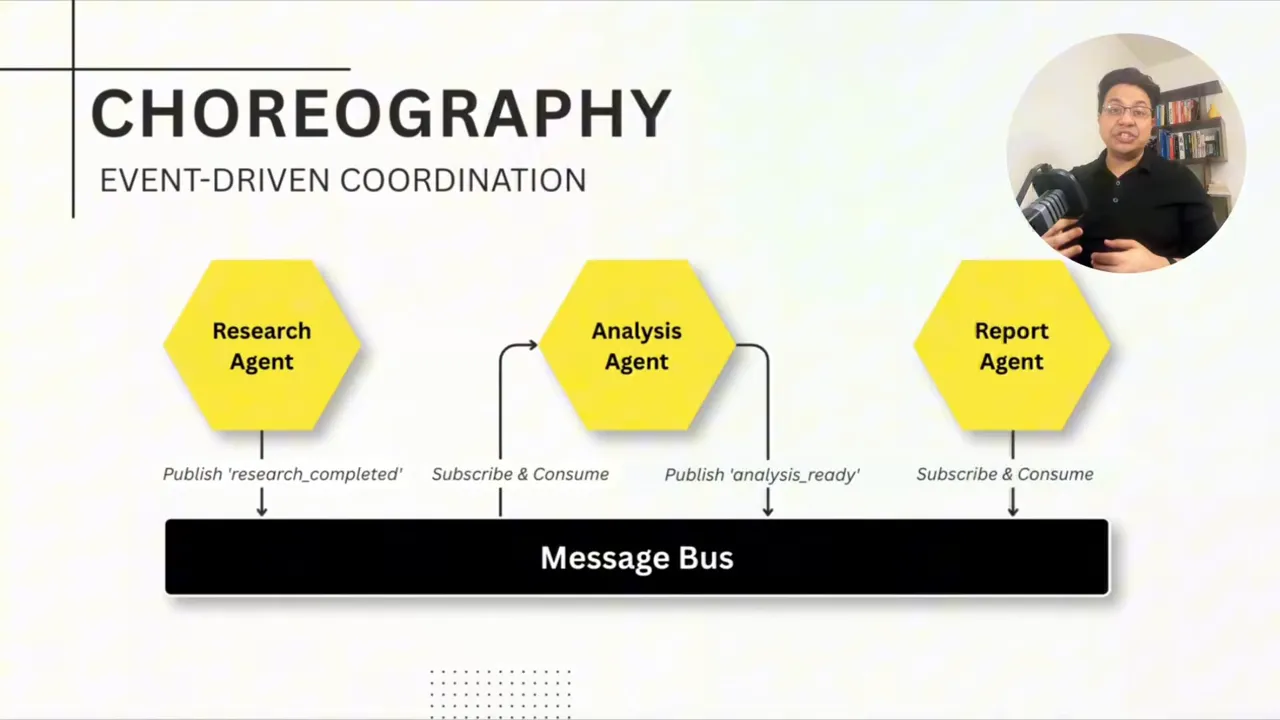
1) Choreography: เอเจนต์ประสานกันผ่านเหตุการณ์ (event-driven)
แนวคิดคือเอเจนต์แต่ละตัวทำงานแบบอิสระและสื่อสารผ่านเหตุการณ์ (events) เช่น research agent เสร็จแล้ว publish “research completed” ไปที่ message bus จากนั้น analysis agent subscribe เฉพาะ event ที่สนใจ ทำ analysis แล้ว publish “analysis ready” แล้ว report agent ก็ทำงานต่อ
ข้อดีคือความหลวมตัว (loose coupling) เพิ่มเอเจนต์ได้ง่าย เพราะแต่ละตัวเพียงแค่ subscribe event ที่ต้องใช้ ไม่ต้องไปแก้ central coordinator
แต่ฝั่ง nightmare ของ choreography คือ การดีบัก เมื่อเกิดความล้มเหลว เราไม่รู้ทันทีว่า agent ไหน “ไม่ publish”, event ถูก consumed หรือ consumed ซ้ำ, หรือการไหลของ event ขาดช่วงตรงไหน
ดังนั้น choreography ใช้ได้ดีเมื่อ workflow เป็นธรรมชาติแบบ event-driven, ต้องการ autonomy สูง, และทีมพร้อมลงทุนกับ observability ที่แข็งแรง เช่น tracing และการรับประกัน delivery
2) Orchestration: มีตัวกลางคุม workflow แบบ DAG
orchestration คือมี orchestrator ที่เป็นศูนย์กลาง เรียกเอเจนต์ตามลำดับหรือแบบขนาน รวบรวมผล แล้วคุม state และ retry ทั้งหมดไว้ที่จุดเดียว
ในโมเดลที่ชัดเจน: orchestrator เรียก agent A ก่อน แล้วรอผล จากนั้นอาจเรียก agent B และ C แบบขนาน แล้วนำผลรวมไปเรียก agent D อีกครั้ง เอเจนต์ไม่เรียกกันเอง หน้าที่ฉลาดอยู่ที่ orchestrator
ข้อดีคือ orchestrator เป็นแหล่ง truth เพียงแหล่งเดียว ทำให้ debugging ง่าย มี dashboard ภาพรวม และรองรับ rollback/compensation ได้ดี
เหตุผลที่มักจำเป็นในอุตสาหกรรมที่ “ต้องอธิบายได้” เช่น financial services คือเมื่อเกิดข้อผิดพลาดใน credit decision เราต้องรู้แน่ชัดว่า agent ตัวไหนทำการตัดสินใจในลำดับใด และใช้ข้อมูลอะไร ณ ตอนนั้น
กรอบตัดสินใจ: เลือกให้ตรงกับความซับซ้อนและระดับความเป็นอิสระ
แนวคิดที่ช่วยตัดสินใจคือดูสองแกน:
- ความซับซ้อนของ workflow ตั้งแต่ simple ถึง complex
- ข้อกำหนดด้าน autonomy ตั้งแต่ต่ำถึงสูง
หาก workflow ซับซ้อนต่ำและต้องการ autonomy สูง choreography จะเหมาะ
หาก workflow ซับซ้อนสูงแต่ autonomy ไม่ต้องมาก orchestration จะคุมเกมได้กว่า
และกรณีน่าสนใจคือ top-right: workflow ซับซ้อนสูงและต้องการ autonomy สูงด้วย ตรงนี้มักต้องใช้ hybrid pattern เช่น choreography พร้อม saga-style compensation สำหรับการชดเชยเมื่อเกิดความล้มเหลว
ประเด็นคือการเลือกไม่ควรเกิดจากความรู้สึก “agent ดูฉลาดกว่า” แต่ควรเกิดจากการออกแบบระบบให้ทนต่อความผิดพลาดและตรวจสอบได้
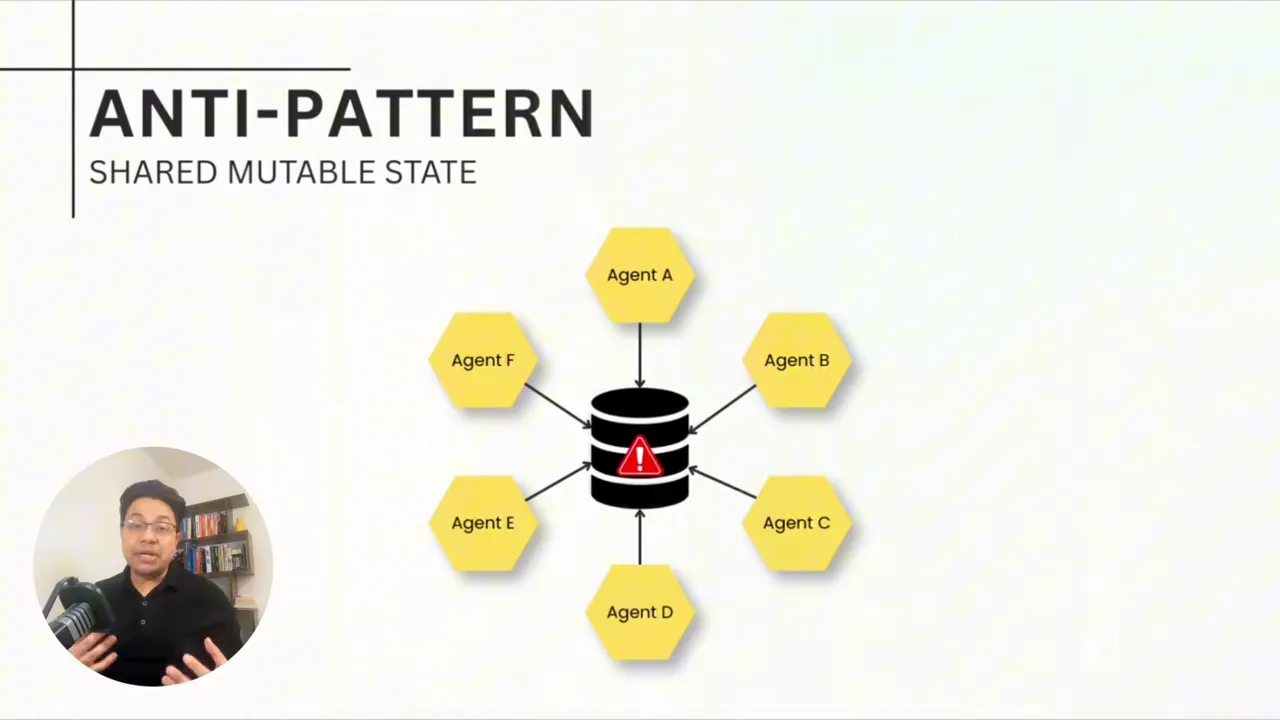
State คือจุดที่พังง่ายที่สุด: ทำไม shared mutable state ถึงชวนให้เกิด race
คำตอบที่ชัดคือ “อย่าให้หลายเอเจนต์แก้ค่าเดียวกันพร้อมกัน”
รูปแบบที่มักเริ่มต้นคือ shared mutable state: agent A อ่าน credit score แล้วคำนวณและเขียนกลับ Agent B ทำเช่นเดียวกันพร้อมกัน เมื่อเขียนพร้อมกัน “last write wins” อัปเดตของ agent ตัวแรกหายไป กลายเป็น lost update
แม้ฐานข้อมูลสมัยใหม่มี isolation level และ row locking แต่หลายทีมใช้ default จนไม่ป้องกัน race อย่างที่คิด พอจำนวน agent เพิ่ม ความน่าจะเป็นของการเกิดปัญหาจะสูงขึ้นเรื่อยๆ และอาการจะกลายเป็น delayed value ต่อธุรกิจ
แนวทางที่ใช้งานได้จริง: Immutable state snapshots พร้อม versioning
สิ่งที่ทำให้ระบบนิ่งคือเปลี่ยนจาก “แก้ไขค่าเดิม” เป็น “สร้างค่าใหม่”
แนวทางที่แนะนำคือ immutable state snapshots กับ versioning แบบ append-only:
- agent A สร้าง state version 1 แล้ว “seal” หรือทำให้แก้ไขไม่ได้ จากนั้นส่ง version 1 เป็นอินพุตให้ agent B
- agent B ตรวจ schema ตาม data contract แล้วประมวลผล สร้าง state version 2 แบบใหม่ โดยบันทึกเป็น append (ไม่อัปเดต version 1)
- แต่ละ handoff ทำ schema validation และ version tracking
- เมื่อมีความผิดพลาดที่ปลายน้ำ เราไล่ตรวจย้อนผ่าน lineage ของ state versions ได้ทันที
ข้อดีคือ eliminates race condition จากมุม shared record เพราะแต่ละ agent ไม่แก้ record เดิม แต่เพิ่มเวอร์ชันใหม่แทน และช่วยกัน stale reads เพราะ input ที่ส่งไปถูกทำให้ immutable
มุมมองเชิงปฏิบัติที่น่าสนใจคือ “state history” กลายเป็นเครื่องมือดีบัก: หาก version 7 สร้างผลลัพธ์ผิด เราสามารถย้อนดู version 6, 5, ไปเรื่อยๆ และใช้วิธีคล้ายการ binary search เพื่อหาจุดที่คุณภาพเริ่มตก
State ยังไม่พอ: Data contracts คือด่านกันขยะ
ต่อให้ state ถูก versioned ถ้าเอเจนต์ส่งข้อมูลแบบไม่ถูกสัญญา (contract) ระบบก็ยังพัง แต่จะพังไกลออกไปจากจุดที่ผิด ทำให้ดีบักยาก
แนวคิดคือให้แต่ละ agent มี input-output schema ที่ชัดเจน และมีการตรวจที่ boundary ของการ handoff
ตัวอย่างที่เล่าในภาพรวมคือ research agent ต้องส่ง findings, confidence score, sources, timestamp เป็นต้น ส่วน analysis agent ประกาศว่าต้องการ research output “ประเภท X” ตาม contract และมีเงื่อนไขคุณภาพ เช่น confidence ต้องไม่ต่ำกว่า 0.7 หากต่ำกว่าจะ reject handoff
ผลลัพธ์คือเราจับปัญหาได้ตั้งแต่ช่วงส่งต่อ ไม่ต้องรอจนถึงขั้น report ที่คุณภาพตกจริงๆ แล้วเริ่มโทษไปไกล
ในบริบทการทำงานกับแพลตฟอร์มอย่าง Databricks มีวิธีหนึ่งที่กล่าวถึงคือ register schema ไว้ใน Unity Catalog เพื่อให้ contract ถูก versioned และ governed ในที่เดียว
Failure เป็นของจริง: ออกแบบให้ “ออกจากวงจรพัง”
ใน multi-agent workflow failure ไม่ใช่ “ถ้ามี” แต่เป็น “เมื่อไหร่”
สาเหตุอาจมาจาก LLM time out, API rate limit, ตัว agent ล้มกลางคัน หรือเครื่องมือภายนอกตอบช้า/ผิดพลาด แล้วคำถามคือ “ระบบจะทำอย่างไรต่อ?”
สองแพทเทิร์นที่เน้นในงานนี้คือ circuit breaker และ compensation (Saga pattern)
1) Circuit breaker: Fail fast เพื่อกัน cascading failures
circuit breaker มาจาก distributed systems ตรงๆ
เมื่อ agent A เรียก agent B จะห่อ call ด้วย circuit breaker หาก agent B ล้มเหลวซ้ำหลายครั้ง (เช่นห้าครั้งติด) circuit จะ “open” จากนั้นระบบจะ fail fast ไม่รอ timeout ทุกครั้ง และจะลองใหม่ในภายหลัง
หลังระยะ timeout วงจรจะ “half open” โดยทดสอบ agent B ด้วย request เดียว หากสำเร็จก็ “close” กลับสู่โหมดปกติ แต่ถ้าล้มเหลวก็ “open” ใหม่
แนวคิดสำคัญคือป้องกันไม่ให้หนึ่งเอเจนต์ที่เริ่ม flaking ทำให้ workflow ทั้งหมดพัง และระบบสามารถ degrade ได้อย่างสง่างาม เช่น
- ข้าม agent บางตัวเพื่อทำงานต่อแบบ reduced functionality
- ใช้ cached results ชั่วคราว
- ส่งสัญญาณให้คนตรวจ แต่ไม่หยุดทั้งระบบ
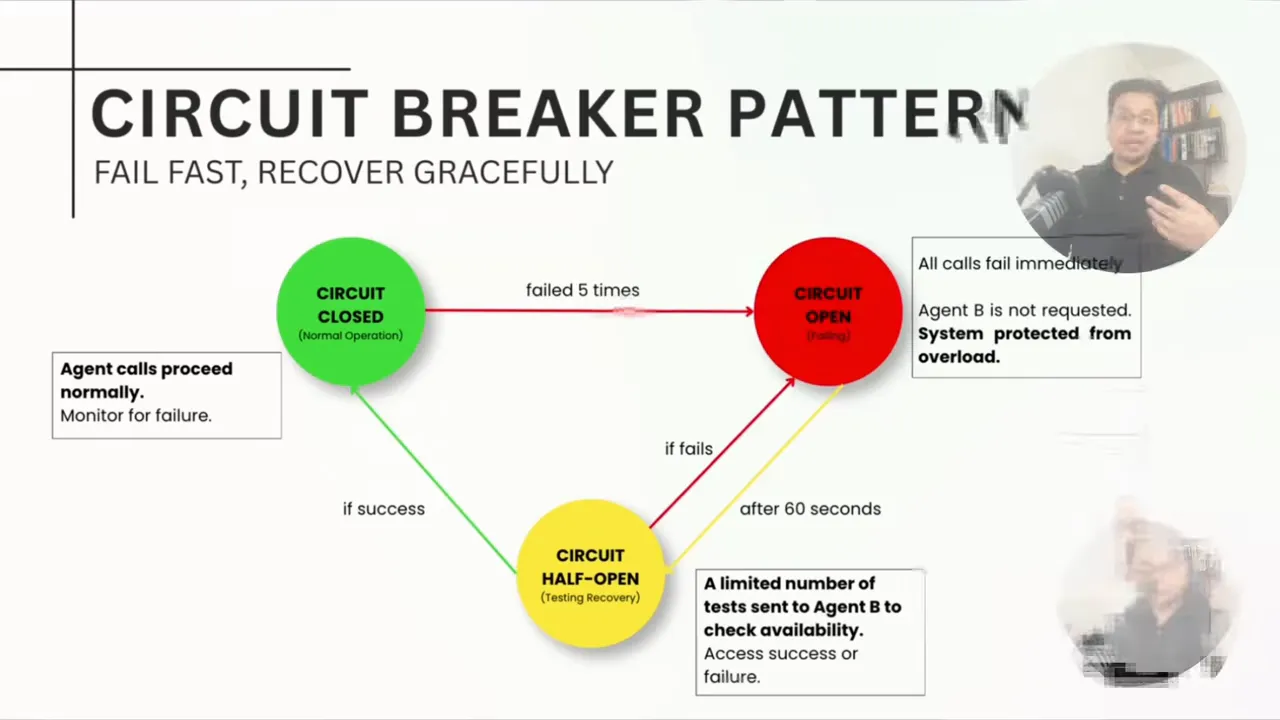
และหลักการที่เน้นคือ circuit breaker ควรถูกใช้ “ทุกครั้ง” ที่เรียก agent ไม่ใช่ทำเฉพาะ call ที่คิดว่าคงไม่พัง
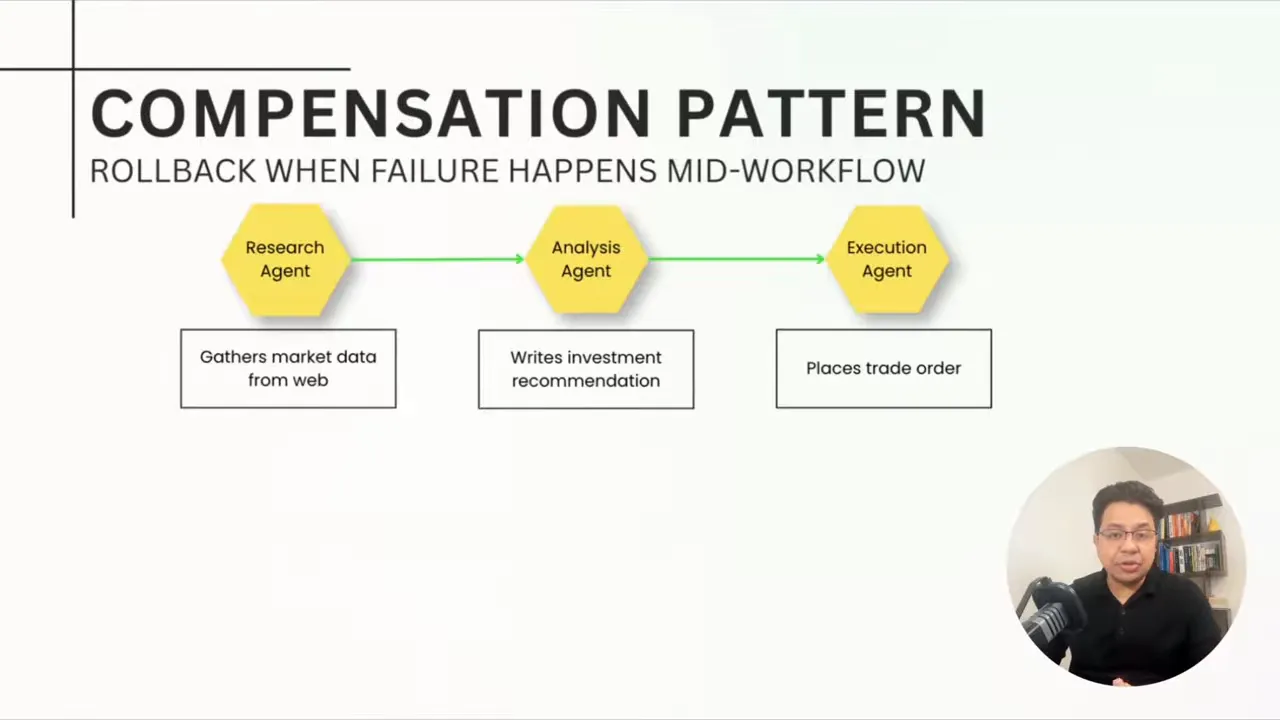
2) Compensation (Saga pattern): Undo แบบเป็นขั้นตอน ไม่ใช่หวังให้ rollback ได้ทันที
เมื่อ orchestrated workflow ทำหลายขั้นตอน ข้อเท็จจริงคือแบบ distributed transactions ไม่ได้ rollback ทุกอย่างพร้อมกันเหมือน database transaction ในเครื่องเดียว
ดังนั้นใช้ compensation หรือ Saga pattern ที่ออกแบบให้งานแต่ละขั้นย้อนกลับได้
รูปแบบที่อธิบายคือให้แต่ละ agent มีสองวิธี:
- execute ทำงาน
- compensate undo หรือชดเชยเพื่อกลับสู่ state ก่อนหน้า
orchestrator เก็บรายการของ agent ที่ execute สำเร็จแล้ว หากขั้นถัดไปล้มเหลว orchestrator จะเดินย้อนกลับจาก agent ล่าสุดไปก่อนหน้า และเรียก compensate ตามลำดับ เพื่อให้กลับสู่ initial state
เช่น analysis agent อาจต้องลบ draft recommendations ที่เคยเขียนไว้ และ research agent อาจต้องล้าง cached research data ที่เก็บไว้
แม้จะดูไม่ “เท่” แต่เป็นวิธีที่ระบบ production ใช้จริงเพื่อจัดการ partial failures แบบมีความรับผิดชอบ
สถาปัตยกรรม production ที่รวมทุกแพทเทิร์นเข้าด้วยกัน
เมื่อวางทุกชิ้นเข้าด้วยกัน เราจะได้ภาพสถาปัตยกรรมที่มี orchestrator เป็นหัวใจ
- Orchestrator เป็น workflow engine, เก็บ state versions จาก 0 ถึง N, และส่ง/รับ observability data
- Agents รับ input แล้วทำงาน ส่ง output และ state version กลับมา แต่ไม่เรียกกันเอง
- State store เก็บ immutable snapshots แบบ append-only (ตัวอย่างแนวคิดคือ state versions เป็นแถวใน delta table)
- Serving layer ใช้ policy เช่น retries, timeouts, rate limits พร้อม circuit breakers
- Data governance รวม access control, lineage, audit trail (ในตัวอย่างพูดถึง Unity Catalog)
- Tracing และ metrics ผ่านเครื่องมือเช่น MLflow traces: เวลาแฝง, input/output, token usage
จุดเด่นคือควบคุมได้, observability ชัด, และ rollback/compensation ทำได้จริง เพราะ orchestrator เป็น single source of truth
อีกมุมที่น่าสนใจคือการยืนยันว่าโครงสร้างนี้ทำงานได้ใน scale สูง เช่น “รันวันต่อวัน” สำหรับ workflow ที่สร้างผลลัพธ์บนจำนวน transaction ขนาดใหญ่ ซึ่งสะท้อนว่าไม่ได้เป็นแค่ blueprint แต่เป็น pattern ที่ถูกนำไปใช้ในงานจริง
ตัวอย่างการนำไปใช้บน Databricks stack (เชิงแนวคิด)
แนวทางที่ยกตัวอย่างเชิงแพลตฟอร์มคือ:
- ชั้น orchestration ใช้ Langraph ร่วมกับ Mosaic AI agent framework เพื่อจัดการ workflow graph
- แต่ละ agent ถูกทำให้เป็น Unity Catalog function (เขียนด้วย SQL หรือ Python) หรือเป็นโมเดลที่ลงทะเบียนใน Unity Catalog
- การ expose เอเจนต์ผ่าน Databricks model serving หรือ function serving และที่ serving layer จะ enforce circuit breaker style policies เช่น retries/timeout/rate limit ผ่าน AI gateway
- ชั้น data ใช้ Delta Lake เก็บ state snapshots และข้อมูลที่ workflow ต้องใช้
- state snapshots เป็น immutable และ versioned โดยไม่ update in place
- MLflow traces ผูกทุก run เข้ากับ state version เพื่อ replay และ step-through lineage ได้
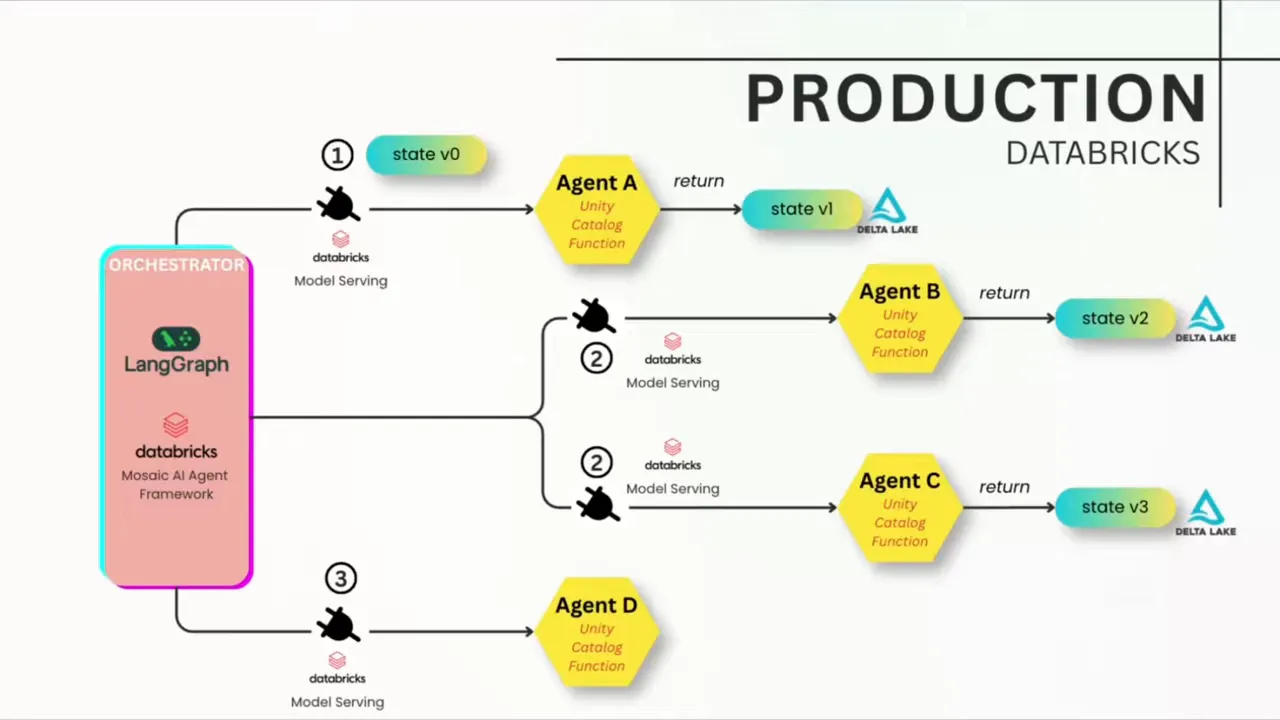
แก่นแท้ของแนวคิดนี้คือ “ทำให้ระบบตรวจสอบได้และควบคุมได้” ด้วย governance และ tracing ในระดับที่องค์กรใช้งาน production จริง
สิ่งที่ควรยึด: ความเป็นจริงของ agent chaos และสิ่งที่ทำให้ระบบไม่ล้ม
ข้อสรุปที่ชัดคือ agent chaos เป็นเรื่องหลีกเลี่ยงไม่ได้ เมื่อ scale เกินหนึ่งเอเจนต์ จะเจอ coordination problems, race conditions และ cascading failures แบบหลีกไม่พ้น
แต่ “หลีกเลี่ยงไม่ได้” ไม่เท่ากับ “ปล่อยให้พัง” วิธีที่แก้ได้คือเลือกแพทเทิร์นที่ถูกต้องและนำไปทำเป็นโครงสร้างใน production architecture ไม่ใช่ฝากความหวังไว้กับความฉลาดของโมเดล
งาน infrastructure แบบ circuit breaker, compensation, immutable state snapshots และ data contracts อาจไม่ดึงดูดเท่าการทำ prompt ให้น่าอ่าน แต่มันคือสิ่งที่ทำให้ระบบไม่ fail ตอนสองทุ่มคืนหนึ่ง และที่สำคัญคือทำให้ทีมอธิบายความผิดพลาดได้
คำศัพท์เฉพาะทางเพิ่มเติม
Choreography vs Orchestration
- Choreography: เอเจนต์สื่อสารผ่านเหตุการณ์แบบกระจาย ไม่มีตัวกลางคุม workflow
- Orchestration: orchestrator คุม workflow เป็นศูนย์กลาง เรียก agent ตาม graph และจัดการ retry/state/observability
Circuit breaker
กลไกที่ “ตัดวงจร” เมื่อบริการหนึ่งเริ่มล้มบ่อย เพื่อลดการรอ timeout ซ้ำๆ และกัน cascading failures ช่วย degrade อย่างมีการควบคุม
Compensation (Saga pattern)
แพทเทิร์นสำหรับ distributed workflows ที่ไม่ได้ rollback พร้อมกันทั้งระบบ แต่ให้แต่ละขั้นตอนออกแบบวิธีย้อนกลับ (compensate) แล้ว orchestrator เดินย้อนเพื่อกลับสู่สภาพก่อนเริ่ม
Immutable state snapshots และ versioning
การเก็บ state เป็นเวอร์ชันที่สร้างใหม่เสมอแบบ append-only เพื่อเลี่ยง shared mutable state ลด race/stale reads และเพิ่มความสามารถในการตรวจสอบ lineage
อ้างอิงแนวคิด Saga: Saga pattern (Wikipedia)
บทสรุปส่งท้ายจากทีมงาน Insiderly
- ถ้าเพิ่ม agent แล้วทีมเจอปัญหาพร้อมกันหลายมิติ จุดที่ต้องโฟกัสไม่ใช่ prompt แต่คือ coordination แบบ distributed system
- เลือก choreography หรือ orchestration ให้ตรงกับ ความซับซ้อนของ workflow และ ระดับ autonomy ที่ต้องการ
- เลี่ยง shared mutable state ด้วย immutable state snapshots + versioning เพื่อกัน race และทำให้ดีบักย้อนรอยได้
- ตั้ง data contracts ชัดเจนที่ boundary ของ handoff เพื่อจับคุณภาพผิดตั้งแต่ต้นทาง
- ออกแบบ failure เป็นส่วนหนึ่งของระบบ: ใช้ circuit breaker เพื่อ fail fast และ compensation (Saga) เพื่อกลับสู่ initial state เมื่อเกิด partial failures
- สถาปัตยกรรม production ที่ดีต้องมาพร้อม observability และ governance ไม่ใช่แค่ให้เอเจนต์ “ตอบได้”
