


คลิป What if the harness mattered more than the model? จากช่อง AI Engineer ตั้งคำถามว่า สิ่งที่ทำให้ AI ใช้งานได้จริงอาจไม่ได้อยู่ที่ตัว model เพียงอย่างเดียว แต่อยู่ที่ harness หรือโครงที่ครอบการทำงานของมันด้วย ผู้พูดคือ Aditya Bhargava จาก Etsy และบทความนี้สรุปข้อเสนอพร้อมการสาธิต coding agent ของเขา
วิดีโอเผยแพร่วันที่ 8 กรกฎาคม 2026 ตามเวลาไทย (7 กรกฎาคม 2026 เวลา 23:31:54 UTC) วันที่นี้เป็นวันเผยแพร่วิดีโอ ไม่ใช่วันที่จัดงานบรรยาย ดูวิดีโอต้นทาง
มุมนี้ชวนให้คนทำ AI workflow กลับมาดูระบบรอบ model ทั้งเครื่องมือ ขอบเขตสิทธิ์ และวิธีตรวจผลลัพธ์ ผู้พูดเสนอให้พัฒนาความสามารถด้าน harness เพื่อสำรวจทางเลือกในการใช้ model ที่รันในเครื่องได้ ข้อเสนอนี้ยังไม่ใช่หลักฐานว่า model ใดจะทดแทนกันได้ในทุกงาน
ตัวอย่างการประยุกต์กับธุรกิจไทยในบทความเป็นข้อเสนอทางบรรณาธิการสำหรับนำไปทดสอบต่อ ไม่ใช่ผลทดลองหรือคำกล่าวของผู้พูด
เข้าใจก่อนว่า harness คืออะไร และทำไมมันอาจสำคัญกว่า model
ในคลิปนี้ คำว่า agent ถูกอธิบายแบบง่ายว่าเป็นการรวมกันของ model + harness โดย model คือสมองที่สร้างคำตอบ ส่วน harness คือทุกอย่างรอบนอกที่ทำให้มันทำงานเป็นระบบ เช่น prompt, tools, กติกาความปลอดภัย, loop การตรวจงาน, การแบ่งงานเป็นส่วนย่อย และวิธีวัดผลเพื่อปรับปรุง
ผู้พูดตั้งข้อสังเกตว่า การพึ่ง model เชิงพาณิชย์ที่รันในเครื่องไม่ได้อาจทำให้เราผูกกับผู้ให้บริการไม่กี่ราย เขาจึงเสนอให้สำรวจว่า harness ที่ดีขึ้นจะช่วยให้ local model ทำงานที่ต้องการได้มากขึ้นเพียงใด ส่วนต้นทุน ความเป็นส่วนตัว และความสามารถในการย้ายระบบยังต้องประเมินตามงานจริง
การเลือกระบบรอบ model จึงเกี่ยวข้องกับข้อกำหนดของงานด้วย โดยเฉพาะงานที่มีข้อมูลลูกค้า ข้อมูลภายใน หรือ workflow ที่อยากเก็บไว้ในองค์กร
ข้อเสนอเรื่อง harness และขอบเขตของตัวอย่าง
ผู้พูดยกการเปรียบเทียบ harness ประกอบข้อเสนอว่า การออกแบบระบบรอบ model ควรได้รับความสนใจมากขึ้น บทความนี้เน้นการสาธิตที่เล่าในคลิป และไม่ได้ใช้ตัวเลขจากงานวิจัยที่อ้างถึงเป็นผลยืนยัน เพราะยังไม่ได้ตรวจงานวิจัยต้นฉบับ
ในส่วนสาธิต เขาใช้โจทย์แก้ bug เดิมและ model เดิม แล้วค่อยๆ เพิ่มความสามารถของ harness จึงช่วยให้เห็นความต่างระหว่างการขอคำตอบกับการลงมือแก้ไฟล์และตรวจผล แต่ยังไม่ใช่การเปรียบเทียบ model หลายรุ่นหรือผลทดสอบงานธุรกิจ
ตัวอย่างในงานจริงของธุรกิจไทยอาจเป็นแบบนี้
- แชตบอตตอบลูกค้าผิด อาจเกี่ยวกับฐานความรู้ที่ไม่ชัด จึงควรตรวจทั้งข้อมูลและความสามารถของ model
- AI เขียนคอนเทนต์เพี้ยน อาจเกี่ยวกับขั้นตอนตรวจโทนภาษาและข้อเท็จจริงด้วย
- AI ช่วยสรุปรายงานไม่ตรงใจ อาจเพราะเราไม่กำหนดรูปแบบผลลัพธ์และเกณฑ์การประเมิน
ถ้าคิดแบบนี้ เราจะเลิกถามว่า “ใช้ model อะไรดี” อย่างเดียว แล้วเริ่มถามว่า “ออกแบบระบบรอบ model ยังไงให้ได้งาน”
เริ่มจากระดับพื้นฐานที่สุด อย่าคาดหวังว่า model จะทำงานเองทั้งหมด
ตัวอย่างในคลิปเริ่มจากโจทย์ง่ายมาก คือให้ AI ไปแก้ bug ในฟังก์ชัน Python ที่คำนวณค่า median ของชุดตัวเลข แต่พอเริ่มจาก prompt ล้วนๆ โดยไม่มีเครื่องมืออะไร AI ทำได้แค่บอกว่าต้องขอดูโค้ดก่อน มันยังอ่านไฟล์ไม่ได้ เขียนไฟล์ไม่ได้ และทดสอบอะไรไม่ได้
ตัวอย่างนี้แยกให้เห็นว่า การตอบคำถามกับการแก้ไฟล์จริงต้องอาศัยความสามารถต่างกัน ถ้าต้องการให้ agent ลงมือทำงาน ก็ต้องเตรียมเครื่องมือและข้อมูลที่จำเป็นให้มัน
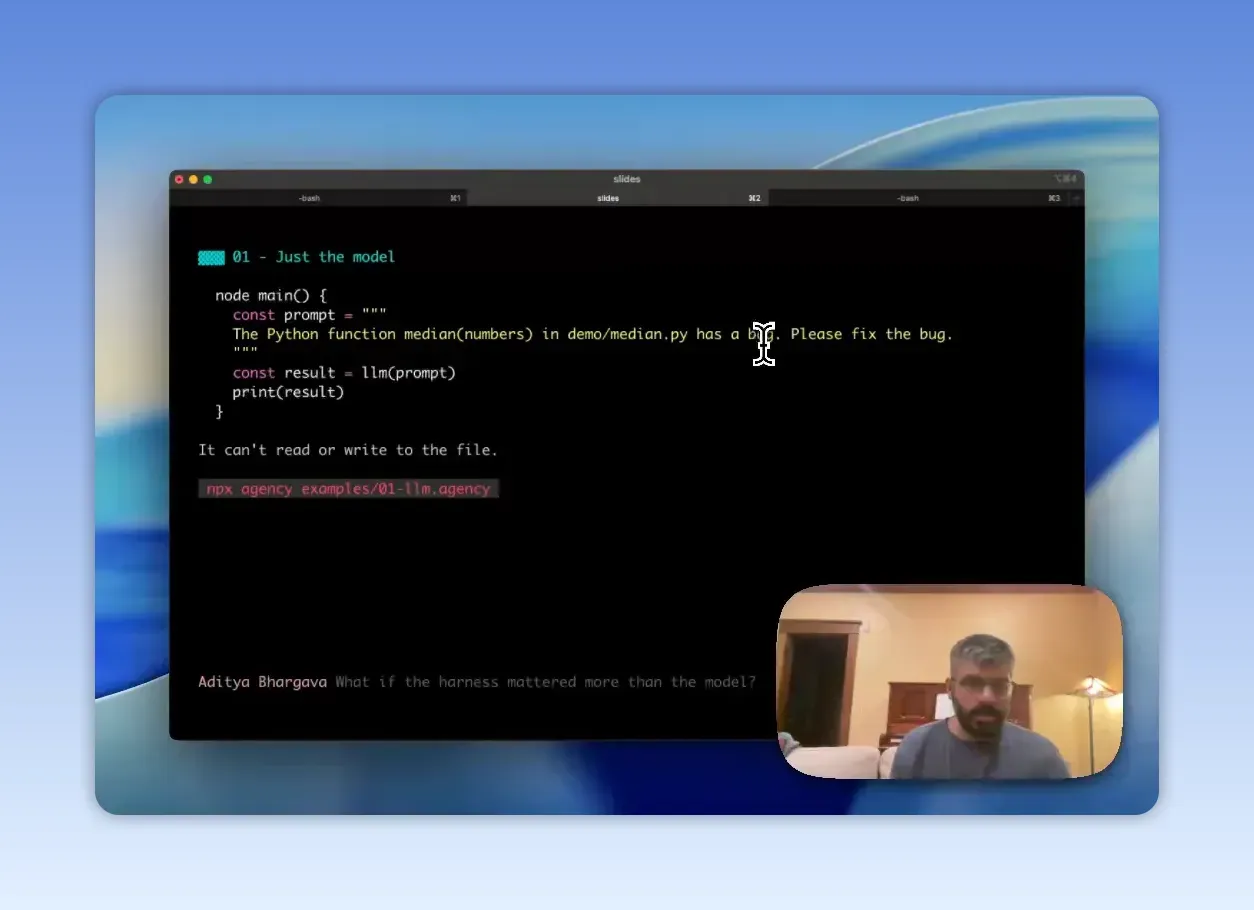
เพิ่ม tools ให้ AI ทำงานได้จริง แต่ต้องไม่เปิดสิทธิ์กว้างเกินไป
เมื่อเพิ่ม tools สำหรับอ่านและเขียนไฟล์ agent ก็มีเครื่องมือที่จำเป็นสำหรับแก้โค้ด แต่การส่งเครื่องมือให้ยังไม่เท่ากับใช้งานได้ทันที ใน demo ระบบหยุดเมื่อยังไม่มีตัวจัดการการขออนุมัติ
ผู้พูดอธิบายว่าการให้ agent อ่านหรือเขียนไฟล์ได้โดยไม่จำกัดขอบเขตมีความเสี่ยง ภาษา Agency ที่ใช้ใน demo จึงยก interrupt เพื่อขอการจัดการก่อนดำเนินการอ่านหรือเขียนไฟล์
ตัวอย่างการกำหนดสิทธิ์ในงานธุรกิจอาจเริ่มจากแบ่งข้อมูลตามขอบเขตที่ยอมให้เข้าถึง เช่น
- ข้อมูลที่เปิดได้ทั้งหมด เช่น FAQ สินค้า
- ข้อมูลที่เปิดได้บางส่วน เช่น เอกสารภายในบางหมวด
- ข้อมูลที่ห้ามแตะเด็ดขาด เช่น ข้อมูลเงินเดือน ข้อมูลบัญชี ข้อมูลลูกค้าเชิงลึก
ถ้า AI ไม่มีการคุมสิทธิ์แบบละเอียด ต่อให้ตอบเก่งแค่ไหนก็เสี่ยงเกินไปสำหรับองค์กร
ใส่ human in the loop เพื่อความปลอดภัย แต่ต้องรู้ว่ามันแลกกับความช้า
ขั้นต่อมาในคลิปคือการเพิ่มตัวจัดการที่คอยหยุดการทำงานเมื่อ AI จะทำสิ่งเสี่ยง เช่น อ่านไฟล์หรือเขียนไฟล์ แล้วขอให้มนุษย์อนุมัติก่อน
ในตัวอย่าง มนุษย์จึงได้ตัดสินใจก่อนอ่านหรือเขียนไฟล์ ผู้พูดชี้ว่าการขออนุมัติช่วยเพิ่มการควบคุม แต่ก็ทำให้การทำงานช้าลง ไม่ได้หมายความว่ามี human in the loop แล้วระบบจะปลอดภัยครบทุกด้าน
สำหรับการประยุกต์กับธุรกิจ การแบ่งงานตามความเสี่ยงอาจช่วยเลือกจุดที่ต้องตรวจได้เหมาะขึ้น ทั้งนี้ต้องกำหนดตามผลกระทบและสิทธิ์ของระบบจริง เช่น
- งานที่มีผลกระทบสูง กำหนดจุดอนุมัติก่อนดำเนินการ
- งานที่ยอมให้ดำเนินการในขอบเขตได้ เก็บ log และกำหนดวิธีตรวจผล
- งานที่ต้องการให้ทำอัตโนมัติ ระบุขอบเขตสิทธิ์และเกณฑ์ตรวจให้ชัดก่อน
ถ้าทุกอย่างต้องกดอนุมัติหมด AI จะกลายเป็นภาระมากกว่าเครื่องทุ่นแรง
จำกัดขอบเขตให้แคบลง เพื่อให้ AI ทำงานอัตโนมัติได้โดยยังคุมความเสี่ยง
แนวคิด partial function application ในคลิปคือ แทนที่จะให้ AI ระบุทุกพารามิเตอร์เอง เราล็อกบางอย่างไว้ล่วงหน้า
ในตัวอย่าง ผู้พูดล็อกพารามิเตอร์ directory ของ read และ write ไว้ที่โฟลเดอร์ demo ก่อนส่งเครื่องมือให้ model จึงเหลือเพียงพารามิเตอร์ชื่อไฟล์ให้ model เลือก เป็นวิธีจำกัดความสามารถใน demo นี้ ไม่ใช่การรับประกันว่าการล็อกพารามิเตอร์เพียงอย่างเดียวจะป้องกันความเสี่ยงทุกชนิด
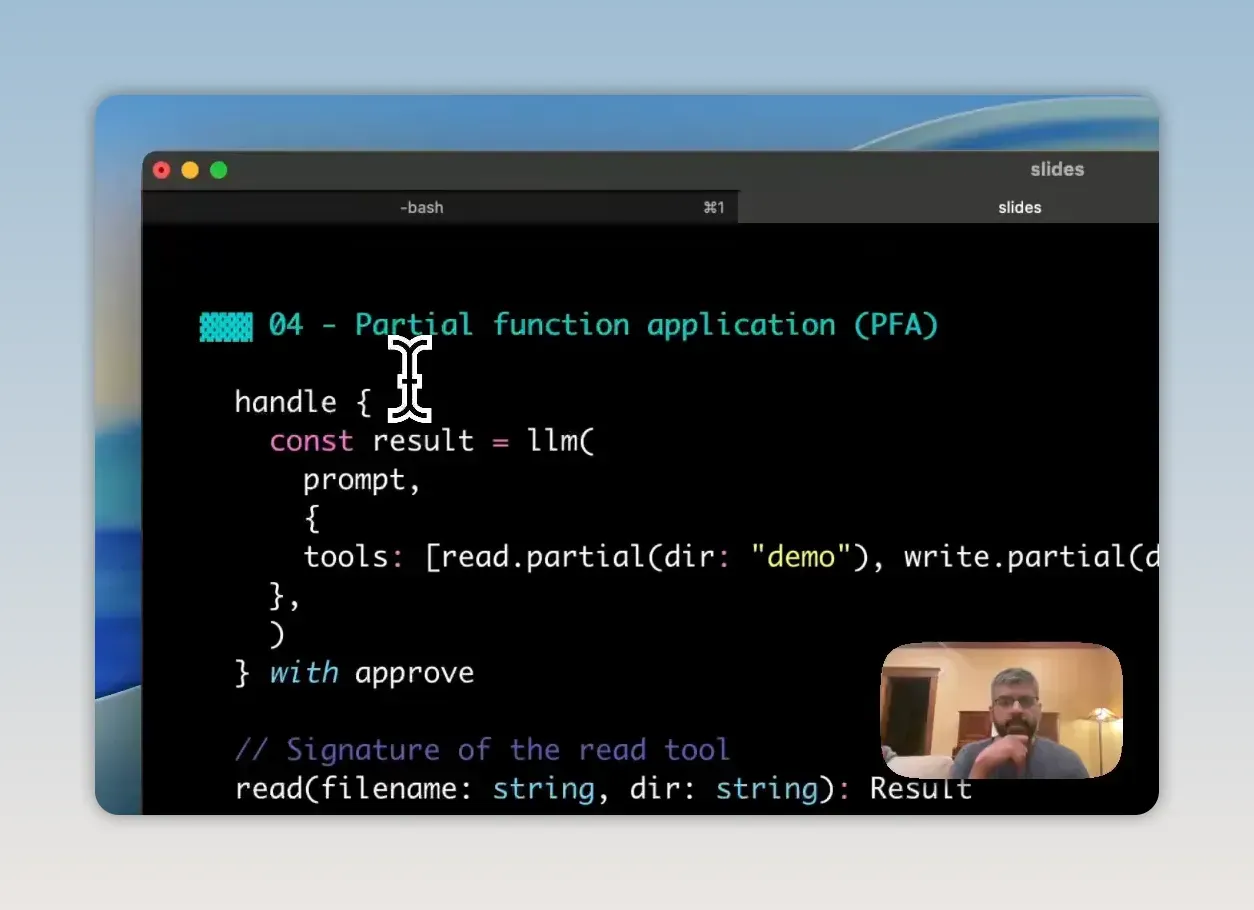
หลักการกำหนดขอบเขตก่อนส่งเครื่องมือให้ agent อาจนำมาทดสอบกับงานอื่น เช่น
- AI เขียนคำตอบลูกค้าได้ แต่ใช้ได้เฉพาะฐานความรู้หมวดบริการหลังการขาย
- AI สร้างโพสต์โซเชียลได้ แต่ดึงข้อมูลได้เฉพาะจาก product sheet ที่อนุมัติแล้ว
- AI สรุปรายงานประชุมได้ แต่บันทึกผลลัพธ์ได้เฉพาะในโฟลเดอร์โปรเจกต์ที่กำหนด
สรุปคืออย่าถามว่า “ให้ AI ทำได้ไหม” แต่ให้ถามว่า ทำได้แค่ไหน ภายในขอบเขตอะไร
สร้าง feedback loop ให้ AI ตรวจงานตัวเองก่อนส่งต่อ
ถึงจุดนี้ AI อ่านไฟล์ได้ เขียนไฟล์ได้ และอยู่ในกรอบที่ปลอดภัยขึ้นแล้ว แต่ยังมีปัญหาอยู่ มันอาจเสนอวิธีแก้ที่ถูกต้องโดยหลักการ แต่ยังไม่ได้ลงมือแก้ไฟล์จริง หรือยังไม่ยืนยันว่าผลลัพธ์ใช้ได้
คลิปจึงเพิ่มแนวคิดสำคัญมาก คือ feedback loop หรือวงจรคิด ทำ ดูผล แล้วคิดใหม่ คล้าย pattern ที่หลายคนรู้จักในชื่อ ReAct ซึ่งย่อมาจาก Reason and Act
ลูปนี้ในตัวอย่างทำงานประมาณนี้
- อ่านโค้ดและไฟล์ทดสอบ
- รันทดสอบเพื่อดูว่า error คืออะไร
- แก้ไขโค้ด
- รันทดสอบซ้ำ
- ถ้ายังไม่ผ่าน ให้อ่าน error แล้วแก้อีก
- หยุดเมื่อผลผ่าน
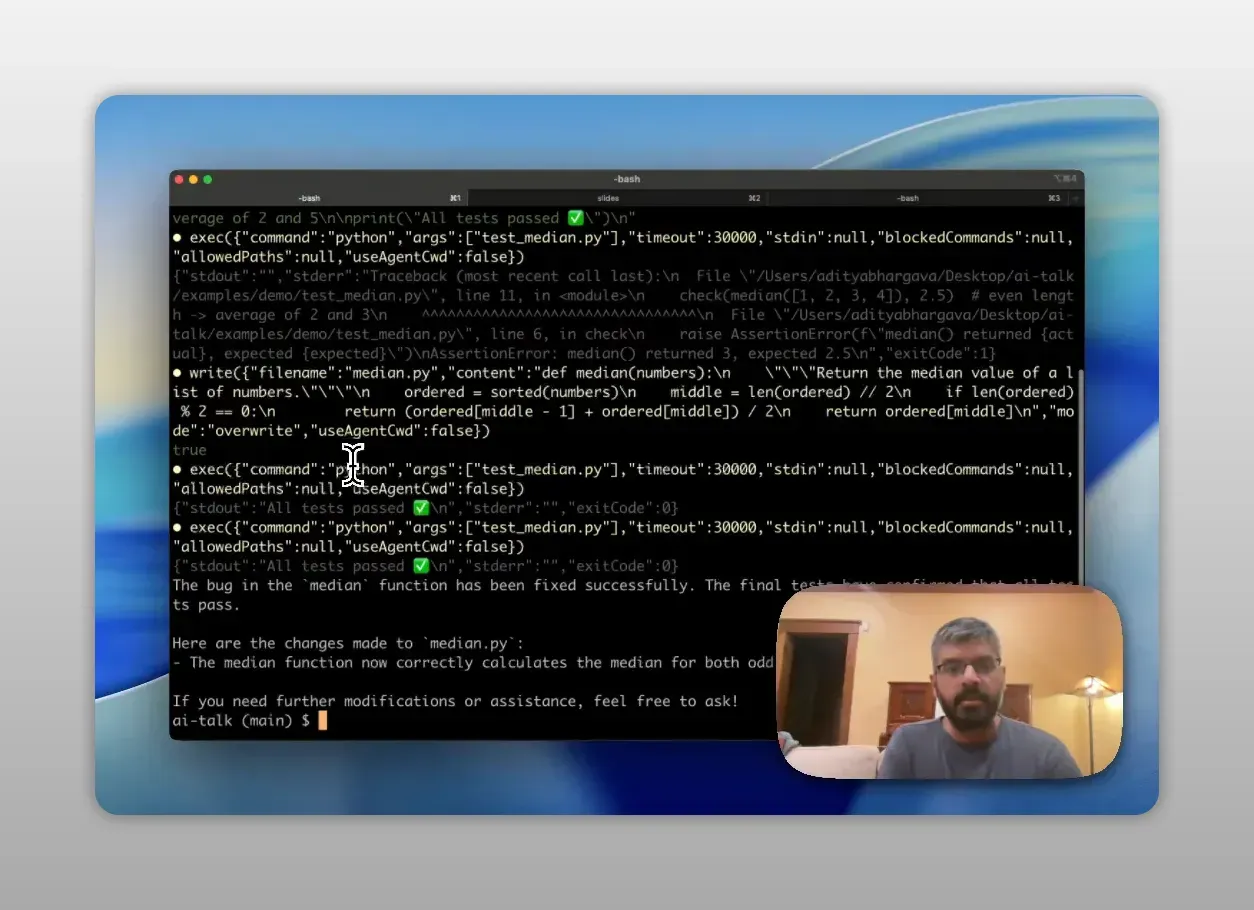
ใน demo ผู้พูดแสดงว่า agent อ่านไฟล์ รัน test พบข้อผิดพลาด แก้ไฟล์ แล้วรัน test ซ้ำจนผ่าน การผ่าน test นี้เป็นผลของโจทย์ตัวอย่าง ไม่ได้ยืนยันว่าโค้ดถูกต้องในทุกกรณี
ตัวอย่างการประยุกต์กับงานธุรกิจที่อาจนำไปทดสอบต่อ เช่น
- AI เขียนอีเมลขาย แล้วให้เช็กว่ามีชื่อสินค้า ราคา และ call to action ครบหรือไม่
- AI สรุปใบเสนอราคา แล้วให้เทียบกับข้อมูลต้นทางก่อนส่ง
- AI สร้างโพสต์คอนเทนต์ แล้วให้ตรวจว่าตรง brand voice และไม่มีคำต้องห้าม
ถ้าไม่มี loop ตรวจงาน AI จะสร้างงานได้เร็ว แต่ความผิดพลาดจะไหลต่อเร็วเหมือนกัน
ใช้ sub-agents เพื่อเพิ่มความสามารถ โดยไม่ทำให้ context เละ
อีกช่วงที่น่าเอาไปต่อยอดคือการใช้ sub-agents แทนการยัดทุก tool และทุกงานไว้ใน agent ตัวเดียว
ตัวอย่างในคลิปให้ agent หลักทำ 2 งานพร้อมกัน คือแก้ bug ในโค้ด และไปค้นข้อมูลเรื่อง Jensen's inequality สำหรับ median จาก Wikipedia แล้วอธิบายออกมาเป็นกลอนสั้น จากนั้นจึงแบ่งงานให้ sub-agent คนละตัวรับผิดชอบ
ผู้พูดเสนอว่า การแยก sub-agents ช่วยเพิ่มความสามารถโดยลดการปะปนของ context และเครื่องมือที่ไม่เกี่ยวข้องกัน
ถ้าแปลเป็นภาพธุรกิจ เราอาจออกแบบแบบนี้
- agent หลัก รับโจทย์จากทีมงาน
- sub-agent ด้านข้อมูลสินค้า ดึงรายละเอียดสินค้า
- sub-agent ด้านการตลาด เขียนข้อความตามโทนแบรนด์
- sub-agent ด้านตรวจคุณภาพ เช็กข้อผิดพลาดก่อนส่งออก
รูปแบบนี้ทำให้กำหนดหน้าที่และเครื่องมือของแต่ละส่วนได้ชัดขึ้น ส่วนคุณภาพเมื่อเทียบกับ agent เดียวยังต้องวัดด้วยงานและเกณฑ์เดียวกัน
เลิกเดา prompt ไปเรื่อยๆ แล้ววัดผลเพื่อ optimize แบบเป็นระบบ
ช่วงท้ายคลิปพูดถึง self-optimization โดยกำหนดตัวแปรและเป้าหมายให้ระบบปรับ prompt แล้ววัดผล
แนวคิดที่นำเสนอคือ ให้กำหนดตัวแปรที่อยาก optimize เช่น system prompt หรือคำสั่งหลัก แล้วให้ระบบวัดผลตาม objective ที่ชัดเจน เช่น “แก้ bug ให้สำเร็จด้วย TDD” ผู้พูดไม่ได้แสดงการรัน optimizer สดจนจบ แต่เปิดผลจากการรันก่อนหน้าให้ดู จึงควรแยกสิ่งที่สาธิตจากผลที่เขารายงาน
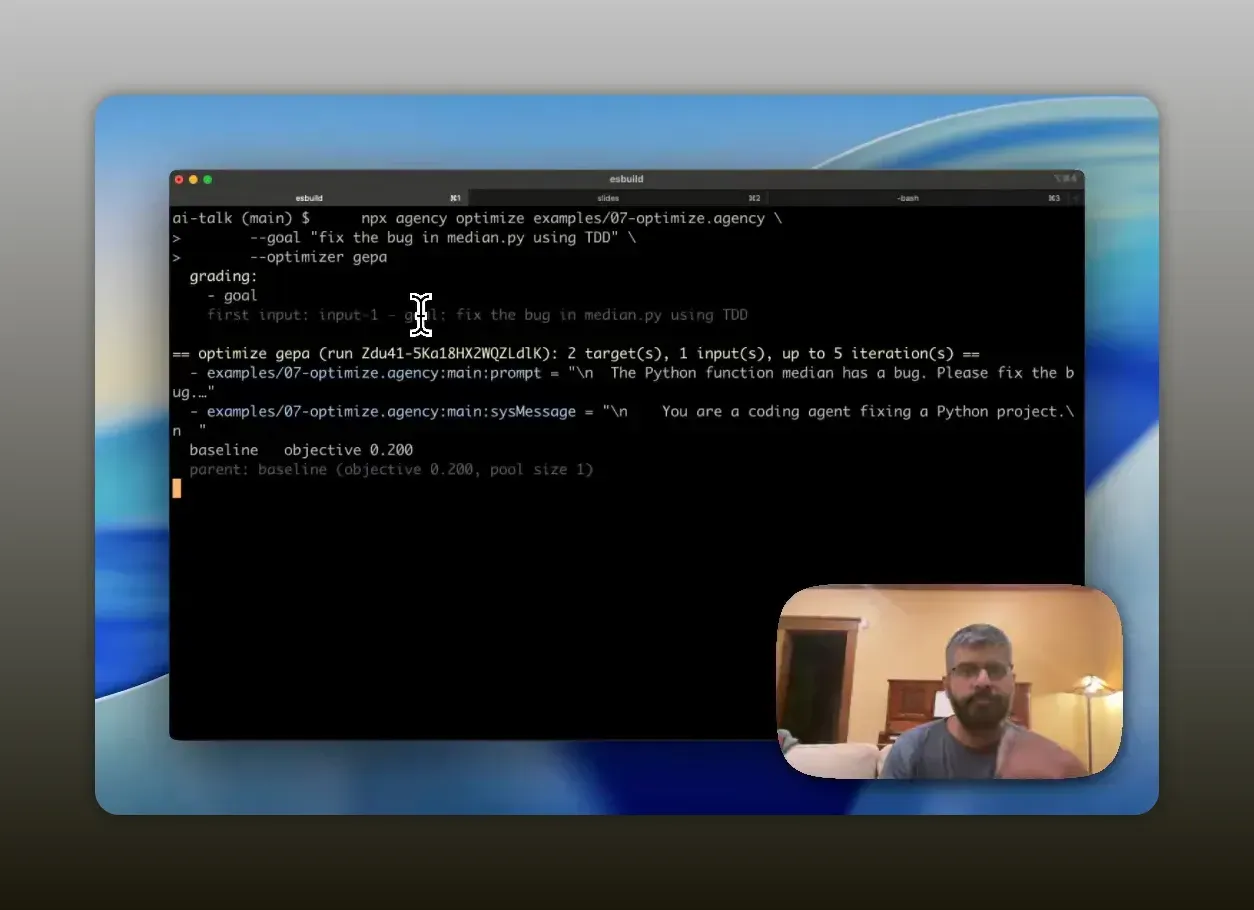
มุมนี้สำคัญกับธุรกิจมาก เพราะ KPI ของ AI ไม่ควรเป็นแค่ว่า “ดูโอเค” แต่ควรตอบได้ว่า
- ตอบลูกค้าถูกกี่เปอร์เซ็นต์
- ลดเวลาทีมงานได้กี่นาทีต่อเคส
- เขียน draft แล้วต้องแก้ซ้ำกี่รอบ
- สรุปข้อมูลผิดกี่ครั้งต่อสัปดาห์
เมื่อวัดผลได้ เราจะรู้ว่าควรปรับ prompt, tool, workflow หรือสิทธิ์การเข้าถึงตรงไหน แทนที่จะโทษ model อย่างเดียว
มองให้ออกว่าแนวคิดนี้แปลเป็น AI สำหรับธุรกิจไทยได้อย่างไร
ถ้าสรุปคลิปนี้ในภาษาธุรกิจ สิ่งที่สำคัญไม่ใช่การไล่ซื้อ AI ที่แพงขึ้นเรื่อยๆ แต่คือการออกแบบระบบรอบมันให้ตอบโจทย์งานจริง
ตัวอย่างการประยุกต์ทางบรรณาธิการที่อาจนำไปทดสอบต่อมี 4 กลุ่มงาน
- งานบริการลูกค้า ใช้ harness คุมแหล่งข้อมูล คุมโทนคำตอบ และบังคับตรวจเงื่อนไขก่อนตอบ
- งานการตลาด แยก sub-agent สำหรับ research, writing, fact check และ brand review
- งานปฏิบัติการ ให้ AI สรุปรายงาน จัดหมวดเอกสาร หรือเตรียม draft งาน โดยจำกัดสิทธิ์เข้าถึงเฉพาะโฟลเดอร์ที่เกี่ยวข้อง
- งานภายในองค์กร ประเมินว่า local model เหมาะกับข้อกำหนดด้านข้อมูลและงานเพียงใด โดยยังต้องตรวจสิทธิ์ การจัดเก็บ และคุณภาพผลลัพธ์
แนวคิดนี้ไม่ได้แปลว่า model ไม่สำคัญ หรือ harness ที่ดีจะทำให้ local model ทดแทน model อื่นได้ทุกงาน สิ่งที่คลิปสาธิตคือการปรับระบบรอบ model ในโจทย์ coding agent หนึ่งชุด จึงควรทดสอบกับงานจริงก่อนตัดสินใจใช้
