


Agentic Search vs Vector Search เป็นคำถามเรื่องวิธีค้นข้อมูลและต้นทุน AI ในการทดลองของ Braintrust ระบบสองแบบทำงานสำเร็จในระดับเดียวกัน แต่ค่าใช้จ่ายต่างกันประมาณ 4 เท่า ผลนี้เป็นของการตั้งค่าที่ทดลอง ไม่ใช่ข้อสรุปสำหรับระบบค้นหาทุกแบบ
Jess Wang จาก Braintrust อธิบายเรื่องนี้ผ่านการทดลองในคลิปของช่อง AI Engineer โดยนำ Claude Code มาทำงานแก้บั๊กในโครงการเดียว แล้วเปรียบเทียบวิธีค้นหาข้อมูลสองแบบ ประเด็นที่น่าสนใจกว่าผู้ชนะคือวิธีใช้ evals หรือการประเมินระบบ AI เปลี่ยนความรู้สึกว่า “น่าจะพร้อมใช้” ให้เป็นหลักฐานที่ตรวจสอบได้
สำหรับคนทำระบบ AI บทเรียนนี้เป็นแนวทางทดลองว่าคำตอบถูกพอหรือยัง ค่าใช้งานแพงเพราะอะไร และเมื่อเปลี่ยนโมเดลหรือคำสั่ง งานส่วนใดดีขึ้นหรือแย่ลง ตัวอย่างธุรกิจในบทความเป็นการนำแนวคิดไปคิดต่อจากงานเขียนโค้ดที่ผู้พูดทดลอง
ตั้งคำถามให้ชัดก่อนเลือก Agentic Search vs Vector Search
จุดเริ่มต้นของ evals ไม่ใช่เครื่องมือ แต่คือคำถามที่เราต้องการคำตอบ Jess ยกตัวอย่างทีมที่ปล่อยฟีเจอร์เพราะฝ่ายพัฒนาบอกว่าพร้อม หรือผู้จัดการผลิตภัณฑ์ลอง prompt สองสามชุดแล้วรู้สึกว่าดี ปัญหาคือความมั่นใจแบบนี้ยังไม่บอกว่าระบบจะรับมือกับงานจริงได้แค่ไหน
การบอกว่า “ทดสอบ 200 กรณี ผ่าน 94%” เป็นตัวอย่างของการตัดสินใจด้วยข้อมูล ไม่ใช่ผลจากการทดลองค้นหาครั้งนี้ และตัวเลขผ่านเพียงตัวเดียวก็ยังไม่พอ เพราะระบบอาจตอบแม่นขึ้น แต่ใช้น้ำเสียงที่ไม่เหมาะกับแบรนด์มากขึ้นด้วย
คำถามที่ evals ช่วยตอบได้มีหลายด้าน:
- การเลือก model: ตัวไหนเหมาะกับงานของธุรกิจ ไม่ใช่แค่ได้คะแนนสูงในงานทั่วไป
- ความหลากหลายของงาน: ระบบทำได้ดีเท่ากันหรือไม่เมื่อภาษา รูปแบบข้อมูล หรือประเภทคำถามเปลี่ยนไป
- ต้นทุน: ผลลัพธ์ที่ดีขึ้นคุ้มกับค่าใช้งานที่เพิ่มหรือไม่
- เสียงของแบรนด์: คำตอบรักษามาตรฐานการสื่อสารของบริษัทได้หรือไม่
- การถดถอย: หลังปรับระบบ มีงานที่เคยทำได้แล้วกลับทำไม่ได้หรือไม่
Jess ยกเรื่องการอัปเดตโมเดลของ OpenAI ในเดือนเมษายน 2025 เป็นตัวอย่างที่เธออธิบายว่า โมเดลเออออตามผู้ใช้มากขึ้นและน่าเชื่อถือน้อยลง ประเด็นที่เธอเน้นคือการวัดพฤติกรรมหลังปรับระบบ เรื่องเล่านี้เป็นบริบทจากผู้พูด ไม่ใช่ผลของการทดลองค้นหาครั้งนี้
มุมมองสำหรับธุรกิจคือ AI ที่ฟังดูเป็นมิตร ไม่จำเป็นต้องเป็น AI ที่ให้คำตอบถูก ถ้าเราทำแชตบอตบริการลูกค้า เกณฑ์ประเมินจึงควรแยกความถูกต้องออกจากความสุภาพ ไม่รวมทุกอย่างเป็นคำว่า “ตอบดี”
สร้างชุดทดสอบจากงานจริง และให้คนรู้เรื่องงานร่วมออกแบบ
evals ประกอบด้วยสี่ส่วนหลัก ได้แก่ ชุดข้อมูล งานที่ AI ต้องทำ ระบบให้คะแนน และการทดลอง ส่วนแรกคือชุดข้อมูลทดสอบ ซึ่งควรมีทั้งกรณีมาตรฐาน กรณีขอบเขต และกรณีที่ระบบเคยล้มเหลว
การทดลองของ Braintrust ใช้ โครงการ TypeScript Go ของ Microsoft ซึ่งเปิดเผยโค้ดต่อสาธารณะ ทีมเลือกคำขอแก้ไขโค้ดที่รวมเข้าโครงการแล้วและมีคำว่า fix ในชื่อ จากนั้นย้อนโค้ดกลับไปยังสถานะก่อนแก้ เพื่อให้ปัญหายังอยู่
ขั้นต่อมาคือใช้ Claude สร้างคำอธิบายงานจากความต่างระหว่างโค้ดก่อนและหลังแก้ แล้วให้ AI ใช้วิธีค้นหาที่กำหนดเพื่อหาตำแหน่งตรรกะที่มีปัญหา ชุดทดลองนี้มีประมาณ 20 กรณี
สิ่งที่ธุรกิจนำไปใช้ได้ไม่ใช่ขั้นตอนจัดการโค้ด แต่คือหลักการ เอาปัญหาที่เกิดขึ้นจริงมาสร้างข้อสอบ แทนการแต่งคำถามที่ AI ตอบได้ง่ายอยู่แล้ว
ตัวอย่างประยุกต์สำหรับร้านค้าไทยคือการเลือกคำถามจากงานบริการลูกค้า ทั้งคำถามทั่วไป คำถามเรื่องเงื่อนไข และคำถามที่เจ้าหน้าที่เคยต้องแก้คำตอบให้ AI ตัวอย่างนี้เป็นการต่อยอดแนวคิด ไม่ใช่งานที่ Braintrust ทดลองในคลิป
เหตุผลที่ฝ่ายธุรกิจต้องร่วมทำ evals
Jess เน้นว่า evals เป็นงานของทีม ไม่ใช่หน้าที่ฝ่ายพัฒนาเพียงฝ่ายเดียว คนแต่ละกลุ่มช่วยเติมส่วนที่ต่างกัน:
- ทีมพัฒนา: นำข้อมูลเข้าสู่ระบบ ปรับการทำงาน และแก้ส่วนที่ผิดพลาด
- ผู้ดูแลผลิตภัณฑ์: ตั้งสมมติฐาน กำหนดความสำเร็จ และช่วยปรับ prompt
- ผู้เชี่ยวชาญในงาน: ระบุคำตอบมาตรฐานและตัดสินกรณีที่ต้องใช้ความรู้เฉพาะ
- ผู้วิเคราะห์ข้อมูล: หารูปแบบของผลลัพธ์และความผิดพลาด
ในธุรกิจขนาดเล็ก คนหนึ่งอาจรับหลายบทบาทได้ แต่บทบาทเหล่านี้ยังต้องมี โดยเฉพาะงานประกัน การแพทย์ หรือกฎหมาย ซึ่งคำตอบที่อ่านลื่นไม่ได้แปลว่าถูกต้องตามหลักวิชาชีพ
กำหนดงานและเกณฑ์ผ่าน ก่อนเริ่มเปรียบเทียบ
ส่วนที่สองของ evals คือ “งาน” หรือวิธีที่ระบบรับข้อมูลแล้วสร้างผลลัพธ์ โดยทั่วไปเกี่ยวข้องกับ system prompt และ model ที่เลือกใช้ ส่วนที่สามคือเกณฑ์ให้คะแนน ซึ่งต้องอธิบายได้ว่าคำตอบแบบไหนผ่านและแบบไหนไม่ผ่าน
วิธีให้คะแนนมีหลายรูปแบบ ตั้งแต่กฎตายตัว การให้ LLM ช่วยตัดสิน ไปจนถึงการให้คนตรวจ การเลือกวิธีขึ้นอยู่กับลักษณะงาน ไม่จำเป็นต้องใช้ AI ตัดสินทุกเรื่อง
ในการทดลองนี้ ทีมใช้ชุดทดสอบของโครงการ TypeScript Go เป็นเกณฑ์ หากผ่านให้คะแนน 100% หากไม่ผ่านให้ 0% ตัวเลขเป็นเกณฑ์ของแต่ละงาน ไม่ได้หมายความว่าทั้งระบบตอบถูก 100% และคะแนนนี้วัดผลตามชุดทดสอบ ไม่ได้วัดคุณภาพคำอธิบายทุกด้าน
อย่างไรก็ตาม คะแนนจากชุดทดสอบเป็นผลสำเร็จของงานภายใต้เงื่อนไขที่กำหนด ไม่ใช่คะแนนความสามารถค้นหาทุกมิติ เราจึงควรระวังการอ่านคำว่า “แม่นเท่ากัน” ว่าสองระบบเก่งเท่ากันในทุกสถานการณ์
เมื่อนำไปประยุกต์กับแชตบอตธุรกิจ เราอาจแยกเกณฑ์เป็นความถูกต้องของข้อมูล การรักษาน้ำเสียง และการตอบตามข้อกำหนดของบริษัท การแยกคะแนนช่วยให้เห็นสิ่งที่ต้องแลก เช่น ตอบถูกขึ้นแต่สื่อสารแข็งขึ้น แทนการซ่อนความต่างไว้ในคะแนนเฉลี่ยเดียว
ข้อเสนอของบทความนี้คือให้เจ้าของงานเป็นคนอนุมัติเกณฑ์ก่อนเริ่มทดลอง เพราะฝ่ายเทคนิคอาจทำให้ระบบทำงานได้ แต่ฝ่ายธุรกิจต้องเป็นคนตัดสินว่า “ผลลัพธ์นี้ใช้กับลูกค้าได้หรือยัง”
เข้าใจวิธีค้นหาสองแบบ และควบคุมการทดลองให้เทียบกันได้
Vector Search: ค้นจากความใกล้เคียงทางความหมาย
Vector Search แปลงข้อความหรือโค้ดเป็น embeddings ซึ่งเป็นตัวแทนเชิงตัวเลขของความหมาย แล้วเก็บไว้ในฐานข้อมูลเวกเตอร์ เช่น Qdrant หรือ Pinecone เมื่อมีคำถาม ระบบจะคืนส่วนของข้อมูลที่มีความหมายใกล้กับคำถามมากที่สุด
Jess ใช้ตัวอย่างคำเกี่ยวกับสัตว์ เช่น หมาป่า สุนัข และแมว ซึ่งอยู่ใกล้กันในพื้นที่ของ embeddings ส่วนกล้วยกับแอปเปิลอยู่ใกล้กันอีกกลุ่ม เพราะมีความหมายเกี่ยวกับผลไม้
สำหรับคนทำงาน แนวคิดนี้คล้ายการหาข้อความที่ “พูดเรื่องเดียวกัน” แม้ไม่ได้ใช้คำตรงกันทุกคำ แต่ความใกล้เคียงทางความหมายยังไม่รับประกันว่าข้อมูลที่ได้จะครบพอสำหรับตัดสินใจ
Agentic Search: ให้ AI ค้น อ่าน และตามความเชื่อมโยง
Agentic Search ในการทดลองนี้ให้ LLM ใช้เครื่องมือค้นหาและอ่านไฟล์ เช่น grep, find, ls และ cat ระบบอาจค้นชื่อฟังก์ชัน เปิดอ่านไฟล์ แล้วตามไปดูอีกไฟล์ที่ถูกเรียกใช้งาน กระบวนการจึงคล้ายคนค่อย ๆ ตรวจสอบโครงการเพื่อเข้าใจว่าชิ้นส่วนต่าง ๆ ทำงานร่วมกันอย่างไร
สองคำนี้ไม่ควรถูกใช้แทนกัน การค้นตามความหมายเป็นวิธีจับคู่ข้อมูล ส่วนการค้นแบบ agent เน้นกระบวนการใช้เครื่องมือและเลือกว่าจะค้นอะไรต่อ ในที่นี้เรากำลังเปรียบเทียบ embeddings กับการค้นและอ่านไฟล์แบบต่อเนื่อง
ทำไมสั่งด้วย prompt อย่างเดียวไม่พอ
ทีมใช้ Claude Code เป็นสภาพแวดล้อมการทำงานเดียวกันทั้งสองฝั่ง เพื่อให้การทดลองสอดคล้องกัน ฝั่ง Agentic Search ใช้พฤติกรรมค้นหาที่ Claude Code มีอยู่แล้ว ส่วนฝั่ง Vector Search ต้องป้องกันไม่ให้ระบบกลับไปใช้วิธีค้นแบบ agent
ทีมจึงทำสองอย่างร่วมกัน คือระบุใน prompt ว่าไม่ให้ใช้ Agentic Search และปิดเครื่องมือที่เกี่ยวข้องผ่านการตั้งค่าห้ามใช้เครื่องมือ เพราะคำสั่งใน prompt เพียงอย่างเดียวไม่ใช่ข้อบังคับที่เชื่อถือได้เสมอ
บทเรียนสำหรับเจ้าของธุรกิจคือ คำสั่งกับสิทธิ์ใช้งานเป็นคนละเรื่อง หากเราต้องการทดสอบ workflow แบบจำกัดเครื่องมือ ควรให้ทีมตรวจสิทธิ์จริงด้วย ไม่ใช่อาศัยเพียงข้อความว่า “ห้ามใช้” แล้วถือว่าการทดลองถูกควบคุมแล้ว
ตรวจเส้นทางการทำงาน แล้วเชื่อมผลทดสอบกลับสู่งานจริง
การรู้ว่า AI ผ่านหรือไม่ผ่านช่วยตัดสินผล แต่ยังไม่อธิบายสาเหตุ เราจึงต้องมี observability หรือความสามารถในการเห็นสิ่งที่เกิดขึ้นระหว่างการทำงาน ทั้งข้อมูลที่เข้า การเรียก model และการใช้เครื่องมือ
ในการทดลองนี้ Claude Code ทำงานเป็นกระบวนการย่อย ช่วงแรกบันทึกเส้นทางการทำงานหรือ trace ไม่เชื่อมกับงานหลัก จึงเห็นเพียงว่าเรียก Claude แล้ว แต่ไม่เห็นรายละเอียดข้างใน ทีมแก้ด้วยการส่งรหัสเชื่อมต่อของงานหลักไปยังกระบวนการย่อยผ่านตัวแปรสภาพแวดล้อม
เมื่อเชื่อมได้แล้ว ทีมจึงตรวจเห็นรอบสนทนา การเรียก LLM และคำสั่งค้นหาแต่ละครั้ง สำหรับฝ่ายธุรกิจ สิ่งที่ควรขอจากทีมคือรายงานที่ตอบได้ว่า AI ใช้ข้อมูลอะไร ทำขั้นตอนอะไร และติดอยู่ตรงไหน ไม่ใช่เพียงคำตอบสุดท้าย
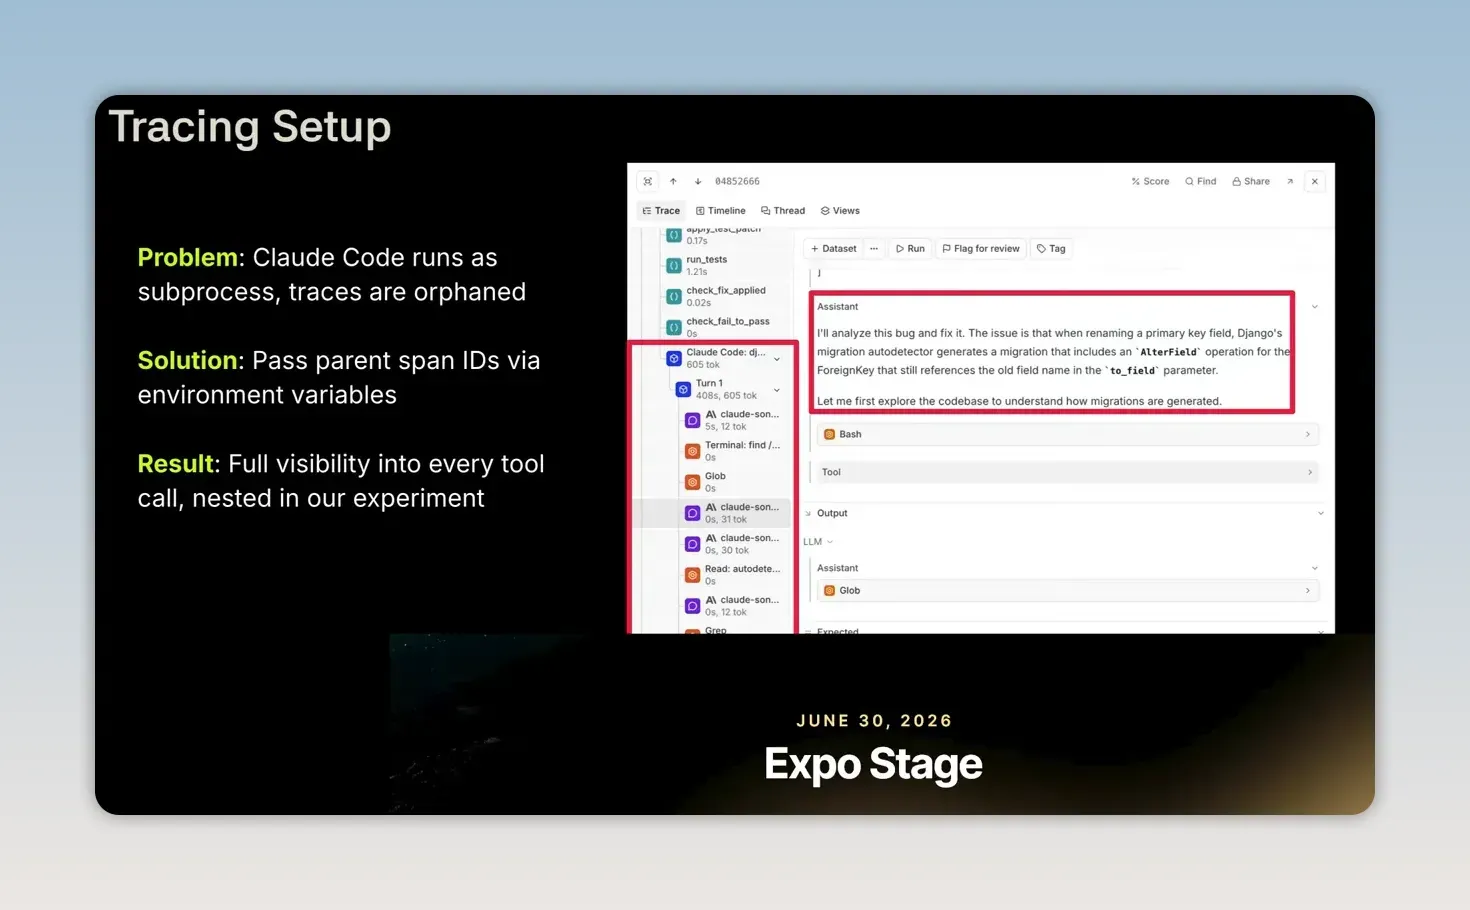
Braintrust ยังแสดงการใช้ภาษาธรรมชาติถามข้อมูลการทดลอง เช่น ให้สรุปปัญหาหรือหาแนวโน้มใน trace วิธีนี้ช่วยตรวจบทสนทนายาวที่อาจมีการแต่งข้อมูลหรือค่อย ๆ หลุดจากเป้าหมาย แต่ข้อค้นพบสำคัญยังควรย้อนกลับไปตรวจรายการจริง
ทำให้ evals เป็นวงจร ไม่ใช่การตรวจครั้งเดียว
Jess ยกตัวอย่างแชตบอตตอบคำถามเกี่ยวกับเอกสาร เมื่อมีการใช้งานจริง บันทึกการทำงานจะกลายเป็นแหล่งข้อมูลสำหรับสร้างชุดทดสอบรอบถัดไป วงจรมีลำดับดังนี้:
- เก็บบันทึกจากระบบที่ใช้งานจริง
- เลือกตัวอย่างบางส่วน เช่น 10 ถึง 20 รายการ เพื่อเริ่มสร้างชุดข้อมูล
- กำหนดงานและเกณฑ์คะแนน แล้วทดลองหลายรูปแบบ
- เปรียบเทียบผลรวมและตรวจกรณีที่เปลี่ยนไปเป็นรายข้อ
- นำสิ่งที่เรียนรู้ไปปรับระบบ แล้วติดตามผลหลังนำกลับไปใช้
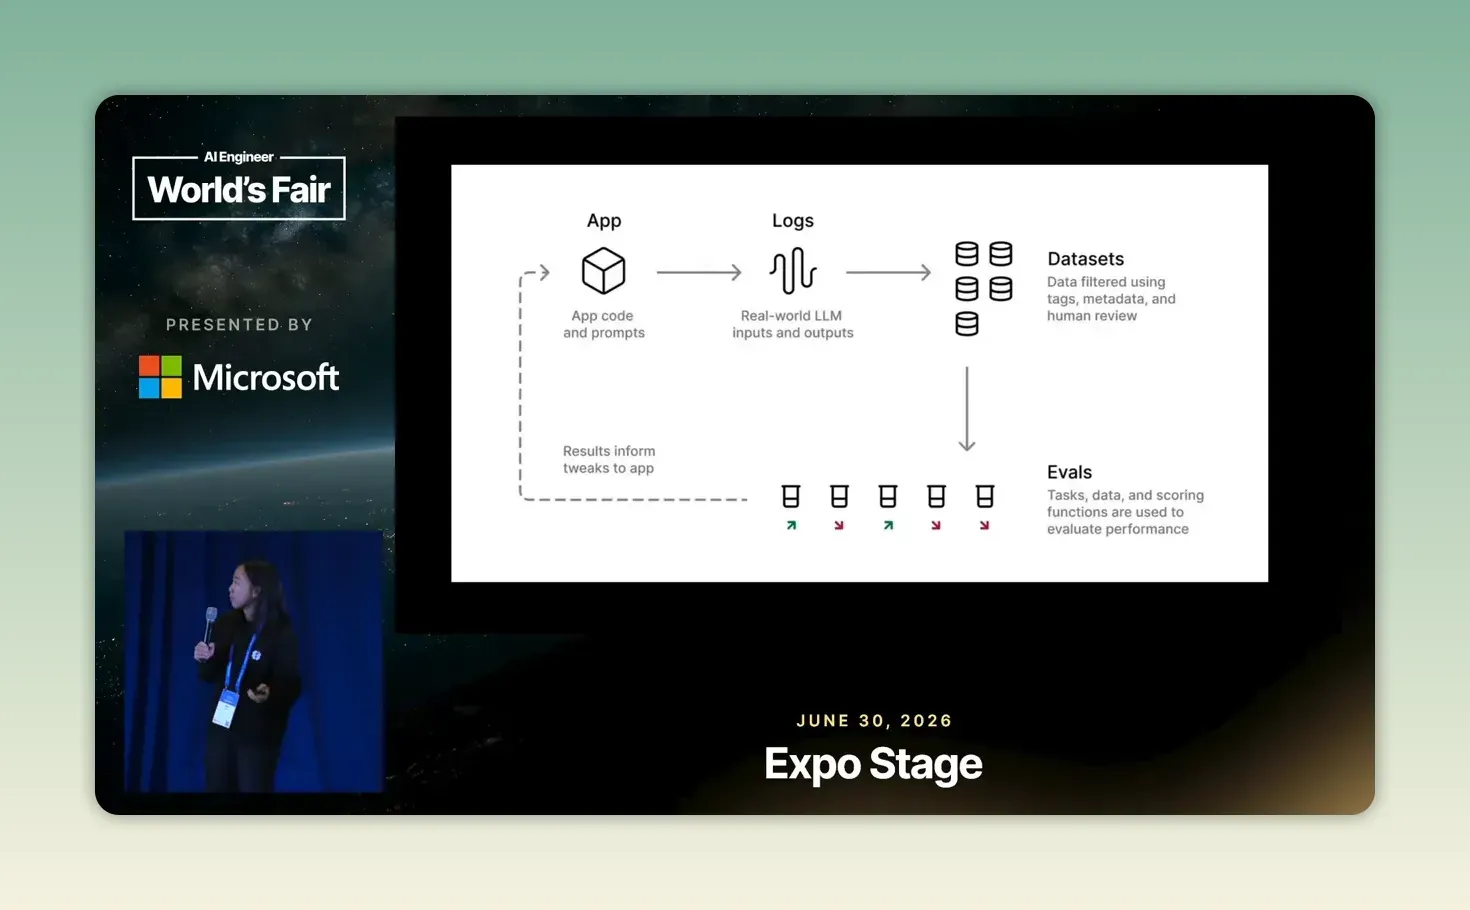
ตัวเลข 10 ถึง 20 รายการเป็นจุดเริ่มต้นสำหรับเรียนรู้ ไม่ใช่หลักประกันว่าครอบคลุมงานทั้งหมด จุดที่มีค่าคือทุกปัญหาจากงานจริงสามารถกลายเป็นข้อสอบที่ช่วยป้องกันการพลาดซ้ำได้
อ่านผลแม่นเท่ากัน แต่ต้นทุนต่าง 4 เท่าอย่างระมัดระวัง
Jess รายงานว่า ในการตั้งค่าครั้งนี้ Vector Search และ Agentic Search ผ่านงานได้ในระดับเดียวกัน แต่ Vector Search มีค่าใช้จ่ายประมาณ 4 เท่าของ Agentic Search ตัวเลขราว 4 เท่ามาจากคำบรรยาย ส่วนสไลด์ที่เก็บไว้ระบุ Ts-go 10 งาน และค่าใช้จ่ายเฉลี่ย $4.40 เทียบกับ $1.58 หรือราว 2.8 เท่า จึงไม่ควรใช้ตารางนี้ยืนยันอัตรา 4 เท่า เธอตรวจ trace หรือบันทึกเส้นทางการทำงานเพื่อหาสาเหตุ และเชื่อมความต่างกับข้อมูลที่ค้นคืนมาและจำนวนครั้งที่ต้องค้นต่อ
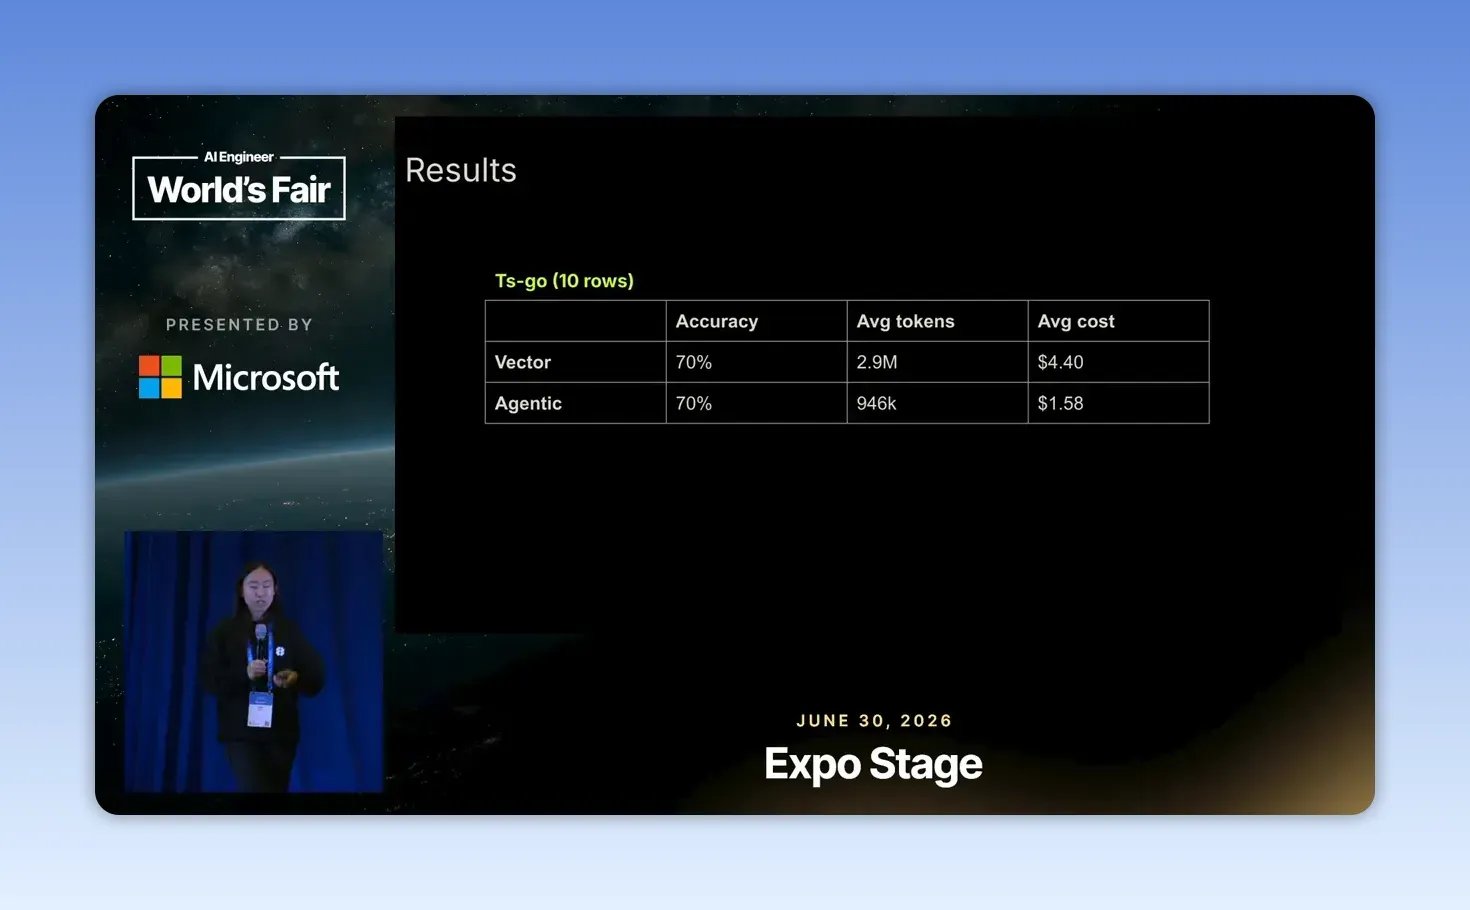
ในการทดลองนี้ Vector Search คืนโค้ดเป็นชิ้นย่อย ซึ่งบางครั้งขาดส่วนรอบข้าง เช่น imports หรือโค้ดที่เรียกใช้ฟังก์ชัน Jess อธิบายว่า agent จึงเข้าใกล้ตำแหน่งที่ถูกต้อง แต่ยังไม่มีข้อมูลพอจะเข้าใจความสัมพันธ์เพื่อแก้บั๊ก
หนึ่งในกรณีที่ Jess รายงาน ฝั่ง Vector Search ค้นถึง 26 ครั้ง แต่ยังต่อภาพไม่ได้ว่าฟังก์ชันสามตัวทำงานร่วมกันอย่างไร ส่วน Agentic Search ในกรณีที่เธออธิบายค้นชื่อฟังก์ชัน อ่านส่วนที่เกี่ยวข้อง และตามการเรียกใช้งานไปยังไฟล์อื่นได้
Jess เชื่อมการค้นซ้ำในบันทึกเหล่านี้กับการเรียกโมเดลที่เพิ่มขึ้นและต้นทุนที่สะสม บทเรียนจากกรณีนี้คือ ข้อมูลที่เกี่ยวข้องอาจยังไม่ใช่ข้อมูลที่เพียงพอสำหรับทำงานต่อ จึงควรตรวจพฤติกรรมรายกรณีควบคู่กับคะแนนรวม
ตัวอย่างประยุกต์กับธุรกิจไทยคือแชตบอตที่ค้นเจอข้อความนโยบายคืนสินค้า แต่ไม่ได้รับข้อยกเว้นในหัวข้อข้างเคียง ระบบอาจต้องค้นซ้ำหรือให้คำตอบไม่ครบ ตัวอย่างนี้ไม่ได้พิสูจน์ว่า Agentic Search จะดีกว่าในงานบริการลูกค้า แต่ชี้ว่าเราควรทดสอบความครบถ้วนของข้อมูล ไม่ใช่ตรวจแค่ว่าหาเอกสารที่เกี่ยวข้องเจอหรือไม่
ข้อจำกัดที่ห้ามตัดออกจากข้อสรุป
Jess ยอมรับว่าการทดลองยังปรับปรุงได้ การทำ Vector Search ของเธอยังไม่แข็งแรง ชุดข้อมูลมีประมาณ 20 งานในโครงการเดียว และอาจขยายไปยัง repo หรือคลังโค้ดอื่นได้ เธอเสนอให้รันหลายครั้งต่อโจทย์เพราะโมเดลให้ผลต่างกันได้ จึงไม่ควรขยายอัตราต้นทุน 4 เท่าเป็นข้อสรุปของทุกระบบ
ดังนั้น ข้อสรุปที่เหมาะสมไม่ใช่ “Vector Search แพงกว่าเสมอ” แต่คือ “ในการตั้งค่าที่ทดลองครั้งนี้ Vector Search แพงกว่า โดย trace ชี้ว่าการค้นซ้ำเป็นสาเหตุสำคัญ”
มุมมองของบทความนี้คือ ตัวเลข 4 เท่าควรเป็นเหตุผลให้เราตรวจระบบของตัวเอง ไม่ใช่เหตุผลให้รื้อระบบทันที ผลทดลองเล็กที่อธิบายสาเหตุได้มีประโยชน์ แต่ยังไม่ควรถูกขยายเป็นคำตัดสินสำหรับทุกธุรกิจ
เปลี่ยนบทเรียนเป็นสิ่งที่ลงมือทำได้
- เลือกงานเดียวก่อน: เริ่มจาก workflow ที่มีผู้รับผิดชอบและอธิบายผลสำเร็จได้ชัด เช่น แชตบอตตอบคำถามเอกสาร
- รวบรวมกรณีจริง: เลือกทั้งงานทั่วไป งานยาก และงานที่ AI เคยพลาด ไม่เก็บเฉพาะตัวอย่างที่ตอบสวย
- ตกลงเกณฑ์กับเจ้าของงาน: แยกความถูกต้อง น้ำเสียง และข้อกำหนดสำคัญก่อนเริ่มให้คะแนน
- เทียบผลพร้อมต้นทุน: ขอข้อมูลค่าใช้จ่าย token และการค้นซ้ำควบคู่กับคะแนนผ่าน
- ตรวจซ้ำหลังเปลี่ยนระบบ: ใช้ชุดทดสอบเดิมเทียบรุ่นก่อนกับรุ่นใหม่ และเพิ่มกรณีผิดพลาดจากงานจริงอย่างต่อเนื่อง
เป้าหมายของรอบแรกไม่ใช่การสร้างข้อสอบสมบูรณ์แบบ แต่คือการทำให้คำว่า “พร้อมใช้” มีความหมายที่ทุกฝ่ายเข้าใจตรงกัน
แก้ปัญหาที่พบบ่อยเมื่อเริ่มทำ evals
ปัญหา 1: คะแนนดี แต่พอใช้งานจริงกลับตอบพลาด
- ปัญหา: ชุดทดสอบผ่านเกือบทั้งหมด แต่ยังมีคำตอบผิดในงานจริง
- สิ่งที่ควรตรวจ: ตัวอย่างทดสอบอาจง่ายเกินไป หรือยังไม่ครอบคลุมประเภทงานจริง
- แนวทางทดสอบ: เลือกกรณีผิดพลาดจากบันทึกการใช้งาน ให้เจ้าของงานระบุคำตอบที่ควรได้ แล้วเพิ่มเข้าสู่ชุดทดสอบรอบถัดไป
ปัญหา 2: ทดลองโจทย์เดิมแล้วคะแนนแกว่ง
- ปัญหา: ครั้งหนึ่งผ่าน แต่อีกครั้งไม่ผ่าน ทั้งที่โจทย์เหมือนเดิม
- สิ่งที่ควรตรวจ: ผลลัพธ์ของ LLM ไม่คงที่เสมอ การทดลองรอบเดียวจึงอาจไม่สะท้อนพฤติกรรมโดยรวม
- แนวทางทดสอบ: รันหลายรอบต่อโจทย์ บันทึกผลทุกครั้ง และตรวจทั้งกรณีที่ผ่านสม่ำเสมอกับกรณีที่ขึ้นอยู่กับแต่ละรอบ
ปัญหา 3: ค่าใช้จ่ายสูง แต่คำตอบไม่ได้ดีขึ้น
- ปัญหา: ระบบค้นหลายครั้งและเรียก model ต่อเนื่อง แต่ยังตอบไม่ครบ
- สิ่งที่ควรตรวจ: ข้อมูลที่ได้อาจขาด context หรือความเชื่อมโยงที่จำเป็นต่อการทำงาน
- แนวทางทดสอบ: ตรวจ trace ของกรณีแพง ดูว่าค้นซ้ำเพื่อเติมข้อมูลอะไร แล้วให้ทีมปรับการคืนข้อมูลหรือวิธีค้นก่อนทดลองใหม่
ปัญหา 4: แยกไม่ออกว่าวิธีไหนทำให้ผลดีขึ้น
- ปัญหา: ตั้งใจเปรียบเทียบสองวิธี แต่ระบบแอบใช้เครื่องมือร่วมกัน
- สิ่งที่ควรตรวจ: จำกัดพฤติกรรมด้วย prompt แต่ไม่ได้จำกัดสิทธิ์เครื่องมือ
- แนวทางทดสอบ: ตรวจการตั้งค่าเครื่องมือ ปิดส่วนที่ไม่อนุญาต และยืนยันจาก trace ว่าแต่ละฝั่งทำงานตามเงื่อนไขจริง
ปัญหา 5: รู้ว่างานล้มเหลว แต่หาจุดผิดไม่เจอ
- ปัญหา: รายงานมีเพียงคำตอบสุดท้าย หรือเห็นงานหลักแต่ไม่เห็นงานย่อย
- สิ่งที่ควรตรวจ: บันทึกเส้นทางการทำงานไม่ครบ หรือกระบวนการย่อยไม่เชื่อมกับงานหลัก
- แนวทางทดสอบ: ให้ทีมตรวจการเชื่อม trace ระหว่างงานหลักกับงานย่อย แล้วทดสอบว่าเห็นการเรียก model และเครื่องมือครบก่อนวิเคราะห์สาเหตุ
วางแนวทางการต่อยอดหลังการทดลองแรก
เมื่อมีชุดทดสอบและเกณฑ์คะแนนแล้ว เราสามารถต่อยอดได้โดยไม่ต้องเริ่มใหม่ทุกครั้ง แนวทางที่ควรพิจารณามีสามเรื่อง:
- ขยายชุดข้อมูล: เพิ่มประเภทงาน ภาษา และกรณียาก เพื่อทดสอบว่าผลจากรอบแรกยังคงอยู่หรือไม่ โดยธุรกิจไทยควรตรวจภาษาไทยด้วย ไม่อนุมานจากผลภาษาอังกฤษ
- ทดสอบการปรับวิธีค้น: หากข้อมูลชิ้นย่อยขาดส่วนรอบข้าง ให้ปรับการคืนข้อมูลแล้วเปรียบเทียบใหม่ แทนการตัดสินว่าวิธีนั้นใช้ไม่ได้ทันที
- กำหนดรอบประเมินร่วมกัน: ให้ฝ่ายธุรกิจและทีมพัฒนาตรวจผลก่อนเปลี่ยน prompt หรือ model และหลังพบรูปแบบความผิดพลาดใหม่
การต่อยอดที่ดีควรเริ่มจากสมมติฐานที่ตรวจสอบได้ เช่น “การให้ข้อมูลส่วนที่เกี่ยวข้องครบขึ้นจะลดการค้นซ้ำหรือไม่” ไม่ใช่เปลี่ยนหลายอย่างพร้อมกันแล้วหวังว่าคะแนนรวมจะดีขึ้น
Agentic Search vs Vector Search สอนว่า ความแม่นยำเท่ากันไม่ได้หมายถึงต้นทุนหรือกระบวนการทำงานเท่ากัน สิ่งที่ธุรกิจควรนำกลับไปใช้จึงไม่ใช่คำตอบสำเร็จรูปว่าวิธีไหนดีที่สุด แต่เป็นวิธีสร้างหลักฐานก่อนเลือก
ที่มา: Agentic Search vs Vector Search for Coding Agents: We Ran the Eval · Braintrust บนช่อง AI Engineer วิดีโอเผยแพร่วันที่ 5 ตุลาคม 2569 สรุปจาก transcript ที่บันทึกไว้ช่วง 00:01–17:55 ผลและตัวเลขเป็นสิ่งที่ผู้พูดรายงานในเวลานั้น ตัวอย่างธุรกิจและแนวทางทดลองเป็นข้อเสนอของ VibeSolo ให้นำไปทดสอบกับงานจริง
