


AI Agent ที่จำงานเก่าได้ ไม่ได้แปลว่าทีมจะเลิกทำงานซ้ำ Karthik Ranganathan ตั้งโจทย์ว่า หากตัวหนึ่งส่งต่อเพียงไฟล์ผลลัพธ์ อีกตัวอาจต้องค้นข้อมูลและทดลองทางเดิมใหม่ เพราะไม่มีเหตุผล ทางตัน และข้อจำกัดที่เคยพบ นี่คือปัญหาการส่งต่อความรู้ที่ทีมของเขาต้องการแก้
ประเด็นนี้มาจากคลิปของช่อง AI Engineer ซึ่งแนะนำ Karthik Ranganathan ว่าเป็นผู้ร่วมก่อตั้งและซีอีโอร่วมของ Yugabyte เขาเล่าประสบการณ์สร้างระบบ AI ที่ทีมใช้เองและให้ลูกค้า พร้อมการสาธิต Meko ที่บันทึกไว้โดย Heather Downing แก่นของเรื่องคือการแยกความจำของ AI แต่ละตัวออกจากความรู้ที่ทีมใช้ต่อได้
สำหรับเจ้าของธุรกิจและคนทำงาน บทเรียนที่น่าสนใจไม่ใช่การเพิ่ม AI ให้มากขึ้น แต่คือการออกแบบให้ข้อค้นพบ เหตุผลในการตัดสินใจ และข้อผิดพลาดที่ผ่านมา กลายเป็นสินทรัพย์ของทีม บทความนี้จึงเรียงแนวคิดดังกล่าวเป็นขั้นตอน พร้อมข้อจำกัดและแนวทางทดลองใช้กับธุรกิจไทย
แยกความจำของ AI Agent ออกจากการเรียนรู้ของทีม
ความจำช่วยให้ AI Agent ดึงข้อมูลจากการสนทนาเก่ากลับมาใช้ เช่น ความต้องการของคนทำงานหรือรายละเอียดโครงการ แต่การเรียนรู้ร่วมกันต้องทำได้มากกว่านั้น ข้อค้นพบจากงานหนึ่งต้องถูกส่งต่อให้คนและ AI ตัวอื่นนำไปใช้ โดยไม่ต้องเริ่มกระบวนการค้นหาคำตอบใหม่ทั้งหมด
Karthik เล่าว่าทีมสร้าง agent สี่กลุ่มงาน ได้แก่ งานบริการลูกค้า งานประสานฝ่ายขายกับการตลาด งานดูแลฐานข้อมูล และงานย้ายฐานข้อมูล หลังพยายามเกือบหนึ่งปี ทีมมองว่าปัญหาที่ต้องแก้อยู่ที่ข้อมูลซึ่งใช้และส่งต่อ ไม่ใช่แค่ความเร็วหรือขนาดฐานข้อมูล นี่เป็นประสบการณ์ที่ผู้พูดรายงาน
จุดที่งานสะดุดคือ การส่งต่อผลลัพธ์โดยไม่ส่งต่อ context เอกสาร PDF หรือไฟล์สรุปบอกได้ว่าสุดท้ายเลือกอะไร แต่ไม่จำเป็นต้องบอกว่าเหตุใดจึงเลือก ทางเลือกไหนเคยทดลองแล้ว หรือข้อจำกัดใดทำให้แนวทางอื่นใช้ไม่ได้
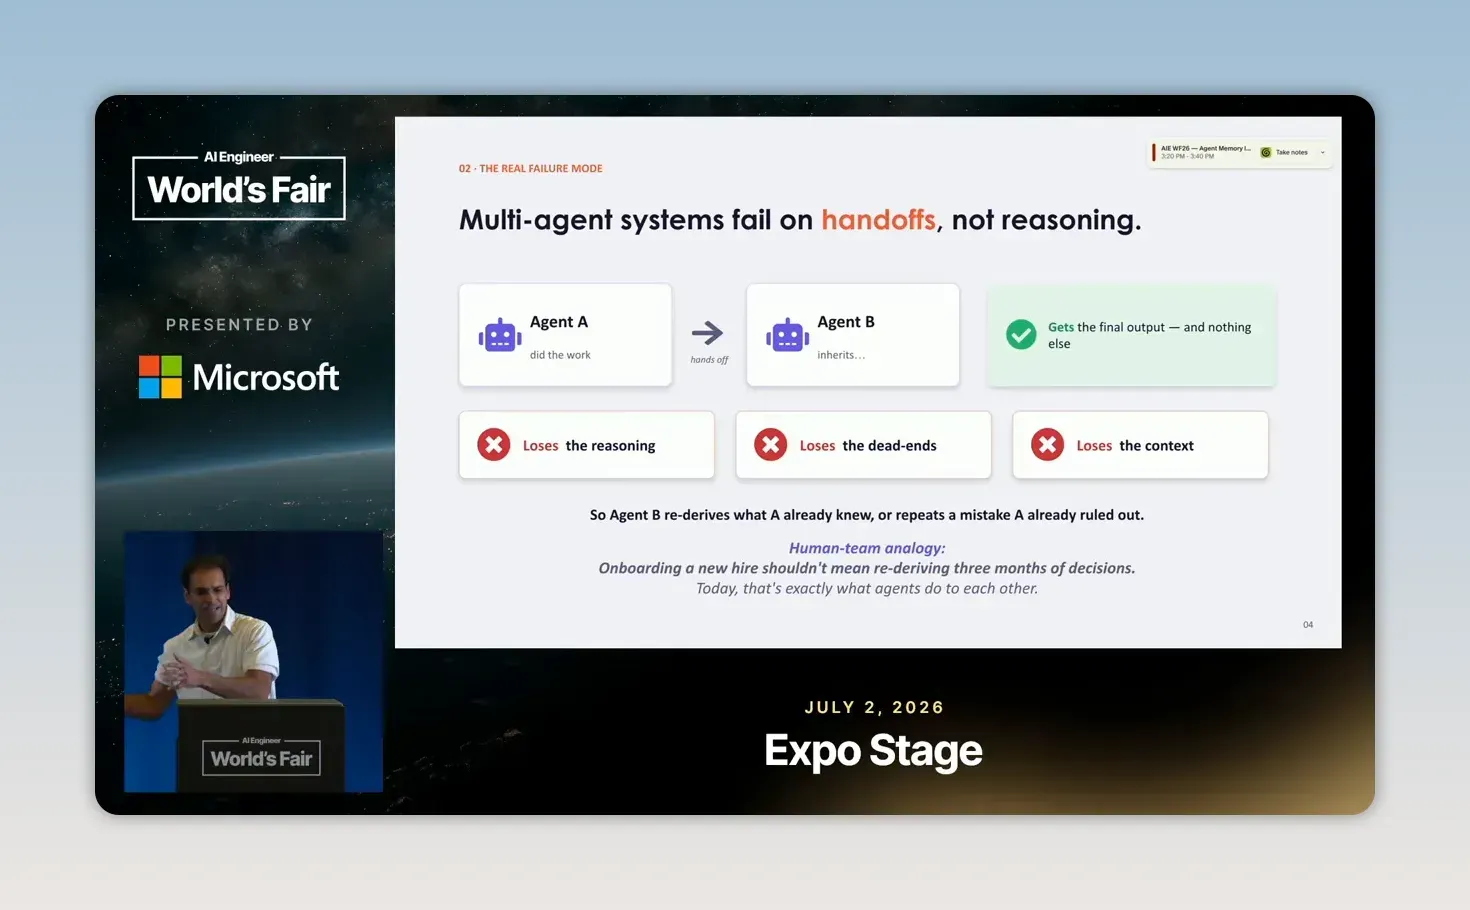
ภาพเปรียบเทียบที่เข้าใจง่ายคือพนักงานใหม่เข้าทีม หากได้รับเพียงคำสั่งให้ทำตามแผน ก็อาจเสนอทางเลือกที่ทีมเคยปฏิเสธไปแล้ว การอธิบายประวัติโครงการช่วยให้เริ่มต่อจากจุดปัจจุบันได้ AI หลายตัวก็ต้องการข้อมูลลักษณะเดียวกัน
หากนำแนวคิดนี้มาใช้กับธุรกิจไทย เราอาจเริ่มจากงานส่งต่อระหว่างฝ่ายขายกับฝ่ายบริการลูกค้า โดยให้บันทึกไม่ใช่แค่คำตอบที่ส่งให้ลูกค้า แต่รวมถึงเงื่อนไขที่ตกลง เหตุผลที่เลือกแนวทางนั้น และวิธีที่ลองแล้วไม่สำเร็จ นี่เป็นตัวอย่างการประยุกต์ ไม่ใช่ผลลัพธ์ที่คลิปพิสูจน์ไว้
คำกล่าวว่าเรื่องความจำ “แก้ได้แล้ว” ควรอ่านเป็นจุดยืนของ Karthik ไม่ใช่ข้อสรุปว่าระบบความจำทุกแบบสมบูรณ์แล้ว สิ่งที่เขาต้องการแยกคือ การจำข้อมูลรายตัวกับการส่งต่อความรู้ให้ทั้งทีมเป็นคนละโจทย์
ตรวจหาความเข้าใจผิดก่อนเพิ่มเครื่องมือ
Karthik ตั้งประเด็นความเข้าใจผิดห้าข้อจากงานที่ทีมพยายามทำ ข้อต่อไปนี้เป็นมุมมองของผู้พูดต่อโจทย์การเรียนรู้ร่วมกัน ไม่ใช่ข้อสรุปว่าทุกเทคนิคไม่มีประโยชน์
- เพิ่มความจำแล้วจะเรียนรู้ดีขึ้น: การเก็บมากขึ้นไม่ได้ทำให้ข้อมูลถูกคัดเลือก ตรวจสอบ หรือพร้อมส่งต่อโดยอัตโนมัติ
- มีไฟล์ร่วมกันเท่ากับมีความรู้ร่วมกัน: ทุกคนเปิดเอกสารเดียวกันได้ แต่ยังอาจไม่รู้ว่าข้อสรุปมาจากไหนและใช้ได้ภายใต้เงื่อนไขใด
- นำประวัติการสนทนาทั้งหมดเข้า RAG แล้วจบ: ข้อมูลดิบอาจมีข้อสันนิษฐานที่ผิด ทางเลือกที่ยกเลิก และข้อความที่ไม่เกี่ยวกับงานปัจจุบันปะปนอยู่
- ปรับแต่ง model แล้วจะเก็บทุกบทเรียนได้: Karthik มองว่าการปรับแต่ง model ไม่ใช่ทางที่ขยายตามบทเรียนใหม่ของ agent ได้สะดวกในโจทย์นี้
- context window ใหญ่ขึ้นย่อมดีกว่า: การใส่ข้อมูลเพิ่มอาจเพิ่มค่า token โดยไม่ช่วยให้ AI เลือกข้อมูลที่เหมาะกับคำถาม
มุมที่ควรระวังคือเครื่องมือเหล่านี้ไม่ได้ไร้ประโยชน์ทั้งหมด ไฟล์ร่วมกัน ฐานความรู้ และ RAG ยังเป็นส่วนประกอบของระบบได้ เพียงแต่ ไม่มีสิ่งใดทดแทนกติกาว่าอะไรควรถูกเก็บ อะไรควรถูกแชร์ และใครรับรองได้
สำหรับทีมเล็ก การเริ่มด้วยเอกสารร่วมกันอาจสมเหตุสมผลกว่าการซื้อ platform ใหม่ทันที แต่เอกสารนั้นควรเก็บบทเรียนพร้อมหลักฐาน ไม่ใช่รวบทุกข้อความลงโฟลเดอร์แล้วหวังให้ AI แยกของสำคัญเอง
ออกแบบ context ให้แชร์ได้ มีผู้ดูแล และย้อนกลับไปหาต้นทางได้
แนวทางของ Yugabyte มีองค์ประกอบสามส่วน ซึ่งเจ้าของธุรกิจสามารถใช้เป็นเกณฑ์ประเมินระบบได้โดยไม่ต้องเข้าใจโครงสร้างฐานข้อมูล
แชร์ข้อมูลที่จำเป็นต่อการทำงานต่อ
ผู้รับงานควรรู้เป้าหมาย ข้อจำกัด ข้อสรุป และทางเลือกที่เคยทดลอง ไม่ใช่ได้รับเพียงชิ้นงานสุดท้าย ความรู้ที่ดีต้องช่วยลดการตั้งคำถามเดิม ไม่ใช่เพิ่มภาระในการอ่านประวัติทั้งหมด
มีคนอนุมัติก่อนเลื่อนเป็นความรู้ส่วนกลาง
ข้อค้นพบของ agent อาจผิดได้ จึงไม่ควรเปิดให้ทุกข้อความกลายเป็นความรู้ของทั้งทีมทันที คลิปเรียกกระบวนการนี้ว่า promotion คือการเลื่อนข้อมูลจากพื้นที่ส่วนตัวเข้าสู่พื้นที่ร่วม หลังผ่านการพิจารณา
จุดนี้คล้ายการตรวจงานก่อนประกาศเป็นแนวทางของบริษัท การอนุมัติไม่ได้เป็นเพียงเรื่องสิทธิ์เข้าถึง แต่เป็นด่านป้องกันไม่ให้ข้อสรุปที่ยังไม่ตรวจสอบถูกนำไปใช้ซ้ำหลายครั้ง
รู้ว่าข้อมูลมาจากไหน
เมื่อ AI ให้ข้อมูลที่น่าสงสัย ทีมต้องตามกลับไปถึงเอกสาร บุคคล หรือการสนทนาที่เป็นต้นทางได้ หากหาต้นทางไม่ได้ การแก้คำตอบหนึ่งครั้งก็อาจไม่แก้ความผิดพลาดในฐานความรู้
แนวทางเริ่มต้นที่เราใช้ได้คือทำบันทึกบทเรียนสั้น ๆ ให้มีห้าช่อง:
- เหตุการณ์หรือคำถามที่ต้องแก้
- ข้อสรุปที่ยืนยันแล้ว
- เงื่อนไขและข้อจำกัดของข้อสรุป
- วิธีที่ลองแล้วไม่สำเร็จ
- แหล่งข้อมูลและผู้ตรวจสอบ
โครงสร้างนี้เป็นข้อเสนอสำหรับนำแนวคิดไปใช้ ไม่ใช่แบบฟอร์มที่ Meko บังคับ ประโยชน์คือทำให้เราเห็นความต่างระหว่าง “ข้อมูลที่ AI เคยพูด” กับ “ความรู้ที่ทีมพร้อมรับรอง”
ปรับ RAG ด้วยการวัดผล ไม่ใช่การใส่ข้อมูลเพิ่ม
RAG คือการค้นข้อมูลที่เกี่ยวข้องมาประกอบการสร้างคำตอบ ปัญหาของ Yugabyte คือแม้สร้างระบบค้นข้อมูลที่รองรับงานขนาดใหญ่ได้ ก็ยังได้คำตอบที่ไม่ดีพอ
ทีมเคยลองสามแนวทางแล้วพบข้อจำกัดต่างกัน การรวบทุกอย่างไว้ในฐานความรู้ไม่ได้สร้างผลลัพธ์ที่ดี การให้ agent แต่ละตัวมีฐานข้อมูลเล็กของตัวเองทำให้ workflow เดิมถูกคิดใหม่ซ้ำ ๆ ส่วนการมีแต่ระบบเบื้องหลังโดยไม่มีหน้าจอให้คนตรวจ ทำให้ทีมไม่รู้ว่าเกิดอะไรขึ้น
Karthik เล่าว่าทีมตรวจร่องรอยการทำงาน ทดลอง และปรับทีละตัวแปร ก่อนรายงานค่าที่วัดได้สามตัวแยกกันดังนี้
- การยึดตามข้อมูลอ้างอิงสำหรับเอกสาร Markdown เพิ่มจาก 14% เป็น 65%
- การยึดตามข้อมูลอ้างอิงสำหรับ PDF เพิ่มจาก 20% เป็น 74%
- Context precision ในสไลด์เพิ่มจาก 5% เป็น 82% ส่วนข้อความ ASR ที่บันทึกไว้ถอดค่าตั้งต้นเป็น 57% หลักฐานสองส่วนนี้จึงต่างกัน
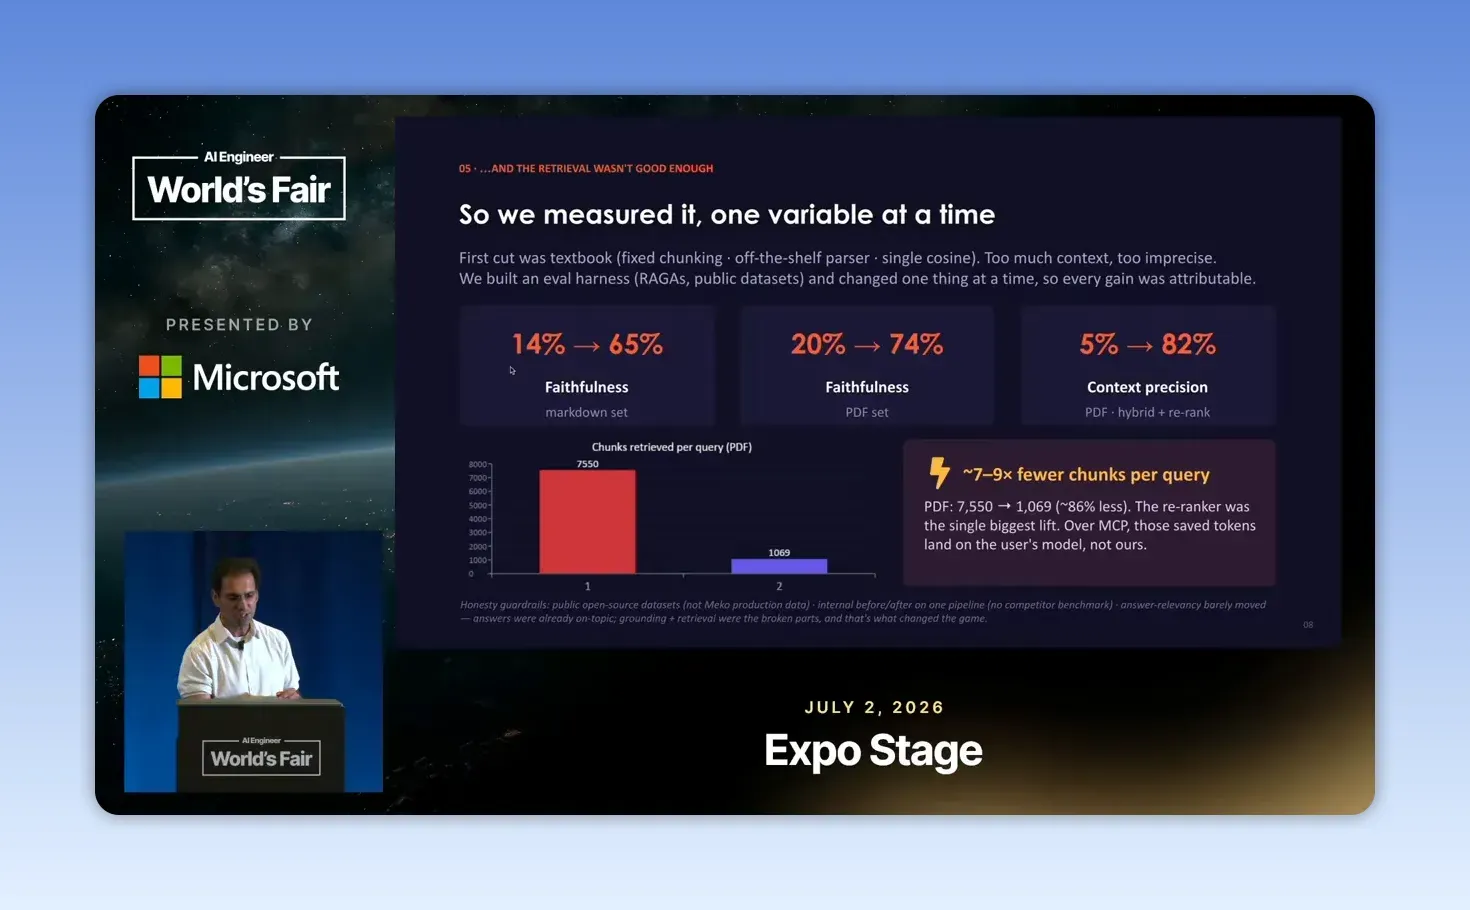
ผู้พูดรายงานว่า จำนวนชิ้นข้อมูลลดจากมากกว่า 7,000 เหลือประมาณ 1,000 หรือราวหนึ่งในเจ็ดของเดิม ขณะที่ค่าที่วัดได้ดีขึ้น ผลนี้เป็นของชุดทดลองที่เล่า ไม่ได้พิสูจน์ว่าข้อมูลน้อยกว่าจะดีกว่าเสมอ
ตัวเลขเหล่านี้เป็นผลทดสอบที่ทีมรายงาน ไม่ใช่คำรับประกันสำหรับทุกธุรกิจ และตัวชี้วัดทั้งสามไม่ควรถูกรวมเป็นเปอร์เซ็นต์ความถูกต้องเดียว หากเราทดลองกับงานบริการลูกค้า ควรวัดแยกว่าคำตอบอ้างอิงหลักฐานได้หรือไม่ และข้อมูลที่ค้นมานั้นเกี่ยวข้องกับคำถามจริงแค่ไหน
เจ้าของธุรกิจไม่จำเป็นต้องลงมือปรับระบบค้นเอง แต่ควรขอให้ทีมทดสอบด้วยคำถามเดิมก่อนและหลังเปลี่ยน พร้อมรายงานข้อผิดพลาด การเปลี่ยนหลายอย่างพร้อมกันจะทำให้รู้ยากว่าอะไรช่วยให้งานดีขึ้น
ทดลองเก็บงานและส่งต่อข้าม AI ด้วย Meko
Meko เป็นชั้นจัดเก็บข้อมูลที่ออกแบบสำหรับ agent โดยรวมข้อมูลหลายประเภทไว้ในชุดที่เรียกว่า data pack ทั้งฐานความรู้ ความจำ การสนทนา และข้อมูลสำหรับตรวจการทำงาน
สำหรับคนทำงาน data pack อาจเข้าใจได้ว่าเป็น “ชุดความรู้ของงานหนึ่ง” จุดสำคัญคือข้อมูลสามารถอยู่ในพื้นที่ส่วนตัวก่อน แล้วค่อยเลื่อนบางส่วนไปให้คนหรือ agent อื่นใช้ ไม่ได้เปิดทั้งหมดทันทีที่เชื่อมต่อ
ทดลองกลับมาทำงานต่อในแชตใหม่
Heather บรรยายการสาธิตที่บันทึกไว้ โดยใช้เหตุการณ์ที่เธอเล่าว่าอีเมลสมัครใช้งานส่งไม่สำเร็จ เพราะระบบส่งอีเมลอยู่ในโหมด sandbox หรือโหมดทดสอบ และเกินข้อจำกัดการส่ง เธออธิบายว่าบันทึกเหตุการณ์ลง data pack สำหรับการเปิดให้ทดลองใช้งาน เหตุการณ์นี้ไม่ได้ถูกตรวจจากบันทึกระบบอีเมลอย่างอิสระในบทความนี้
ในการสาธิตที่ Heather บรรยาย หลังปิดเซสชันแล้วเปิดแชตใหม่ ระบบค้นความจำที่บันทึกไว้และนำข้อเท็จจริงเดิมกลับมา เธอเล่าว่ามีจังหวะที่ agent ค้นก่อนสร้างรายการสนทนาใหม่ จึงต้องให้คำแนะนำเรื่องลำดับเครื่องมือด้วย ผลนี้เป็นตัวอย่างหนึ่งของการกลับมาทำงานต่อ ไม่ใช่คำรับประกันว่าแต่ละการเชื่อมต่อจะทำงานได้เหมือนกัน
การเชื่อมต่อในตัวอย่างใช้ MCP ซึ่งเป็นช่องทางให้ AI เรียกเครื่องมือภายนอก ผู้ที่ต้องการเข้าใจแนวคิดเพิ่มเติมสามารถอ่านคำอธิบาย MCP จากเว็บไซต์โครงการ ส่วนขั้นตอนของผลิตภัณฑ์อยู่ในคู่มือ Meko สำหรับเจ้าของธุรกิจ สิ่งที่ควรตรวจคือเครื่องมือ AI ที่ใช้อยู่เชื่อมต่อได้หรือไม่ และใครเป็นผู้ดูแลสิทธิ์
ทดลองส่งต่อให้ AI อีกตัว
Heather อธิบายว่า เมื่อเปลี่ยนไปใช้ Codex ระบบเห็น data pack ที่เชื่อมต่อ แต่ยังค้นความจำเรื่องอีเมลไม่พบ เพราะรายการนั้นยังเป็นส่วนตัว หลังเลื่อนความจำรายการดังกล่าวเข้าสู่พื้นที่ร่วมแล้วลองถามอีกครั้ง เธอรายงานว่า Codex ดึงมาใช้ได้ ขั้นตอนนี้เป็นผลในเดโมที่เล่า ไม่ใช่การตรวจสิทธิ์ของระบบจริงอย่างอิสระ
การเห็นชุดข้อมูลไม่ได้หมายถึงการมีสิทธิ์อ่านทุกอย่างในชุดนั้น นี่เป็นรายละเอียดสำคัญสำหรับธุรกิจที่ต้องส่งต่อข้อค้นพบ แต่ไม่ต้องการเปิดประวัติการสนทนาทั้งหมดให้ทุกฝ่าย
นำไปใช้กับงานความรู้ ไม่ใช่เฉพาะงานเขียนโค้ด
Karthik เล่าว่าทีมใช้แนวทางเดียวกันเตรียมสไลด์ Heather สร้างโครงเรื่องและแชร์ data pack ให้เขา จากนั้นเขาใช้ Claude Desktop ช่วยแยกประเด็น ปรับโครง และสร้างสไลด์ ก่อนส่งกลับให้ Heather ตรวจให้เข้ากับการสาธิต เป็นวิธีทำงานที่ผู้พูดรายงาน
ตัวอย่างอื่นในคลิป ได้แก่ ชุดข้อมูลแก้ปัญหาการเข้าใช้งาน การร่างอีเมลขอโทษ และชุดข้อมูลสไตล์การเขียนสำหรับโพสต์ LinkedIn สำหรับธุรกิจไทย เราอาจทดลองกับงานเตรียมข้อเสนอ งานสื่อสารลูกค้า หรือคู่มือรับพนักงานใหม่ โดยยังให้คนตรวจข้อเท็จจริงและข้อความก่อนใช้งาน
ตรวจต้นทุนและแยกสิ่งที่ทำได้วันนี้ออกจากคำสัญญาในอนาคต
เหตุผลที่การแชร์ความรู้อาจลด token คือการค้นหาคำตอบครั้งแรกต้องมีการถามตอบและทดลองหลายรอบ แต่ครั้งต่อไป agent สามารถเรียกข้อค้นพบที่บันทึกไว้ แทนการทำกระบวนการเดิมใหม่ทั้งหมด
การเรียกความจำก็ไม่ใช่การใช้งานฟรี และคลิปไม่ได้ให้ตัวเลขประหยัดที่ใช้เป็นเกณฑ์ทั่วไปได้ Heather กล่าวว่าผู้ใช้ตรวจประวัติถึงระดับการเรียกเครื่องมือได้ จึงควรใช้บันทึกเหล่านี้เทียบการค้นซ้ำและ token ที่ใช้จริง
มุมของธุรกิจควรวัด ต้นทุนต่อชิ้นงานที่ผ่านการตรวจรับ ไม่ใช่ดูค่า token เพียงอย่างเดียว หาก token ลดแต่คนต้องแก้คำตอบมากขึ้น ก็ยังสรุปไม่ได้ว่างานคุ้มค่าขึ้น
Heather ยังเสนอว่าการอนุมัติความรู้โดยคนอาจกลายเป็นตัวอย่างสำหรับฝึกระบบให้เลือกข้อมูลที่ควรเก็บได้ดีขึ้นในอนาคต แต่ ณ จุดที่สาธิต คนยังอยู่ในกระบวนการตัดสินใจ การบันทึกความจำไม่ได้พิสูจน์ว่า model เรียนรู้เองหรือถูกฝึกใหม่อัตโนมัติ
ตัวอย่างการต่อยอดที่เล่าคือเมื่อบริการหนึ่งล่ม agent ตัวแรกบันทึกเหตุการณ์ไว้ให้ตัวอื่นรับรู้ เพื่อลดการเรียกตรวจบริการเดิมซ้ำ มุมที่เราควรเพิ่มคือข้อมูลเหตุการณ์ต้องบอกเวลาและสถานะด้วย มิฉะนั้นข้อเท็จจริงที่ถูกต้องเมื่อเช้าอาจกลายเป็นข้อมูลผิดหลังระบบกลับมาทำงานแล้ว
เปลี่ยนแนวคิดเป็นสิ่งที่ลงมือทำได้
- เลือก workflow เดียว: เริ่มจากงานที่ทีมต้องอธิบายหรือค้นคำตอบซ้ำ เช่น การส่งต่อเคสบริการลูกค้า ไม่ต้องเริ่มทั้งองค์กร
- เปลี่ยนบันทึกผลลัพธ์เป็นบันทึกบทเรียน: เก็บข้อสรุป เงื่อนไข วิธีที่ไม่สำเร็จ และหลักฐานต้นทาง
- ตั้งผู้อนุมัติความรู้ส่วนกลาง: ให้ผู้รับผิดชอบงานตรวจข้อค้นพบก่อนเปิดให้ทีมและ AI ตัวอื่นใช้
- ทดสอบสองสถานการณ์: ปิดแชตแล้วกลับมาถามใหม่ จากนั้นลองส่งต่อให้ AI อีกตัวโดยใช้ข้อมูลที่อนุมัติแล้ว
- เปรียบเทียบงานก่อนและหลัง: บันทึก token เวลา และจำนวนรอบแก้ไข ด้วยงานชนิดเดียวกันก่อนขยายการใช้งาน
จุดเริ่มต้นไม่จำเป็นต้องเป็น Meko ขณะบรรยายทีมกล่าวว่ามีระดับใช้งานฟรี หากสนใจทดลองควรตรวจเงื่อนไขของผลิตภัณฑ์อีกครั้ง คำกล่าวนี้ไม่ใช่การยืนยันราคาและสิทธิ์ใช้งานปัจจุบันของบทความ
แก้ปัญหาที่พบบ่อยระหว่างทดลอง
ปัญหา: เปิดแชตใหม่แล้ว AI จำงานเดิมไม่ได้
- สิ่งที่ควรตรวจ: ข้อมูลอาจยังอยู่เฉพาะเซสชันเดิม หรือยังไม่ได้บันทึกลง data pack
- แนวทางทดสอบ: ตรวจว่ามีรายการความจำที่บันทึกสำเร็จ ตรวจบัญชีและการเชื่อมต่อ แล้วทดสอบค้นข้อเท็จจริงเฉพาะหนึ่งเรื่อง
ปัญหา: AI อีกตัวเห็น data pack แต่ค้นคำตอบไม่พบ
- สิ่งที่ควรตรวจ: ความจำอาจยังเป็นส่วนตัว แม้ชุดข้อมูลจะเชื่อมต่อแล้ว
- แนวทางทดสอบ: ตรวจสิทธิ์ของผู้รับ เลือกข้อมูลที่ต้องการส่งต่อ อนุมัติเข้าพื้นที่ร่วม แล้วถามคำถามเดิมอีกครั้ง
ปัญหา: ระบบเรียกเครื่องมือผิดลำดับ
- สิ่งที่ควรตรวจ: ในการสาธิต agent พยายามค้นก่อนสร้างรายการสนทนาใหม่ จึงต้องได้รับคำแนะนำให้ทำตามลำดับที่ระบบต้องการ
- แนวทางทดสอบ: ตรวจคำแนะนำการใช้งานเครื่องมือให้ชัด และให้ผู้ดูแลดูประวัติการเรียกเครื่องมือว่าติดตรงขั้นตอนไหน
ปัญหา: เก็บข้อมูลมากขึ้น แต่คำตอบกลับแย่ลง
- สิ่งที่ควรตรวจ: ข้อมูลดิบ ข้อสันนิษฐาน และข้อสรุปที่ยกเลิกอาจถูกค้นมาปะปนกัน
- แนวทางทดสอบ: แยกความรู้ที่ผ่านการอนุมัติออกจากประวัติดิบ ทดสอบด้วยคำถามเดิม และปรับทีละตัวแปร
ปัญหา: ยังไม่รู้ว่าประหยัด token จริงหรือไม่
- สิ่งที่ควรตรวจ: ไม่มีค่าก่อนทดลอง หรือเปรียบเทียบงานที่ความยากต่างกัน
- แนวทางทดสอบ: ใช้งานชนิดเดียวกัน ตรวจจำนวนการเรียกเครื่องมือและ token แล้วรวมเวลาที่คนใช้ตรวจแก้ก่อนสรุปผล
ต่อยอดจากความจำร่วมสู่ความรู้ขององค์กร
เมื่อ workflow แรกผ่านการทดสอบแล้ว การขยายควรเริ่มจากงานที่ใช้ความรู้ซ้ำสูง ไม่ใช่เพิ่มจำนวน agent เพื่อให้ระบบดูใหญ่ขึ้น
- สร้างชุดความรู้รับพนักงานใหม่: รวมประวัติการตัดสินใจ ข้อจำกัด และแนวทางที่ทีมรับรอง เพื่อให้ทั้งคนและ AI เริ่มงานจากฐานเดียวกัน
- สร้างชุดข้อมูลน้ำเสียงของแบรนด์: เก็บตัวอย่างที่ผ่านการตรวจแล้วสำหรับอีเมลและโพสต์ แยกจากข้อเท็จจริงของแต่ละงาน
- เชื่อมบทเรียนจากเหตุขัดข้อง: ให้ข้อค้นพบของผู้แก้ปัญหารายแรกช่วยงานฝ่ายอื่น โดยมีผู้ตรวจและสถานะที่อัปเดตได้
บทเรียนหลักของ AI Agent ไม่ใช่การทำให้แต่ละตัวจำทุกอย่าง แต่คือการทำให้ทีมไม่ต้องเรียนเรื่องเดิมซ้ำ เมื่อ context ถูกคัดเลือก มีผู้รับรอง แชร์ตามสิทธิ์ และย้อนกลับไปหาต้นทางได้ ความจำจึงเริ่มเปลี่ยนจากประวัติการสนทนาเป็นความรู้ขององค์กร การเริ่มจากงานเล็กหนึ่งงานและวัดผลให้ชัด ย่อมมีน้ำหนักกว่าการเพิ่ม AI หลายตัวโดยยังส่งต่อความรู้ไม่เป็น
ที่มา: Agent Memory Is Solved. Agent Learning Isn't. · Karthik Ranganathan, Yugabyte บนช่อง AI Engineer วิดีโอเผยแพร่วันที่ 5 ตุลาคม 2569 สรุปจาก transcript ที่บันทึกไว้ช่วง 00:01–20:33 ผลและตัวเลขเป็นสิ่งที่ผู้พูดรายงานในเวลานั้น ตัวอย่างธุรกิจและแนวทางทดลองเป็นข้อเสนอของ VibeSolo ให้นำไปทดสอบกับงานจริง
