

เรียบเรียงจากบทความ VideoToBlog วันที่ 5 เมษายน 2026 เกี่ยวกับ Obsidian และ Claude Code วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่การยืนยันวันเผยแพร่วิดีโอ ต้นทางไม่มี iframe หรือลิงก์วิดีโอที่ยืนยันตัวตนได้ จึงอ้างอิงหน้าบทความโดยไม่เพิ่มวิดีโออื่นแทน การเปรียบเทียบ LLM Wiki กับ RAG เป็นกรอบคิดในต้นทาง ไม่ใช่ผลทดสอบว่าแนวทางใดแม่นกว่า เร็วกว่า หรือประหยัดกว่าในทุกงาน ข้อความ 95% cheaper บนภาพปกเป็นคำโฆษณาในภาพต้นทางและไม่ได้รับการตรวจยืนยัน ภาพเอกสารระบุชื่อ CLAUDE.md สำหรับ Claude Code ขณะที่เนื้อหาเดิมใช้คำว่า cloud.md ซึ่งคงไว้ตามต้นทาง ควรเริ่มใน vault ทดลอง สำรองไฟล์ ตรวจสิทธิ์ของเอกสาร และกำหนดขอบเขตการเขียนไฟล์ให้ชัด ภาพที่เปิดโหมดข้ามการขออนุญาตไม่ใช่คำแนะนำให้ปิดการควบคุมความปลอดภัย · แหล่งอ้างอิงในบทความต้นทาง
ความรู้จากแชทแบบเดิมหายไปหลังจบการสนทนา แต่แนวคิด “LLM knowledge base” ทำให้ความรู้สะสมและต่อยอดได้เหมือนดอกเบี้ยทบต้น โดยย้ายแกนจาก “คำตอบชั่วคราว” ไปสู่ “โครงสร้างความรู้ที่ค้นหาได้” แนวทางนี้ได้รับความสนใจอย่างมากจากวิธีของ Andrej Karpathy ที่พยายามทำให้คลังความรู้ขับเคลื่อนด้วย LLM โดยใช้เพียง Markdown และระบบอัตโนมัติในการจัดหมวดหมู่และสร้างลิงก์เชิงสัมพันธ์
บทความนี้จะอธิบายทั้งแนวคิดและวิธีคิดแบบใช้งานได้จริง สำหรับคนที่อยากทำ knowledge base ของตัวเอง ด้วย Obsidian เป็นหน้าแสดงผล และ Claude Code เป็นตัวช่วย “อ่านแล้วจัดโครง” รวมถึงชี้ให้เห็นว่าแนวทางนี้เทียบกับ RAG แบบเดิมอย่างไร และควรระวังอะไรบ้าง
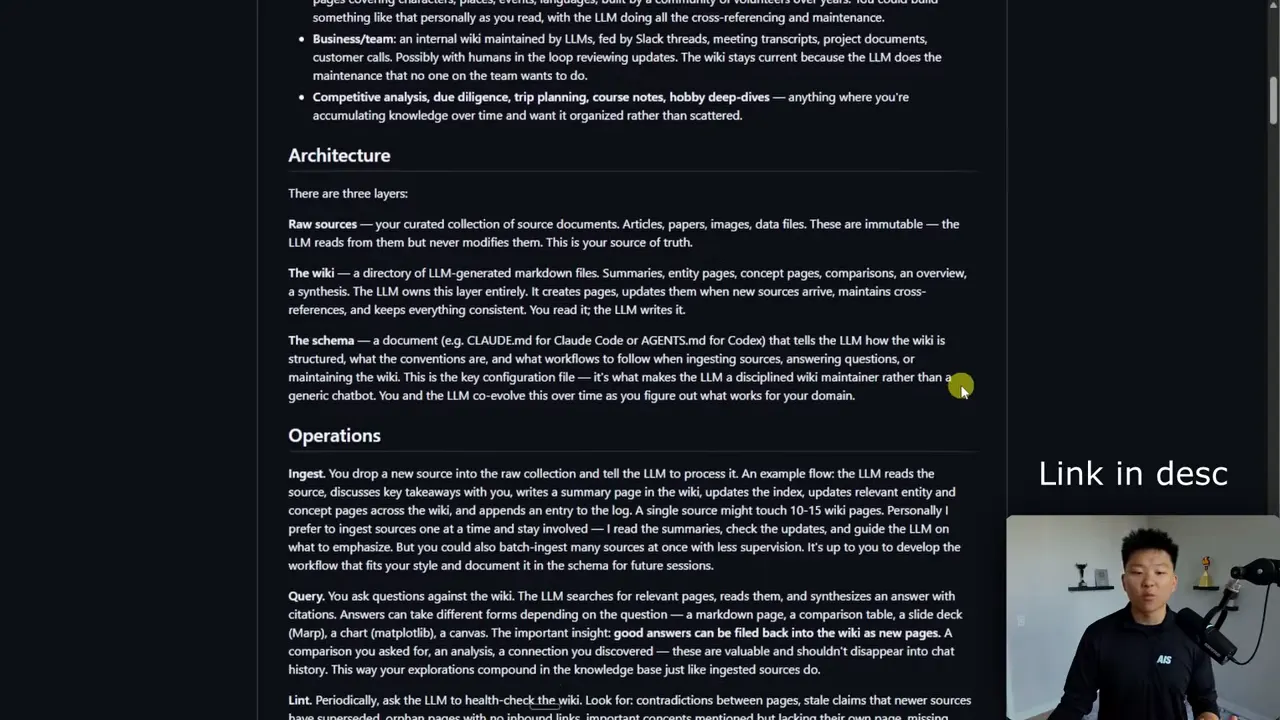
ภาพรวมการตั้งค่า: ใช้ Obsidian เป็น vault และให้ Claude Code สร้างโฟลเดอร์ raw/wiki พร้อมไฟล์ index และ log เพื่อให้ระบบรู้ว่าควรค้นหาและอัปเดตอย่างไร
LLM knowledge base คืออะไร และทำไมถึง “ต่าง” จากการคุยแชท
ปัญหาหลักของแชทกับ LLM คือธรรมชาติของมันมักเป็นแบบ ชั่วคราว ข้อมูลใหม่อาจถูก “ลืม” เมื่อจบบทสนทนา หรือแม้จะมีการอ้างอิงย้อนหลัง แต่ก็ต้องดึงบริบทเข้ามาใหม่ทุกครั้ง
แนวทาง LLM knowledge base พยายามทำให้ “ความรู้” ถูกเก็บไว้ในระบบถาวร และถูกจัดความสัมพันธ์ให้ค้นหาได้ เช่น
- นำเข้า (ingest) ข้อมูลต้นทาง เช่น PDF หรือบทความ
- จัด chunk และสรุป เป็นหลายไฟล์/หลายหน้าภายในคลัง
- สร้างดัชนี (index) และบันทึกการทำงาน (log) เพื่อให้การเพิ่มข้อมูลรอบถัดไปไม่เริ่มจากศูนย์
- เชื่อมโยงความสัมพันธ์ ด้วยลิงก์ภายในคลังความรู้ ทำให้การเดินเรื่องและการตอบคำถามลึกขึ้น
ผลลัพธ์ที่ได้ไม่ใช่แค่ “เอกสารรวม ๆ” แต่เป็น knowledge map ที่มีโครงสร้างและความสัมพันธ์ระหว่างแนวคิด เครื่องมือ คน บทความ และหัวข้อย่อย
สถาปัตยกรรมแบบมาร์กดาวน์: raw, wiki, index, log
หัวใจของแนวคิดนี้คือการสร้างคลังความรู้จาก โฟลเดอร์ Markdown โดยแยกพื้นที่จัดเก็บเป็นอย่างน้อย 2 ส่วน
- raw: เก็บเอกสารต้นทาง (เช่นบทความที่เก็บมาเป็นไฟล์ หรือข้อความดิบ)
- wiki: ที่ Claude Code ไปประมวลผลแล้วสร้างหน้าความรู้ (หลายไฟล์) พร้อมลิงก์เชิงสัมพันธ์
นอกจากนี้ยังมีชิ้นส่วนสำคัญที่ทำให้ระบบ “ใช้งานจริง”:
- index: สารบัญและแผนที่การค้นหา (มักเป็นรายการหัวข้อ คน เครื่องมือ เทคนิค และลิงก์ไปยังหน้าที่เกี่ยวข้อง)
- log: ประวัติการอัปเดตหรือการรันงาน เพื่อรองรับการเพิ่มข้อมูลภายหลังแบบเป็นรอบ
- cloud.md (หรือไฟล์อธิบายโครงสร้าง): เอกสารที่บอกระบบว่าคลังนี้ทำงานอย่างไร ควรค้นจากตรงไหน และอัปเดตอย่างไร
สิ่งที่น่าสนใจคือระบบไม่ต้องพึ่ง “โครงสร้างพื้นฐานที่ซับซ้อน” แบบฐานข้อมูลเวกเตอร์เสมอไป การจัดการจำนวนมากเกิดจากการที่ LLM อ่านไฟล์และเขียนไฟล์ใหม่ให้เราในรูปแบบ Markdown ที่ค้นหาและเชื่อมต่อได้
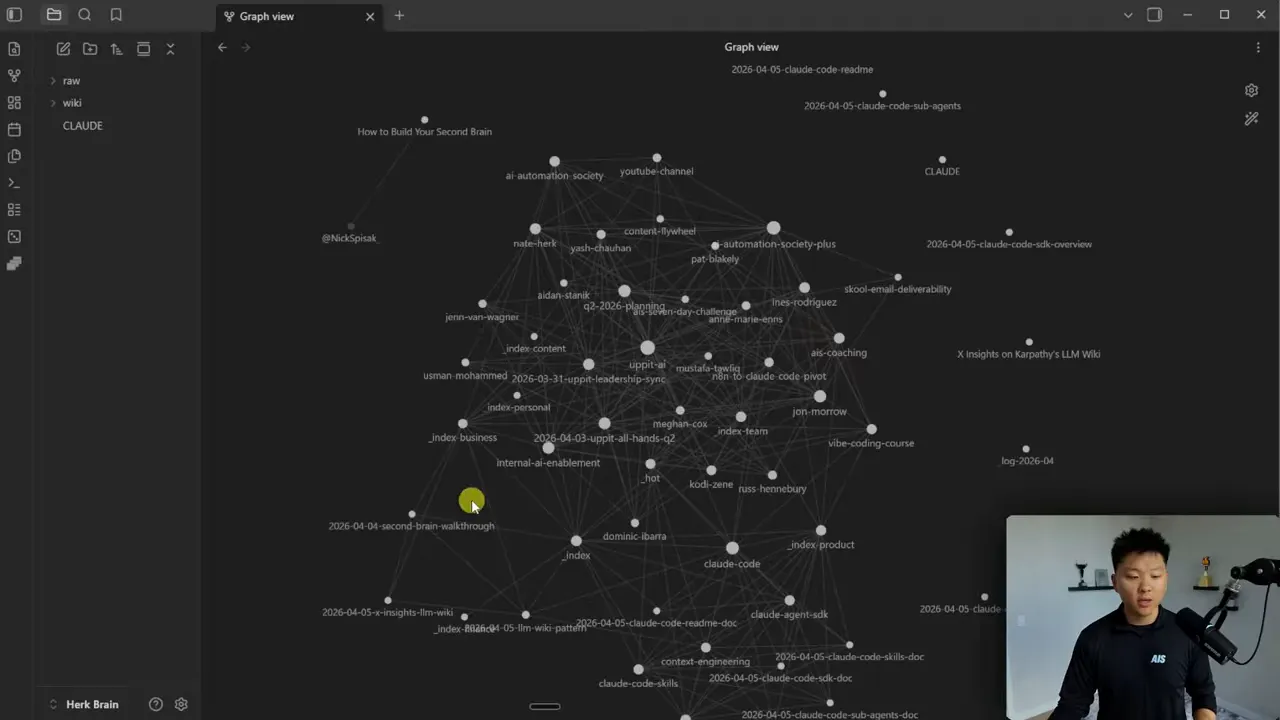
ภาพตัวอย่างโครงสร้าง vault: สร้าง vault ใน Obsidian แล้วเปิดโฟลเดอร์ให้ Claude Code ทำงานเพื่อสร้าง raw/wiki และไฟล์ระบบอย่าง index และ log
ตั้งค่าได้เร็วจริงไหม? ขั้นตอนเริ่มต้นที่ทำตามได้
แนวคิดนี้ถูกออกแบบให้เริ่มได้แบบรวดเร็ว สำหรับการใช้งานจริง เราสามารถเริ่มจากลูปพื้นฐาน 3 ขั้น
- เตรียม Obsidian vault สร้าง vault ใหม่ตั้งชื่อที่ต้องการ แล้วเก็บไว้ในโฟลเดอร์ที่ Claude Code เข้าถึงได้
- ให้ Claude Code “สร้างโครง” ตามแบบแผนของแนวคิด LLM Wiki โดยใช้พรอมต์ (prompt) ที่สั่งให้เป็นตัว “LLM wiki agent” ให้ทำงานกับ vault นั้น
- นำเข้าเอกสารชิ้นแรก วางไว้ในโฟลเดอร์ raw แล้วสั่งให้ระบบ ingest เพื่อสร้างหน้าความรู้ใน wiki
เพื่อให้คล่องตัว โดยเฉพาะบทความจากเว็บ สามารถใช้ส่วนเสริมของ Obsidian เช่น Web Clipper เพื่อเก็บบทความลง vault ได้โดยตรง และกำหนดให้ไปอยู่ในโฟลเดอร์ raw
เมื่อเริ่ม ingest ระบบจะทำงานหลายอย่าง เช่น อ่านเนื้อหา แยกส่วนเป็นหัวข้อย่อย สรุปประเด็นสำคัญ และจัดความสัมพันธ์ระหว่างส่วนเหล่านั้น แล้วเขียนผลลัพธ์กลับเข้าไปเป็น Markdown pages ภายใน wiki
ยิ่งเติมมาก ยิ่งเห็น “แพตเทิร์น”: ความรู้เชื่อมโยงกันได้อย่างไร
ความคุ้มค่าของคลังความรู้แบบนี้เริ่มชัดขึ้นเมื่อมีหลายเอกสาร ระบบจะเริ่มสร้าง “hub” และ “node” ของความคิด เช่น
- หน้าที่เป็นศูนย์กลางของหัวข้อใหญ่
- ความสัมพันธ์ข้ามบทความ เช่น เครื่องมือหนึ่งถูกกล่าวถึงในบริบทของหลายแนวคิด
- การสรุปแท็กและเมตาดาต้าบนหน้าเอกสาร เพื่อให้ค้นหาง่ายขึ้น
แนวคิดสำคัญคือความสัมพันธ์ไม่ได้ถูกสร้างแบบ “เดาจากความคล้ายเชิงเวกเตอร์” เท่านั้น แต่ยังเกิดจากการที่ระบบจัดลิงก์และโครงสร้างภายในคลัง ทำให้การเดินเรื่องเป็นธรรมชาติและตรวจสอบได้
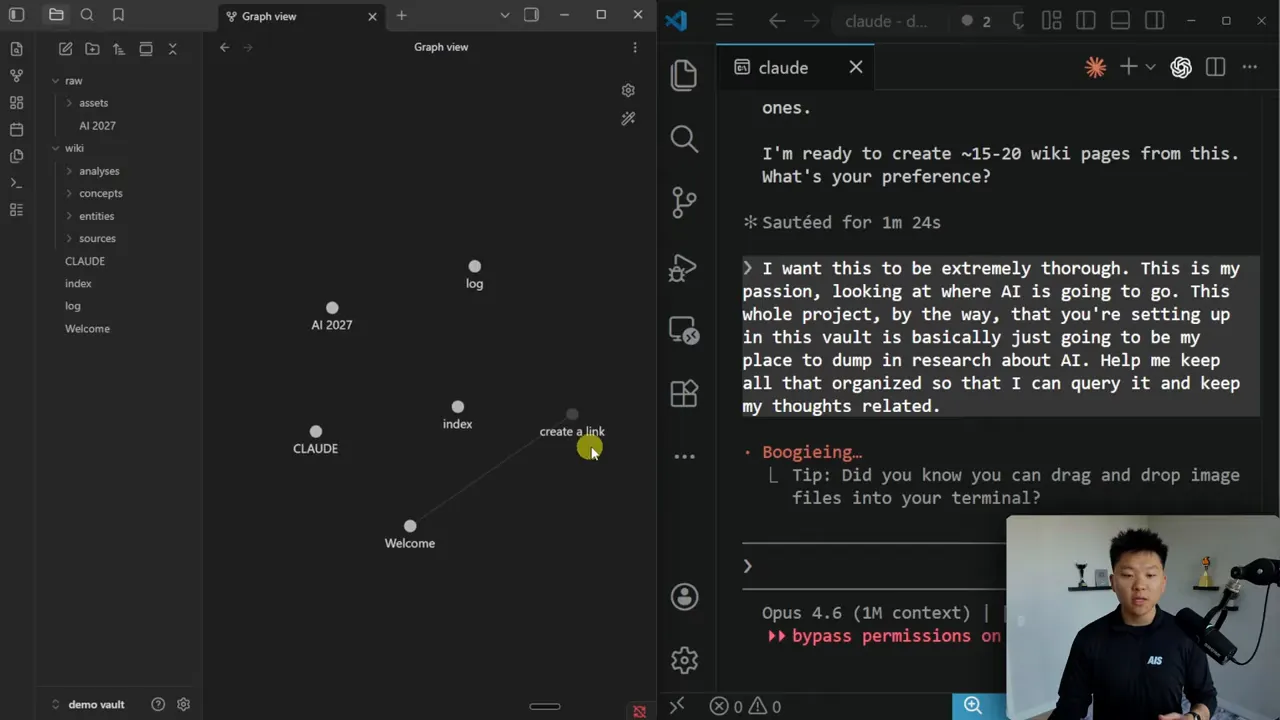
ภาพจากการ ingest จำนวนมาก: โหมดกราฟช่วยให้เห็นว่าบางหัวข้อกลายเป็นศูนย์กลางและมีความสัมพันธ์กับส่วนอื่นอย่างไร
Query และการใช้งานหลายโปรเจกต์: เอาคลังเดียวไปใช้กับงานอื่นได้
หลังจากคลัง wiki เริ่มมีเนื้อหา สามารถใช้งานได้หลายรูปแบบ ขึ้นกับเป้าหมาย
- ถามคำถามภายในคลัง เพื่อหาคำตอบเกี่ยวกับเอกสารที่จัดเก็บไว้
- เชื่อมคลังกับระบบอื่น เช่น กำหนดให้ agent อื่นอ่าน index แล้วเลือกหน้าที่จำเป็น ไม่ต้องอ่านทั้งหมด
- ทำให้คลังเป็น context source สำหรับงานเฉพาะทาง เช่น executive assistant หรือระบบสรุปข่าวงานธุรกิจ
จุดที่ควรสังเกตคือระบบสามารถช่วยลดการสิ้นเปลืองโทเค็นโดยใช้ “ไฟล์แคช” (เช่น hot cache ที่เก็บบริบทสั้น ๆ ของเรื่องที่อัปเดตบ่อย) แทนที่จะต้องวนอ่านทุกหน้าทุกครั้ง โดยแนวคิดนี้จะเหมาะเมื่อโปรเจกต์ต้องตอบคำถามที่เปลี่ยนเร็ว
LLM Wiki vs Semantic Search RAG: ควรเลือกแบบไหน
คำถามที่หลายคนถามคือ วิธีนี้ “ฆ่า” RAG แบบเดิมหรือไม่ คำตอบคือขึ้นกับเป้าหมายและสเกลของงาน
ความแตกต่างหลัก
- LLM Wiki: อ่านและจัดโครงด้วย Markdown เป็นหลัก ใช้ index และ ลิงก์ ในคลังเพื่อตอบและเชื่อมความสัมพันธ์
- Semantic Search RAG: ใช้การ chunk และสร้าง embeddings แล้วค้นด้วยความใกล้เคียง จากนั้นจึงนำชิ้นส่วนที่เกี่ยวข้องเข้าสู่โมเดลเพื่อสร้างคำตอบ
ข้อดีที่เด่นของ LLM Wiki
- โครงสร้างความสัมพันธ์ลึกกว่า เพราะการเชื่อมเกิดจากลิงก์ในคลัง ไม่ใช่แค่ความคล้ายเชิงเวกเตอร์
- ต้นทุนด้านโครงสร้างพื้นฐานต่ำ เพราะเป็นโฟลเดอร์ Markdown ที่ดูแลได้ง่าย
- การอัปเดตแบบสะสม ลดการ re-embed เมื่อเนื้อหาเปลี่ยน (ในเชิงแนวคิดระบบเน้นการจัดทำไฟล์ในคลัง)
ข้อจำกัดที่ต้องยอมรับ
- การสเกลข้ามองค์กรอาจยาก เพราะไฟล์จำนวนมหาศาลและการรักษาคุณภาพ index ต้องอาศัยวินัยการจัดการ
- เมื่อเอกสารมีขนาดระดับ “หลายล้าน” วิธีแบบไฟล์ล้วน ๆ อาจไม่เหมาะเท่ากับ pipeline แบบดั้งเดิมหรือระบบความรู้เฉพาะทาง
ดังนั้นถ้าเรามีจำนวนเอกสารไม่ใหญ่มาก แต่ต้องการ ความเข้าใจเชิงความสัมพันธ์ และความสามารถในการตรวจสอบย้อนกลับ ระบบแบบ LLM Wiki มักตอบโจทย์ได้ดี
แนวทางการบำรุงรักษา: index, linting และการเติมช่องว่างความรู้
สิ่งที่ทำให้คลังความรู้ “อยู่รอดระยะยาว” คือการบำรุงรักษาเป็นรอบ
- เพิ่มเอกสารใหม่ โดยให้ระบบ ingest แล้วอัปเดต index กับ log
- ตรวจความสอดคล้อง ด้วยแนวคิด “linting” หรือการให้ LLM ทำ health checks กับคลัง เช่น
- ค้นหาข้อมูลที่ไม่สอดคล้อง
- เติมช่องว่างด้วยการค้นข้อมูลเพิ่ม
- ชี้ว่าเอกสารใหม่ควรเติมส่วนไหนเพื่อทำให้ความสัมพันธ์แน่นขึ้น
มุมมองเชิงปฏิบัติคือ ถ้าคลังเติบโตแบบไม่มีระบบตรวจสอบ โครงสร้างจะเริ่มรกและคุณภาพความสัมพันธ์อาจลดลง การทำ linting เป็นรอบจะช่วยให้คลังยัง “เชื่อถือได้”
ข้อผิดพลาดที่พบบ่อยและวิธีเลี่ยง
1) เริ่มด้วยโครงสร้างซับซ้อนเกินจำเป็น
บางครั้งคลังแบบ flat (ไม่ต้องแบ่งย่อยเยอะ) ทำงานได้ดี โดยเฉพาะช่วงเริ่มต้น ขณะเดียวกันบางโปรเจกต์ก็ต้องการโครงแบบย่อยเพื่อรองรับบริบทเฉพาะ
2) ลืมกำหนด “บริบทของคลัง”
ตอน ingest ควรให้บริบทว่าคลังนี้ทำเพื่ออะไร เช่น โปรเจกต์ส่วนตัว งานธุรกิจ หรือหัวข้อวิจัยเฉพาะทาง การสื่อเป้าหมายชัดจะช่วยให้ระบบจัดหน้าและสรุปตามแนวทางที่ต้องการมากขึ้น
3) ไม่ดู index และการเชื่อมโยง
บางคนจบที่ “เอาไฟล์เข้าแล้ว” แต่ถ้า index ไม่สะท้อนสิ่งที่ต้องค้นจริง การใช้งานในภายหลังจะช้าหรือพลาด ในทางกลับกันถ้า index ดี จะค้นง่ายและประหยัดโทเค็น
4) หวังให้มันสเกลได้ทุกกรณี
เมื่อข้อมูลจำนวนมหาศาล การเลือกสถาปัตยกรรมที่เหมาะกับขนาดเป็นสิ่งสำคัญ ถ้าเอกสารอยู่ระดับ “หลายล้าน” ควรวางแผนระบบค้นหาแบบดั้งเดิมหรือระบบความรู้ที่ออกแบบเพื่อสเกล
คำศัพท์เฉพาะทางที่น่าสนใจ
- LLM: โมเดลภาษาขนาดใหญ่ (เช่นที่ใช้สร้างสรุปและจัดโครงเอกสาร)
- Knowledge base: คลังความรู้ที่จัดเก็บและค้นหาได้ ไม่ใช่แค่คำตอบจากแชท
- Ingest: ขั้นตอนนำข้อมูลต้นทางเข้าสู่ระบบเพื่อประมวลผลเป็นความรู้
- Index: ดัชนีหรือสารบัญสำหรับค้นหาและชี้ไปยังหน้าที่เกี่ยวข้อง
- Log: บันทึกประวัติการทำงาน เช่น ingest รอบไหน สร้างอะไรไว้บ้าง
- RAG (Retrieval-Augmented Generation): วิธีตอบคำถามที่ดึงข้อมูลที่เกี่ยวข้องมาให้โมเดลก่อนสรุปคำตอบ
- Semantic search: การค้นด้วยความหมาย โดยอาศัยการแปลงข้อความเป็นเวกเตอร์
- Embeddings: การแทนข้อความด้วยเวกเตอร์เพื่อใช้หาความใกล้เคียงทางความหมาย
- Vector database: ฐานข้อมูลเวกเตอร์สำหรับค้น similarity
- Hot cache: แคชบริบทสั้น ๆ ที่อัปเดตบ่อยเพื่อประหยัดการดึงข้อมูลจากหลายหน้า
- Linting: การตรวจสุขภาพของคลังความรู้ เช่น ความสอดคล้อง ความครบถ้วน และจุดที่ควรเติมข้อมูล
บทสรุป
แนวคิด LLM knowledge base ที่สร้างจาก Obsidian vault + Markdown + Claude Code ไม่ได้พยายามแทนที่การค้นแบบ semantic search ทั้งหมด แต่เสนอ “ทางเลือกที่เน้นความสัมพันธ์และความคงอยู่ของความรู้” ด้วยโครงสร้างที่ตรวจสอบได้ผ่านไฟล์และลิงก์ในคลัง
มุมมองที่คมชัดคือ หากงานของเราต้องการ ต่อยอดจากเอกสารหลายชิ้น และอยากให้ LLM เชื่อมโยงแนวคิดเป็นเครือข่าย การทำ LLM Wiki มักให้ประโยชน์สูงกว่าการพึ่ง RAG อย่างเดียว โดยเฉพาะเมื่อเอกสารยังอยู่ในขนาดที่ควบคุมคุณภาพด้วย index และ linting ได้
แนวทางนี้จึงเหมาะกับการสร้าง “สมองที่สอง” หรือคลังวิจัยเฉพาะทาง ที่ไม่เพียงเก็บข้อมูล แต่ทำให้ความรู้ สะสมและไหลลื่น ไปสู่คำตอบที่แม่นขึ้นเมื่อเพิ่มข้อมูลต่อเนื่อง
