

AI เริ่มตอบช้า คำตอบไหลสะดุด หรือเร็วตอนทดสอบคนเดียวแต่ช้าลงเมื่อมีคนใช้พร้อมกัน อาจเป็นปัญหาคนละจุด การดูเพียงชื่อโมเดลหรือจำนวน GPU จึงยังไม่พอจะอธิบายสิ่งที่เกิดขึ้น
Charles Frye จาก Modal อธิบายระบบเบื้องหลังนี้ใน What Is an Inference Engine, Anyway? ของช่อง AI Engineer โดยไล่ตั้งแต่ชนิดของงาน เส้นทางคำขอ การจัดคิว ไปจนถึงการวัดผลเมื่อใช้งานจริง บทความนี้สรุปแนวคิดจากเวิร์กช็อป ไม่ใช่ผลเปรียบเทียบ engine หรือคำรับรองความเร็วของผู้ให้บริการรายใด
สารบัญ
- แยกโมเดล Engine และ Server
- งานสามแบบต้องการความเร็วต่างกัน
- Prefill กับ Decode: แยกช่วงก่อนตอบและช่วงสร้างคำตอบ
- เส้นทางคำขอและหน้าที่ของ Scheduler
- สามเทคนิคที่ช่วยลดงานซ้ำและการรอ
- ตัวอย่างป้ายงานศิลปะ: เมื่อโหลดเพิ่มจนเกิดคิว
- วัดทั้งความเร็วและความถูกต้องบนระบบที่ใช้จริง
- เริ่มประเมินระบบจากงานของตัวเอง
แยกโมเดล Engine และ Server
การฝึกโมเดลสร้างความสามารถในการประมวลผล ส่วน inference คือการนำโมเดลที่ฝึกแล้วมาใช้กับข้อมูลใหม่ เช่น รับคำถามแล้วสร้างคำตอบ หรือรับภาพแล้วสร้างคำอธิบาย
Inference engine คือซอฟต์แวร์ที่จัดการการประมวลผลนั้น รวมถึงคิวคำขอ หน่วยความจำ การรวมงานเป็นชุด และการส่งงานไปยังตัวเร่งการคำนวณอย่าง GPU Frye ยก SGLang, vLLM และ TensorRT-LLM เป็นตัวอย่าง
ส่วน inference server ครอบชั้นรับส่งคำขอผ่านเครือข่ายเพิ่มเข้ามา ผลิตภัณฑ์เดียวอาจมีทั้งสองส่วน จึงไม่จำเป็นต้องเป็นระบบคนละตัว แต่การแยกหน้าที่ช่วยให้ถามได้ตรงขึ้นว่าความช้าเกิดในส่วนรับคำขอ การเตรียมข้อมูล หรือการรันโมเดล
Frye ใช้มุมธุรกิจว่าการฝึกเป็นศูนย์ต้นทุน ส่วน inference เป็นจุดที่ผู้ให้บริการขายผลลัพธ์ได้ นี่เป็นกรอบมองของผู้ให้บริการโมเดล สำหรับองค์กรที่ใช้ AI ภายใน ค่า inference ยังเป็นต้นทุนที่ต้องเทียบกับประโยชน์ของงานที่ทำได้
งานสามแบบต้องการความเร็วต่างกัน
Frye แบ่งงานหลักออกเป็นสามกลุ่ม แม้หน้าตาการเรียก API จะคล้ายกัน:
- แชตบอตที่เรียกเครื่องมือได้: มีคนรอและโต้ตอบอยู่ปลายทาง จึงต้องสนใจทั้งเวลาเริ่มตอบและความต่อเนื่องของคำตอบ
- เอเจนต์เบื้องหลัง: อาจทำงานคล้ายผู้ช่วยแบบโต้ตอบ แต่มีเวลาทำงานเป็นนาทีหรือมากกว่านั้นตามเป้าหมาย ผู้ใช้ไม่ได้รออ่านทุกโทเคน
- ระบบประมวลผลข้อมูล: เช่น แปลงเอกสารเป็นข้อมูลมีโครงสร้าง มักรับข้อมูลขาเข้ามากและให้ผลลัพธ์สั้นกว่า งานจำนวนมากอาจให้ความสำคัญกับปริมาณที่ทำเสร็จในเวลาที่กำหนด
การแบ่งนี้เป็นกรอบอธิบายลักษณะงาน ไม่ใช่กฎตายตัวของทุกแอป จุดสำคัญคือกำหนดเป้าหมายจากสิ่งที่ผู้ใช้ต้องการ แทนการใช้ตัวเลขความเร็วเดียวตัดสินทุกระบบ
Prefill กับ Decode: แยกช่วงก่อนตอบและช่วงสร้างคำตอบ
Prefill คือช่วงประมวลผลโทเคนขาเข้า ส่วน decode คือช่วงสร้างโทเคนขาออกต่อเนื่อง โดยทั่วไปเป็นการทำงานตามลำดับ แม้ผู้ใช้จะเห็นเป็นคำขอเดียว แต่ภาระคำนวณและวิธีจัดงานของสองช่วงต่างกัน
ตัวเลขที่ควรอ่านร่วมกันมีอย่างน้อยสี่กลุ่ม:
- Time to first token หรือ TTFT: เวลาตั้งแต่ส่งคำขอจนเริ่มได้รับโทเคนคำตอบแรก
- Inter-token latency: ช่วงเวลาระหว่างโทเคนขาออก บอกว่าคำตอบไหลต่อเนื่องแค่ไหน
- Throughput: จำนวนคำขอหรือโทเคนที่ระบบทำได้ต่อหน่วยเวลา โดยต้องระบุให้ชัดว่ากำลังวัดอะไร
- ความยาวอินพุตและเอาต์พุต: ใช้แยกว่าภาระงานอยู่ตรงช่วงอ่านหรือช่วงสร้างคำตอบมากเพียงใด
TTFT ไม่ใช่เวลาที่ tokenizer ใช้แปลงข้อความขาเข้าอย่างเดียว Frye อธิบายว่าเอกสารยาวอาจทำให้ช่วง prefill ใช้เวลามากขึ้น และอาจเจอเวลารอคิวเพิ่มด้วย จึงยังสรุปไม่ได้ว่าตัวแปลงข้อความเป็นโทเคนเป็นสาเหตุ เพียงเพราะคำตอบแรกมาช้า
เส้นทางคำขอและหน้าที่ของ Scheduler
ภาพรวมที่ Frye ใช้อธิบาย โดยมี SGLang เป็นตัวอย่างหลัก แบ่งการทำงานได้ดังนี้:
- ส่วนรับส่งข้อมูลรับคำขอจากภายนอก
- ส่วนเตรียมข้อมูลแปลงข้อความ ภาพ หรืออินพุตอื่นให้อยู่ในรูปที่โมเดลใช้ได้
- Scheduler ประเมินทรัพยากร จัดคิว และรวมคำขอเป็นชุด
- Model runner สั่งการประมวลผลบน GPU
- ส่วนแปลงผลลัพธ์และ detokenizer เตรียมคำตอบเพื่อส่งกลับ
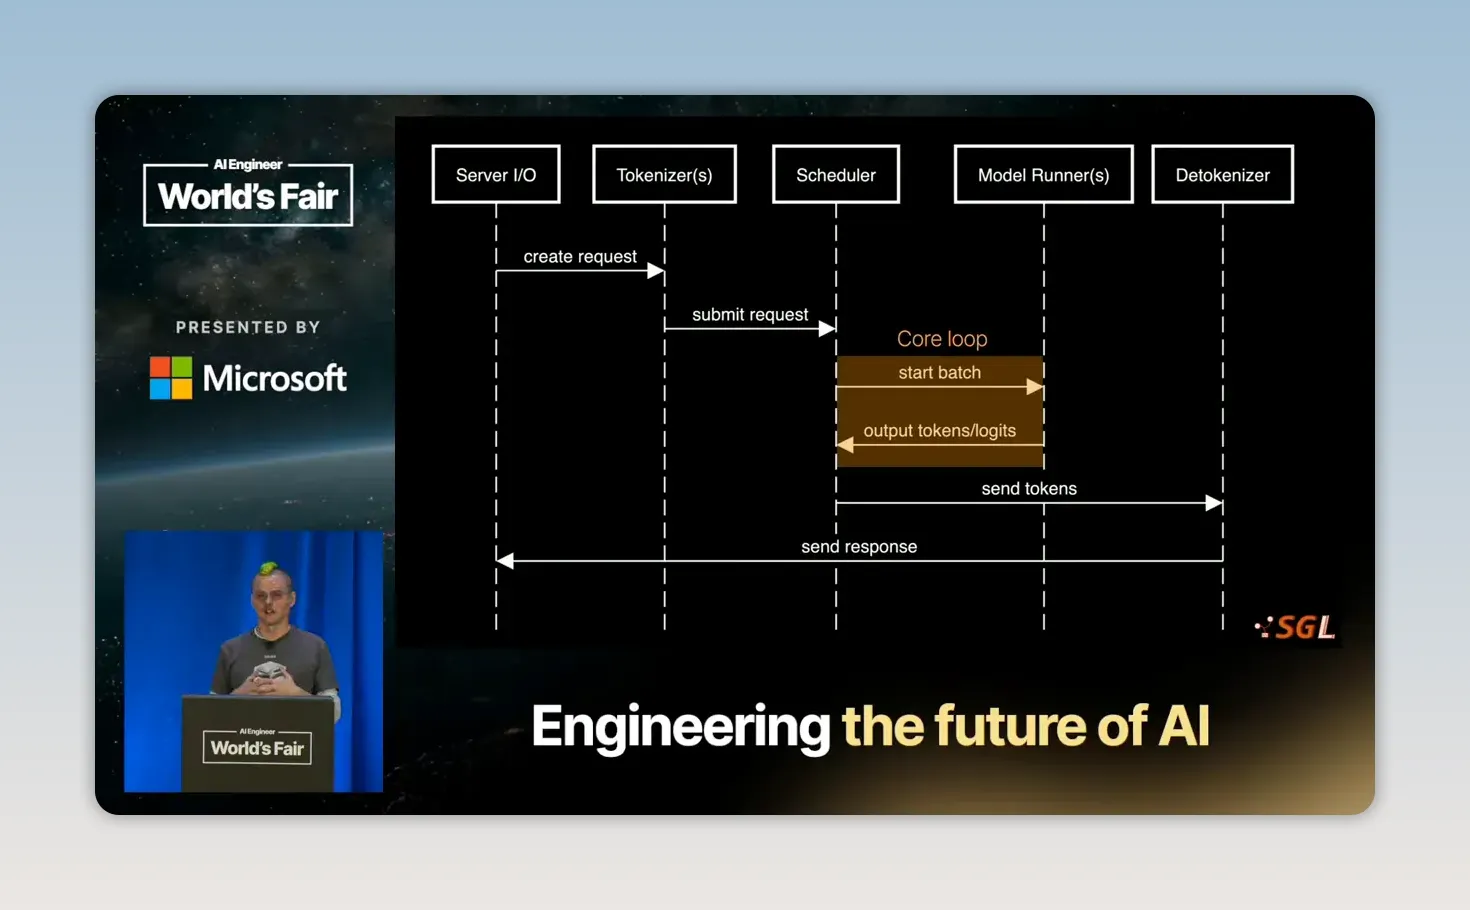
ที่มาภาพ: What Is an Inference Engine, Anyway? — Charles Frye, Modal จากช่อง AI Engineer
แม้ GPU จะรับงานคำนวณหนัก แต่ scheduler เป็นส่วนกำหนดว่างานใดเข้าถึงทรัพยากรนั้น หากส่วนจัดงานทำไม่ทัน GPU ก็อาจต้องรอ ความสามารถของฮาร์ดแวร์จึงไม่ใช่คำตอบทั้งหมด
การรวมหลายคำขอเป็นชุดหรือ batching ช่วยใช้ทรัพยากรร่วมกัน แต่ต้องจัดสมดุลระหว่าง prefill, decode และเป้าหมายเวลารอของผู้ใช้ การรับคำขอเพิ่มจนคิวสะสมจึงอาจทำให้ประสบการณ์แย่ลง แม้ระบบยังไม่หยุดทำงาน
Frye อธิบายด้วยว่า engine หลายตัวใช้คลัง kernel ระดับล่างร่วมกัน ความแตกต่างจึงไม่ได้อยู่ที่โค้ดคำนวณบน GPU เพียงอย่างเดียว แต่รวมถึงการเลือก backend การจัดชุดงาน และการลดเวลาที่ CPU กับ GPU ต้องรอกัน รายละเอียดสถาปัตยกรรมและตัวเลือกจริงอาจต่างกันตาม engine และรุ่น
สามเทคนิคที่ช่วยลดงานซ้ำและการรอ
KV Cache และการใช้ส่วนต้นร่วมกัน
KV Cache เก็บผลคำนวณบางส่วนเพื่อใช้ต่อในการสร้างคำตอบ และรองรับการใช้ผลคำนวณซ้ำเมื่อคำขอมีลำดับโทเคนช่วงต้นตรงกันภายใต้เงื่อนไขของระบบนั้น การใช้ prefix ร่วมกันไม่ได้อาศัยแค่ข้อความมีความหมายคล้ายกัน หากโทเคนต่างกัน ก็ใช้ผลคำนวณร่วมกันต่อจากจุดนั้นไม่ได้
แต่ cache ใช้หน่วยความจำ และความจุยังจำกัดเมื่อมีหลายคำขอพร้อมกัน การจัดเก็บแบบ pages หรือ radix ช่วยจัดการพื้นที่ ไม่ได้ทำให้เก็บได้ไม่จำกัด ส่วนการกำหนดเซสชันและส่งคำขอไปยัง replica ที่เหมาะสมอาจเป็นหน้าที่ของชั้นระบบภายนอก engine
CUDA Graphs
CPU ต้องสั่งให้ GPU รันงานย่อยหลายรายการ CUDA Graphs บันทึกลำดับและความสัมพันธ์ของงานเหล่านั้นเป็นกราฟ เพื่อเรียกใช้งานเป็นชุด ลดงานสั่งการซ้ำบน CPU แนวคิดนี้มุ่งลดช่องว่างที่ GPU ต้องรอการสั่งงาน ไม่ได้เปลี่ยนความสามารถด้านเหตุผลของโมเดล
Speculative Decoding
เทคนิคนี้ให้โมเดลผู้ร่างเสนอหลายโทเคนล่วงหน้า แล้วให้โมเดลหลักตรวจพร้อมกัน แทนการให้ตัวหลักสร้างทีละโทเคนในทุกจังหวะ วิธีตรวจรับและสุ่มที่ถูกต้องสามารถรักษาการแจกแจงผลลัพธ์ของโมเดลหลักได้ จึงไม่ใช่การยอมรับคำตอบของตัวเล็กโดยไม่ตรวจ และไม่ได้หมายความว่าทุกครั้งต้องได้ข้อความตรงกันทุกตัวอักษร
Frye มองว่าคุณภาพของผู้ร่างเป็นโอกาสเพิ่มความเร็วได้มาก แต่ตัวเลขเร่งความเร็วขึ้นกับงานและการตั้งค่าที่ใช้ บทความนี้จึงไม่ยกจำนวนเท่าจากคำบรรยายมาเป็นผลที่ระบบอื่นจะได้แน่นอน
อ่านเพิ่มเติมจากแหล่งที่ต้นฉบับอ้างไว้ได้ที่ เอกสาร KV Cache ของ Hugging Face และ เอกสาร CUDA Graphs ของ NVIDIA โดยตรวจเอกสารให้ตรงกับรุ่นที่ใช้งานก่อนนำไปตั้งค่า
ตัวอย่างป้ายงานศิลปะ: เมื่อโหลดเพิ่มจนเกิดคิว
Frye ใช้แอปของตนที่รับภาพ ส่งเข้า vision-language model ตระกูล Qwen ผ่าน SGLang บน Modal แล้วสร้างข้อความคล้ายป้ายคำอธิบายในพิพิธภัณฑ์ เป็นตัวอย่างอ่านแดชบอร์ด
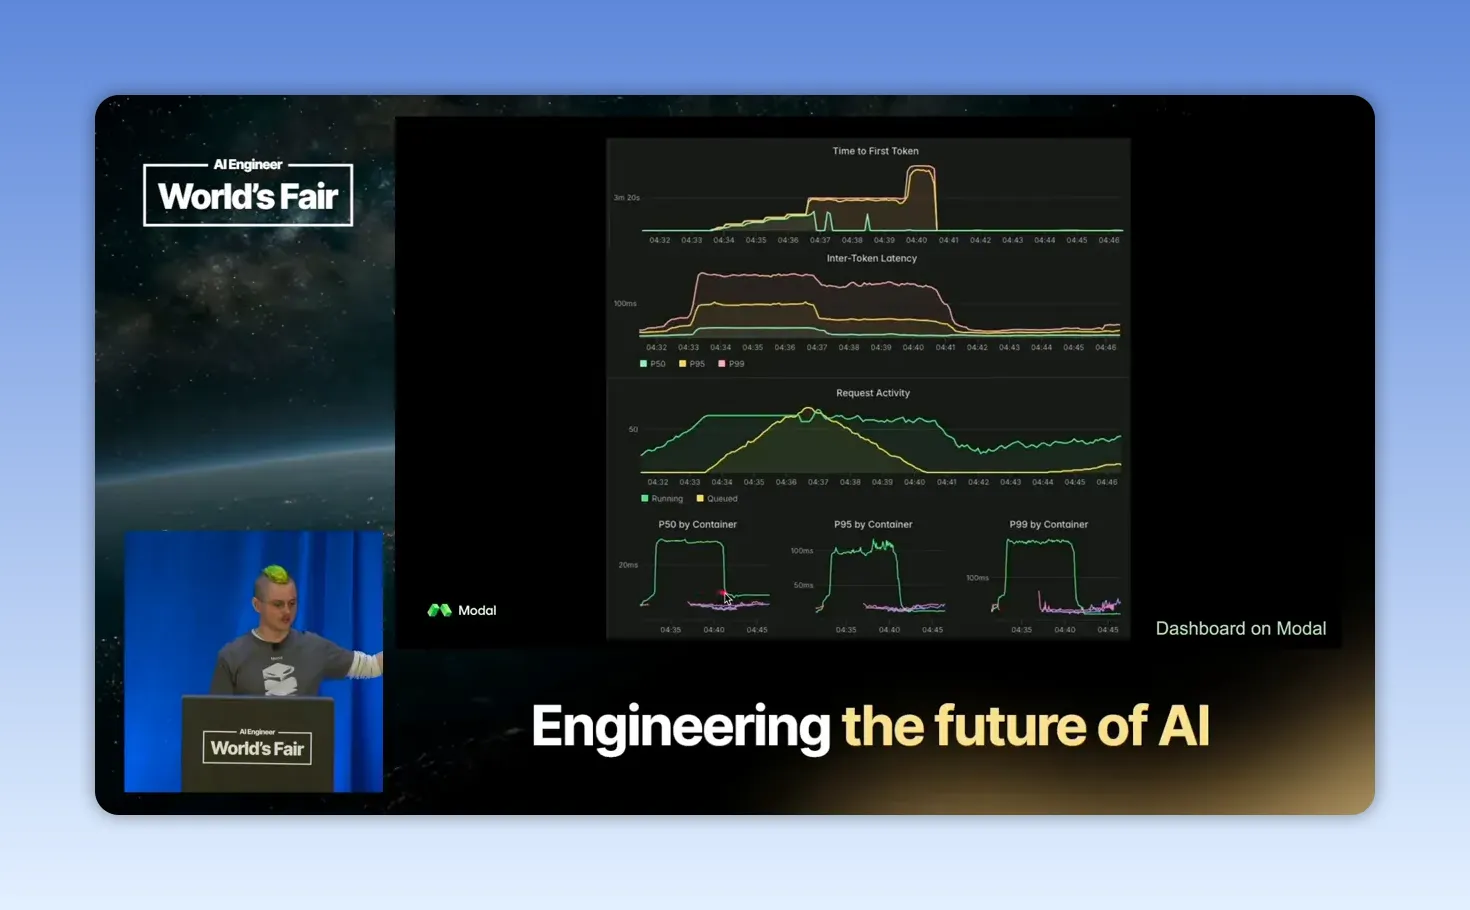
ที่มาภาพ: What Is an Inference Engine, Anyway? — Charles Frye, Modal จากช่อง AI Engineer
เขาอธิบายว่าเมื่อโหลดเพิ่ม ค่า TTFT สูงขึ้นจากการรอเข้า prefill และ inter-token latency ก็เพิ่มจากการแย่งใช้ GPU ในตัวอย่างนี้ เมื่อเพิ่ม replica มาช่วยรับคำขอ คิวจึงลดลงกลับใกล้ระดับเดิม
นี่เป็นกรณีที่เพิ่มกำลังรองรับเพื่อแก้ความแออัด ไม่ใช่ข้อสรุปว่าการเพิ่ม GPU หรือ replica แก้ความช้าได้ทุกชนิด หากภาระงานเปลี่ยน มีข้อผิดพลาดในส่วนเตรียมข้อมูล หรือเครื่องบางชุดทำงานผิดปกติ ก็ต้องตรวจแยกกัน
วัดทั้งความเร็วและความถูกต้องบนระบบที่ใช้จริง
Frye แยกปัญหาที่พบออกเป็นสามระดับ:
- ระดับแอป: โมเดลหรือกระบวนการทำงานให้ผลไม่ตรงโจทย์
- ความถูกต้องของการรันโมเดล: tokenizer, chat template หรือการปรับประสิทธิภาพทำให้พฤติกรรมเปลี่ยน
- ประสิทธิภาพของระบบ: replica บางตัวช้ากว่า หรือทำงานช้าลงหลังเปิดใช้งานต่อเนื่อง
เขาแนะนำให้รันการประเมินกับ endpoint ที่นำไปใช้งานจริง เก็บข้อมูลที่เชื่อมคำร้องเรียนของผู้ใช้กลับไปยังคำขอ และใช้เครื่องมืออย่าง Nsight Systems หรือ PyTorch Profiler เมื่อต้องตรวจการทำงานของ CPU และ GPU ลึกขึ้น
การเก็บข้อมูลเพื่อวิเคราะห์ต้องมีขอบเขตด้วย เช่น ใครเข้าถึงได้และเก็บนานเท่าไร โดยเฉพาะเมื่อคำขอมีข้อมูลลูกค้า ประเด็นนี้เป็นข้อควรพิจารณาในการนำแนวคิดไปใช้เพิ่มเติมจากคำแนะนำเชิงเทคนิคของผู้บรรยาย
เริ่มประเมินระบบจากงานของตัวเอง
ก่อนเลือก engine หรือเพิ่มทรัพยากร ทีมควรมีชุดทดสอบที่สะท้อนงานจริง บทความเสนอรายการเริ่มต้นดังนี้:
- ระบุประเภทงานและเป้าหมายเวลารอ แยกงานโต้ตอบออกจากงานเบื้องหลัง
- ใช้ความยาวอินพุต เอาต์พุต และจำนวนคำขอพร้อมกันที่ใกล้เคียงการใช้งาน
- ดู TTFT, inter-token latency, throughput และคิวร่วมกัน
- ทดสอบความถูกต้องทุกครั้งที่เปลี่ยนโมเดล engine หรือการตั้งค่าประสิทธิภาพ
- เปลี่ยนทีละส่วนและเปรียบเทียบกับค่าตั้งต้น เพื่อรู้ว่าอะไรช่วยและอะไรทำให้แย่ลง
ช่วงท้าย Frye แนะนำ mini-SGLang, nano-vLLM และการอ่านโค้ดหรือเอกสารสถาปัตยกรรมเพื่อเรียนรู้ต่อ พร้อมกล่าวถึง Modal Endpoints ซึ่งเป็นผลิตภัณฑ์ของบริษัทที่เขาทำงานด้วย การกล่าวถึงนี้เป็นส่วนหนึ่งของแหล่งต้นทาง ไม่ใช่ผลเปรียบเทียบว่าเป็นตัวเลือกที่ดีที่สุด
สาระหลักของเวิร์กช็อปคือทำให้คำว่า “AI ช้า” กลายเป็นคำถามที่ตรวจสอบได้: ช้าตอนอ่านอินพุต สร้างคำตอบ รอคิว หรือจัดการทรัพยากร เมื่อรู้ว่ากำลังรออะไร การปรับระบบจึงมีหลักฐานรองรับมากขึ้น
ที่มา: What Is an Inference Engine, Anyway? — Charles Frye, Modal จากช่อง AI Engineer เรียบเรียงจากบทถอดเสียงและภาพในต้นฉบับ VideoToBlog ไม่ได้ทดสอบประสิทธิภาพของ engine หรือบริการใดเพิ่มเติมอย่างอิสระ
