

อ่านการออกแบบงานหลายรอบผ่าน interaction ID, environment ID และผลลัพธ์ที่แยกชนิดชัดเจน
เมื่อสั่ง AI วิเคราะห์โครงการหนึ่งรอบแล้วขอให้แก้รายงานต่อ ระบบต้องกลับไปหาอะไรบ้าง ประวัติคำสั่งเป็นส่วนหนึ่ง อีกส่วนคือไฟล์ แพ็กเกจ และพื้นที่ทำงานที่ใช้สร้างรายงานนั้น ถ้าต่อบทสนทนาได้แต่กลับไปคนละพื้นที่ งานรอบใหม่ก็อาจไม่มีสิ่งที่เตรียมไว้ในรอบแรก
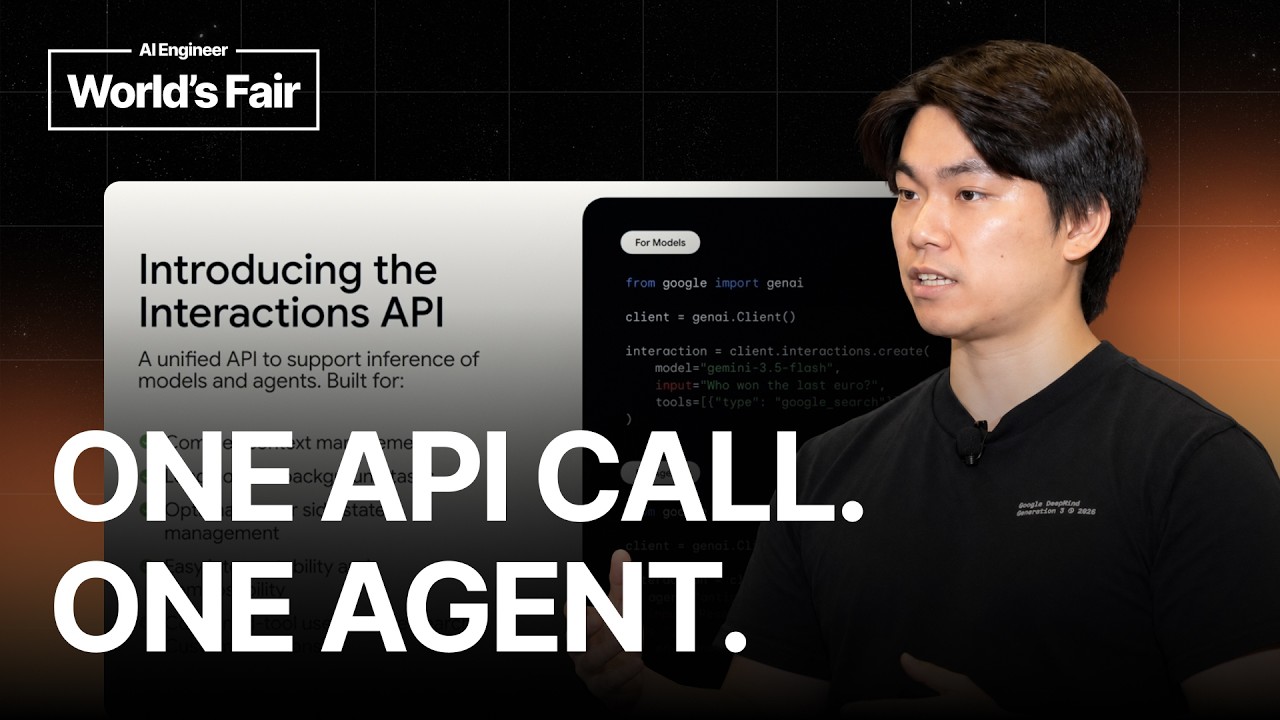
ในการบรรยาย An Interaction Is All You Need จากช่อง AI Engineer Ivan Leo ซึ่งได้รับการแนะนำว่าอยู่ Google DeepMind อธิบาย Gemini Interactions API และ Managed Agents ผ่านปัญหาการทำงานต่อเนื่องนี้ บทความจะเน้นวิธีเชื่อมคำขอ ผลลัพธ์ และพื้นที่รันงานตามเดโม ส่วนชื่อพารามิเตอร์ ความสามารถของแต่ละโมเดล และเงื่อนไขการเก็บสถานะต้องตรวจเอกสารปัจจุบันก่อนลงมือเชื่อมระบบ
ต่อ context ด้วย interaction ID
ช่วง 05:25–06:18 Ivan อธิบายการเก็บสถานะฝั่งเซิร์ฟเวอร์ด้วยตัวอย่างง่าย ๆ ผู้ใช้บอกชื่อในรอบแรก แล้วนำรหัสที่ระบบตอบกลับไปอ้างในรอบถัดไปผ่านช่องสำหรับ previous interaction ID ระบบจึงมีจุดเชื่อมกลับไปยังบริบทก่อนหน้า
เหตุผลที่เขาให้ความสำคัญกับเรื่องนี้คือ thought signatures ซึ่งเป็นข้อมูลที่โมเดลส่งกลับมาเพื่อใช้ต่อในการทำงาน ผู้บรรยายเล่าว่าการประกอบหรือส่งข้อมูลส่วนนี้ด้วยมือมีโอกาสผิดพลาด การอ้าง interaction เดิมจึงเป็นวิธีลดภาระในการส่งต่อสถานะบางส่วน
สำหรับระบบที่เราสร้าง จุดที่ต้องออกแบบคือการผูกรหัสเข้ากับงานให้ถูกชิ้น เช่น รายงานฉบับหนึ่งควรมีรหัสของรอบล่าสุดที่ใช้ทำงานต่อ หากเผลอเริ่มคำขอใหม่โดยไม่เชื่อมกลับ หรือดึงรหัสของอีกงานมาใช้ ก็ไม่ควรคาดว่าระบบจะมีบริบทที่ต้องการเอง
Thought signatures เป็นข้อมูลสำหรับการทำงานต่อของโมเดล จึงควรส่งต่อด้วยวิธีที่ API กำหนด ไม่ควรนำมาแก้เสมือนเป็นข้อความธรรมดา ส่วนอายุของสถานะ การลบข้อมูล และขอบเขตที่เรียกกลับมาใช้ได้ เป็นเงื่อนไขที่ต้องตรวจแยกก่อนเลือกใช้กับข้อมูลจริง
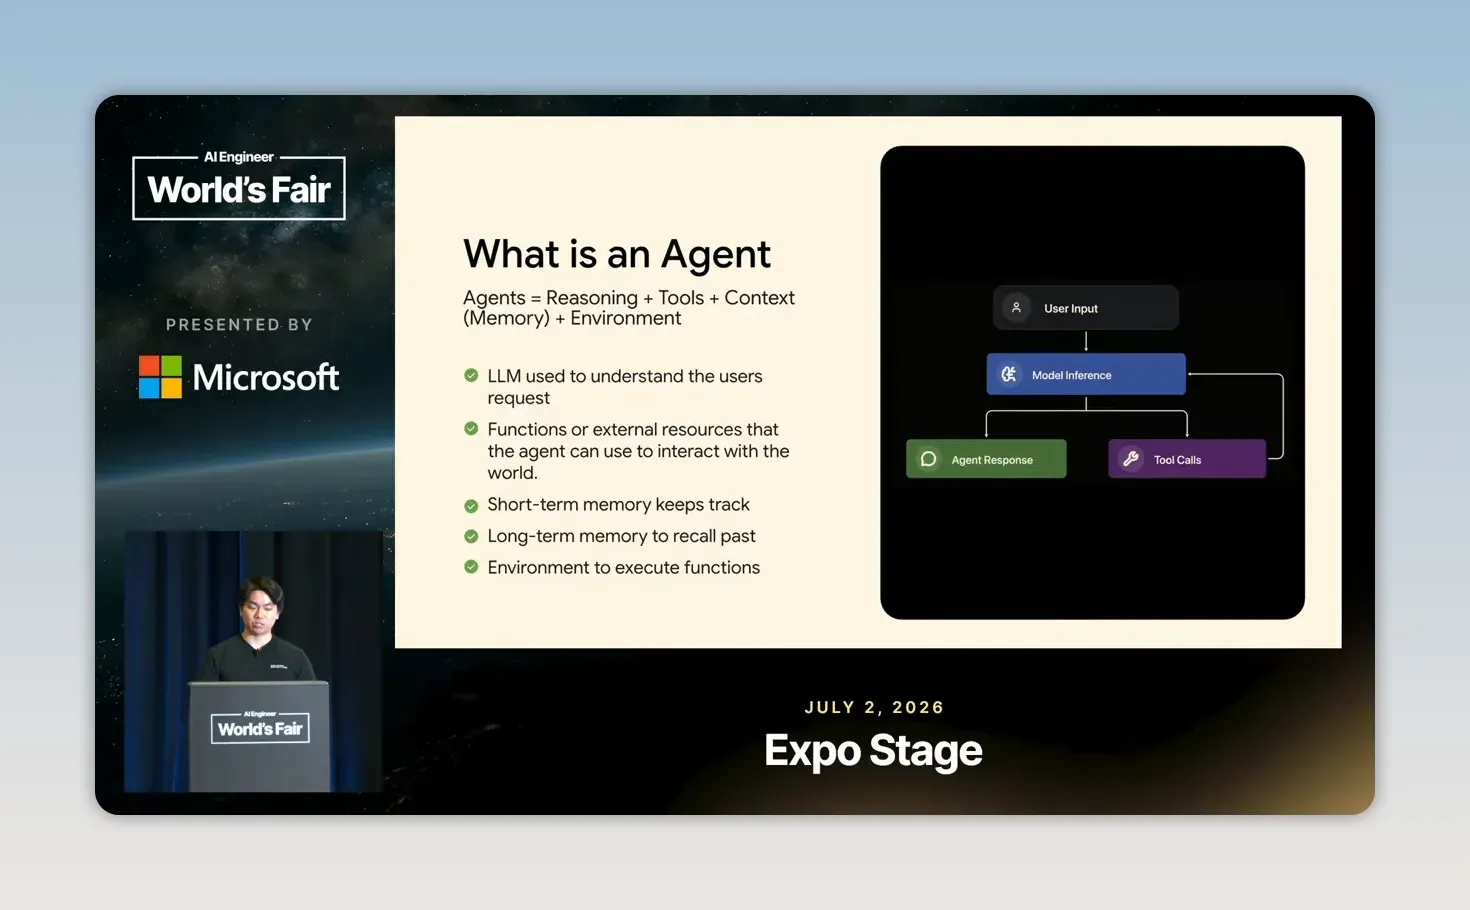
สไลด์นี้ช่วยอธิบายว่าทำไมการเก็บบทสนทนาอย่างเดียวจึงยังไม่ครอบคลุมงานของ agent เครื่องมือเป็นช่องทางลงมือทำ ส่วน environment เป็นที่ให้เครื่องมือทำงานจริง ความต่อเนื่องของทั้งสองส่วนจะเห็นชัดในเดโมวิเคราะห์ GitHub ช่วงถัดไป
จากภาพไปวิดีโอ และการแยกชนิดผลลัพธ์
เดโมช่วง 06:18–08:14 เริ่มจากภาพบุคคลหนึ่งภาพ แล้วสร้างภาพของบุคคลนั้นในสถานที่ต่าง ๆ จากนั้นนำ interaction ID ของงานภาพไปใช้ต่อกับงานวิดีโอ ในคำอธิบายของ Ivan รหัสนี้ช่วยเชื่อมข้อมูลจากขั้นก่อนหน้า แม้ผลลัพธ์ที่ต้องการในขั้นใหม่จะเปลี่ยนประเภท
ถ้าจะนำแนวคิดนี้มาทำเครื่องมือสร้างสื่อ จุดส่งต่อที่ควรเห็นชัดคือกำลังต่อจากภาพฉบับใด ผู้ใช้เลือกผลลัพธ์ไหนแล้ว และต้องการเปลี่ยนอะไรในรอบถัดไป การเก็บรหัสไว้คู่กับชิ้นงานช่วยให้ไล่เส้นทางนี้ได้ แทนการอาศัยว่าคำขอล่าสุดพิมพ์ต่อท้ายบทสนทนาใดอยู่
อีกส่วนของเดโมคือผลลัพธ์ที่ระบุชนิด เช่น ข้อความ ภาพ หรือเสียง ระบบปลายทางจึงเลือกวิธีจัดการตามชนิดที่ได้รับได้ ถ้าเป็นภาพก็ต้องมีทางเก็บและแสดงภาพ ถ้าเป็นเสียงก็ต้องจัดการข้อมูลเสียง การเขียนตัวรับผลลัพธ์โดยคาดว่าจะได้ข้อความเสมอทำให้ใช้รูปแบบอื่นต่อได้ลำบาก
เดโมนี้แสดงแนวทางส่งต่อ context ระหว่างงานสื่อ แต่ก่อนเปิดให้ใช้งานจริงยังต้องตรวจว่าโมเดลที่เลือกสร้างสื่อชนิดนั้นได้ และผลงานรอบใหม่รักษารายละเอียดที่ต้องการไว้หรือไม่ ชื่อรุ่นในตัวอย่างการบรรยายจึงไม่ควรถูกคัดลอกมาเป็นค่าเริ่มต้นของระบบโดยไม่ตรวจอีกครั้ง
อ่าน steps เพื่อเห็นเส้นทางการใช้เครื่องมือ
ช่วง 08:21–09:44 ยกตัวอย่างค้นหารายงานด้านความปลอดภัย โดยให้โมเดลใช้ Google Search เครื่องมืออ่านข้อมูลจาก URL และเครื่องมืออัปเดตไฟล์ที่สร้างเพิ่มขึ้นมาเอง งานหนึ่งจึงมีทั้งการหาข้อมูล อ่านเนื้อหา และเขียนผลลัพธ์
Ivan อธิบายโครงสร้างข้อมูลแบบ steps เพื่อรองรับเหตุการณ์เหล่านี้ในแต่ละช่วงของงาน เช่น มีการเรียกเครื่องมือใด และสร้างเนื้อหาประเภทใดออกมา การรู้เพียงว่าคำขอจบแล้วและได้ข้อความหนึ่งก้อนอาจไม่พอเมื่อเราต้องหาว่าความผิดพลาดเกิดตรงไหน
เมื่อต่อกับงานของตัวเอง สมมติรายงานใส่ข้อมูลผิด เราควรไล่ดูได้ว่าแหล่งข้อมูลต้นทางผิดตั้งแต่แรก เครื่องมืออ่านเนื้อหาไม่ครบ หรือขั้นเขียนรายงานตีความผิด การเก็บข้อมูลการเรียกเครื่องมือและผลลัพธ์ที่เกี่ยวข้องทำให้ตั้งคำถามได้ตรงจุดขึ้น โดยไม่ต้องอ้างว่า steps เปิดเผยกระบวนการคิดภายในทั้งหมดของโมเดล
ตัวรับข้อมูลจึงควรจัดการกับแต่ละชนิดของเหตุการณ์อย่างตั้งใจ และแยกงานที่ยังดำเนินอยู่ งานสำเร็จ และงานที่ต้องแก้ข้อผิดพลาดออกจากกัน สำหรับโค้ดจริงต้องยึดรูปแบบข้อมูลและสถานะในเอกสารของรุ่นที่ใช้ เพราะคำอธิบายบนเวทีไม่ครอบคลุมทุกกรณีที่ระบบอาจส่งกลับ
เก็บ environment ID คู่กับงาน
เดโม Managed Agents ช่วง 09:44–12:16 ให้ agent วิเคราะห์ repository บน GitHub ในพื้นที่รันงานระยะไกล มันเรียกดูรายการไฟล์ อ่านเนื้อหา แล้วจัดทำรายงาน ประเด็นที่เกี่ยวกับ API โดยตรงคือการกลับเข้าพื้นที่เดิมในคำขอรอบถัดไป
Ivan แยกรหัสไว้สองหน้าที่:
- Interaction ID ใช้อ้างความต่อเนื่องของบริบทจาก interaction ก่อนหน้า
- Environment ID ใช้อ้างพื้นที่ทำงานที่มีไฟล์และสิ่งที่เตรียมไว้
ในเดโมที่ต่อจากงานแรก ผู้บรรยายส่งรหัสกลับไปเพื่อให้ agent เข้าถึงไฟล์เดิม รวมถึงแพ็กเกจและไฟล์ที่สร้างไว้ระหว่างทำงาน จุดนี้ต่างจากการมีเพียงข้อความว่าเคยอ่านไฟล์อะไรมาแล้ว เพราะการทำงานต่ออาจต้องเปิดไฟล์หรือรันโปรแกรมในพื้นที่นั้นจริง ๆ
วิธีตรวจที่ต่อยอดจากเดโมได้คือเริ่มด้วย repository ตัวอย่างที่เปิดเผยได้ ให้รอบแรกสร้างรายงานพร้อมไฟล์ผลลัพธ์ แล้วใช้รอบถัดไปขอแก้ส่วนหนึ่งของรายงาน ก่อนถือว่าทำต่อสำเร็จ ให้ดูทั้งรหัสที่ใช้ รายการไฟล์ และเนื้อหาที่เปลี่ยน หากกลับมาแล้วไม่มีไฟล์เดิม ควรตรวจการเลือก environment ก่อนสรุปว่าโมเดลลืมงาน
การทดสอบลักษณะนี้แยกปัญหาบริบทออกจากปัญหาพื้นที่ทำงานได้ ส่วนระยะเวลาที่ environment อยู่ต่อ เงื่อนไขการกู้คืน และสิ่งที่จะเกิดขึ้นเมื่อรหัสใช้ไม่ได้ ต้องกำหนดจากข้อจำกัดจริงของบริการ
เติมข้อมูลยืนยันตัวตนผ่าน proxy
ช่วง 13:30–14:21 เสนอวิธีให้ agent เรียกบริการภายนอกผ่าน proxy ที่เติมข้อมูลยืนยันตัวตนในคำขอขาออก ตัวอย่างบนเวทีคือการเรียก GitHub API โดยตัวกลางเติม token ใน header แทนการส่ง token ให้โมเดลอ่านโดยตรง
วิธีนี้แยกข้อมูลลับออกจากส่วนที่ agent มองเห็น แต่สิ่งที่ต้องตรวจต่อคือคำขอที่ออกไปทำอะไรได้บ้าง หาก token มีสิทธิ์เขียนข้อมูล การซ่อนค่าของ token ก็ยังไม่ได้ตัดสิทธิ์นั้นออกจากบริการที่ agent เรียกใช้
สำหรับงานวิเคราะห์ repository จึงควรเริ่มจากสิทธิ์อ่านเท่าที่ต้องใช้ และกำหนดจุดอนุมัติแยกหากจะให้แก้หรือเผยแพร่ข้อมูลจริง การตรวจว่าตัวกลางเติมข้อมูลยืนยันตัวตนให้ปลายทางที่ถูกต้องกับการตรวจว่า agent ได้รับอำนาจเหมาะกับงาน เป็นสิ่งที่ต้องทำคู่กัน
นำ workflow ที่ทดลองแล้วไปเรียกใช้ซ้ำ
ช่วงท้ายการบรรยายอธิบายการส่งแหล่งข้อมูลและไฟล์เข้า environment ผ่านแหล่งอย่าง Google Cloud Storage, GitHub หรือไฟล์ที่แนบกับคำขอ รวมถึงการนำ workflow และทักษะที่ทดลองใน Antigravity บนเครื่องไปใช้กับ agent ระยะไกล
Ivan ยังแสดงแนวคิดการบันทึกการตั้งค่าเป็น agent ที่มีชื่อ โดยเตรียมไฟล์และการตั้งค่าล่วงหน้า หรือค่อย ๆ ปรับ environment ผ่านการสนทนาแล้วเก็บรูปแบบนั้นไว้เรียกใช้ซ้ำ ส่วนที่ควรนำกลับไปทดสอบหลังย้ายคือ dependency ตำแหน่งไฟล์ สิทธิ์ และวิธีรับผลลัพธ์ เพราะสิ่งเหล่านี้เป็นเงื่อนไขที่ workflow พึ่งพาอยู่
เครื่องมือ CLI และทักษะช่วยย้ายมาใช้ Interactions API ถูกกล่าวถึงในฐานะตัวช่วยให้ coding agent อ้างรูปแบบ API ได้ตรงขึ้น หากนำมาใช้ ก็ควรเทียบกับเอกสารและตัวอย่างปัจจุบัน แล้วลองงานเดิมที่มีผลลัพธ์สำหรับเปรียบเทียบอยู่แล้ว โดยเฉพาะเส้นทางการส่ง interaction ID และ environment ID กลับไปในรอบต่อไป
ประเด็นสำคัญของการออกแบบนี้คือทำให้ทุกคำขอรู้ว่ากำลังต่อจากงานไหน ใช้พื้นที่ใด และจะรับผลลัพธ์อย่างไร เมื่อข้อมูลสามส่วนนี้ชัด เราจะตรวจได้ว่างานทำต่อจากจุดเดิมจริง และหาตำแหน่งที่ผิดได้โดยไม่ต้องเริ่มรื้อทั้ง workflow
วิดีโอต้นทาง
ดูตัวอย่าง API และเดโมเต็มได้ใน An Interaction Is All You Need จาก AI Engineer
