

ผู้ช่วยฝ่ายบริการยังตอบชื่อสินค้าที่เลิกขายไปแล้ว ทั้งที่ทีมเปลี่ยนแค็ตตาล็อกใน prompt เป็นฉบับใหม่เรียบร้อย ปัญหาในตัวอย่างนี้อยู่ที่ข้อมูลสินค้าเก่าปะปนในเคสบริการย้อนหลังที่นำไป fine-tuning จึงเข้าไปอยู่ใน weights ของโมเดลด้วย
Anant Srivastava ยกกรณีนี้ในการบรรยาย Stop Fine-Tuning to Fix Retrieval Problems ทางช่อง AI Engineer เพื่อชวนทีมดูว่าความรู้ถูกเก็บไว้ตรงไหน เขาเสนอให้มอง prompt, memory และ weights เป็นเครื่องมือสำหรับงานต่างชนิด แทนการไล่เปลี่ยนไปใช้สิ่งที่ซับซ้อนขึ้นทุกครั้งที่ AI ตอบผิด
ข้อมูลเก่าเข้าไปอยู่ใน weights ได้อย่างไร
ในกรณีที่ผู้บรรยายเล่า การเปลี่ยนแปลงแต่ละอย่างดูสมเหตุสมผลเมื่อมองแยกกัน ผู้จัดการผลิตภัณฑ์แก้ prompt ให้น้ำเสียงดีขึ้น ทีมบริการเพิ่มนโยบายคืนเงินเข้าระบบค้นข้อมูล วิศวกรใส่แค็ตตาล็อกสินค้าใน prompt และทีมแมชชีนเลิร์นนิงนำเคสบริการย้อนหลังถึงหกเดือนมาฝึกเพิ่มเติม
พอสินค้าเปลี่ยน ทีมอัปเดตแค็ตตาล็อกที่มองเห็นได้ แต่ข้อมูลเดิมไม่ได้อยู่แค่จุดนั้น ชื่อสินค้าเก่าอยู่ในเคสที่ใช้ฝึกด้วย จึงยังปรากฏในคำตอบได้ ตามคำอธิบายของ Srivastava ความผิดพลาดนี้เกิดจากหลายทีมค่อย ๆ เพิ่มส่วนของตัวเอง โดยไม่มีใครรับผิดชอบการวางข้อมูลทั้งระบบ
ประเด็นของกรณีนี้จึงอยู่ที่การตามหาทุกทางที่ข้อมูลเดินเข้าโมเดล การดูเพียง prompt ล่าสุดหรือรายชื่อเอกสารที่อัปโหลดไว้ อาจยังไม่เห็นสิ่งที่เคยถูกใส่ในชุดฝึก
แยกคำสั่ง ความรู้ และทักษะออกจากกัน
ผู้บรรยายใช้กรอบสามส่วนเพื่อช่วยวินิจฉัยปัญหา โดยย้ำว่ามีข้อยกเว้นได้ ไม่ใช่กฎที่ใช้ตัดสินทุกระบบโดยไม่ดูบริบท
- Prompt: คำสั่งเรื่องพฤติกรรม เช่น น้ำเสียง วิธีตอบ และจุดที่ต้องส่งต่อให้คน ควรกระชับและแก้ไขได้สะดวก
- Memory: ความรู้ที่ต้องหยิบมาใช้ เช่น เอกสาร นโยบาย และข้อมูลที่เปลี่ยนตามเวลา รวมถึงแหล่งภายนอกที่ค้นผ่าน RAG
- Weights: ส่วนของโมเดลที่เปลี่ยนจากการฝึก ในกรอบนี้เขาสนใจการฝึกรูปแบบหรือทักษะที่เริ่มนิ่งแล้ว มากกว่าการให้โมเดลจำข้อมูลธุรกิจที่ยังเปลี่ยนอยู่
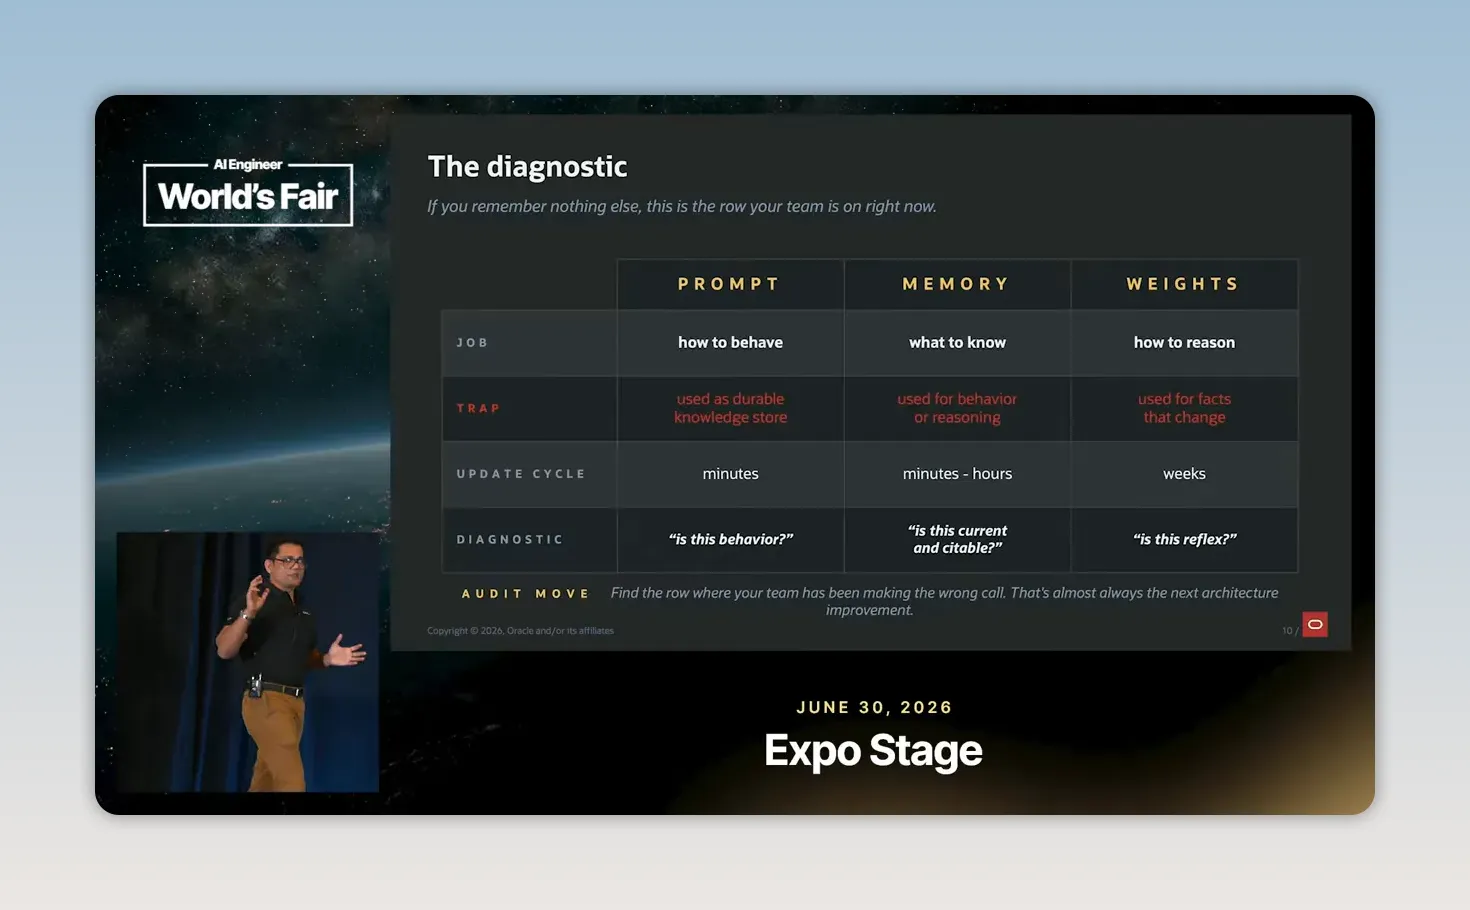
ตัวอย่าง prompt ในคลิปคือผู้ช่วยบริการซอฟต์แวร์ที่ใช้น้ำเสียงมืออาชีพ เสนอส่งต่อเจ้าหน้าที่หลังแก้ปัญหาไม่สำเร็จสามครั้ง และบอกขั้นตอนถัดไปให้ชัด นี่เป็นตัวอย่างกติกาของระบบที่เขายกมา ไม่ใช่จำนวนครั้งที่เหมาะกับทุกธุรกิจ
คำว่า prompt ในการบรรยายครอบคลุมคำสั่งที่เขียนไว้ในไฟล์และส่วนอื่นของระบบด้วย ส่วนการเตือนไม่ให้ใช้ prompt เป็นคลังข้อมูลถาวร ไม่ได้แปลว่าห้ามส่งข้อเท็จจริงเข้าสู่ context เมื่อจะตอบคำถาม ข้อมูลที่ค้นมาและเกี่ยวข้องกับงานยังต้องถูกส่งให้โมเดลใช้ ความต่างอยู่ที่การเลือกข้อมูลให้ตรงโจทย์ แทนการแนบคลังทั้งหมดซ้ำทุกครั้ง
สำหรับ memory ผู้บรรยายเน้นความรู้ที่มีปริมาณมาก เปลี่ยนเร็วกว่ารอบฝึก และต้องอ้างกลับไปยังแหล่งข้อมูลได้ เขานับทั้งความจำของเอเจนต์และฐานความรู้ภายนอกองค์กรไว้ในคำนี้ จึงไม่ควรอ่านว่า memory หมายถึงประวัติแชตเพียงอย่างเดียว
ตรวจข้อมูลที่ค้นได้จริง ก่อนฝึกโมเดลเพิ่ม
ผู้บรรยายยกผู้ช่วยเขียนโค้ดเป็นตัวอย่าง คลังโค้ดมีขนาดใหญ่และเปลี่ยนอยู่เรื่อย ๆ จึงต้องดูวิธีแบ่งข้อมูลเป็นส่วนย่อยและเลือกส่วนที่เกี่ยวข้องกลับมาใช้ เขาเน้นการแบ่งโดยคำนึงถึงโครงสร้างโค้ด พร้อม metadata ที่บอกว่าชิ้นนั้นมาจาก repository ใดและอยู่ในขอบเขตการเข้าถึงของใคร
ข้อเสนอคือให้ตัวกรองช่วยจำกัดชุดข้อมูลที่ดึงมา แทนการคืนชิ้นส่วนจำนวนมากจนปะปนกัน สำหรับข้อมูลที่ผู้ใช้แต่ละคนเห็นได้ไม่เท่ากัน การออกแบบสิทธิ์จึงต้องอยู่ในเส้นทางค้นข้อมูลด้วย
กรณีคล้ายกันเกิดกับผู้ช่วยค้นเอกสารภายใน หากมันตอบผิดเพราะไม่ได้รับส่วนที่เกี่ยวข้องจากคู่มือ การนำคู่มือทั้งรุ่นไป fine-tuning อาจทำให้ยิ่งผูกกับข้อมูลเก่า Srivastava เสนอให้กลับไปแก้การค้นและการเลือกชิ้นข้อมูลก่อน
วิธีตรวจที่นำหลักนี้มาใช้ได้คือเลือกคำถามที่ตอบผิดหนึ่งข้อ แล้วเปิดดูข้อมูลที่โมเดลได้รับจริง: เอกสารถูกฉบับหรือไม่ มีเงื่อนไขสำคัญครบหรือไม่ และอยู่ในขอบเขตสิทธิ์ที่ถูกต้องหรือไม่ เมื่อข้อมูลถูกแล้วแต่ยังใช้เหตุผลผิด จึงแยกไปประเมินความสามารถของโมเดลและรูปแบบงานต่อ วิธีตรวจนี้ต่อยอดจากกรอบที่ผู้บรรยายเสนอ
เมื่อใดจึงมีเหตุผลให้ fine-tuning
Srivastava ไม่ได้เสนอให้เลิก fine-tuning เขาเสนอให้มีเหตุผลชัดว่ากำลังแก้ข้อจำกัดด้านความสามารถหรือประเมินทางเลือกด้านต้นทุน และต้องดูว่ารูปแบบที่กำลังจะฝึกนิ่งพอแล้วหรือยัง
ตัวอย่างในคลิปคืองานที่คนยังตัดสินต่างกันในช่วงแรก เช่น การกลั่นกรองเนื้อหา เมื่อเก็บการแก้ไขของคนไปสักระยะ อาจเห็นส่วนที่เริ่มมีมาตรฐานตรงกันกับส่วนที่ยังถกเถียง ผู้บรรยายมองว่าส่วนที่นิ่งแล้วเป็นผู้สมัครสำหรับการฝึกเพิ่มเติม ขณะที่กรณีกำกวมยังต้องให้คนดูต่อ หลังฝึกก็ยังต้องติดตามว่ามาตรฐานหรือข้อมูลเปลี่ยนไปหรือไม่
เขายังยกงานจับคู่บันทึกกับรหัสทางการแพทย์เพื่อแยก “ความรู้เรื่องรายการรหัส” ออกจาก “ทักษะอ่านรูปแบบข้อมูลและเลือกผลลัพธ์” จุดของตัวอย่างคือไม่จำเป็นต้องฝังรายการทั้งหมดไว้ในโมเดลเพื่อฝึกให้ทำงานกับรูปแบบนั้นได้ บทความนี้ใช้เป็นตัวอย่างด้านสถาปัตยกรรมเท่านั้น ไม่ได้ประเมินความถูกต้องหรือแนะนำการนำไปตัดสินงานทางการแพทย์
ส่วนการใช้โมเดลขนาดเล็กกับงานที่มีรูปแบบชัด ผู้บรรยายเสนอว่าอาจเป็นทางเลือกด้านต้นทุนได้ แต่ไม่ได้ให้ผลทดลองที่ใช้คำนวณความประหยัดสำหรับระบบของผู้อ่าน การมีข้อมูลที่นิ่งจึงยังต้องประกอบกับเป้าหมายและการประเมินผลของงานนั้น
ออกแบบการส่งต่อระหว่างสามส่วน
ช่วงท้ายของการบรรยายเชื่อมสามส่วนกลับเข้าด้วยกัน ข้อมูลจากการทำงานบางอย่างถูกเลือกเก็บเป็น memory เมื่อเริ่มงานใหม่ ระบบดึงข้อมูลที่เกี่ยวข้องกลับเข้า context และเมื่อพบรูปแบบที่นิ่งพอ ก็อาจนำไปสร้างชุดฝึกได้
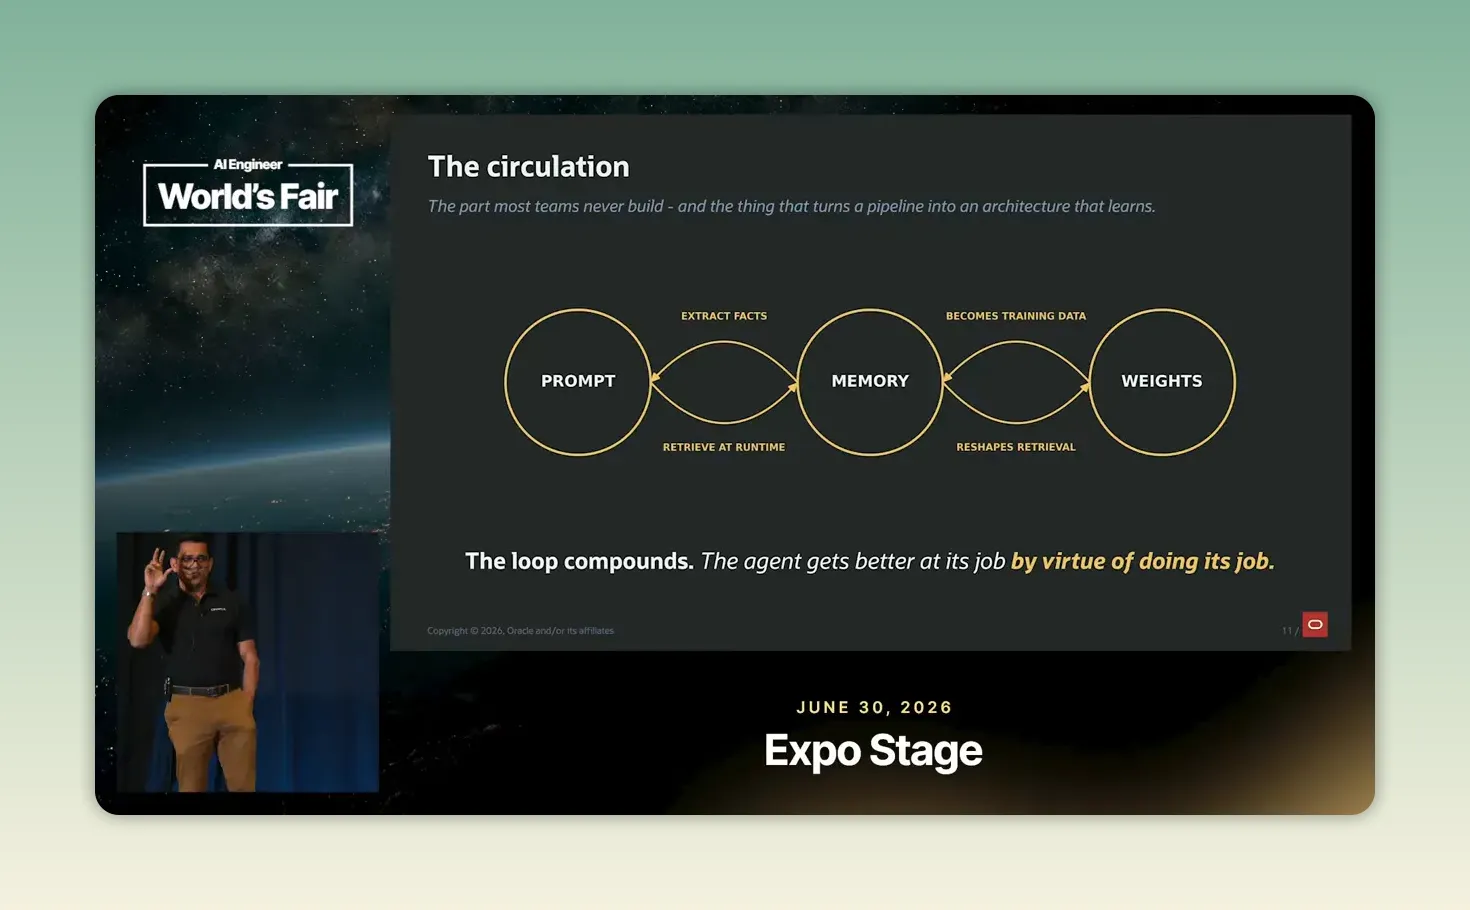
หลังฝึกให้โมเดลคุ้นกับรูปแบบบางอย่างแล้ว ตัวอย่างที่เคยต้องดึงมาประกอบทุกครั้งอาจเปลี่ยนไป ส่วนข้อเท็จจริงที่ต้องเป็นปัจจุบันยังต้องได้รับการดูแลในแหล่งข้อมูลของมัน วงจรนี้ต้องมีการคัดเลือกและประเมินผล ไม่ได้หมายความว่าเอเจนต์จะฝึกตัวเองหรือทำงานดีขึ้นโดยอัตโนมัติเพียงเพราะใช้งานมากขึ้น
ก่อนเปลี่ยนโมเดลหรือเริ่มชุดฝึกใหม่ คำถามที่บทบรรยายฝากไว้จึงเป็นเรื่องที่ตรวจได้: ข้อมูลที่ทำให้ตอบผิดมาจากไหน ใครเป็นคนอัปเดต และควรแก้ตรงจุดใด คำตอบเหล่านี้ช่วยให้การแก้ระบบมีเป้าหมายชัดกว่าการเพิ่ม prompt เพิ่มเอกสาร และเพิ่มการฝึกพร้อมกัน
แหล่งที่มา: Stop Fine-Tuning to Fix Retrieval Problems / Anant Srivastava / AI Engineer
