

วันที่บทความต้นทางใน VideoToBlog: 2026-04-10 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว ตัวเลข accuracy ชุดข้อมูล โมเดลและต้นทุนเป็นผลทดลองที่ผู้บรรยายรายงาน ไม่ใช่ผลทดสอบอิสระหรือผลรับประกันสำหรับข้อมูลของทีมอื่น แนวทางและรายละเอียดเครื่องมืออ้างอิงตามช่วงเวลาของต้นทาง · วิดีโอต้นทาง
หลังจบคลิปเวิร์กช็อปเรื่อง “Judge the Judge” สิ่งที่ยังติดอยู่คือประโยคเชิงกังวลแบบตรงไปตรงมา: หาก LLM-as-a-judge (LLM ที่ทำหน้าที่ตัดสินคุณภาพของคำตอบ) ไม่ได้ถูกคาลิเบรตให้สอดคล้องกับมนุษย์จริงๆ การใช้มันไป “ตัดสิน” ในระบบอาจทำให้ได้ความมั่นใจผิดๆ ทั้งที่สัญญาณประเมินไม่สอดคล้องกับโลกจริง
ประเด็นนี้สำคัญยิ่งสำหรับทีมที่ทำ Agent ใน production ซึ่งต้องการความน่าเชื่อถือ (reliability) และต้องการวัดผลทั้ง offline evaluation และ online evaluation แต่กลับพบว่า “ใน observability เหมือนดี” ขณะที่ลูกค้ารายงานว่า “ใช้ไม่ได้” ผลลัพธ์คือการตรวจย้อนกลับไปเห็นว่า LLM-as-a-judge ถูกสร้างจาก prompt ที่เหมือนตั้งคำสั่งให้มันตอบแบบขาวดำทันที เช่น ให้เขียนว่า output นั้น “เป็น hallucination หรือไม่” พร้อมคำสั่งให้ “ห้ามพลาด”
แล้วคำถามตามมาก็คือ ถ้ามัน “รู้” อยู่แล้วว่าควรเป็น hallucination หรือไม่ Agent ก็คงทำงานได้ตั้งแต่วันแรกอยู่แล้ว เพราะปัญหาจริงคือ LLM-as-a-judge ที่ไม่ได้ผ่านการเรียนรู้จาก ground truth จะมี bias ของตัวมันเอง และมักไม่สัมพันธ์กับคำตัดสินของมนุษย์
บทความนี้นำแก่นคิดจากคลิปมาสังเคราะห์เป็นแนวทางเชิงปฏิบัติสำหรับการสร้าง calibrated LLM as a judge ที่ “ใช้งานได้จริง” ด้วยการคาลิเบรตจาก annotation ของมนุษย์ และใช้ การปรับแต่ง prompt ด้วย GEPA (GePA ในคลิป) เพื่อให้ judge มีคุณภาพใกล้เคียงมนุษย์มากขึ้น โดยยกเคสจริงเป็น customer support agent จากชุดข้อมูล Tau-bench (หมวด airline agent) และเดินผ่านตั้งแต่การออกแบบ metrics ไปจนถึงการ optimize และการประเมินผล
ปัญหาใหญ่: LLM-as-a-judge ที่ไม่คาลิเบรตให้สัญญาณผิด
ปัจจัยที่ทำให้ eval พังไม่ใช่แค่ “LLM ตัดสินผิด” แต่เป็นกรณีที่มัน ตัดสินผิดในแบบที่ดูเหมือนถูก ยิ่งถ้า instrumentation ใน observability รายงาน metric แบบง่ายๆ เช่น เปอร์เซ็นต์ “ผ่าน” จำนวนมาก ทีมจะยิ่งเชื่อว่าระบบดีขึ้น ทั้งที่จริงแล้วมันเพียงสะท้อน bias ของ judge เท่านั้น
คลิปชี้ภาพชัด: prompt ของ judge ที่ใช้แค่คำสั่งให้ “ตัดสินว่า hallucination ไหม” โดยไม่อธิบายหลักการหรือไม่ผ่านการเรียนรู้จากชุดคำตัดสินมนุษย์ ทำให้เมื่อ deploy ลง production แล้ว ลูกค้ากลับรายงานว่า agent ล้มเหลว ขณะที่ eval ในระบบยัง “ดูโอเค”
แนวคิดที่เป็นแก่นของบทความนี้จึงคือ: miscalibrated evals แย่กว่าการไม่มี eval เสียอีก เพราะมันให้ feedback ที่ผิดทิศ และทำให้ loop การพัฒนาพังตั้งแต่ต้น
ทำไมต้อง “calibrated” LLM-as-a-judge
คำว่า calibrated ในที่นี้หมายถึง judge ถูกปรับให้สอดคล้องกับ human annotation หรือ ground truth ที่มนุษย์ให้ไว้ วิธีคิดคือเราจะไม่ยอมให้ LLM-as-a-judge เป็น “คนตัดสิน” ที่ใช้กฎของมันเองแบบไร้การคุมทิศ แต่จะให้มัน “เรียนรู้นิสัยการตัดสิน” จากสิ่งที่มนุษย์ทำจริง
คลิปย้ำเหตุผลสำคัญ 3 อย่างที่เจอบ่อยในงานวิศวกรรม AI
1) เร็วขึ้นใน offline evaluation loop
วงจรปรับปรุง prompt หรือ agent โดยทั่วไปคือ: ทดลอง prompt → รัน eval → ดูผล → ปรับปรุง → ทำซ้ำ วงจรนี้จะติดขัดที่ “ความเร็วของการประเมิน”
ถ้าประเมินด้วยมนุษย์ทุกครั้ง คุณภาพดี แต่ช้าและแพงมาก ในขณะที่การใช้ LLM-as-a-judge ที่ไม่ correlate กับมนุษย์จะทำให้ loop วิ่งเร็ว แต่ไปไม่ถึงเป้าหมาย เพราะสัญญาณที่ใช้ปรับปรุงไม่ได้สะท้อนคุณค่าทางธุรกิจจริง
ดังนั้นการมี judge ที่ คุณภาพใกล้เคียงมนุษย์ จะทำให้ทั้งเร็วและมีทิศทาง จึงช่วยเร่งการพัฒนา agent หรือ prompt ได้จริง
2) ดีขึ้นใน online evaluation เพื่อดูการเปลี่ยนแปลง
ออนไลน์ eval เป็นอีกสนามที่ต้องการ judge ที่สอดคล้องกับเป้าหมายธุรกิจ หากทีมปรับโมเดลหรือ prompt แล้วอยากรู้ว่า “ดีขึ้นหรือแย่ลง” judge ที่คาลิเบรตแล้วจะช่วย detect การเปลี่ยน distribution ของข้อมูลและพฤติกรรมผู้ใช้ได้เร็วขึ้น
ที่สำคัญคือมันทำให้การตอบสนองต่อปัญหาใน production เร็วขึ้นและลดความเสี่ยงจากการ deploy แบบมองไม่เห็น
3) สร้าง data flywheel ได้จริง (และไม่ติดหล่ม manual labeling)
เป้าหมายสุดยอดในวิศวกรรม AI คือวนลูปอัตโนมัติ: optimize harness หรือ eval → สังเกต traces → สร้าง eval เพิ่มจาก edge cases ที่พบ → ทำซ้ำเรื่อยๆ
แต่ลูปจะเป็น “วงกลม” ที่ขับเคลื่อนด้วยข้อมูลก็ต่อเมื่อการเพิ่ม eval ทำได้เร็ว และ judge ให้สัญญาณที่สอดคล้องกับมนุษย์ ไม่อย่างนั้นมันจะสะสมข้อผิดพลาดในทิศทางที่ผิดไปเรื่อยๆ
ภาพรวม workflow: metrics → annotation → optimize judge → validate
คลิปเสนอ workflow แบบ 4 ขั้นตอน ชัดเจนและเป็นระบบ โดยมีประโยคที่ควรจำ: metrics ต้องมาจาก use case ไม่ใช่เลือกชื่อ metric ทั่วไปแล้วหวังว่าจะใช้งานได้
ขั้นที่ 1: ออกแบบ metrics (แกนตัดสินที่สอดคล้องกับธุรกิจ)
สำหรับ customer support agent สิ่งที่นับว่า “สำเร็จ” หรือ “ผิด” ไม่ใช่คำว่า hallucination อย่างเดียว แต่เป็นการ ปฏิบัติตาม policy และ รูปแบบการสื่อสาร และ การเรียกเครื่องมือ ให้ถูกต้อง
จุดนี้ต้องให้ subject matter expert (SME) เข้ามา เพราะคนที่เขียน policy หรือทำงานกับเคสจริงเท่านั้นที่จะตอบได้ว่าอะไรคือความผิดที่มีผลต่อผู้ใช้จริง
ขั้นที่ 2: ทำ annotation ด้วยการทำ error analysis แบบมีโครงสร้าง
คลิปอ้างแนวคิด error analysis จาก HamelDev ซึ่งโฟกัสที่การให้ SME ดู traces แล้วเริ่มจากการใส่ข้อคิดเห็น จากนั้นค่อยๆ จัดกลุ่มเป็นชนิดของข้อผิดพลาด (error types)
ใน airline customer support agent เคสนี้พบ error types หลัก 4 กลุ่ม ได้แก่
- policy adherence ล้มเหลว เช่น ยกเลิกโดยไม่ตรวจเงื่อนไขยกเลิกที่ถูกต้อง
- response style ไม่เหมาะสมหรือสื่อสารไม่ถูกต้อง
- information delivery ไม่แจ้งผู้ใช้ว่าเกิดการเปลี่ยนแปลงอะไร
- tool usage เรียกเครื่องมือไม่ถูกต้อง
มุมมองส่วนตัวที่น่าสนใจจากภาพรวมนี้คือ การทำ metrics แบบแยกแกน ไม่ได้ทำให้ระบบง่ายขึ้นเสมอ แต่ทำให้ระบบ เรียนรู้ได้ง่ายขึ้น เพราะ judge ถูกบังคับให้เชี่ยวชาญในสิ่งที่ชัดเจน แทนที่จะพยายามตัดสิน “ความสำเร็จทั้งหมด” ในครั้งเดียว
ขั้นที่ 3: สร้าง binary labels พร้อมเหตุผล (reasoning) เพื่อให้ judge เรียนรู้ได้
อีกจุดที่ควรเน้นคือคลิปเลือกใช้ binary มากกว่า score 1-5 หรือเปอร์เซ็นต์
เหตุผลมีสองชั้น
- การคาลิเบรต LLM-as-a-judge ให้เป็นตัวเลขระหว่าง 1 ถึง 5 ยากขึ้นมาก และแม้แต่มนุษย์เองยังเห็นด้วยกันยาก
- เมื่อเป็น binary แล้วโจทย์การเรียนรู้จะกระชับขึ้น ทำให้การ optimize prompt ผ่าน GEPA มีทิศทางชัดเจน
แต่มันยังไม่พอ เพราะคลิปย้ำว่า label ต้องมาพร้อม reasoning หรือเหตุผลจากมนุษย์ (หรืออย่างน้อยจาก annotation ที่เตรียมมา) เช่น ในเคส policy adherence เหตุผลคือ “ยกเลิกโดยไม่ตรวจว่า reservation เข้าเงื่อนไขยกเลิกหรือไม่”
เหตุผลนี้สำคัญสำหรับการเรียนรู้ เพราะหากให้แค่ถูกผิดอย่างเดียว LLM-as-a-judge จะต้องพยายาม “เดา” เองว่าทำไม และนี่มักไปไม่ถึงการเรียนรู้ policy ที่ซับซ้อน
ขั้นที่ 4: optimize LLM-as-a-judge ด้วย GEPA และ validate ด้วยชุดแยก
หลังได้ annotated dataset แล้ว ขั้นต่อไปคือ optimize prompt ของ judge โดยใช้ GEPA ซึ่งเป็นอัลกอริทึมแนว genetic algorithm ที่ทำงานเป็นรอบๆ: สร้าง candidate prompts ใหม่ → ประเมินกับ mini-batches → คัดเลือกชุดที่ดีขึ้น → ทำซ้ำจนจบ compute budget
และสุดท้ายต้อง validate บนชุดที่แยก (validation set) เพื่อดูว่า judge ไม่ได้ “จำ” training จนเกินจริง
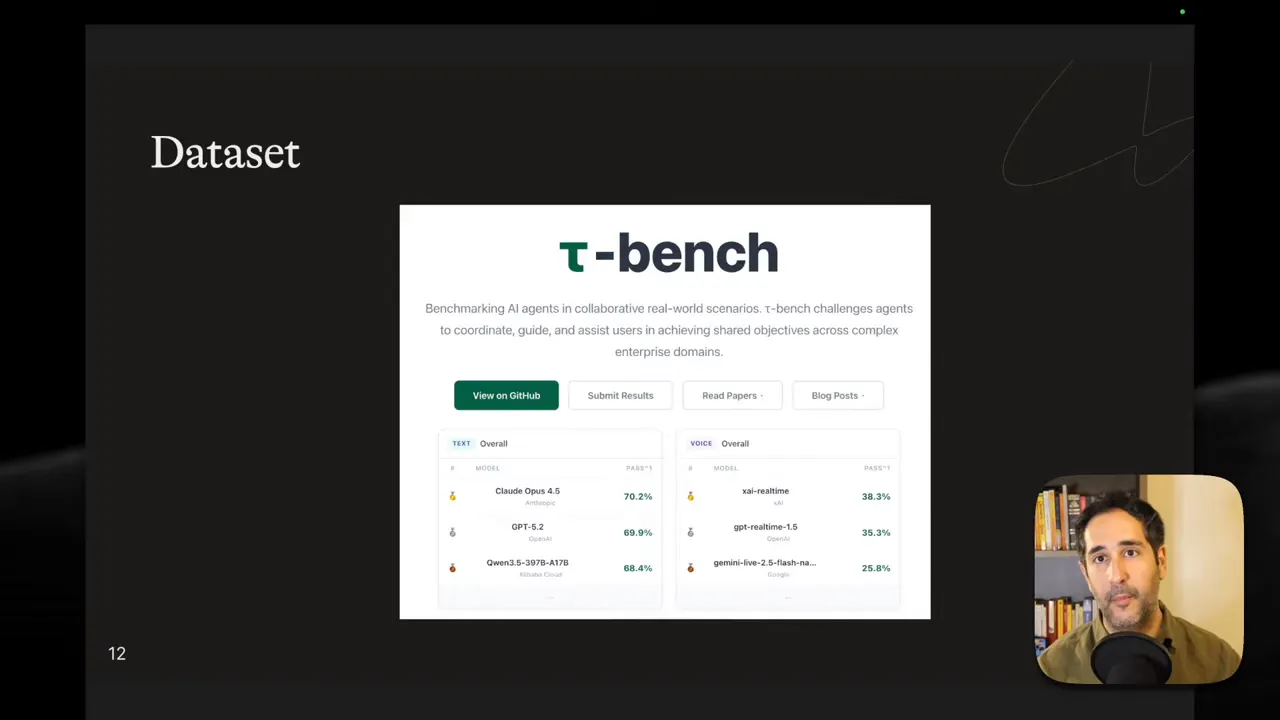
ทำไมเคส airline customer support ถึงเป็นบททดสอบที่ดี
ชุดข้อมูล Tau-bench ในหมวด airline agent ให้ conversation traces หลายร้อยเคส (คลิปกล่าวถึง 599 traces รวม) ซึ่งสะท้อนโลกจริงในแง่ที่ policy ซับซ้อนและ agent มีเครื่องมือหลายอย่าง เช่น เครื่องมือจัดการ reservation และข้อมูลเที่ยวบิน
นอกจากความซับซ้อนแล้ว ข้อมูลยังมี “caveats” เช่น ไม่สะอาดมากนักและมี redundancies (แต่คลิปบอกว่าไม่มี redundancies ข้าม training กับ validation) และ annotation บางส่วนเป็น AI-generated มาก่อน ซึ่งทำให้โจทย์ยิ่งท้าทาย
มุมมองของผู้เขียนบทความเชิงสังเคราะห์คือ เรื่องนี้ไม่ใช่ข้อด้อยล้วนๆ เพราะมันสะท้อนงานจริง: datasets มักไม่ได้ perfect และงานวิศวกรรมที่ชนะไม่ใช่แค่ทำคะแนนสูง แต่คือทำระบบที่ “ทนต่อความสกปรกของข้อมูล” ได้ระดับหนึ่ง
เข้าใจ GEPA: อัลกอริทึมลักษณะพันธุกรรมสำหรับ prompt optimization
ส่วนของ GEPA ในคลิปอธิบายด้วยภาพรวมที่อ่านง่าย: เริ่มด้วย seed prompt แล้วค่อยๆ สร้าง prompt ใหม่ด้วยการ mutation หรือ merging จาก prompt ที่ผ่านเกณฑ์ แล้วประเมินว่าดีขึ้นไหม
GEPA ใช้แนวคิดหลัก 3 ส่วนในแต่ละรอบ
- Sampling candidates สร้าง prompt ใหม่
- Evaluation ประเมิน prompt candidate กับชุดย่อย
- Selection ด้วย Pareto frontier เพื่อเพิ่ม diversity และครอบคลุมเคสหลายแบบ
Prompt mutation และ merging: เพิ่มพื้นที่ค้นหา
ในรอบแรก เมื่อยังมี candidate เพียงตัวเดียวจะใช้ prompt mutation โดยให้ LLM ช่วยสะท้อน (reflection) ว่า prompt ควรปรับอย่างไร จากผลการประเมิน
ส่วนการ merging จะเกิดเมื่อมีหลาย prompt แล้วนำ “แนวคิด” จาก prompt A และ prompt B มารวม เพื่อให้ judge ได้กฎหรือโครงสร้างที่ครอบคลุมมากขึ้น
ทำไมต้อง Pareto frontier ไม่ใช่เลือกค่าเฉลี่ยที่ดีที่สุด
หากเลือก prompt ที่ได้คะแนนเฉลี่ยสูงสุด อัลกอริทึมจะมีแนวโน้ม “เก่งกับงานส่วนใหญ่” แต่พลาดงานเฉพาะบางประเภท
แนวคิด Pareto frontier ในคลิปคือการมองหา prompt ที่ดีที่สุดสำหรับแต่ละ task หรือแต่ละ trajectory แล้วเลือกชุด candidates ที่ช่วยครอบคลุมภาพรวมของชุดทดสอบ เพื่อให้ในท้ายที่สุด “มีอย่างน้อยหนึ่ง candidate ที่แก้โจทย์แต่ละเคสได้”
การตั้งต้น: seed judge ต้องเริ่มด้วย bias ที่ถูกทาง
จุดที่หลายทีมมองข้ามคือ seed prompt ของ LLM-as-a-judge ที่ใช้เป็นจุดเริ่มต้น
เคสนี้เริ่มจาก “สมมติว่า agent compliant ก่อน” และค่อยตัดสิน non-compliant เมื่อมีเหตุผลเฉพาะ เมื่อประเมินบน validation set แบบ seed นี้ได้ accuracy ประมาณ 61% แต่ที่น่าสนใจคือ bias ไปทาง “compliant” เป็นหลัก ซึ่งถือว่าเป็น bias ที่สมเหตุสมผลในบริบทการคาลิเบรต
คลิปยังชี้ให้เห็นว่าเมื่อทดลองแล้ว seed แบบอื่นที่ทำให้ตัดสินเกือบสุ่มหรือไม่พอ ก็ทำให้การเรียนรู้ด้วย GEPA ไม่เกิดผลชัดเจน หรือ “ไม่เรียนรู้” ได้จริง
ข้อคิดส่วนตัวคือ seed judge เหมือนการตั้งระบบพิกัด ถ้าพิกัดผิดทิศตั้งแต่แรก optimization อาจติดหลุมที่แก้ยาก ยิ่งโจทย์ policy adherence ซับซ้อนแบบนี้แล้วยิ่งต้องให้ bias ตั้งแต่ต้นอยู่ในฝั่งที่ถูก
สิ่งที่เปลี่ยนเกม: reflection template ต้องใส่ prior และข้อมูล ground truth
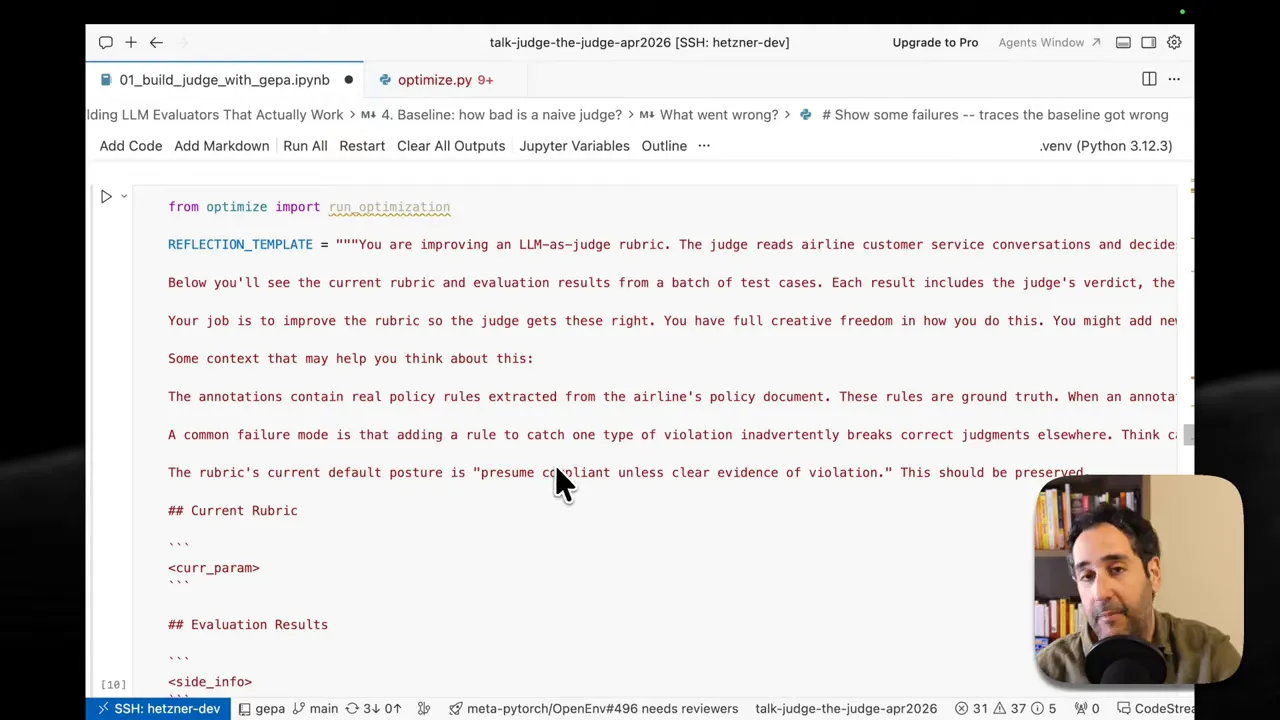
GEPA มี default reflection prompt ให้ แต่คลิปเล่าว่าผลไม่ดีเท่าที่คาด จึงมีการเขียน reflection template เอง โดยใส่ prior ว่าควรช่วย “เรียนรู้ policy” ไม่ใช่แค่ตัดสินว่าผิดหรือถูก
การออกแบบ reflection template สำคัญเพราะมันเป็นส่วนที่ทำให้ candidate prompts ใหม่ “คิดในทิศทางเดียวกับโจทย์” คลิปกล่าวถึงการให้ข้อมูลเพิ่ม เช่น
- ให้ reflection มองเห็น judge verdict และ ground truth annotation
- ให้มีคำแนะนำเชิงโครงสร้าง เช่น ออกกฎเพิ่ม เรียบเรียงใหม่ และให้รางวัลความชัดเจน
- กระตุ้นให้ reflection สร้าง “policy rules” ที่แท้จริงในภาษาของ prompt
พูดให้ตรงคือ ถ้า reflection template ไม่ช่วยบังคับทิศทาง มันจะเป็นเพียงการให้ LLM “คิดเอาเอง” ว่าควรแก้ prompt อย่างไร ผลที่ได้อาจเป็นการปรับที่ไม่ไปแตะแกน policy จริง
ผลการ optimize: Accuracy ดีขึ้น และ bias ของ judge ลดลง
หลังรัน optimization ใช้เวลาประมาณราวหนึ่งชั่วโมงในงานตัวอย่าง (ขึ้นกับระบบและจำนวนการเรียกโมเดล) ผลบน validation set ดีขึ้นจากช่วงเริ่มต้น โดยคลิปกล่าวถึง
- accuracy เพิ่มจากเดิมไปประมาณ 74%
- ลด bias: จากเดิมที่ตัดสิน non-compliant แทบไม่ออก (precision/recall ที่เริ่มต้นแย่มาก) หลัง optimize ดีขึ้น
- ทั้ง training accuracy และ validation accuracy ดีขึ้น เช่น training เพิ่มราว 9 จุด และ validation เพิ่มราว 14%
อีกสัญญาณที่น่าสนใจคือ Pareto frontier มีช่วงที่ accuracy สามารถไปถึง 100% ในแง่ของ “สำหรับแต่ละ task มีอย่างน้อยหนึ่ง candidate ที่แก้โจทย์ได้” แต่ปัญหาคือการ merge ให้เหลือ prompt ตัวเดียวที่แก้ทุกเคสได้ยังยาก ทำให้ accuracy จากการ merge ยังไม่ถึงระดับมนุษย์ในอุดมคติ
นี่เป็นเรื่องที่ควรยอมรับในงานจริง: optimization แบบนี้เก่งในการสร้างชุดความสามารถเฉพาะทาง แต่การควบรวมให้เป็น prompt เดียวที่ทำได้ทุกอย่างพร้อมกันยังเป็นเรื่องท้าทาย
บทเรียนจากสิ่งที่ทดลองแล้วไม่เวิร์ก
คลิปใช้เวลาพอสมควรกับ “สิ่งที่ลองแล้วล้มเหลว” ซึ่งมีคุณค่ามาก เพราะช่วยลดเวลาเสียของทีมที่กำลังเริ่มทำ prompt optimization
1) การใช้โมเดลเล็กหรือรุ่นเก่าทั้ง refiner และ judge อาจพัง
ตัวอย่างชัดเจนในคลิปคือการใช้ GPT-4o สำหรับทั้ง refiner และ LLM-as-a-judge ซึ่ง “ล้มเหลวโดยสิ้นเชิง” และการใช้โมเดลเล็กอย่าง Mini/Nano ก็ไม่ช่วยให้โจทย์เรียนรู้ได้
มีรายงานว่าการใช้การผสมโมเดลบางแบบให้ผลดีที่สุดในงานตัวอย่าง เช่น ใช้ Gemini สำหรับ reflection และ Grok สำหรับ judge หรือใช้ GPT-4 mini สำหรับทั้งคู่ซึ่งพอทำได้ดีระดับหนึ่ง
2) วิธี debugging ที่ช่วยได้: เริ่มเล็ก ดู reasoning ดูการปรับก่อนขยาย sampling
อีกบทเรียนคือ อย่ารีบยิง candidate จำนวนมากตั้งแต่เริ่ม แต่ควรเริ่มจาก iteration เล็ก ดูว่า candidate prompts ใหม่ “ดีขึ้นจริงไหม” และดู reasoning ของ refiner ว่ามันเรียนรู้อะไร
คลิปกล่าวถึงการหยุดที่ iteration แรกแล้วหาเคสตัวอย่าง จากนั้นปรับ refinement prompt เพิ่มในลักษณะ overfit บางส่วนเพื่อให้มันปรับปรุง prompt ได้ดีขึ้น
3) seed prompt ที่เข้าถึง policy อาจทำให้ติด local minima
คลิปทดลอง 2 ตระกูล seed prompt
- prompt ที่ไม่ได้ใส่ policy จาก agent prompt ลงไปตั้งแต่ต้น (แต่ให้ annotation เป็นตัวช่วยบอก policy ผ่านเหตุผล)
- prompt ที่ copy-paste policy จาก agent prompt ลงไป
ผลออกมาว่าตระกูลที่ “ไม่ใส่ policy โดยตรง” ทำได้ดีกว่า คลิปตั้งสมมติฐานว่าเมื่อใส่ policy เข้าไปตั้งแต่แรก โมเดลอาจติด local minima เพราะมันถูกบังคับด้วยข้อความ policy ตรงๆ แต่ถ้าไม่ใส่ policy แต่ให้ annotation ที่มี policy coverage เพียงพอ มันจะสำรวจพื้นที่ prompt ได้ดีกว่า
ต้นทุนและการเลือกขนาดโมเดล: ต้องคิดเป็นระบบ ไม่ใช่หวังผลอย่างเดียว
ค่าใช้จ่ายเป็นอีกจุดที่คลิปเตือนตรงๆ แม้จะเป็นงานสเกลตัวอย่าง แต่การทดลองมีค่าใช้จ่ายประมาณหลายร้อยดอลลาร์ใน tokens เพราะ conversation traces ยาว และต้องเรียกโมเดลจำนวนมากในแต่ละ iteration
ที่น่าสนใจคือแนวคิดค่าใช้จ่ายต่อการ optimize
- โมเดลที่แพงมากอาจ “กินเงิน” เร็ว แต่ก็อาจไม่จำเป็นเสมอ
- โมเดลเล็กบางทีไม่ทำงาน (อย่างน้อยในเคสนี้)
- หลักการที่คลิปบอกว่าใช้น่าจะสมเหตุสมผลคือ ใช้โมเดลใหญ่กว่าใน refiner และใช้โมเดลที่คุ้มค่ากว่าใน LLM-as-a-judge เมื่อรัน judge กับจำนวน traces มากใน online evaluation
มุมมองส่วนตัวคือ ถ้าโจทย์คือ “ลดต้นทุนในระยะยาว” การ optimize prompt เพื่อทำให้ judge reliable ขึ้นอาจคุ้มกว่า เพราะมันลดการต้อง label ด้วยมนุษย์ซ้ำๆ และลดการยิงโมเดลผิดทางใน loop development
คำแนะนำเชิงปฏิบัติ: ถ้าจะทำ calibrated LLM-as-a-judge ให้เริ่มตรงไหน
จากสิ่งที่คลิปสอน เราสามารถสรุปเป็น checklist เชิงปฏิบัติได้ โดยยึดสิ่งที่ทำได้จริงในงานระบบ agent
- อย่าใช้ “hallucination” เป็น metric สากล ให้ผูก metrics กับ policy และผลลัพธ์ที่ธุรกิจต้องการ
- ทำ error taxonomy แยกชนิดความผิดออกจากกัน แล้วเลือกให้ judge มีความจำเพาะ ไม่พยายามตัดสินทุกอย่างใน prompt เดียว
- ใช้ binary labels เพื่อให้คาลิเบรตง่าย และอย่าลืมใส่เหตุผล (reasoning) ให้ label
- สร้าง seed judge แบบเอนเอียงอย่างมีเหตุผล เริ่มด้วยสมมติฐานที่ถูกทิศ และให้มันมีการเปลี่ยนไป non-compliant เมื่อมีเหตุผลเฉพาะ
- ปรับ reflection template ให้เห็น ground truth และใส่ prior ว่าเป้าคือการ “เรียนรู้ policy criteria”
- debug แบบเล็ก ดู reasoning ของ candidate ก่อนเพิ่ม sampling
- ยึด validation set ที่แยก เพื่อกันการ overfit โดยเฉพาะเมื่อ Pareto frontier ทำให้เห็นว่าทำได้ 100% ในระดับ candidate
- คุมงบ เลือกขนาดโมเดลสำหรับ refiner และ judge ให้สมดุลกับจำนวน traces ที่ต้องประเมิน
Embed และมุมมองสังเขปจากกรอบคิด “Judge the Judge”
ระบบที่เชื่อถือได้ไม่ได้เริ่มจากการหา prompt ดีๆ หนึ่งอัน แต่เริ่มจากการ “ทำให้ผู้ตัดสินเรียนรู้จากผู้สอนที่ถูกต้อง” แล้วค่อย optimize ให้ตัดสินได้สอดคล้องขึ้น
แก่นคิด “judge the judge” จึงไม่ใช่แค่การตรวจว่า LLM-as-a-judge ตัดสินผิดหรือถูก แต่มันคือการยืนยันว่า judge นั้น สัมพันธ์กับเป้าหมายมนุษย์จริง มิฉะนั้นการพัฒนาจะวิ่งผิดทิศ
คำศัพท์เฉพาะทางเพิ่มเติม
LLM-as-a-judge
คือ LLM ที่ใช้เป็นตัวประเมินคำตอบหรือการตัดสินคุณภาพของ output โดยจะทำหน้าที่คล้ายผู้ตรวจงาน เช่น ตัดสินว่า agent ปฏิบัติตาม policy หรือไม่
Calibration
การคาลิเบรตคือการทำให้ตัวประเมิน (judge) สอดคล้องกับคำตัดสินของมนุษย์หรือ ground truth มากขึ้น ไม่เช่นนั้น metric จะให้ความมั่นใจผิดๆ
Optimization ด้วย GEPA
เป็นอัลกอริทึมแนวพันธุกรรมสำหรับ prompt optimization โดยใช้การสร้าง prompt candidate ใหม่ (mutation/merge) แล้วคัดเลือกด้วยการประเมินและ Pareto frontier
Pareto frontier (ในบริบทการเลือก prompt)
คือการเลือกชุด candidates ที่ช่วยครอบคลุมหลาย task ไม่ใช่เพียงเลือกค่าเฉลี่ยที่ดีที่สุด ซึ่งช่วยให้ judge ไม่ล้มเฉพาะเคส
ลิงก์อ้างอิงเพิ่มเติม (เพื่ออ่านขยายตามแนวคิดที่คล้ายกัน): Pareto efficiency on Wikipedia
บทสรุปส่งท้ายจากทีมงาน Insiderly
- eval ที่ไม่คาลิเบรตอาจทำให้ทีม “เชื่อว่าเดินถูกทาง” ทั้งที่จริง feedback ผิดทิศ ดังนั้นการสร้าง calibrated LLM-as-a-judge คือรากฐานของ reliability
- metrics ต้องมาจาก use case และ policy ของธุรกิจ ไม่ใช่ metric สากลแบบ hallucination แล้วหวังว่ามันจะครอบคลุมโจทย์
- binary labels พร้อมเหตุผล (reasoning) ช่วยให้ judge เรียนรู้ policy criteria ได้ดีขึ้น โดยลดภาระการเดา
- GEPA ช่วย optimize prompt ได้จริง แต่ต้องออกแบบ seed และ reflection template ให้ “เรียนรู้ทิศทางที่ถูก” โดยให้ ground truth มีบทบาทกับการปรับปรุง
- ต้องมีการ validate บนชุดที่แยกจริง และระวังว่า Pareto frontier อาจทำให้เห็นว่ามี candidate เก่ง แต่การ merge ให้เป็น prompt เดียวที่ครอบคลุมทุกเคสยังท้าทาย
- ต้นทุนเป็นส่วนหนึ่งของวิศวกรรม: การเลือกโมเดลสำหรับ refiner และ judge รวมถึงจำนวน traces ที่ต้องประเมิน ส่งผลต่อความคุ้มค่าโดยตรง
