


AI ที่ตอบสุภาพอาจยังทำงานไม่สำเร็จ และคะแนนทดสอบที่ดูดีอาจซ่อนปัญหาที่ลูกค้าเจอทุกวัน AI Observability จึงไม่ใช่แค่การตรวจว่าระบบยังทำงานอยู่ แต่เป็นการหาหลักฐานว่า AI ทำอะไรไปบ้าง ติดขัดตรงไหน และการแก้ไขครั้งถัดไปทำให้งานดีขึ้นหรือแย่ลง
เวิร์กช็อปของ Doug Guthrie จาก Braintrust บนช่อง AI Engineer ใช้ข้อมูลตัวอย่างของ AI ฝ่ายบริการลูกค้า 968 traces เพื่อเชื่อมการติดตามระบบเข้ากับการปรับปรุง agent ตั้งแต่การค้นพบปัญหาค้นหาออเดอร์ไม่เจอ ไปจนถึงการส่งต่อให้เจ้าหน้าที่ที่ล้มเหลว ประเด็นที่น่าสนใจไม่ใช่จำนวนเครื่องมือ แต่คือวิธีเปลี่ยนข้อมูลเหล่านี้ให้กลายเป็นชุดทดสอบและข้อเสนอแก้ไขที่ตรวจสอบได้
สำหรับเจ้าของธุรกิจและคนทำงานไทย บทเรียนหลักคือ เราไม่ควรวัด AI จากคำตอบเพียงอย่างเดียว ต้องวัดว่ามันพางานไปถึงผลลัพธ์ที่ต้องการหรือไม่ การติดตั้งระบบติดตามเป็นหน้าที่ของทีมเทคนิค แต่การกำหนดว่าอะไรเรียกว่า “ทำงานสำเร็จ” เป็นเรื่องที่ทีมธุรกิจต้องร่วมตัดสินใจ
ขั้นตอนที่ 1: เริ่ม AI Observability ด้วยการเห็นทุกขั้นตอนของงาน
พื้นฐานของ observability คือ tracing หรือการบันทึกลำดับการทำงานของ agent ตั้งแต่รับคำถาม เรียก model ใช้เครื่องมือค้นข้อมูล จนส่งคำตอบกลับ ส่วนงานย่อยแต่ละช่วงเรียกว่า span ซึ่งช่วยให้เราตรวจได้ทั้งข้อมูลเข้า ผลลัพธ์ และความสัมพันธ์ระหว่างขั้นตอน
ความต่างจากการเก็บประวัติแชตคือ ประวัติแชตบอกว่า AI พูดอะไร แต่ trace ช่วยบอกว่า คำตอบนั้นเกิดจากกระบวนการแบบไหน หากระบบค้นหาออเดอร์คืนข้อมูลว่าง เราต้องแยกให้ออกว่า agent เลือกเครื่องมือผิด ส่งข้อมูลผิด หรือเครื่องมือทำงานแล้วแต่ค้นไม่พบจริง
เมื่อเชื่อมกับธุรกิจไทยที่ใช้ AI ช่วยตอบเรื่องคืนสินค้าและคืนเงิน คำถามแรกจึงไม่ควรเป็น “ใช้ model รุ่นไหนดี” แต่ควรเป็น “ทีมสามารถย้อนดูการค้นออเดอร์ การอ่านนโยบาย และการส่งต่อเจ้าหน้าที่ได้ครบหรือยัง” ส่วนที่ไม่ถูกบันทึกยังคงเป็นกล่องดำ แม้หน้าจอสนทนาจะดูเรียบร้อยก็ตาม
- ตรวจว่ามีข้อความที่ลูกค้าส่งเข้ามาและคำตอบของ agent
- ตรวจข้อมูลเข้าและผลลัพธ์ของเครื่องมือที่สำคัญ
- เชื่อมขั้นตอนย่อยเข้ากับงานหรือบทสนทนาเดียวกัน
- ใช้มุมมองลำดับเวลาเพื่อหาช่วงที่งานช้าหรือติดขัด
แนวคิดเรื่อง trace และ span มีคำอธิบายเพิ่มเติมใน เอกสาร tracing ของ OpenTelemetry ทีมธุรกิจไม่จำเป็นต้องลงรายละเอียดการเชื่อมต่อทั้งหมด แต่ควรรู้ว่าหลักฐานแบบใดที่ต้องขอจากผู้พัฒนาระบบ
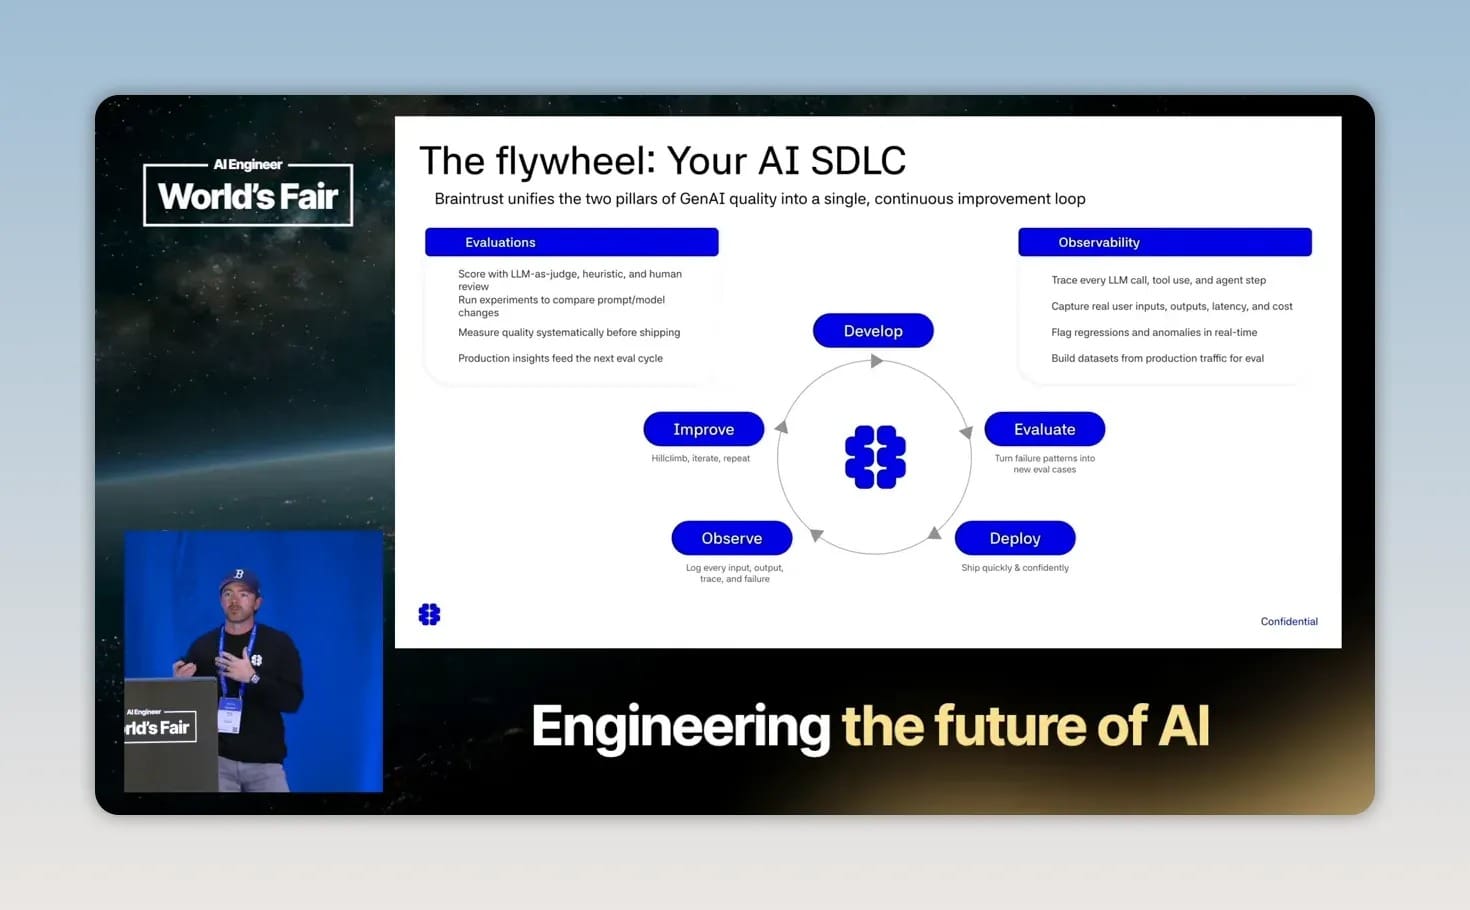
ขั้นตอนที่ 2: วางวงจรให้ข้อมูลใช้งานจริงย้อนกลับมาพัฒนา AI
Doug เน้นแนวคิด flywheel หรือวงจรปรับปรุงต่อเนื่อง ได้แก่ แก้ไข agent ทดสอบ ปล่อยใช้งาน สังเกตผล แล้วนำสิ่งที่พบกลับมาแก้ไขอีกครั้ง จุดสำคัญคือ ข้อมูลจากงานจริงต้องมีผลต่อการพัฒนา ไม่ใช่ถูกเก็บไว้เป็นรายงานที่ไม่มีใครนำไปใช้
Observability และการประเมิน AI หรือ evals จึงทำหน้าที่ต่างกันแต่ต้องเชื่อมกัน Observability ช่วยค้นหาว่าเกิดอะไรขึ้นระหว่างใช้งาน ส่วน evals ช่วยทดสอบว่าการเปลี่ยนแปลงแก้ปัญหาได้หรือไม่ และทำให้งานเดิมถอยหลังหรือเปล่า
ขั้นตอนที่ 3: เตรียมโครงการและยืนยันว่าข้อมูลไหลเข้าถูกที่
ตัวอย่างในเวิร์กช็อปเป็น support agent ที่เขียนด้วย Python และใช้ OpenAI Agents SDK ขั้นเตรียมงานประกอบด้วยการสร้างองค์กร สร้าง project เชื่อมผู้ให้บริการ model และสร้าง Braintrust API key จากนั้นทีมเทคนิคติดตั้งส่วนประกอบของโครงการและตั้งค่า model ที่จะเรียกใช้
สิ่งที่คนทำงานควรร่วมตรวจไม่ใช่คำสั่งติดตั้ง แต่เป็นความสอดคล้องของการตั้งค่า:
- โครงการ: ชื่อ project ใน Braintrust ต้องตรงกับที่ระบบส่งข้อมูลเข้าไป
- สิทธิ์เข้าถึง: API key และบัญชีที่ใช้ต้องเข้าถึงองค์กรและ project เป้าหมายได้
- ผู้ให้บริการ model: model ที่เลือกต้องเรียกใช้ได้ผ่านผู้ให้บริการที่เชื่อมไว้
- ข้อมูลทดสอบ: ส่งคำถามหนึ่งครั้งแล้วตรวจว่ามี trace ปรากฏพร้อมขั้นตอนการทำงาน
Braintrust CLI เป็นเครื่องมือสำหรับทีมเทคนิคที่ใช้ค้น logs สร้างชุดข้อมูล และเรียก evals รวมถึงเปิดทางให้ coding agent ทำงานกับข้อมูลเหล่านี้ได้ ส่วนรายละเอียดการติดตั้งอยู่ใน โครงการตัวอย่างของเวิร์กช็อป
ข้อเสนอสำหรับธุรกิจคือแยก project ตามงานหรือ agent ให้เข้าใจง่ายก่อน เพราะ logs ชุดทดสอบ และเกณฑ์คะแนนควรอยู่ในขอบเขตงานที่สัมพันธ์กัน การรวมทุกอย่างตั้งแต่ต้นอาจทำให้ตีความผลยากขึ้น
ขั้นตอนที่ 4: กำหนดคะแนนที่สะท้อนความสำเร็จของธุรกิจ
ข้อมูลจำนวนมากยังไม่ใช่ข้อมูลที่ช่วยตัดสินใจ จนกว่าเราจะมีเกณฑ์แยกงานที่สำเร็จออกจากงานที่ผิดพลาด Braintrust ใช้ scorers เพื่อให้คะแนนได้หลายวิธี โดยเวิร์กช็อปแยกแนวทางสำคัญไว้ดังนี้
- ตรวจด้วยกฎหรือโค้ด: เหมาะกับเงื่อนไขชัดเจน เช่น เรียกเครื่องมือที่จำเป็นหรือไม่ และเรียกตามลำดับที่กำหนดหรือเปล่า
- ให้ LLM เป็นผู้ประเมิน: เหมาะกับการตัดสินที่ต้องตีความ เช่น แก้ปัญหาให้ลูกค้าได้หรือไม่ และใช้เครื่องมือเหมาะสมเพียงใด
- ให้คนตรวจเพื่อปรับเกณฑ์ของ LLM: ใช้ตรวจว่าคะแนนและเหตุผลของผู้ประเมินสอดคล้องกับมาตรฐานของทีมจริงหรือไม่
- ใช้กฎร่วมกับ LLM: รองรับการประเมินที่มีเงื่อนไขหลายขั้น ซึ่งต้องให้ทีมเทคนิคช่วยจัดทำ
ตัวอย่าง support agent ใช้คะแนนทั้งการเรียกเครื่องมือที่จำเป็น การแก้ปัญหาบริการลูกค้า และความเหมาะสมของการใช้เครื่องมือ เมื่อเปิดประเมินข้อมูลใช้งานจริงยังเพิ่มการประเมินการสื่อสารด้วย ทำให้เราไม่ต้องพึ่งคะแนนก้อนเดียวเพื่ออธิบายทุกอย่าง
Doug แนะนำให้เริ่มด้วยคะแนนแบบผ่านหรือไม่ผ่าน พร้อมตัวอย่างที่ท้าทาย และให้ LLM อธิบายเหตุผล มุมนี้เหมาะกับงานที่มีข้อกำหนดชัดเจน แต่ไม่จำเป็นต้องใช้กับทุกเรื่อง งานที่มีระดับความสำเร็จหลายแบบอาจต้องการเกณฑ์ละเอียดกว่า สิ่งสำคัญคือทีมต้องเห็นตรงกันว่าคะแนนหมายถึงอะไร
คะแนนเต็มทุกเคสไม่ใช่หลักฐานว่า agent พร้อมเสมอไป อาจหมายถึงชุดทดสอบง่ายเกินไป หรือผู้ประเมินให้คะแนนผ่อนปรนเกินไป แนวทางออกแบบชุดประเมินเพิ่มเติมอ่านได้จาก คู่มือแนวปฏิบัติด้านการประเมินของ OpenAI
ขั้นตอนที่ 5: สร้างผลทดสอบตั้งต้น แล้วประเมินงานจริงตามขอบเขตที่เหมาะสม
ก่อนเปลี่ยน agent ควรมีผลทดสอบตั้งต้นหรือ baseline ไว้เปรียบเทียบ การประเมินแบบ offline ใช้ชุดเคสที่เตรียมไว้เพื่อตัดสินใจว่าการเปลี่ยนแปลงควรถูกนำไปใช้งานหรือไม่ ส่วนการประเมินแบบ online ให้คะแนนข้อมูลจากการใช้งานจริงเพื่อค้นหาปัญหาที่กำลังเกิดขึ้น
ใน Braintrust ทีมสามารถเผยแพร่ scorers แล้วสร้าง automation ให้ทำงานเมื่อมี logs เข้ามา แต่ต้องเลือกขอบเขตให้ตรงกับคำถามที่ต้องการประเมิน
- Span: ตรวจขั้นตอนเฉพาะ เช่น ผลลัพธ์จากการค้นนโยบาย
- Trace: ตรวจลำดับการทำงานภายใน trace หนึ่งรายการ
- Group: รวมหลาย traces ด้วยรหัสร่วม เช่น รหัสบทสนทนา เพื่อประเมินงานที่มีหลายรอบสนทนา
หากลูกค้าคุยต่อเนื่องหลายครั้ง แต่ระบบประเมินเฉพาะข้อความท้ายสุด คะแนนอาจขาด context ของปัญหา การใช้ข้อมูลบทสนทนารวมและกำหนดช่วงเวลาประมวลผลจึงสำคัญ โดยเฉพาะงานที่ไม่ได้จบภายในครั้งเดียว
อีกเรื่องที่ต้องคุมคือ sampling หรือสัดส่วนข้อมูลที่นำมาประเมิน LLM judges เรียก model ผ่านผู้ให้บริการที่ทีมตั้งค่าไว้ จึงมีค่าใช้จ่ายตามการเรียกใช้งาน การตั้ง 100% ในตัวอย่างช่วยให้เห็นผลชัด แต่ไม่ใช่คำแนะนำให้ทุกธุรกิจทำเช่นนั้นตลอดเวลา
แนวทางของ Doug คือช่วงเริ่มใช้งานอาจตรวจในสัดส่วนสูง แล้วลดลงเมื่อ agent มีความเสถียรมากขึ้น เราควรใช้แนวคิดนี้ร่วมกับระดับความเสี่ยงของงาน ไม่ใช่ลดการตรวจเพียงเพราะระบบใช้งานมานาน
ขั้นตอนที่ 6: ใช้ Topics ค้นหาปัญหาที่เกณฑ์เดิมมองไม่เห็น
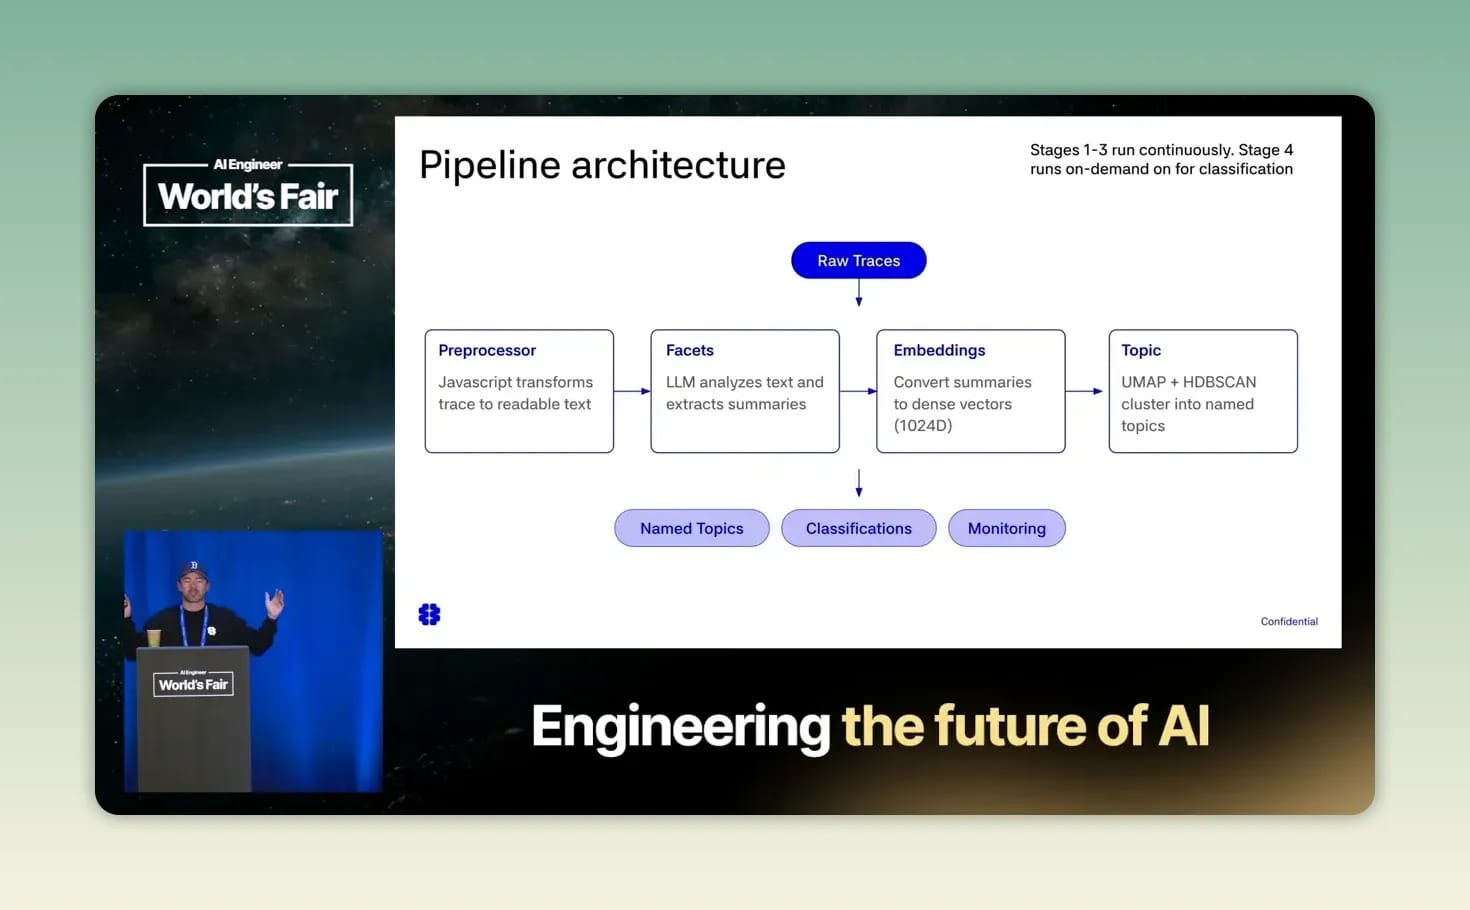
Scorers ตรวจสิ่งที่เรารู้แล้วว่าต้องตรวจ แต่ลูกค้าอาจใช้ agent ในรูปแบบที่ทีมไม่เคยเตรียมไว้ Topics จึงเข้ามาช่วยค้นรูปแบบในข้อมูล จัดกลุ่ม และแสดงความถี่ของสิ่งที่เกิดขึ้น
มุมวิเคราะห์สำเร็จรูปของ Topics มีสามด้าน ได้แก่ งานที่ลูกค้าต้องการทำ ความรู้สึกระหว่างสนทนา และปัญหาของ agent ทีมยังสร้าง custom facet หรือมุมวิเคราะห์เฉพาะงานได้ โดยเขียน prompt ระบุว่าสนใจค้นหาอะไร
กระบวนการเบื้องหลังเริ่มจากย่อ trace ให้เหลือข้อมูลที่มีความหมาย เช่น ข้อความสนทนาและการเรียกเครื่องมือ จากนั้นสรุปตามมุมวิเคราะห์ แปลงเป็นข้อมูลเชิงความหมายเพื่อจัดกลุ่ม แล้วติดป้ายให้ traces กลับไปค้นต่อได้ ทีมสามารถปรับตัวเตรียมข้อมูลได้ หากข้อมูลสำคัญอยู่ใน metadata หรือขั้นตอนที่วิธีเริ่มต้นไม่ได้ดึงมา
ตัวอย่างที่น่าสนใจคือมุมวิเคราะห์ปัญหาสำเร็จรูปไม่ได้สร้างกลุ่ม issues ในข้อมูลทดลอง Doug จึงสร้าง custom facet สำหรับปัญหา workflow ของงานบริการลูกค้า และกรองผลลัพธ์ที่หมายถึง “ไม่มีปัญหา” ออก
บทเรียนคือเกณฑ์สำเร็จรูปไม่จำเป็นต้องตรงกับงานของเรา ธุรกิจไทยที่นำไปใช้กับงานคืนเงินควรให้ทีมบริการลูกค้าช่วยอธิบายลักษณะความผิดพลาด แทนการใช้คำกว้างๆ อย่าง “คำตอบไม่ดี” ซึ่งยากต่อการนำไปแก้ไข
ต้องแยกข้อจำกัดด้วยว่า ในเวิร์กช็อป ขั้นสรุปและสร้าง embedding ของ Topics ใช้ model ที่ Braintrust ให้บริการ ไม่ได้เปิดให้สลับ model ได้เหมือน LLM judges และชื่อกลุ่มที่ระบบสร้างยังเป็นข้อค้นพบที่ควรตรวจหลักฐาน ไม่ใช่ข้อสรุปสาเหตุโดยอัตโนมัติ
ขั้นตอนที่ 7: ตรวจเคสตัวแทน ก่อนตัดสินใจว่าควรแก้อะไร
เมื่อนำข้อมูลตัวอย่าง 968 traces ซึ่งมี 5,260 spans เข้าระบบ จะเริ่มเห็นทั้งคะแนนและป้ายจาก Topics เคสหนึ่งเกี่ยวกับลูกค้าติดตามเงินคืน โดยระบบระบุความรู้สึกเชิงลบ และ custom facet พบว่าการค้นออเดอร์ทั้งจากเลขออเดอร์และการค้นลูกค้าไม่พบข้อมูล
แผนที่ Topics ยังช่วยให้เห็นงานที่พบถี่ เช่น การจัดการสินค้าเสียหายระหว่างขนส่ง ข้อมูลแบบนี้มีประโยชน์สองทาง คือค้นจุดผิดพลาด และค้นความต้องการที่ agent อาจยังรองรับไม่ครบ
ขั้นต่อไปคือกรองข้อมูลด้วยหัวข้อ คะแนน และความรู้สึก แล้วเปิด trace ตัวแทนเพื่อตรวจรายละเอียด มุมมองบทสนทนาช่วยอ่านการโต้ตอบ ส่วนมุมมองลำดับเวลาช่วยดูคอขวดของการทำงาน
Loop ซึ่งเป็นผู้ช่วยภายใน Braintrust สามารถรับคำถามว่าควรปรับปรุง support agent ตรงไหน แล้วค้นข้อมูลด้วย SQL เพื่อนำเฉพาะหลักฐานที่เกี่ยวข้องมาวิเคราะห์ ทีมจึงไม่ต้องดึงทุก trace เข้าไปใน context ของ AI อีกตัว
อย่างไรก็ตาม ความรู้สึกเชิงลบของลูกค้าไม่เท่ากับความผิดของ agent ทุกครั้ง ลูกค้าอาจไม่พอใจธุรกรรมที่ยังค้างอยู่ แม้ AI อธิบายถูกต้องแล้ว เราต้องอ่านร่วมกับคะแนนการแก้ปัญหาและผลลัพธ์ของเครื่องมือ เพื่อไม่แก้ผิดจุด
ขั้นตอนที่ 8: เปลี่ยนปัญหาจริงเป็นชุดทดสอบ และให้คนอนุมัติการแก้ไข
เมื่อพบเคสที่มีหลักฐานชัดเจน ให้นำกลับเข้า evaluation dataset พร้อมผลลัพธ์ที่ควรได้ จากนั้นแก้ agent และรัน evals เปรียบเทียบกับ baseline ทั้งเคสใหม่และเคสเดิม หากค้นพบรูปแบบความผิดพลาดใหม่ ก็ควรพิจารณาเพิ่ม scorer เพื่อจับปัญหานั้นก่อนปล่อยใช้งานครั้งถัดไป
ช่วงท้ายเวิร์กช็อปใช้ coding agent ร่วมกับ Braintrust CLI และชุดคำแนะนำสำหรับปรับปรุง agent เพื่อค้น logs ตรวจ traces เสนอการแก้ไข เพิ่มเคสทดสอบ และเรียก evals สิ่งที่สำคัญสำหรับผู้บริหารไม่ใช่ว่า AI เขียนโค้ดได้ แต่คือข้อเสนอเปลี่ยนแปลงมีหลักฐานรองรับหรือไม่
ตัวอย่าง automation ผ่าน GitHub Actions จัดผลวิเคราะห์และข้อเสนอเป็นคำขอแก้ไขโค้ดหรือ PR สำหรับคนตรวจ โดยควรมี:
- รายการสิ่งที่เปลี่ยนและเหตุผลที่เปลี่ยน
- หลักฐานจากเคสใช้งานจริง
- ผลประเมินก่อนและหลัง
- เคสที่ดีขึ้นและเคสที่ถอยหลัง
- ลิงก์สำหรับย้อนตรวจรายละเอียด
ในเวลาที่สาธิตยังไม่มีปุ่มเดียวภายใน platform ที่สั่งให้ทำวงจรทั้งหมด และ Braintrust เองไม่ได้เข้าถึงโค้ดของ agent โดยตรง การแก้ไขเฉพาะส่วนจึงต้องเชื่อมกับ coding agent ที่เข้าถึงโครงการได้ เราควรมองสิ่งนี้เป็น ระบบช่วยเสนอการปรับปรุงที่คนตรวจได้ ไม่ใช่ระบบที่พิสูจน์แล้วว่าสามารถปล่อยแก้ตัวเองได้โดยไม่ต้องกำกับ
ขั้นตอนที่ 9: เปิดให้ทีมธุรกิจร่วมทดสอบ พร้อมกำหนดสิทธิ์ข้อมูล
ฟีเจอร์ remote eval เปิดทางให้ผู้เชี่ยวชาญงานและทีมผลิตภัณฑ์ปรับ prompt หรือ model ผ่าน playground แล้วเรียกการประเมินได้ โดยการทำงานของโค้ดยังคงอยู่บนเซิร์ฟเวอร์ประเมิน และส่งผลกลับมาให้เปรียบเทียบ
สำหรับทีมไทย นี่เป็นทางเลือกให้หัวหน้าฝ่ายบริการลูกค้าทดลองคำแนะนำการทำงานของ agent โดยไม่ต้องเข้าไปแก้ระบบเอง แต่ต้องให้ทีมเทคนิคเปิดพารามิเตอร์ที่เหมาะสมไว้ก่อน จึงเป็นการร่วมทำงานแบบ low-code ไม่ใช่การตั้งระบบทั้งหมดโดยไม่พึ่งผู้พัฒนา
เรื่องข้อมูลต้องตัดสินใจก่อนขยายใช้งาน Braintrust อธิบายทางเลือกทั้ง SaaS, BYOC และ hybrid ซึ่งสามารถเก็บ traces ชุดข้อมูล และผลทดลองไว้ในโครงสร้างพื้นฐานขององค์กร ขณะที่ส่วนเว็บและข้อมูลควบคุมบางส่วนยังอยู่กับผู้ให้บริการ ตัวเลือก hybrid ถูกระบุว่าอยู่ในแผน enterprise ระหว่างเวิร์กช็อป จึงควรตรวจเงื่อนไขล่าสุดก่อนตัดสินใจ
อีกแนวทางคือจำกัดผู้เข้าถึง traces แล้วให้บัญชีบริการทำการวิเคราะห์ เพื่อส่งเฉพาะผลรวมและข้อค้นพบให้ผู้เกี่ยวข้อง ประเด็นสำหรับธุรกิจคือ คนที่ต้องตัดสินใจไม่จำเป็นต้องเห็นข้อมูลลูกค้าดิบทุกคน แต่ต้องมีหลักฐานเพียงพอให้ตรวจข้อเสนอได้
ขั้นตอนที่ 10: นำข้อคิดไปลงมือใช้กับงานจริง
- เลือกหนึ่ง workflow ก่อน: เริ่มจากงานบริการลูกค้าที่มีผลลัพธ์ชัด เช่น ค้นออเดอร์และติดตามเงินคืน
- เขียนเกณฑ์สำเร็จร่วมกัน: แยกการสื่อสาร การใช้เครื่องมือ และการแก้ปัญหา ไม่รวมเป็นคะแนนเดียว
- มี baseline ก่อนเปลี่ยน: เก็บชุดทดสอบและผลเดิม เพื่อแยกความรู้สึกว่าดีขึ้นออกจากหลักฐาน
- ทบทวนเคสจากงานจริง: เลือกเคสที่คะแนนต่ำหรือพบรูปแบบใหม่ แล้วเพิ่มเข้าชุดประเมิน
- เริ่มอัตโนมัติที่การวิเคราะห์: ให้ AI รวบรวมหลักฐานและเสนอการแก้ไขก่อน โดยยังให้คนอนุมัติการปล่อยใช้งาน
ขั้นตอนที่ 11: แก้ปัญหาที่พบบ่อยระหว่างทำตาม
ส่งคำถามแล้วไม่พบ trace
- ปัญหา: Agent ตอบได้ แต่หน้า logs ไม่มีข้อมูลใหม่
- สาเหตุ: การเชื่อม tracing, API key, องค์กร หรือ project อาจไม่ตรงกัน
- วิธีแก้: ตรวจชื่อ project และสิทธิ์บัญชี ยืนยันการตั้งค่า tracing แล้วส่งคำถามทดสอบใหม่หนึ่งครั้ง
Topics ไม่สร้างกลุ่มปัญหา
- ปัญหา: มีข้อมูลเข้า แต่ไม่เห็นหัวข้อ issues
- สาเหตุ: Prompt สำเร็จรูปอาจไม่ตรงกับงาน หรือมีผล facet ที่เข้าเงื่อนไขไม่พอ ในตัวอย่างระบบต้องการอย่างน้อย 100 ผลที่ตรงเกณฑ์เพื่อสร้างกลุ่ม
- วิธีแก้: ตรวจผล facet รายเคส สร้างมุมวิเคราะห์เฉพาะ workflow และตรวจตัวกรองกับช่วงข้อมูลก่อนสรุปว่าไม่มีปัญหา
คะแนนไม่ตรงกับข้อสรุปของทีม
- ปัญหา: LLM ให้ผ่าน แต่ทีมบริการลูกค้าเห็นว่างานยังไม่จบ
- สาเหตุ: เกณฑ์กว้างเกินไป หรือข้อมูลที่ส่งประเมินขาด context
- วิธีแก้: อ่านเหตุผลของคะแนน เพิ่มตัวอย่างผ่านและไม่ผ่าน ใช้บทสนทนารวมเมื่อจำเป็น และให้คนตรวจเพื่อปรับเกณฑ์
ค่าใช้จ่ายประเมินสูงกว่าที่คาด
- ปัญหา: หลังเปิด automation มีการเรียก model เพิ่มมาก
- สาเหตุ: ใช้ LLM judges หลายตัวกับข้อมูลทั้งหมดโดยไม่จำกัดขอบเขต
- วิธีแก้: ลด sampling ใช้ตัวกรอง เลือกตรวจขั้นตอนที่จำเป็น และพิจารณา Topics สำหรับงานจัดหมวดหมู่หลังตรวจว่าผลเหมาะกับงานแล้ว
ประเมินบทสนทนายาวแล้วได้ผลคลาดเคลื่อน
- ปัญหา: ระบบตัดสินจากบางช่วง ทั้งที่ลูกค้าคุยต่อเนื่องหลายรอบ
- สาเหตุ: แต่ละรอบอยู่คนละ trace หรือเริ่มประมวลผลก่อนบทสนทนาครบ
- วิธีแก้: บันทึกรหัสบทสนทนาร่วม ใช้การรวมกลุ่ม และปรับช่วงรอประมวลผลตามระยะเวลาของงานจริง
ขั้นตอนที่ 12: ต่อยอดจากการจับข้อผิดพลาดสู่การพัฒนาบริการ
- สร้างรายงานความต้องการลูกค้า: ใช้ Topics ดูว่างานใดถูกขอซ้ำ แต่ agent ยังรองรับไม่ครบ เพื่อประกอบการจัดลำดับพัฒนาบริการ
- ทดสอบการเปลี่ยน model: ใช้ชุดประเมินเดิมตรวจว่า model ใหม่ยังรักษามาตรฐานงานได้หรือไม่ แทนการตัดสินจากราคาเพียงอย่างเดียว
- ทำรอบเสนอปรับปรุงตามกำหนด: ให้ automation รวบรวมปัญหา เคสทดสอบ และหลักฐานก่อนหลัง ส่งให้ทีมพิจารณาเป็นรอบๆ
Dashboard ในการสาธิตมีขอบเขตระดับ project หากต้องการภาพรวมหลายโครงการระดับองค์กร ยังต้องค้นและดึงข้อมูลมาประกอบเพิ่มเติม ข้อจำกัดนี้ควรอยู่ในแผนก่อนขยายจาก agent ตัวเดียวไปหลายฝ่าย
ขั้นตอนที่ 13: สรุปรายการตรวจสอบทั้งหมด
- ☐ เลือก workflow และกำหนดผลลัพธ์ที่เรียกว่าสำเร็จ
- ☐ แต่งตั้งผู้รับผิดชอบตรวจปัญหาและอนุมัติการเปลี่ยนแปลง
- ☐ สร้างองค์กรและ project พร้อมเชื่อมผู้ให้บริการ model
- ☐ ตรวจ API key สิทธิ์เข้าถึง และชื่อ project ให้ตรงกัน
- ☐ ยืนยันว่า traces บันทึกการสนทนาและขั้นตอนสำคัญครบ
- ☐ สร้าง scorers ที่แยกมิติของงานและให้คนตรวจเกณฑ์
- ☐ รัน evals เพื่อเก็บ baseline ก่อนแก้ไข agent
- ☐ ตั้ง online automation พร้อมขอบเขตและ sampling
- ☐ เชื่อมบทสนทนาหลายรอบด้วยรหัสร่วมและช่วงเวลาที่เหมาะสม
- ☐ เปิด Topics และเพิ่ม custom facet หากเกณฑ์เดิมไม่ตรงงาน
- ☐ ตรวจ trace ตัวแทนเพื่อยืนยันข้อค้นพบและสาเหตุ
- ☐ นำปัญหาจริงกลับเข้าชุดทดสอบ พร้อมเพิ่ม scorer เมื่อจำเป็น
- ☐ เปรียบเทียบผลก่อนหลัง รวมถึงงานเดิมที่อาจถอยหลัง
- ☐ ให้คนตรวจข้อเสนอแก้ไขก่อนปล่อยใช้งาน
- ☐ เปิดพื้นที่ให้ทีมธุรกิจร่วมทดสอบ และจำกัดสิทธิ์ข้อมูลตามหน้าที่
- ☐ ทบทวนต้นทุน เกณฑ์ประเมิน และชุดทดสอบเมื่อ agent เปลี่ยนไป
AI Observability ที่มีประโยชน์ต้องจบที่การตัดสินใจ ไม่ใช่จบที่ dashboard บทเรียนจาก Braintrust คือการเชื่อม traces คะแนน และรูปแบบจาก Topics กลับไปสู่การทดสอบและการแก้ไข สำหรับธุรกิจไทย จุดเริ่มต้นที่เหมาะสมจึงไม่ใช่ซื้อเครื่องมือให้ครบ แต่คือเลือกงานหนึ่งอย่าง มองเห็นขั้นตอนของมัน และสร้างวงจรที่ทุกการปรับปรุงมีหลักฐานให้ตรวจสอบ
ที่มา: Advanced Workshop: Mastering AI Observability — Doug Guthrie, Braintrust — วันที่เผยแพร่วิดีโอ 2026-10-06T01:00:25Z (UTC; 06/10/2026 08:00:25 เวลาไทย) บทวิเคราะห์และตัวอย่างการประยุกต์เป็นข้อเสนอของกองบรรณาธิการ
