


AI Agent ที่ทำงานได้เองนานขึ้น ไม่ได้ต้องการแค่ model ที่เก่งขึ้น แต่ต้องการขอบเขตที่ชัดขึ้นด้วย คำถามสำคัญสำหรับธุรกิจจึงไม่ใช่เพียง “AI ทำงานนี้ได้ไหม” แต่คือ “ถ้า AI ทำพลาด มันแตะอะไรได้บ้าง” โดยเฉพาะเมื่อเราเริ่มมอบหมายงานที่เชื่อมกับเอกสารภายใน เว็บไซต์ และระบบงานจริง
Jim Clark วิศวกรจาก Docker เสนอแนวคิดนี้ในคลิปบนช่อง AI Engineer ผ่านคำตอบที่ฟังดูสุดโต่ง: จำนวนข้อมูลลับสำหรับเข้าถึงระบบที่ควรอยู่ในพื้นที่ทำงานของ Agent คือศูนย์ เขาอธิบายผ่านการแยกหน้าที่ในกองบรรณาธิการ การใช้กุญแจลงนามเฉพาะตอนบันทึกโค้ด และการควบคุมเครื่องมือผ่าน MCP Gateway
ประเด็นที่น่านำมาวิเคราะห์สำหรับเจ้าของธุรกิจไทยคือ เราไม่จำเป็นต้องเลือกระหว่าง AI ที่ทำอะไรไม่ได้ กับ AI ที่ได้รับสิทธิ์ทุกอย่าง ทางเลือกที่ดีกว่าคือให้สิทธิ์ตามหน้าที่ ตามช่วงเวลา และตามสิ่งที่งานนั้นต้องใช้จริง โดยไม่ฝากความปลอดภัยทั้งหมดไว้กับ prompt
ขั้นตอนที่ 1: ตั้งโจทย์ความปลอดภัยของ AI Agent ก่อนเลือกเครื่องมือ
Clark เริ่มจากความเปลี่ยนแปลงของ Agent ที่รับงานยาวขึ้นและต้องการการกำกับน้อยลง ความสามารถนี้มีประโยชน์ แต่ทำให้การนั่งอนุมัติทุกการกระทำไม่ใช่รูปแบบการทำงานที่ยั่งยืน หากต้องคอยเฝ้าทุกนาที ประโยชน์ของการมอบหมายงานก็ลดลงมาก
สิ่งที่ต้องเปลี่ยนจึงเป็นวิธีออกแบบความไว้วางใจ จากการหวังว่า Agent จะตัดสินใจถูกทุกครั้ง ไปเป็นการกำหนดว่า ต่อให้ตัดสินใจผิด ความเสียหายจะหยุดอยู่ตรงไหน
ก่อนเชื่อม AI เข้ากับระบบธุรกิจ เราควรตอบคำถามสามข้อให้ได้:
- ต้องรู้อะไร: งานนี้ต้องใช้เอกสาร ข้อมูล หรือแหล่งข้อมูลใด
- ต้องทำอะไร: อ่านอย่างเดียว สร้างร่าง แก้ไขข้อมูล หรือเผยแพร่ผลลัพธ์
- ห้ามแตะอะไร: ระบบหรือข้อมูลใดไม่เกี่ยวกับงาน แม้จะเชื่อมต่อได้ก็ตาม
ขั้นตอนที่ 2: แยกตัวขับเคลื่อน Agent ออกจากพื้นที่ทำงาน
เพื่อเข้าใจแนวคิดของ Docker ต้องแยกองค์ประกอบสามส่วนออกจากกันก่อน โดยไม่จำเป็นต้องลงรายละเอียดทางเทคนิคทั้งหมด
- ตัวขับเคลื่อน Agent หรือ harness: ระบบที่นำ context เข้า model เรียกเครื่องมือ รับผลลัพธ์ แล้ววนทำงานต่อ
- พื้นที่ทำงานแยก หรือ sandbox: สภาพแวดล้อมที่กำหนดว่า Agent เข้าถึงไฟล์ เครื่องมือ และเครือข่ายใดได้
- MCP: มาตรฐานเชื่อม Agent กับเครื่องมือ แหล่งข้อมูล และ prompt ที่ระบบจัดเตรียมให้
Clark มองว่า harness เป็นวงจรการทำงานที่ค่อนข้างเรียบง่าย และเราจะเปลี่ยนไปใช้หลายตัวตามความสามารถใหม่ที่เกิดขึ้น ดังนั้น ขอบเขตความปลอดภัยไม่ควรผูกติดกับตัวใดตัวหนึ่งมากเกินไป
สิ่งที่ต้องควบคุมคือ ข้อมูลและเครื่องมือที่ไหลเข้าไปในวงจรนั้น หาก Agent อ่านได้ทุกไฟล์ ใช้อินเทอร์เน็ตได้ทั้งหมด และเรียกเครื่องมือที่เปลี่ยนข้อมูลจริงได้พร้อมกัน ความเสี่ยงก็เกิดจากชุดความสามารถนี้ ไม่ใช่แค่ชื่อ model ที่เลือกใช้
สำหรับคนทำงาน คำว่า sandbox จึงไม่ควรถูกเข้าใจว่าเป็นเพียง “พื้นที่ทดลอง” เพราะพื้นที่นี้อาจถูกใช้ทำงานจริงด้วย หน้าที่หลักคือจำกัดพื้นที่ที่ Agent ลงมือทำได้ ส่วน sandbox จะปลอดภัยแค่ไหนยังขึ้นกับการตั้งค่าขอบเขต ไม่ใช่การมีชื่อนี้อยู่ในระบบเท่านั้น
ขั้นตอนที่ 3: แบ่ง workflow เป็นหน้าที่ที่ไม่ถือสิทธิ์อันตรายพร้อมกัน
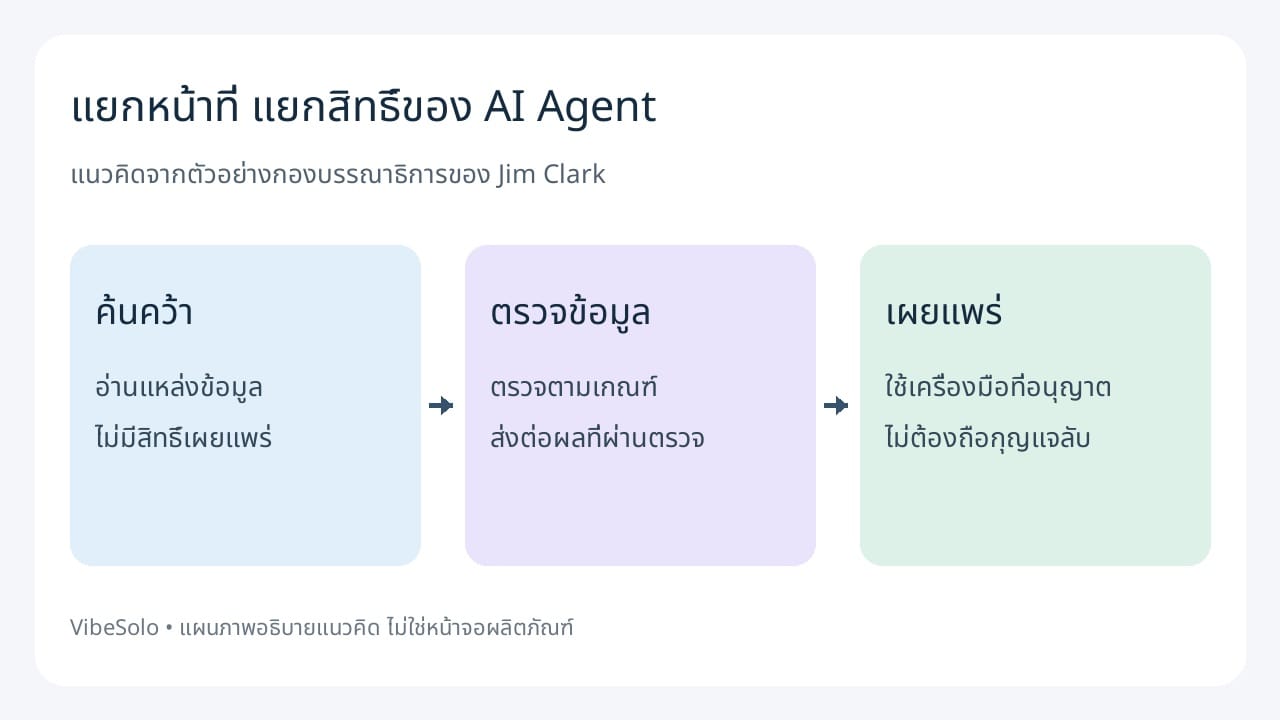
ตัวอย่างกองบรรณาธิการของ Clark อธิบายเรื่องนี้ได้ชัดที่สุด แทนที่จะให้ Agent ตัวเดียวค้นข้อมูล ตรวจข้อเท็จจริง และเผยแพร่บทความ เขาแยกออกเป็นสามหน้าที่ พร้อม sandbox คนละชุด
หน้าที่ค้นคว้า
Agent ส่วนนี้ออกไปอ่านข้อมูลบนอินเทอร์เน็ตได้กว้าง เพราะหน้าที่คือรวบรวมข้อมูล แต่ไม่มีสิทธิ์เผยแพร่ลงเว็บไซต์ ผลการค้นคว้าถูกเขียนไว้ในพื้นที่ทำงานที่กำหนด ไม่ใช่ส่งตรงขึ้นระบบเผยแพร่
หน้าที่ตรวจข้อเท็จจริง
Agent ส่วนนี้รับผลการค้นคว้าและใช้ฐานข้อมูลข้อเท็จจริงที่เตรียมไว้ ในตัวอย่างไม่ได้รับสิทธิ์ออกอินเทอร์เน็ตทั่วไป เป้าหมายคือคัดกรองข้อมูล ก่อนส่งต่อไปยังขั้นตอนที่มีสิทธิ์ลงมือกับระบบจริง
หน้าที่จัดทำและเผยแพร่
ส่วนสุดท้ายรับเฉพาะข้อมูลที่ผ่านการคัดกรอง และมีเครื่องมือ MCP สำหรับเผยแพร่ โดยไม่จำเป็นต้องเข้าถึงอินเทอร์เน็ตอย่างอิสระอีก
หัวใจของตัวอย่างนี้คือ ไม่ให้ข้อมูลภายนอกที่ยังไม่น่าเชื่อถืออยู่ร่วมกับเครื่องมือที่ทำสิ่งอันตรายได้ในขั้นตอนเดียวกัน ทั้ง workflow อาจมีความสามารถครบ แต่แต่ละหน้าที่ไม่จำเป็นต้องถือความสามารถทั้งหมด
หากนำมาประยุกต์กับทีมการตลาดไทย รูปแบบที่เสนอได้คือ แยกการค้นข้อมูลออกจากการตรวจข้อมูลสินค้า แล้วให้ขั้นตอนเผยแพร่รับเฉพาะงานที่ผ่านการตรวจแล้ว ทีมอาจเพิ่มการอนุมัติโดยคนก่อนเผยแพร่ในช่วงเริ่มต้น ข้อนี้เป็นข้อเสนอสำหรับการใช้งานธุรกิจ ไม่ใช่ขั้นตอนที่ Clark สาธิตไว้
อย่างไรก็ตาม การมี Agent ตรวจข้อเท็จจริงไม่ได้รับประกันว่าข้อมูลจะถูกต้องทั้งหมด การแยกหน้าที่ช่วยลดการกระจุกตัวของสิทธิ์ แต่เกณฑ์ตรวจ แหล่งอ้างอิง และสิ่งที่ส่งต่อระหว่างขั้นตอนยังต้องออกแบบให้ดี
ขั้นตอนที่ 4: ให้ความสามารถเฉพาะช่วงที่ต้องใช้
ตัวอย่างที่สองเป็น Agent เขียนโค้ดซึ่งทำงานประมาณหนึ่งชั่วโมง และบันทึกการเปลี่ยนแปลงเป็นระยะผ่าน Git commit ในเวลาทั้งหมดนั้น งานลงนาม commit อาจต้องใช้กุญแจเพียงประมาณสองนาที
Clark จึงตั้งคำถามว่า ทำไมพื้นที่ที่ใช้เขียนโค้ดต้องมีกุญแจลงนามอยู่ตลอดทั้งชั่วโมง ทั้งที่ช่วงส่วนใหญ่ไม่ได้ทำหน้าที่ลงนามเลย
แนวคิดคือแยกงาน commit เป็นงานเฉพาะ เมื่อถึงขั้นตอนนี้ ระบบจึงเปิดความสามารถที่จำเป็นต่อการตรวจชุดการเปลี่ยนแปลงและลงนาม ไม่ต้องนำความสามารถนั้นไปอยู่ในพื้นที่เขียนโค้ดตลอดเวลา
สำหรับธุรกิจ บทเรียนที่นำไปใช้ได้คือ สิทธิ์ไม่ได้มีเพียงมิติว่าใครใช้ได้ แต่มีมิติว่าใช้เมื่อไรด้วย หากเราประยุกต์กับงานเนื้อหา สิทธิ์เผยแพร่ก็ไม่จำเป็นต้องเปิดตั้งแต่ตอนเริ่มค้นข้อมูล และไม่จำเป็นต้องคงอยู่หลังเผยแพร่เสร็จ
จุดที่ต้องระวังคือ “ให้ความสามารถชั่วคราว” ไม่จำเป็นต้องแปลว่า “ส่งกุญแจลับให้ Agent ชั่วคราว” เมื่อเชื่อมกับหลักการถัดไป แนวทางที่สอดคล้องกันคือให้ชั้นบริการที่ได้รับอนุญาตจัดการความลับ แล้วให้ Agent เรียกการกระทำที่อนุญาตผ่านเครื่องมือ
ขั้นตอนที่ 5: รวมการเชื่อมเครื่องมือไว้ที่ MCP Gateway
Docker เสนอให้แต่ละ sandbox มีจุดเชื่อม MCP Gateway หนึ่งจุด การเรียกเครื่องมือและการเข้าถึงทรัพยากรผ่าน MCP จึงวิ่งผ่านจุดควบคุมเดียว แทนที่จะให้ Agent ตั้งค่าการเชื่อมต่อแต่ละบริการเองทั้งหมด
Gateway ทำหน้าที่กำหนดว่า sandbox แต่ละแห่งเห็นเครื่องมือ ทรัพยากร และ prompt อะไรได้บ้าง ตัวขับเคลื่อน Agent จึงมีหน้าที่เรียกใช้สิ่งที่ได้รับ ไม่ใช่เป็นเจ้าของการตั้งค่าสิทธิ์ทุกระบบ
ประโยชน์อีกด้านคือการสลับ harness เช่น Codex หรือ Claude Code โดยไม่ต้องจัดการ MCP ของทุกตัวด้วยวิธีแยกกันทั้งหมด ในภาพที่ Clark เสนอ เราเลือกตัวขับเคลื่อน เลือกเครื่องมือ MCP และกำหนดกฎเครือข่ายให้ตรงกับงาน
สำหรับเจ้าของธุรกิจ ประเด็นนี้มีค่ามากกว่าความสะดวกในการตั้งค่า เพราะช่วยแยก นโยบายขององค์กร ออกจาก เครื่องมือ AI ที่ทีมกำลังทดลอง เราจึงเปลี่ยนเครื่องมือได้โดยไม่ควรต้องเปลี่ยนหลักการอนุญาตใหม่ทุกครั้ง
แต่ Gateway ไม่ใช่กำแพงวิเศษ หาก sandbox ยังเข้าถึงไฟล์ลับหรือออกเครือข่ายผ่านทางอื่นได้ การควบคุม MCP เพียงทางเดียวก็ยังไม่ครอบคลุมทั้งหมด แนวคิดนี้จึงต้องทำร่วมกับขอบเขตไฟล์และกฎเครือข่ายของ sandbox
ขั้นตอนที่ 6: เอาข้อมูลลับออกจาก sandbox แล้วเชื่อมกับระบบยืนยันตัวตน
คำตอบ “ศูนย์” ในชื่อคลิปหมายถึงจำนวน credentials ที่ควรอยู่ใน sandbox หรือพื้นที่ที่ Agent ทำงาน เช่น กุญแจและข้อมูลลับที่ใช้เข้าถึงบริการ ไม่ได้หมายความว่า Agent ต้องไม่มีสิทธิ์ทำอะไรเลย และไม่ได้หมายความว่าระบบทั้งหมดไม่ใช้ credentials
หลักการของ Clark คือให้ข้อมูลลับอยู่ในชั้น MCP ที่รับผิดชอบการเรียกบริการ ไม่ใช่อยู่ใน harness หรือพื้นที่ทำงานทั่วไปของ Agent การทำเช่นนี้ช่วยลดขอบเขตความเสียหายหาก Agent ทำสิ่งที่ไม่ควรทำ
ส่วนการระบุว่า Agent มีสิทธิ์ทำอะไร เขาเชื่อมกับ Cross App Access หรือ XAA ซึ่ง Docker ทำงานร่วมกับ Anthropic และ Okta แนวคิดคือใช้ระบบยืนยันตัวตนและ SSO ที่องค์กรลงทุนไว้แล้ว แทนการแจกกุญแจแยกให้ Agent สำหรับทุกแอป
ระบบต้องระบุได้ว่า Agent เป็นใคร ทำงานแทนใคร และได้รับอนุญาตให้ทำการกระทำใดกับบริการปลายทาง เช่น Notion, Atlassian, GitHub หรือ Slack การอนุญาตจึงอาศัยตัวตนและนโยบายเดิมขององค์กร มากกว่าการครอบครองกุญแจแบบกว้าง ๆ
มุมที่ต้องไม่ตีความเกินคือ การมี SSO อยู่แล้วไม่ได้ทำให้ทุกแอปรองรับ Agent โดยอัตโนมัติ องค์กรยังต้องตรวจการรองรับของบริการและวิธีเชื่อมต่อ สำหรับธุรกิจที่ยังไม่มีระบบตัวตนส่วนกลาง จุดเริ่มต้นอาจเป็นการจัดระเบียบสิทธิ์และที่เก็บข้อมูลลับก่อน ไม่จำเป็นต้องเริ่มจาก XAA ทันที
แนวคิดจำกัดความสามารถนี้สอดคล้องกับความเสี่ยงที่ OWASP อธิบายไว้เรื่องการให้ AI มีอำนาจเกินจำเป็น ส่วนรายละเอียดการเชื่อมตัวตนสามารถศึกษาเพิ่มจาก ข้อมูล Cross App Access ของ Okta
ขั้นตอนที่ 7: เปิดเครื่องมือทีละส่วนตามเจตนาของงาน
Clark ใช้แนวคิด progressive disclosure หรือการเปิดเผยความสามารถตามความจำเป็น แม้ทั้ง workflow จะใช้ MCP server จำนวนมาก แต่ sandbox แต่ละแห่งไม่จำเป็นต้องเห็นทั้งหมดตั้งแต่เริ่ม
ผลที่ได้คือพื้นที่ทำงานแต่ละส่วนมีขอบเขตเล็กลง และ context ที่เกี่ยวกับเครื่องมือก็ไม่ต้องบรรทุกสิ่งที่ยังไม่ใช้ ความสามารถของทั้งระบบยังคงอยู่ แต่ถูกแจกจ่ายไปตามหน้าที่
ตัวประสานงาน หรือ orchestrator จึงไม่ได้ทำแค่ส่งงานให้ Agent แต่ต้องเลือกพื้นที่ทำงานที่เหมาะสมด้วย โดยพิจารณา:
- งานนี้มีเป้าหมายอะไร และควรอยู่ใน sandbox แบบใด
- ต้องใช้ตัวขับเคลื่อน Agent ตัวไหน
- เครื่องมือ MCP ใดได้รับอนุญาต
- ต้องออกอินเทอร์เน็ตทั่วไป เข้าถึงเฉพาะปลายทาง หรือไม่ต้องออกเลย
- ต้องใช้ไฟล์ ทรัพยากร และผลลัพธ์จากขั้นตอนก่อนหน้าใดบ้าง
ในมุมธุรกิจ นี่คือการเขียนคำบรรยายงานให้ AI แต่เพิ่มเรื่องสิทธิ์เข้าไปด้วย ไม่ใช่บอกเพียงว่าต้องส่งงานอะไร หลักการที่ควรใช้คือ Agent ขอความสามารถได้ แต่ไม่ควรเป็นผู้อนุมัติสิทธิ์ที่เพิ่มขึ้นให้ตัวเอง ข้อนี้เป็นข้อเสนอในการนำแนวคิดไปใช้ เพื่อไม่ให้ระบบที่จัดการสิทธิ์กลายเป็นช่องทางขยายสิทธิ์เสียเอง
ขั้นตอนที่ 8: เปลี่ยนแนวคิดเป็นสิ่งที่ลงมือทำได้
เราไม่ต้องเริ่มจากการสร้างระบบหลาย Agent ขนาดใหญ่ สิ่งที่เจ้าของธุรกิจและหัวหน้าทีมทำได้ก่อนคือทำให้ความสัมพันธ์ระหว่างงาน ข้อมูล และสิทธิ์มองเห็นได้ชัด
- เลือกหนึ่ง workflow: เริ่มจากงานที่มีขั้นตอนชัด เช่น ค้นข้อมูล ตรวจข้อมูล และเตรียมเผยแพร่ แทนการมอบหมายงานครอบจักรวาล
- เขียนสิทธิ์ของแต่ละหน้าที่: แยกให้ออกว่าใครอ่าน ใครแก้ และใครเผยแพร่ แล้วตัดสิทธิ์ที่ไม่มีเหตุผลรองรับ
- ตรวจที่อยู่ของข้อมูลลับ: ให้ทีมระบุว่ากุญแจและ token อยู่ที่ไหน และ Agent อ่านถึงหรือไม่
- กำหนดช่วงเปิดสิทธิ์: ความสามารถที่เปลี่ยนข้อมูลจริงควรเปิดเฉพาะขั้นตอนที่ต้องใช้ ไม่ใช่ตลอดอายุงาน
- ทดลองขอบเขตก่อนเพิ่มอิสระ: ตรวจว่า Agent ทำงานที่อนุญาตได้ และถูกปฏิเสธเมื่อพยายามทำสิ่งนอกขอบเขต
ทีมเทคนิคสามารถเริ่มศึกษาจาก เอกสาร Docker Sandboxes และ โครงการ Docker MCP Gateway ช่วงท้าย Clark แนะนำเครื่องมือ sbx สำหรับทดลองแนวคิดนี้ โดยควรตรวจวิธีติดตั้งและข้อกำหนดล่าสุดจาก คู่มือ sbx ก่อนใช้งาน
ขั้นตอนที่ 9: แก้ปัญหาที่มักเจอเมื่อนำแนวคิดไปใช้
รายการต่อไปนี้เป็นปัญหาที่คาดได้จากการประยุกต์แนวทางในคลิป ไม่ใช่ผลการทดสอบผลิตภัณฑ์ ควรใช้เป็นคำถามสำหรับคุยกับทีมที่ดูแลระบบ
ปัญหา 1: Agent ทำงานไม่สำเร็จหลังลดสิทธิ์
- ปัญหา: อ่านข้อมูลไม่ได้ หรือเรียกเครื่องมือที่งานต้องใช้ไม่เจอ
- สาเหตุ: ลดสิทธิ์ก่อนระบุความต้องการของแต่ละขั้นตอนครบ
- วิธีแก้: ระบุขั้นตอนที่ติด ตรวจข้อมูลและเครื่องมือที่จำเป็น แล้วเพิ่มเฉพาะสิทธิ์นั้น ไม่ย้อนกลับไปเปิดทั้งหมด
ปัญหา 2: มี Gateway แล้ว แต่ Agent ยังอ่านกุญแจได้
- ปัญหา: ข้อมูลลับยังอยู่ในไฟล์หรือพื้นที่ที่ Agent เข้าถึง
- สาเหตุ: รวมการเรียก MCP แล้ว แต่ยังไม่ได้แยกการจัดเก็บ credentials
- วิธีแก้: ตรวจพื้นที่และไฟล์ที่ sandbox อ่านได้ ย้ายความลับไปยังชั้นบริการที่รับผิดชอบ แล้วทดสอบว่า Agent เรียกงานได้โดยไม่เห็นค่าลับ
ปัญหา 3: แยกสาม Agent แต่ทุกตัวยังมีสิทธิ์เหมือนกัน
- ปัญหา: Agent ค้นคว้ายังเผยแพร่หรือแก้ข้อมูลจริงได้
- สาเหตุ: แยกหน้าที่ใน prompt แต่ใช้พื้นที่และชุดเครื่องมือร่วมกัน
- วิธีแก้: แยก sandbox กำหนดเครื่องมือและเครือข่ายรายหน้าที่ แล้วตรวจสิทธิ์จริง ไม่ใช่ตรวจแค่คำสั่ง
ปัญหา 4: ขั้นตอนเผยแพร่รับข้อมูลดิบทั้งหมด
- ปัญหา: Agent ที่มีสิทธิ์เผยแพร่ได้รับข้อมูลภายนอกที่ยังไม่ผ่านการคัดกรอง
- สาเหตุ: มีขั้นตอนตรวจ แต่ยังส่งข้อมูลเดิมทั้งหมดข้ามไปด้วย
- วิธีแก้: กำหนดผลลัพธ์ที่ส่งต่อให้ชัด ส่งเฉพาะเนื้อหาและข้อมูลที่จำเป็น แล้วตรวจจุดเชื่อมระหว่างขั้นตอนอีกครั้ง
ขั้นตอนที่ 10: วางแผนการต่อยอดและสรุปรายการตรวจสอบทั้งหมด
เมื่อ workflow แรกมีขอบเขตชัด แนวทางต่อยอดที่น่าสนใจมีสามเรื่อง โดยยังไม่จำเป็นต้องขยายทุกอย่างพร้อมกัน
- สร้างต้นแบบสิทธิ์ตามหน้าที่: เตรียมรูปแบบสำหรับงานค้นคว้า งานตรวจ และงานเผยแพร่ เพื่อใช้เป็นฐานกับ workflow ใหม่
- เชื่อมระบบตัวตนขององค์กร: ประเมินว่าระบบ SSO และบริการที่มีอยู่รองรับการทำงานแทนคนของ Agent ได้แค่ไหน
- เพิ่มระยะเวลาทำงานทีละระดับ: ให้ Agent รับงานยาวขึ้นหลังตรวจแล้วว่าขอบเขตข้อมูล เครื่องมือ และเครือข่ายตรงกับงาน
รายการตรวจสอบสำหรับใช้อ้างอิง:
- ☐ ระบุเป้าหมายและผลลัพธ์ของงาน AI Agent ให้ชัด
- ☐ ทำรายการข้อมูลที่ต้องอ่าน การกระทำที่ต้องทำ และสิ่งที่ห้ามแตะ
- ☐ แยกตัวขับเคลื่อน Agent ออกจากการควบคุม sandbox
- ☐ แบ่ง workflow ตามหน้าที่และชุดสิทธิ์ที่จำเป็น
- ☐ ไม่รวมข้อมูลภายนอกที่ยังไม่ผ่านการคัดกรองกับเครื่องมืออันตรายในขั้นตอนเดียว
- ☐ เปิดความสามารถเฉพาะช่วงที่งานต้องใช้
- ☐ รวมการเรียก MCP ผ่าน Gateway ตามการออกแบบ
- ☐ ตรวจช่องทางเข้าถึงไฟล์และเครือข่ายที่อยู่นอก MCP ด้วย
- ☐ เอา credentials ออกจากพื้นที่ที่ Agent อ่านได้
- ☐ ระบุว่า Agent เป็นใคร ทำงานแทนใคร และได้รับอนุญาตให้ทำอะไร
- ☐ เปิดเผยเครื่องมือและทรัพยากรเฉพาะที่เกี่ยวกับงาน
- ☐ ทดสอบทั้งการกระทำที่อนุญาตและการกระทำที่ต้องถูกปฏิเสธ
- ☐ ตรวจการส่งต่อข้อมูลและปัญหาทั้งสี่กลุ่มก่อนขยายการใช้งาน
ข้อสรุปจากแนวคิดของ Docker คือ AI Agent ควรได้รับความสามารถที่งานต้องใช้ โดยไม่ต้องถือกุญแจลับเอง ความปลอดภัยไม่ได้เกิดจากการขอให้ AI ระวังมากขึ้นเท่านั้น แต่เกิดจากการแยกหน้าที่ จำกัดสิทธิ์ และจัดพื้นที่ทำงานให้สะท้อนเจตนาของงาน
สำหรับธุรกิจไทย จุดเริ่มต้นที่คุ้มที่สุดอาจไม่ใช่การเพิ่ม Agent อีกตัว แต่เป็นการลดสิทธิ์ที่ไม่จำเป็นของตัวที่มีอยู่ เมื่อความเสียหายถูกจำกัดไว้ตั้งแต่การออกแบบ เราจึงมีเหตุผลที่หนักแน่นขึ้นในการปล่อยให้ AI ทำงานต่อโดยไม่ต้องกำกับทุกการกระทำ
ที่มา: How Many Credentials Should Your AI Agent Have? Zero. — Jim Clark, Docker — วันที่เผยแพร่วิดีโอ 2026-10-06T00:30:15Z (UTC; 06/10/2026 07:30:15 เวลาไทย) บทวิเคราะห์และตัวอย่างการประยุกต์เป็นข้อเสนอของกองบรรณาธิการ
