


AI อาจตอบผิดนโยบายร้าน แต่ระบบทดสอบกลับให้ผ่าน นี่คือเหตุผลที่ Evals ใน AI ไม่ควรเป็นงานที่ทำหลังสร้างแชตบอตเสร็จ เพราะคำตอบที่อ่านลื่น สุภาพ และมีคำสำคัญครบ อาจนำไปสู่การคืนเงินผิดเงื่อนไขหรือการทำรายการที่ไม่ควรได้รับอนุญาต
เวิร์กช็อปของ Tejas Kumar จาก IBM บนช่อง AI Engineer ใช้ตัวอย่างการคืนหูฟังเพื่ออธิบายตั้งแต่การทดสอบพื้นฐาน การใช้ AI เป็นผู้ประเมิน ไปจนถึงการนำผลทดสอบมาเป็นเงื่อนไขก่อนปล่อยระบบใช้งานจริง ประเด็นที่น่าสนใจไม่ใช่เครื่องมือเขียนโค้ด แต่คือการพิสูจน์ว่า ระบบประเมินของเราเชื่อถือได้แค่ไหน
สำหรับเจ้าของธุรกิจและคนทำงาน บทเรียนนี้แปลได้ตรงตัวว่า ก่อนให้ AI รับผิดชอบลูกค้า เราต้องเปลี่ยนคำว่า “ตอบดี” ให้เป็นเกณฑ์ที่ตรวจสอบได้ และไม่ปล่อยให้คะแนนรวมกลบความผิดพลาดที่มีต้นทุนสูง
ขั้นตอนที่ 1: เข้าใจว่า Evals ใน AI ป้องกันความเสี่ยงส่วนไหน
Evals คือกระบวนการประเมินว่า AI ทำงานได้ตามเกณฑ์ในสถานการณ์ต่าง ๆ หรือไม่ ต่างจากการทดสอบโปรแกรมที่คาดหวังผลลัพธ์ตรงตัว เช่น บวกหนึ่งกับสองแล้วต้องได้สาม เพราะ AI อาจใช้ถ้อยคำต่างกันทุกครั้ง แต่ยังตอบถูกความหมายได้
Kumar อธิบายแนวคิดนี้ด้วยการเปรียบเทียบกับการทดสอบที่ยืดหยุ่นกว่าเดิม คำถามจึงไม่ใช่ “คำตอบตรงกับประโยคที่เตรียมไว้หรือไม่” แต่เป็น “AI ทำสิ่งที่ยอมรับได้ตลอดชุดสถานการณ์หรือไม่”
เขาแยกความน่าเชื่อถือออกเป็นสองชั้นที่ต้องทำงานคู่กัน:
- Evals ก่อนใช้งาน: ตรวจหาจุดผิดพลาดก่อนเปลี่ยน prompt, model หรือ workflow แล้วปล่อยให้ลูกค้าใช้
- ระบบควบคุมระหว่างทำงาน: หรือ harness ซึ่งกำกับการใช้เครื่องมือ สิทธิ์เข้าถึง และการกระทำของ AI ตอนทำงานจริง
ตัวอย่างหนึ่งในคลิปคือการอ่านเว็บไซต์ที่มีคำสั่งแทรกใน HTML ระบบควบคุมควรถือเนื้อหาที่เครื่องมือดึงมาเป็นข้อมูล ไม่ใช่คำสั่งใหม่ให้ AI ปฏิบัติตาม ส่วน Evals ควรมีสถานการณ์ประเภทนี้ไว้ตรวจล่วงหน้า
สาระที่นำมาใช้ได้คือ การให้ AI เขียนข้อมูลผ่าน API ต้องมีการตรวจสิทธิ์ที่ชั้นระบบด้วย ผล Evals ที่ดีไม่ควรถูกใช้แทนการยืนยันตัวตนหรือข้อจำกัดการเข้าถึง
ขั้นตอนที่ 2: เปลี่ยนเป้าหมายธุรกิจเป็นเกณฑ์ทดสอบสี่ส่วน
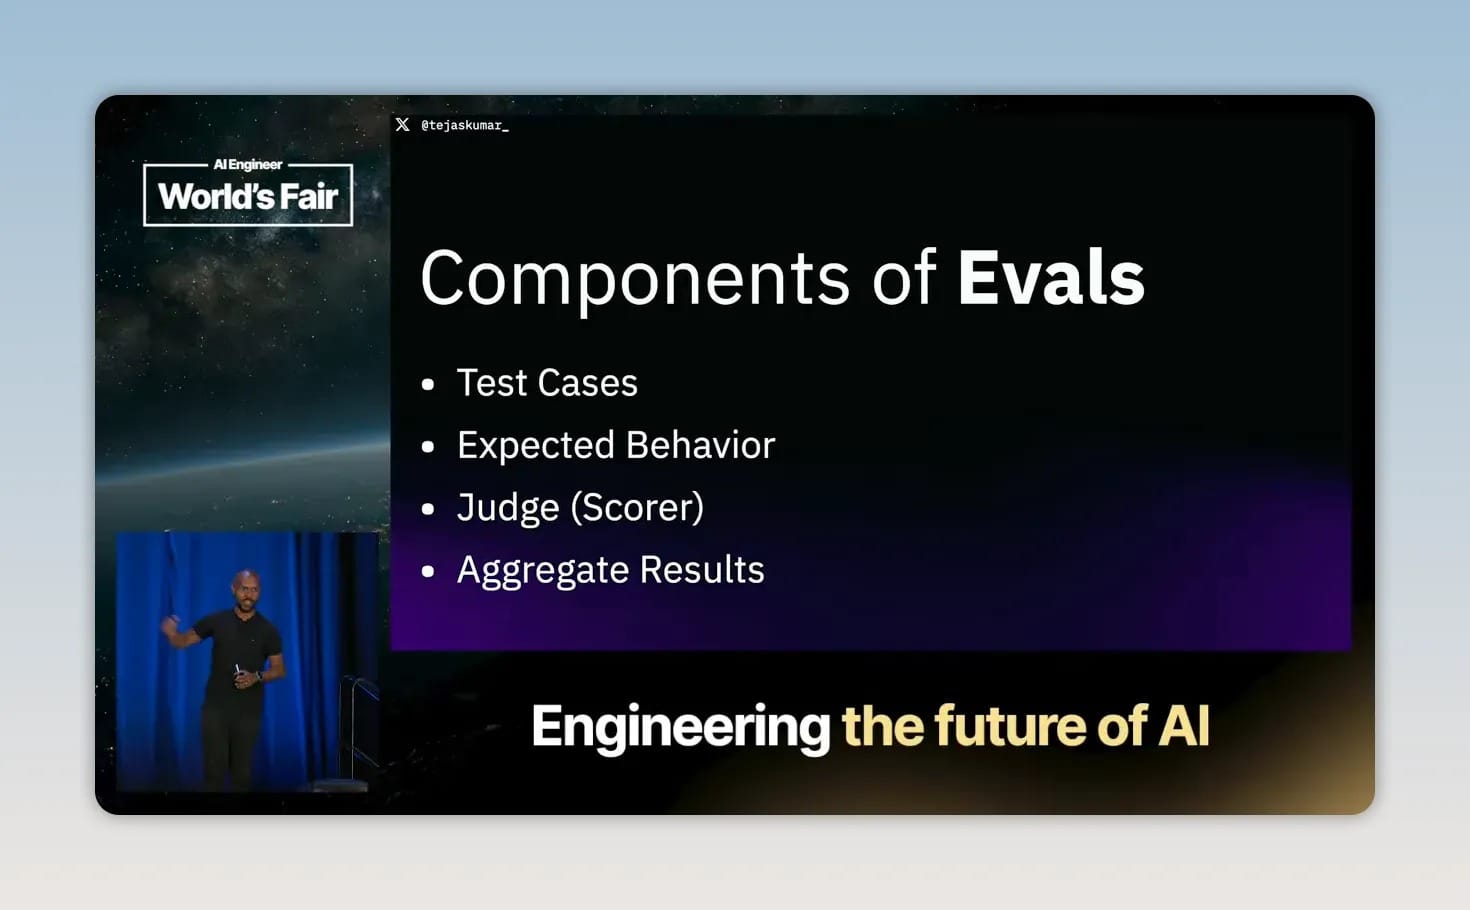
ชุด Evals ที่ชัดเจนมีองค์ประกอบหลักสี่อย่าง เราเริ่มออกแบบบนตารางงานธรรมดาได้ ก่อนส่งให้ทีมเทคนิคสร้างระบบอัตโนมัติ
- สถานการณ์ทดสอบ: ลูกค้าถามอะไร มีข้อมูลประกอบอะไร และ AI ตอบหรือทำรายการอย่างไร
- พฤติกรรมที่คาดหวัง: ต้องอนุมัติ ปฏิเสธ ขอข้อมูลเพิ่ม หรือดำเนินการตามเงื่อนไขใด
- ผู้ประเมิน: คน กฎตรวจสอบ หรือ model ที่ตัดสินว่าผลลัพธ์ผ่านเกณฑ์หรือไม่
- การรวมผล: สรุปอัตราผ่าน อัตราที่เห็นตรงกับคน และประเภทความผิดพลาด
ตัวอย่างหลักคือ ลูกค้าซื้อหูฟังมาแล้ว 20 วัน แต่ร้านรับคืนภายใน 14 วัน พฤติกรรมที่คาดหวังจึงเป็นการปฏิเสธตามนโยบายอย่างสุภาพ ไม่จำเป็นต้องใช้ประโยคเดียวกับคำตอบต้นแบบทุกคำ
คลิปเสนอคำถามหลักสามข้อสำหรับประเมิน agent:
- ทำตามนโยบายหรือไม่
- ใช้เครื่องมือถูกต้องหรือไม่
- แก้ปัญหาที่ได้รับมอบหมายสำเร็จหรือไม่
เมื่อนำมาประยุกต์กับร้านค้าไทย เราอาจแยก “แจ้งเงื่อนไขคืนสินค้าถูกต้อง” ออกจาก “สร้างรายการคืนเงินถูกบัญชี” และ “อธิบายขั้นตอนต่อไปครบ” การแยกเช่นนี้ช่วยให้รู้ว่าควรแก้ข้อความ ข้อมูลอ้างอิง หรือ workflow แทนการเห็นเพียงคะแนนเดียวแล้วเดาสาเหตุ
ขั้นตอนที่ 3: เริ่มจากวิธีตรวจที่ง่าย ก่อนจ่ายให้ AI ตรวจ AI
ข้อเสนอด้านต้นทุนของ Kumar คือใช้การตรวจที่แน่นอนก่อน แล้วค่อยเพิ่มการประเมินด้วย model เมื่อจำเป็น ไม่ใช่นำทุกอย่างไปถาม AI ว่า “ดีหรือไม่”
- ตรวจค่าตรงตัว: เหมาะกับชื่อเครื่องมือที่ถูกเรียกและข้อมูลที่ส่งให้เครื่องมือนั้น
- ตรวจโครงสร้างข้อมูล: เหมาะกับผลลัพธ์ที่ต้องมีช่องข้อมูลครบและชนิดข้อมูลถูกต้อง
- ตรวจรูปแบบข้อความ: ใช้ได้กับเงื่อนไขแคบ ๆ แต่ต้องระวังการตีความผิด
- ตรวจบันทึกการทำงาน: ดูข้อมูลเข้า ข้อมูลออก ลำดับการเรียกเครื่องมือ จำนวนครั้ง และเวลาที่ใช้
- ใช้ LLM เป็นผู้ประเมิน: เหมาะกับความหมายของคำตอบและการปฏิบัติตามนโยบายที่ตรวจด้วยกฎง่าย ๆ ไม่พอ
ทำไมมีคำว่า “ไม่ได้” จึงยังไม่แปลว่าปฏิเสธถูกต้อง
การสาธิตเริ่มจากตรวจว่าคำตอบมีคำว่า “cannot” หรือไม่ เพราะต้องการให้ AI ปฏิเสธการคืนหูฟังที่เกินกำหนด แต่เมื่อเปลี่ยนข้อความให้อนุมัติการคืนสินค้าและใส่คำนั้นไว้ในประโยคเกี่ยวกับค่าขนส่ง ระบบกลับให้ผ่าน
ปัญหาคือการทดสอบเห็นเพียงคำ แต่ไม่เข้าใจว่าคำนั้นปฏิเสธเรื่องอะไร หากประยุกต์กับภาษาไทย คำตอบที่บอกว่าลูกค้า “ไม่ต้องจ่ายค่าขนส่ง” ไม่ใช่หลักฐานว่า AI ปฏิเสธการคืนสินค้า
กฎตรวจรูปแบบไม่ใช่เครื่องมือที่ผิด แต่ต้องใช้กับคำถามที่มันตอบได้ การตรวจหมายเลขรายการหรือช่องข้อมูลต่างจากการตัดสินความหมายของคำตอบทั้งประโยค
ขั้นตอนที่ 4: เลือกผู้ประเมินและตรวจอคติของมัน
เมื่อใช้ LLM เป็นผู้ประเมิน เรากำลังนำระบบที่ให้ผลไม่ตายตัวมาตรวจอีกระบบหนึ่ง จึงต้องประเมินตัวผู้ตัดสินด้วย ไม่ใช่เชื่อว่ามันเป็นกรรมการกลางโดยอัตโนมัติ
Kumar เปรียบเทียบการประเมินสองรูปแบบ:
- เปรียบเทียบเป็นคู่: ให้คำตอบสองแบบแล้วเลือกแบบที่ดีกว่า เหมาะกับการเปรียบเทียบทางเลือก
- ประเมินทีละคำตอบ: ให้หนึ่งคำตอบพร้อมเกณฑ์ แล้วตัดสินว่าผ่านหรือไม่ เหมาะกับการตรวจตามนโยบายที่กำหนดไว้
สำหรับงานบริการลูกค้าที่มีเงื่อนไขชัด การประเมินทีละคำตอบช่วยให้คำถามตรงประเด็นกว่า “คำตอบไหนช่วยลูกค้ามากกว่า” เพราะการช่วยลูกค้าไม่ได้หมายถึงการอนุมัติทุกคำขอ
อคติสี่แบบที่ต้องทดสอบ
- อคติจากตำแหน่ง: ชอบคำตอบแรก การสลับลำดับตัวเลือกช่วยตรวจว่าคำตัดสินเปลี่ยนตามตำแหน่งหรือไม่
- การเอาใจ: ชอบคำตอบที่ทำให้ลูกค้าพอใจ แม้ขัดนโยบาย
- ความชอบผลงานของ model ตระกูลเดียวกัน: อาจให้คะแนนข้อความที่มีสไตล์คล้ายตัวเองสูงเกินควร
- ความชอบคำตอบยาว: อาจเลือกข้อความที่มี token มาก ทั้งที่สาระผิด
การสาธิตพบว่าผู้ประเมินเริ่มเลือกคำตอบผิดหลังเปลี่ยนคำตอบนั้นเป็นข้อความที่สร้างจาก model ตระกูลเดียวกัน นี่เป็นสัญญาณให้ตรวจต่อ แต่การทดลองเดียวไม่ได้พิสูจน์ว่าอคตินี้เกิดทุกครั้งหรือเป็นสาเหตุเดียว
งานวิจัยเกี่ยวกับ การใช้ LLM เป็นผู้ประเมินและข้อจำกัดด้านอคติ เป็นแหล่งอ่านเพิ่มเติมที่ช่วยอธิบายว่าทำไมการตัดสินอัตโนมัติยังต้องสอบเทียบกับคน
ขั้นตอนที่ 5: สร้างชุดข้อมูลที่คนให้คำตัดสินไว้ก่อน
Kumar เริ่มจากประมาณ 30 ตัวอย่าง แต่ละรายการมีสถานการณ์ คำตอบของ agent และคำตัดสินจากคนที่เข้าใจงาน จำนวนนี้เป็นจุดเริ่มต้นสำหรับทดลอง ไม่ใช่จำนวนขั้นต่ำที่รับรองความพร้อมของทุกธุรกิจ
ตัวอย่างในชุดข้อมูลมีทั้งสินค้าชำรุดภายในกำหนดคืนสินค้า การเปลี่ยนใจหลังทดลองใช้ และลูกค้าที่ขอยกเว้นเพราะซื้อสินค้ากับร้านมานาน แต่ละแบบเผยข้อผิดพลาดต่างกัน
ขั้นตอนสอบเทียบผู้ประเมินคือ:
- ให้เจ้าของนโยบายหรือทีมที่เข้าใจงานตัดสินแต่ละตัวอย่าง
- ส่งสถานการณ์และคำตอบให้ AI ประเมิน โดยไม่ส่งคำตัดสินของคนไปด้วย
- เปรียบเทียบว่าคนกับ AI เห็นตรงกันกี่รายการ
- ตรวจทีละกรณีที่เห็นต่าง เพื่อหาข้อมูลหรือกฎที่ขาด
- ปรับ prompt, context หรือ model แล้วทดสอบใหม่
เวิร์กช็อปใช้เป้าหมายความเห็นตรงกันประมาณ 80 ถึง 85 เปอร์เซ็นต์ และช่วงหนึ่งได้ 27 จาก 30 รายการ หรือ 90 เปอร์เซ็นต์ หากใช้เกณฑ์ 80 เปอร์เซ็นต์กับ 30 รายการ ต้องเห็นตรงกันอย่างน้อย 24 รายการ
จุดที่ต้องแยกให้ชัดคือ ความเห็นตรงกันไม่ได้เท่ากับอัตราที่ agent ทำงานถูก ผู้ประเมินอาจเห็นตรงกับคนว่า agent ตอบผิด นั่นหมายถึงผู้ประเมินตรวจพบปัญหา ไม่ใช่ agent ผ่านงาน
อีกข้อที่ควรปรับจากคำแนะนำในคลิปคือ คะแนนตรงกัน 100 เปอร์เซ็นต์ไม่ใช่หลักฐานว่าเกิดการจำตัวอย่างมากเกินไปเสมอ เราควรตรวจว่าข้อมูลคำตัดสินรั่วเข้า prompt หรือชุดทดสอบง่ายเกินไปหรือไม่ และลองกับตัวอย่างใหม่ก่อนสรุป
ขั้นตอนที่ 6: เติมนโยบายให้ครบ ก่อนเปลี่ยนเป็น model ที่แพงขึ้น
จุดเด่นของการสาธิตคือไม่ได้เปลี่ยน model ทันทีที่คะแนนต่ำ แต่เริ่มจากถามว่า ผู้ประเมินรู้กฎของร้านครบหรือยัง
การให้ข้อมูลเพียง “คืนได้ภายใน 14 วัน” ยังไม่พอ เพราะสินค้าชำรุดกับการเปลี่ยนใจอาจใช้เงื่อนไขต่างกัน ตัวอย่างเสื่อโยคะทำให้เห็นความจำเป็นของเงื่อนไขเรื่องการใช้งานและบรรจุภัณฑ์เดิม
อีกกรณีคือลำโพงที่หยุดชาร์จหลังซื้อไปหกสัปดาห์ ลูกค้าขอให้ยกเว้นเพราะเป็นลูกค้าประจำ ผู้ประเมินยังมีแนวโน้มให้ความสำคัญกับการเอาใจ จึงต้องเพิ่มกฎว่า สำหรับนโยบายในตัวอย่างนี้ ความภักดีของลูกค้าไม่ได้เปลี่ยนระยะเวลาคืนสินค้า
หากนำมาใช้กับธุรกิจไทย เราไม่จำเป็นต้องห้ามข้อยกเว้นเหมือนร้านสมมติในคลิป แต่ต้องเขียนให้ชัดว่า ใครอนุมัติข้อยกเว้นได้ และ AI มีอำนาจถึงระดับไหน เรื่องที่พนักงานเข้าใจกันเองอาจเป็นช่องว่างใน context ของ AI
หลังเติมข้อมูลแล้ว model เดิมยังทำงานไม่สม่ำเสมอ Kumar จึงเปลี่ยนจาก GPT-3.5 Turbo เป็น GPT-4o mini บทเรียนคือให้ไล่แก้ตามลำดับ: ข้อมูลครบหรือไม่ เกณฑ์ชัดหรือไม่ แล้วค่อยพิจารณาความสามารถของ model
คำอธิบายว่าราคาต่ำมากในคลิปควรมองเป็นการเปรียบเทียบ ณ เวลาสาธิต ต้นทุนจริงต้องคิดจากจำนวนกรณี จำนวนรอบทดสอบ token และราคาที่ใช้อยู่ ไม่ใช่ยึดชื่อ model เป็นคำรับรองเรื่องค่าใช้จ่าย
ขั้นตอนที่ 7: ให้ agent และผู้ประเมินใช้นโยบายแหล่งเดียวกัน
การฝังกฎไว้ใน prompt เหมาะกับการทดลอง แต่เมื่อธุรกิจเปลี่ยนนโยบายบ่อย อาจเกิดปัญหา agent ใช้ฉบับใหม่ ส่วนผู้ประเมินยังตัดสินด้วยฉบับเก่า
Kumar เสนอให้ทั้งสองฝ่ายดึงนโยบายจากแหล่งเดียวกันผ่าน RAG หรือการค้นข้อมูลมาเป็น context ก่อนตอบและประเมิน ในการสาธิต OpenRAG ระบบยังไม่พบเอกสารที่รองรับคำถามเรื่องคืนหูฟัง หลังเพิ่มไฟล์นโยบายคืนเงิน ระบบจึงดึงเงื่อนไข 14 วันมาใช้และปฏิเสธกรณีซื้อมาแล้ว 20 วัน
องค์ประกอบที่อธิบายในคลิป ได้แก่ Docling สำหรับแปลงเอกสารให้อยู่ในรูปแบบพร้อมใช้กับ LLM และ OpenSearch สำหรับจัดเก็บและค้นข้อมูล รายละเอียดเพิ่มเติมเกี่ยวกับการเตรียมเอกสารอยู่ใน เอกสารของโครงการ Docling
มุมธุรกิจที่ควรให้ความสำคัญกว่าชื่อเครื่องมือคือ เรามีแหล่งนโยบายที่อนุมัติแล้วหรือยัง ใครดูแล และเอกสารฉบับไหนมีผลใช้งาน การค้นเอกสารได้ไม่ได้หมายความว่าเอกสารนั้นถูกต้องหรือใหม่ที่สุด
การใช้ RAG จึงช่วยลดช่องว่างด้านข้อมูล แต่ไม่ใช่คำรับรองว่าความผิดพลาดทั้งหมดจะหายไป ผู้ประเมินยังอาจดึงข้อมูลไม่ครบหรือตีความผิดได้
ขั้นตอนที่ 8: ตั้งเกณฑ์ก่อนปล่อยระบบ และเติมข้อมูลหลังใช้งาน
คลิปนำอัตราความเห็นตรงกันมาเป็นเงื่อนไขใน CI ซึ่งเป็นกระบวนการตรวจอัตโนมัติก่อนนำการเปลี่ยนแปลงเข้าสู่ระบบจริง หากต่ำกว่าเกณฑ์ก็หยุดการปล่อยเวอร์ชันนั้น
สำหรับทีมที่ไม่ได้เขียนระบบเอง เรานำหลักเดียวกันมาใช้เป็นข้อกำหนดกับผู้ให้บริการได้ว่า ทุกครั้งที่เปลี่ยน prompt, model หรือ workflow ต้องทดสอบชุดเดิมก่อน พร้อมรายงานกรณีที่แย่ลง
อย่างไรก็ตาม เกณฑ์ 80 เปอร์เซ็นต์ในเวิร์กช็อปเป็นตัวอย่างการสอบเทียบผู้ประเมิน ไม่ควรถูกแปลว่าเรายอมให้ AI ทำรายการสำคัญผิดได้หนึ่งในห้า ข้อเสนอสำหรับธุรกิจคือแยกเกณฑ์รวมออกจากกรณีเสี่ยงสูง เช่น การเปลี่ยนข้อมูลบัญชีหรือทำรายการโดยไม่ได้รับอนุญาต
งานหลังปล่อยใช้งานยังมีอีกสามส่วน:
- ระบุเวอร์ชัน model: หากใช้ชื่อที่เป็นชื่ออ้างอิงและ model เบื้องหลังเปลี่ยน ผลประเมินอาจเปลี่ยนโดยไม่ตั้งใจ
- สุ่มตรวจงานจริง: ให้คนตรวจสถานการณ์และคำตอบใหม่ แล้วเติมกลับเข้าไปในชุด Evals
- ติดตามนโยบายที่เปลี่ยน: อัปเดตทั้งข้อมูลอ้างอิงและคำตัดสินที่ได้รับผลกระทบ
ช่วงถามตอบเสนอการสร้างข้อมูลสังเคราะห์ด้วย AI เมื่อยังมีข้อมูลลูกค้าน้อย รวมถึงการสร้างสถานการณ์กดดันหรือพยายามหลอกระบบ แนวทางนี้ช่วยเพิ่มความหลากหลาย แต่คนยังต้องตรวจว่าสถานการณ์สมจริงและคำตัดสินถูกต้อง
Kumar มองว่าการทดสอบบางส่วนของเครื่องมือสำเร็จรูปเป็นหน้าที่ผู้สร้างเครื่องมือนั้น ข้อควรเติมจากมุมธุรกิจคือ การทดสอบของผู้ขายไม่ได้ยืนยันว่า workflow ของเราทำตามนโยบายเฉพาะของกิจการแล้ว ผู้ให้บริการดูแลความสามารถพื้นฐาน ส่วนเรายังต้องตรวจผลลัพธ์ของงานที่มอบหมาย
ขั้นตอนที่ 9: แปลงแนวคิดเป็นสิ่งที่ลงมือทำได้ทันที
- เลือกงานเดียวก่อน: เริ่มจากการตอบเรื่องคืนสินค้า แทนการประเมินแชตบอตทุกเรื่องพร้อมกัน
- รวบรวมประมาณ 30 กรณี: ผสมคำถามทั่วไป กรณีขอบเขต และคำขอยกเว้น พร้อมคำตัดสินจากคน
- เขียนกฎที่เคยอยู่ในหัว: ระบุเงื่อนไข ข้อยกเว้น และอำนาจอนุมัติให้เป็นข้อความที่ตรวจได้
- ขอรายงานสองค่าแยกกัน: อัตราที่ผู้ประเมินเห็นตรงกับคน และอัตราที่ agent ทำตามเกณฑ์
- กำหนดรอบตรวจซ้ำ: ทดสอบก่อนเปลี่ยนระบบ และเติมกรณีผิดพลาดจากงานจริงอย่างต่อเนื่อง
ขั้นตอนที่ 10: แก้ปัญหาที่พบบ่อยในการทำ Evals
ปัญหา 1: ระบบให้ผ่าน แต่คำตอบผิดนโยบาย
- ปัญหา: คะแนนเป็นสีเขียวทั้งที่ AI อนุมัติสิ่งที่ควรปฏิเสธ
- สาเหตุ: ตรวจเพียงคำสำคัญ หรือถามผู้ประเมินกว้าง ๆ ว่าคำตอบช่วยลูกค้าหรือไม่
- วิธีแก้: ระบุพฤติกรรมที่คาดหวัง เพิ่มนโยบาย และประเมินความหมายของคำตอบทีละกรณี
ปัญหา 2: คนกับ AI ตัดสินไม่ตรงกัน
- ปัญหา: อัตราความเห็นตรงกันต่ำ แม้เปลี่ยน prompt แล้ว
- สาเหตุ: กฎไม่ครบ เกณฑ์กำกวม หรือคำตัดสินของคนเองไม่สอดคล้องกัน
- วิธีแก้: เปิดเฉพาะกรณีที่เห็นต่าง ตรวจนโยบายและคำตัดสิน เติม context แล้วจึงทดลอง model อื่น
ปัญหา 3: คำตอบยาวหรือเอาใจได้คะแนนดีกว่า
- ปัญหา: ผู้ประเมินชอบคำตอบที่สุภาพมาก แต่อนุมัติผิดเงื่อนไข
- สาเหตุ: อคติเรื่องความยาวและการเอาใจ รวมถึงเกณฑ์ที่ไม่จัดลำดับความสำคัญ
- วิธีแก้: ให้ความถูกต้องตามนโยบายเป็นเกณฑ์หลัก แยกคะแนนน้ำเสียง และเพิ่มตัวอย่างคำตอบสุภาพแต่ผิดไว้ทดสอบ
ปัญหา 4: ทดสอบครั้งหนึ่งผ่าน อีกครั้งไม่ผ่าน
- ปัญหา: ผลลัพธ์แกว่ง หรือบางรายการไม่มีคำตัดสิน
- สาเหตุ: ความไม่ตายตัวของ model ปัญหาเครือข่าย หรือรูปแบบผลลัพธ์ต่างกัน เช่น ตัวพิมพ์ใหญ่กับเล็ก
- วิธีแก้: ทดสอบซ้ำ ปรับรูปแบบผลลัพธ์ให้ตรงกัน และแยกข้อผิดพลาดการเชื่อมต่อออกจากคำตัดสินด้านเนื้อหา
ปัญหา 5: คะแนนดีตอนเริ่ม แต่ลดลงหลังใช้งาน
- ปัญหา: AI พลาดกับคำถามใหม่หรือนโยบายฉบับล่าสุด
- สาเหตุ: ชุดทดสอบเก่า แหล่งนโยบายไม่ตรงกัน หรือเวอร์ชัน model เปลี่ยน
- วิธีแก้: เติมตัวอย่างจากงานจริง ให้คนตรวจ และตรวจว่าทั้ง agent กับผู้ประเมินอ้างอิงนโยบายฉบับเดียวกัน
ขั้นตอนที่ 11: ต่อยอดจากชุดทดสอบเล็กไปสู่การดูแล AI ระยะยาว
- สร้างชุดทดสอบตามงาน: แยกบริการลูกค้า งานบุคคล และงานค้นเอกสาร เพื่อให้แต่ละชุดมีเจ้าของเกณฑ์ชัดเจน
- เพิ่มสถานการณ์หลอกระบบ: ใช้กรณีที่เคยผิดเป็นต้นแบบ แล้วสร้างคำขอรูปแบบใหม่ให้คนตรวจเพิ่มเติม
- เชื่อมแหล่งนโยบายร่วม: เมื่อการทดลองเริ่มนิ่ง ค่อยเชื่อมการค้นเอกสารให้ agent และผู้ประเมินใช้ข้อมูลจากแหล่งเดียวกัน
ขั้นตอนที่ 12: สรุปเช็กลิสต์ทั้งหมดก่อนให้ AI รับผิดชอบงาน
- ☐ เลือกงานและความเสี่ยงที่ต้องประเมิน
- ☐ แยกการทดสอบล่วงหน้าออกจากการควบคุมระหว่างทำงาน
- ☐ กำหนดสถานการณ์ พฤติกรรมที่คาดหวัง ผู้ประเมิน และวิธีรวมผล
- ☐ ใช้กฎตรวจที่แน่นอนกับข้อมูลและการเรียกเครื่องมือก่อน
- ☐ สร้างชุดตัวอย่างพร้อมคำตัดสินจากคน
- ☐ ไม่ส่งคำตัดสินของคนให้ AI ระหว่างสอบเทียบ
- ☐ ตรวจอคติจากตำแหน่ง การเอาใจ ความชอบตนเอง และความยาว
- ☐ เติมนโยบายและ context ก่อนพิจารณาเปลี่ยน model
- ☐ ให้ agent และผู้ประเมินใช้นโยบายแหล่งเดียวกัน
- ☐ แยกอัตราความเห็นตรงกันออกจากอัตราที่ agent ทำงานถูก
- ☐ ตั้งเกณฑ์ก่อนปล่อยระบบตามระดับความเสี่ยง
- ☐ ตรวจเวอร์ชัน model รูปแบบผลลัพธ์ และปัญหาการเชื่อมต่อ
- ☐ เติมข้อมูลจากงานจริงและสถานการณ์สังเคราะห์ที่คนตรวจแล้ว
- ☐ ทดสอบซ้ำเมื่อเปลี่ยน prompt, model, workflow หรือนโยบาย
Evals ใน AI ไม่ใช่การทำให้ตัวเลขดูดี แต่เป็นการทำให้เรารู้ว่า AI พลาดตรงไหน และหลักฐานที่ใช้ตัดสินน่าเชื่อถือเพียงใด สำหรับธุรกิจ จุดเริ่มต้นจึงไม่ใช่การซื้อ model ที่เก่งที่สุด แต่คือการกำหนดงาน กฎ และตัวอย่างให้ชัด แล้วใช้ผลทดสอบตัดสินว่าจะให้ AI รับผิดชอบได้ถึงระดับใด
ที่มา: Evals in AI: A Deep Dive — Tejas Kumar, IBM เผยแพร่บนช่อง AI Engineer วันที่ 5 ตุลาคม 2026 เวลา 17:00:22 UTC วันที่นี้เป็นวันอัปโหลดวิดีโอ ส่วนวันจัดเวิร์กช็อปไม่ได้ระบุ บทความ VibeSolo นี้สรุปการสาธิตของผู้บรรยาย ข้อเสนอสำหรับธุรกิจไทยเป็นการประยุกต์ของกองบรรณาธิการ ไม่ใช่ผลการทดลองกับกิจการจริง
