

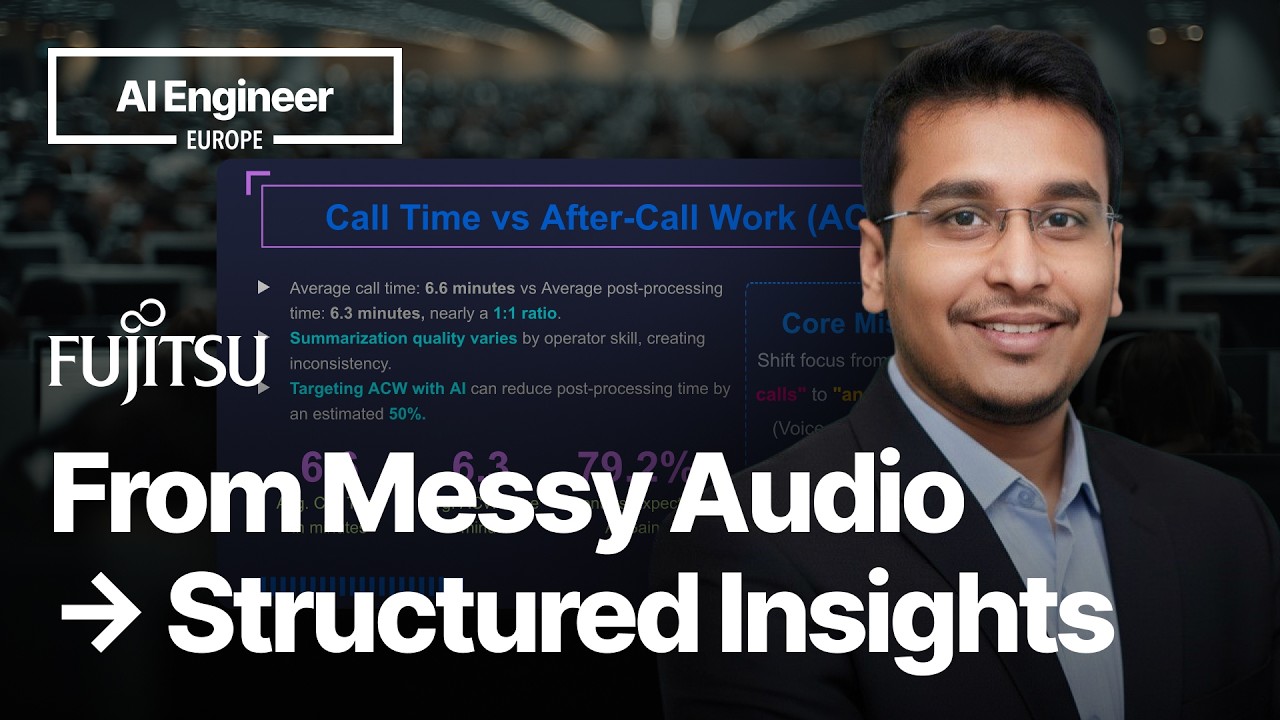
วันที่บทความต้นทางใน VideoToBlog: 2026-04-08 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว ตัวเลขความแม่นยำ STT และเวลา ACW จาก 6.3 เป็น 3.1 นาทีเป็นผลที่ผู้บรรยายรายงานในบริบทของต้นทาง ไม่ใช่การทดสอบอิสระหรือผลรับประกันทั่วไป Roadmap เป็นแผนในเวลานั้น ไม่ใช่หลักฐานว่าเปิดใช้งานครบแล้ว ภาพ thumbnail ระบุเวลาคุยเฉลี่ย 6.6 นาที แต่ข้อความต้นทางระบุ 6.5 นาที จึงควรแยกความคลาดเคลื่อนนี้ออกจากตัวเลข ACW · วิดีโอต้นทาง
คำถามที่หลายทีมเทคโนโลยีเริ่มเจอเหมือนกันในช่วงหลัง คือ ทำไมการทำ AI กับ “บทสนทนา” ถึงไม่เหมือนการทำ AI กับ “ข้อความ” ทั้งหมดที่เคยฝึกมาจากข้อมูลสะอาดๆ ปัญหานี้ไม่ได้อยู่แค่ระดับโมเดล แต่ฝังอยู่ทั้งห่วงโซ่ตั้งแต่เสียงเข้าไปจนถึงสิ่งที่ระบบไปอัปเดตในระบบงานจริง ตัวอย่างจากงานในศูนย์บริการลูกค้า (contact center) ชี้ชัดว่า ถ้าจะดึงข้อมูลเชิงธุรกิจจากเสียงแบบเรียลไทม์ ต้องออกแบบสถาปัตยกรรมที่ “รับความเละ” ของโลกจริงให้ได้
บทความนี้สังเคราะห์แนวคิดจากประเด็นหลักในเซสชันเกี่ยวกับ VoiceOps-fying Low-Latency Intelligence Extraction จากสตรีมเสียงสกปรก โดยเน้นว่าการเปลี่ยนจากงานหลังรับสาย (after call work: ACW) แบบพิมพ์ด้วยความจำของคน ไปเป็นการสรุปและดึงโครงสร้างแบบอัตโนมัติ ต้องทำให้ทั้งความหน่วงต่ำ (low latency) และความน่าเชื่อถือสูง (grounded in transcript) ไปพร้อมกัน
เป้าหมายเชิงปฏิบัติของแนวทางนี้คือทำให้ “เสียงลูกค้า” กลายเป็นสินทรัพย์ข้อมูลที่ระบบธุรกิจนำไปใช้ได้ทันที เช่น การแท็กเหตุผลการติดต่อ สถานะการแก้ไข การอัปเดตฟิลด์ใน CRM และการส่งข้อมูลเข้าระบบวิเคราะห์ เพื่อเพิ่มกำไร ลดภาระงาน และลดความเครียดของพนักงาน
ทำไมปัญหา “เสียงสกปรก” ถึงเป็นศัตรูตัวจริงของ Generative AI
แนวโน้มของ generative AI มักพาเราไปโฟกัสที่อินพุตเป็น “ข้อความ” ซึ่งโดยธรรมชาติอ่านเข้าใจได้ง่ายกว่า แต่ในศูนย์บริการลูกค้า เสียงไม่ได้เริ่มจากสคริปต์ที่เป็นระเบียบเสมอไป มันเป็นสตรีมที่อาจซ้อนทับ มีการพูดข้ามกัน มีอารมณ์เข้ม และอาจมีหลายช่องสัญญาณในตัวเอง (เช่น ช่องเสียงของ agent กับลูกค้าที่ต้องแยกกัน)
สิ่งที่น่าคิดคือ ความผิดพลาดในขั้นต้น ไม่ได้จบแค่ความแม่นยำของคำต่อคำ แต่จะ “ขยายตัว” ไปสู่ขั้นสรุปและขั้นอนุมานเหตุผลของ LLM เพราะหลักการที่ทีมหนึ่งย้ำไว้ชัดคือ garbage in equals garbage out หากระบบ speech-to-text (STT) แย่ หรือแชนเนลเสียงผสมกัน ระบบ generative AI ก็จะสรุปเรื่องที่ไม่ตรงและอาจหลุดไปเป็นเรื่องมั่วได้ง่ายขึ้น
แรงกดดันใน contact center: จุดที่ ACW กลายเป็นคอขวด
หากมองเชิงระบบ contact center เป็นแนวหน้าของประสบการณ์ลูกค้า แต่โครงสร้างการทำงานกำลัง “รับไม่ไหว” ภายใต้แรงกดดันของการหาคนใหม่ การฝึก และการรักษาประสิทธิภาพระยะยาว ข้อมูลในภาคอุตสาหกรรมที่ถูกหยิบยกในเซสชันระบุว่า กว่า 50% ของ contact centers มองการจ้าง ฝึก และผลิตภาพ เป็นอุปสรรคสำคัญที่สุด และสาเหตุหลักที่ทำให้พนักงานอยู่ต่อไม่ไหว คือความเครียดสูง
สิ่งที่ทำให้ความเครียดสูงไม่ได้มาจากการคุยกับลูกค้าเพียงอย่างเดียว แต่รวมถึงการต้องจัดการอารมณ์ที่ซับซ้อน สลับระหว่างหลายแพลตฟอร์มหรือ CRM และต้อง “บันทึกทุกอย่าง” ให้ถูกต้อง
แล้วคอขวดที่เห็นชัดที่สุดคือ after call work (ACW) ช่วงหลังจบสายที่พนักงานต้องพิมพ์สรุป เลือก disposition code และเอกสารอื่นๆ จากข้อมูลที่อยู่ในหัว ตัวเลขที่นำมาเป็น baseline คือโดยเฉลี่ย
- เวลาคุยกับลูกค้า ประมาณ 6.5 นาที
- เวลาหลังรับสาย ประมาณ 6.3 นาที
พูดแบบตรงๆ คือ เวลาเกือบเท่ากัน ระหว่าง “คุย” กับ “ป้อนข้อมูล” และเพราะสรุปขึ้นอยู่กับความจำและทักษะการเขียนของแต่ละคน ข้อมูลที่ได้จึงไม่สม่ำเสมอ
มุมมองเชิงวิศวกรรมที่น่าสนใจคือ ไม่ใช่แค่ “เพิ่มคน” แล้วจบ แต่ต้อง วิศวกรรมให้ workflow เบาลง ด้วยการใช้ AI ไปทำงานหลังรับสายให้เป็นเครื่องจักรมากขึ้น หากทำได้จริง ช่วงเวลาหลังรับสายควรถูกลดลงได้เกือบครึ่ง ซึ่งส่งผลต่อทั้งต้นทุนและคุณภาพข้อมูล
หัวใจของแนวทาง VoiceOps: จากเสียงสู่ JSON ที่ธุรกิจใช้ได้
คำตอบที่ถูกวางไว้คือสร้าง four-stage low latency pipeline เพื่อเปลี่ยนเสียงสนทนาให้เป็น “business intelligence” แบบมีโครงสร้าง โดยมีมนุษย์เหลืออยู่ในจุดตรวจความถูกต้อง ไม่ได้ตัดออกทั้งหมด
โฟลว์หลักมี 4 ส่วน
- Voice capture pipeline ดึงเสียงดิบจากระบบโทรศัพท์ให้ได้คุณภาพสูง
- Speech-to-text (STT) แปลงเสียงเป็นข้อความที่แม่นยำ
- Generative AI core ดึง intent และสรุปโดยออกผลลัพธ์เป็นรูปแบบที่ควบคุมได้
- Customer data sync layer ส่ง JSON ที่ได้ไปอัปเดตระบบข้อมูลผ่าน API ตาม schema ที่กำหนด
จุดเด่นที่ควรเน้นคือ “ไม่โยน transcript ให้ LLM แบบลอยๆ” แต่จัด orchestration ให้ LLM ทำงานเป็นขั้น เป็นโครงสร้าง และมีชั้นตรวจความน่าเชื่อถือ
องค์ประกอบที่ 1: Voice capture pipeline ไม่ใช่ขั้นเตรียม แต่คือด่านความจริง
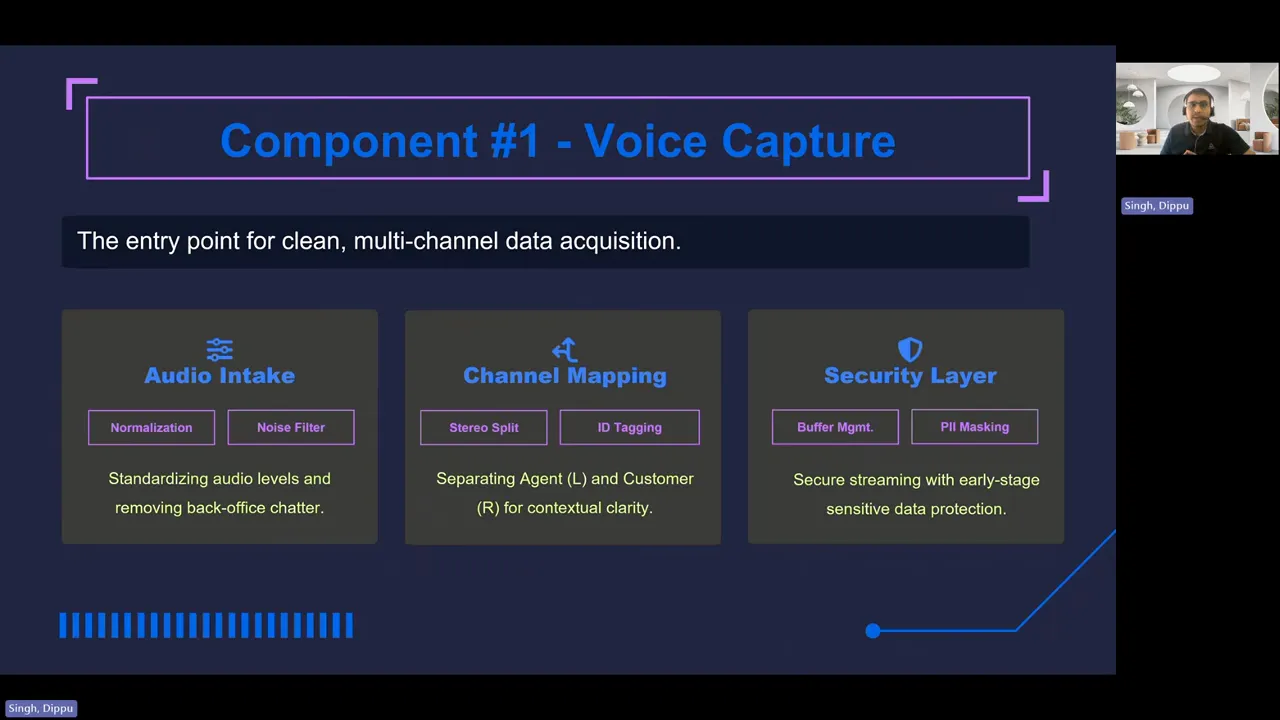
ถ้า STT และ LLM คือสมอง ระบบรับเสียงคือประสาทรับสัมผัส และที่นี่ต้องออกแบบให้รองรับโลกจริงซึ่งเต็มไปด้วยสัญญาณรบกวนและความยุ่งเหยิง โดยแนวทางที่ถูกอธิบายมีหลายชั้น
1) กรองเสียงรบกวนและ normalize ระดับเสียง
เสียงสนทนาใน contact center มักมีเสียงแทรกจาก back office หรือเสียงรบกวนอื่นๆ การกรอง noise และการ normalize ระดับเสียงช่วยลดปัญหาความแตกต่างของ volume ซึ่งจะส่งผลโดยตรงต่อการถอดเสียง
2) Channel mapping ที่ต้องแยก agent กับลูกค้า
ประเด็นนี้สำคัญมาก เพราะถ้ารวม stereo ให้กลายเป็น monotrack จนเสียงซ้อนกัน ระบบจะไม่รู้ว่าใครพูดอะไร แล้ว downstream summary ก็จะพังตามมา แนวทางที่ถูกกล่าวถึงคือต้อง split stereo เพื่อแยกช่องซ้ายสำหรับ agent และช่องขวาสำหรับลูกค้า (ขึ้นกับการตั้งค่าในระบบ) เพื่อให้ LLM และ STT แยกบทสนทนาได้
3) ความปลอดภัยและการปกปิด PII ก่อนถึงหน่วยความจำของ LLM
ในเสียงอาจมีข้อมูลอ่อนไหว เช่น เลขบัตรเครดิต รหัสผ่าน หรือข้อมูล PII กระบวนการจึงต้องมี security layer ตั้งแต่ต้น โดยใช้ buffer management และ early-stage PII masking เพื่อให้ข้อมูลอ่อนไม่เข้า “หน่วยความจำ” ที่จะถูกป้อนให้ LLM ตามขั้นตอนต่อไป
มุมมองส่วนตัวที่น่าสนใจคือ การทำ privacy แบบ “ชั้นต้น” ทำให้ทีมวิศวกรรมควบคุมความเสี่ยงได้มากกว่าแก้ทีหลัง เพราะถ้า PII หลุดเข้าไปแล้ว การแก้ทีหลังมักจะกลายเป็นการชดเชยต้นทุนและเพิ่มภาระ compliance
องค์ประกอบที่ 2: STT ต้องแม่นพอ ไม่งั้น LLM จะไม่มีอะไรให้ “ยึด”
ขั้นถอดเสียงเป็นจุดที่หลายทีมประเมินต่ำเกินไป ในแนวทางนี้มีเงื่อนไขชัดว่า STT accuracy ต้องสูงกว่า 90% เพราะระบบสรุปและ extraction ใช้ transcript เป็นฐาน ถ้าความแม่นยำไม่ถึง สิ่งที่ LLM จะทำได้ก็จะจำกัด
Acoustic modeling และการจัดการสำเนียง
แนวทางระบุว่าใช้ acoustic modeling ขั้นสูงเพื่อลดผลกระทบจากสำเนียงหรือ regional dialect และยังใช้ logic ของภาษาโดยอาศัย domain-specific dictionaries เช่น ธุรกิจประกันภัยต้องรู้ความต่างระหว่างคำที่ฟังคล้ายกัน
ตัวอย่างที่ถูกยกคือความต่างของคำในประกัน ซึ่งคล้ายกันมาก แต่มีนัยต่างกันมาก ถ้า STT จับผิด ระบบ intent extraction ก็จะผิดตาม
Inverse text normalization และ auto-punctuation
หลังถอดเสียง การ post-processing ก็เป็นส่วนหนึ่งของความแม่นยำเชิงความหมาย เช่น เมื่อพูดเป็นจำนวนเงินอย่าง “$5,000” ระบบควร output เป็นรูปแบบตัวเลขจริง และใส่ punctuation ให้อ่านเป็นประโยค ซึ่งช่วยให้ LLM ดึง entity ได้ง่ายขึ้นในขั้นถัดไป
องค์ประกอบที่ 3: Generative AI core ที่ “บังคับรูปแบบ” และลดความหลุด
จุดเปลี่ยนของแนวทางนี้คือการทำให้ generative AI ทำงานแบบมีโครงสร้าง ไม่ใช่แค่สรุปเป็นย่อหน้าข้อความเลื่อนลอย
Orchestration ด้วย prompt templates และ output ที่แยกบทบาท
แนวทางระบุว่าถ้าให้ LLM สรุปตรงๆ มักได้ narrative paragraph ที่เลอะและใช้งานต่อยาก ดังนั้น orchestration layer ต้องใช้ prompt templates และบังคับให้ LLM สร้าง bullet points โดยแยก
- รายการสำหรับ customer inquiry
- รายการสำหรับ operator action
ในทางปฏิบัติ นี่คือการลดพื้นที่ให้ LLM “ตีความอิสระ” และทำให้ข้อมูลออกมาเป็นรูปแบบที่ downstream system แปลงเป็น JSON ได้ง่าย
Reasoning layer: Intent recognition ด้วยชุดรายการที่กำหนด
อีกชั้นคือ reasoning เพื่อดึง intent โดยให้ LLM จัดชั้นตามรายการ reason ที่กำหนดไว้ล่วงหน้า เช่น การยกเลิก การสมัครใหม่ หรือการตรวจสอบสถานะเคลม และให้ LLM ต้องอธิบายว่าทำไมเลือกคลาสนั้นจาก transcript
นี่ไม่ใช่แค่ให้ LLM เดา แต่เป็นการบังคับให้ผูกเหตุผลกับหลักฐานที่อยู่ในบทสนทนา
Trust layer: token optimization, hallucination checks และ grounding
สำหรับ latency ตัวยิ่งยาวยิ่งแพง แนวทางจึงมี token optimization และ “automated hallucination checks” เพื่อให้ summary มีความ strict และ grounded ใน transcript
ถ้ามองในมุมวิศวกรรม ความน่าเชื่อถือของ output ไม่ได้มาจากความฉลาดของโมเดลอย่างเดียว แต่เป็นผลของการออกแบบระบบตรวจสอบให้ LLM ไม่หลุดโครง
องค์ประกอบที่ 4: API gateway เป็น schema mapper เพื่อป้อน CRM แบบตรงช่อง
ต่อให้ LLM จะให้ JSON ดีแค่ไหน ถ้ารูปแบบไม่ตรงกับข้อมูลที่ CRM ต้องการ ระบบก็ใช้จริงไม่ได้ แนวทางนี้ใช้ API gateway ทำหน้าที่เป็น schema mapper
มันจะเอา field จาก JSON ของ LLM เช่น customer intent หรือ resolution status ไปแมปให้ตรงกับฟิลด์ในระบบลูกค้าผ่าน REST APIs
ประเด็นสำคัญคือไม่ได้ตัดคนออกทั้งหมด เพราะยังมี verification step ให้พนักงานมองเห็นสรุปที่ AI เติมให้แบบอัตโนมัติ พนักงานทำ field validation เล็กน้อย แล้วกด confirm
ในขณะเดียวกัน ข้อมูลที่เป็นโครงสร้างก็ไหลไปยัง business intelligence models เพื่อ
- รวมเป็น voice of the customer สำหรับ dashboard
- อัตโนมัติ flag โอกาสสำหรับเพิ่ม FAQ
Linear workflow logic: จาก time indexing ไปสู่ JSON ที่ฐานข้อมูลกินได้
เพื่อให้ pipeline ทำงานกับบทสนทนาที่มีจังหวะและความสับสน ระบบจัดการข้อมูลตั้งแต่ต้น เช่น
- raw transcript พร้อม time indexing, confidence scoring และ denoising
- speaker separation จากการ split แชนเนลเพื่อจัดลำดับว่า “ลูกค้าพูด X, agent พูด Y”
- context deduction ให้ LLM ดึง entity เช่น account number หรือชื่อสินค้า รวมถึงทำ sentiment และ intent recognition
- ผลลัพธ์สุดท้ายเป็น structured output ในรูปแบบ JSON schema ที่รองรับการใช้งานจริง
การที่ระบบออกเป็น structured JSON แทน “กำแพงข้อความ” คือสิ่งที่เปลี่ยน conversational data ให้เป็น database-ready asset ได้จริง
ผลลัพธ์ในเชิงปฏิบัติ: ลด ACW เกือบ 50% และทำให้ข้อมูลสม่ำเสมอ
เมื่อระบบถูกปรับใช้ในสภาพแวดล้อม contact center จริง ผลลัพธ์ที่วัดได้มีความชัดเจน
1) เวลาหลังรับสายลดลงจาก 6.3 นาที เหลือ 3.1 นาที
ค่าเฉลี่ย ACW จาก manual operation ประมาณ 6.3 นาที ลดลงไปที่ประมาณ 3.1 นาที โดยคิดเป็น เกือบ 50% reduction
และเมื่อคำนวณระดับองค์กรที่มีจำนวนที่นั่งทำงาน (seats) และจำนวนสายต่อวัน ผลประหยัดจะกลายเป็น “reclaim headcount” จากประสิทธิภาพ แม้ไม่ได้เพิ่มคน แต่ระบบทำงานด้วยคำนวณแทน
2) คุณภาพ data entry จากความแปรผันของคน กลายเป็นมาตรฐาน
เดิมการแท็ก reason หรือการจัดหมวดหมู่ขึ้นกับความจำ อารมณ์ และโหมดการทำงานของพนักงาน แต่หลังมี AI ที่อิง transcript และออกตาม logic ผลลัพธ์มีความสม่ำเสมอมากขึ้น
และเมื่อการพิมพ์ซ้ำๆ ลดลง ระบบช่วยลด cognitive load ของพนักงาน ซึ่งเป็นจุดที่โยงกับ stress โดยตรง เรื่องนี้สำคัญ เพราะความเครียดไม่ใช่แค่สิ่งที่รู้สึกได้ แต่เป็นปัจจัยที่สัมพันธ์กับ turnover
ในเชิงความคาดหวัง ระบบดังกล่าวจึงช่วยเสถียรภาพของการปฏิบัติงานและลดอัตราการลาออกที่เคยเป็นปัญหา
ข้อจำกัดและความจริงที่ยังต้องสู้: STT, ต้นทุน token, และ compliance
แม้ผลลัพธ์จะน่าพอใจ แต่ระบบแบบ real-time voice intelligence ยังมีแรงเสียดทานที่ต้องจัดการสามด้านหลัก
1) STT accuracy เป็นตัวตั้งต้นของทั้งระบบ
เพราะ summary และ extraction ต้องอาศัย transcript หาก STT ไม่จับสำเนียงหนัก หรือคุณภาพเสียงต่ำ ระบบก็ไม่มีข้อมูลให้ reason ได้ การปรับจูน STT จึงเป็นงานต่อเนื่อง
2) ต้นทุนเริ่มต้นของ API tokens เมื่อสรุปบทสนทนายาว
การประมวลผลด้วย LLM บน transcript ยาวอาจมีค่าใช้จ่ายสูง โดยเฉพาะตอน scaling ช่วงแรกที่ต้องรันกับปริมาณมาก แนวทางนี้จึงต้องทำ token optimization เพื่อลดต้นทุนโดยรวม
3) Security และ compliance เรื่อง PII เพิ่ม latency และ overhead
การ masking ที่เข้มงวดก่อนข้อมูลไป cloud เป็น requirement ที่หลีกเลี่ยงไม่ได้ แต่การเพิ่มชั้นความปลอดภัยหลาย layer ก็มีผลให้ latency เพิ่มขึ้น และสร้าง overhead ในสถาปัตยกรรม
ประเด็นนี้สะท้อนความจริงว่า “AI ที่พร้อมใช้งานจริง” มักต้อง trade-off ระหว่างความปลอดภัย ความหน่วง และต้นทุน compute เสมอ และไม่มีคำตอบเดียวที่ถูกกับทุกองค์กร
Roadmap ถัดไป: จากสรุปเป็นโค้ช, จาก intent เป็นการพยากรณ์คน, และจากความเสี่ยงเป็นการปกป้องพนักงาน
อนาคตของระบบไม่ได้หยุดแค่สรุปหลังรับสาย แต่ขยายไปสู่การใช้งานที่กระทบการบริหารคนและความเป็นอยู่ของพนักงานโดยตรง
Phase 1: Explainable AI และ operator coaching
เปลี่ยนจาก “บอกว่าเกิดอะไรขึ้น” ไปสู่ “ช่วยพนักงานทำงานดีขึ้น” ระบบตั้งใจวิเคราะห์หลังจบสายเพื่อให้ feedback แบบทันทีเกี่ยวกับ soft skills หรือ empathy รวมถึงความถูกต้องของข้อมูล
แนวคิดนี้น่าจะมีผลมาก เพราะการฝึกพนักงานใน real-world feedback loop มักช้าและขึ้นกับการทบทวนย้อนหลัง แต่เมื่อ AI ให้สัญญาณทันที การปรับพฤติกรรมการสื่อสารทำได้เร็วขึ้น
Phase 2: Predictive staffing จาก time series analytics บน intent data
เมื่อระบบเก็บ categorized intent ได้จำนวนมหาศาล จุดต่อไปคือป้อนข้อมูลเดียวกันเข้า time series analytics เพื่อพยากรณ์ call volume spike ตามหัวข้อ เพื่อช่วย workforce management จัดตารางกะได้แม่นยำขึ้น
นี่คือการทำให้ data ที่เคยใช้เพื่อ tagging แบบตื้น กลายเป็น “สัญญาณเชิงปฏิบัติ” สำหรับการบริหารกำลังคน
Phase 3: ตรวจจับการคุกคามและโอนสายเพื่อปกป้อง mental health
เฟสสุดท้ายที่ถูกหยิบยกเป็นเรื่องที่คนทำ contact center เจอมากขึ้นเรื่อยๆ คือ verbal abuse หรือการด่าทอจากลูกค้า ระบบวางแผนพัฒนา low latency sentiment และ acoustic analysis เพื่อตรวจจับความก้าวร้าว
เมื่อระบบตรวจพบเหตุการณ์ ก็อาจ
- ส่ง alert ไปยังผู้รับผิดชอบหรือ supervisor
- หรือแม้แต่โอนสายไป AI voice agent เพื่อปกป้องพนักงานจากบทสนทนาที่ยาก
มุมมองเชิงมนุษย์ที่น่าจะสำคัญ คือเทคโนโลยีไม่ได้ถูกใช้แค่เพื่อ “ลดต้นทุน” แต่ยังถูกใช้เพื่อ “ลดความเสี่ยงต่อคน” ซึ่งเป็นเป้าหมายที่ฟังแล้วควรทำให้วงการขยับไปในทิศที่ดีขึ้น
ภาพรวมเชิงสถาปัตยกรรม: ทำไม pipeline แบบสตรีมถึงเวิร์ก
แนวคิดที่ตอกย้ำคือการย้าย compute จาก batch ไปเป็น stream เพื่อให้ได้ low latency intelligence extraction โดยธรรมชาติสิ่งนี้ต้องทำให้แต่ละขั้นเดินไปข้างหน้าแบบทนต่อความไม่สมบูรณ์ของข้อมูล
เราสามารถสรุปตรรกะสถาปัตยกรรมแบบอ่านง่ายได้ดังนี้
- ลดความเสียหายตั้งแต่ต้น ด้วย noise filtering, channel mapping และ PII masking
- ทำให้ transcript ใช้งานได้ ด้วย STT accuracy เป้าหมายสูงและ post-processing
- บังคับ LLM ให้มีโครง ด้วย prompt templates, reasoning layer และ trust layer
- เชื่อมเข้าระบบธุรกิจแบบชัดเจน ด้วย schema mapping และขั้น verification
ถ้าขาดข้อใดข้อหนึ่ง ระบบอาจยังทำงานได้ แต่จะไม่ใช่ “voice ops” แบบที่ใช้ในงานจริงที่ต้องการความหน่วงและความน่าเชื่อถือ
คำศัพท์เฉพาะทางเพิ่มเติม
After Call Work (ACW) คือช่วงเวลาหลังจบสายที่พนักงานต้องทำเอกสาร เช่น สรุปเคส เลือก disposition code และป้อนข้อมูลให้ระบบ
Speech-to-Text (STT) คือโมดูลที่แปลงเสียงพูดให้เป็นข้อความ โดยในงานนี้ต้องแม่นยำกว่า 90% เพื่อรองรับการสรุปและการดึง intent
Intent Extraction คือการดึง “เหตุผลในการติดต่อ” หรือจุดประสงค์ของลูกค้าออกมาเป็นหมวดหมู่ที่ใช้งานได้กับธุรกิจ
Hallucination (ของ LLM) คือการที่โมเดลสร้างคำตอบที่ดูสมเหตุสมผลแต่ไม่ยึดกับหลักฐานจริงจากข้อมูลต้นทาง ในงานนี้จึงมี hallucination checks และ grounding กับ transcript
PII Masking คือการปกปิดข้อมูลส่วนบุคคลในข้อมูลก่อนนำเข้าระบบประมวลผล เพื่อให้สอดคล้องกับความปลอดภัยและข้อกำหนดทางกฎหมาย
อ้างอิงพื้นฐานเกี่ยวกับแนวคิดเหล่านี้ได้จากบทความรวมที่อธิบายคำว่า hallucination ในบริบทของ AI ที่ [Wikipedia](https://en.wikipedia.org/wiki/Hallucination_(artificial_intelligence))
บทสรุปส่งท้ายจากทีมงาน Insiderly
- การใช้ generative AI กับ contact center ไม่ได้เริ่มจาก prompt แต่เริ่มจาก “การจับเสียงให้ถูก” และการแยกช่องเสียงเพื่อไม่ให้ข้อมูลซ้อนทับ
- STT accuracy คือรากฐานของความน่าเชื่อถือ เพราะสรุปและ intent extraction ต้อง grounded ใน transcript
- LLM ที่ใช้งานจริงต้องมี orchestration และ trust layer เพื่อให้ได้ output เป็นโครงสร้าง เช่น bullet points และ JSON schema ที่ downstream ใช้ได้
- การลด ACW จริงเกิดได้เมื่อระบบแปลงเสียงไปเป็นข้อมูลที่ CRM และ BI ใช้ต่อได้ทันที พร้อมมีขั้น verification ให้พนักงานตรวจยืนยัน
- ข้อจำกัดหลักยังอยู่ที่ต้นทุน tokens, compliance/PII masking และความแปรผันของคุณภาพเสียง แต่ roadmap ชี้ว่าระบบจะขยายไปเป็น coaching, predictive staffing และการปกป้องพนักงานจากการคุกคาม
