

บทความต้นทางวันที่ 18 มีนาคม 2026 อธิบายสถาปัตยกรรมที่ผู้จัดทำเสนอสำหรับการเลือกโมเดลตามงาน ไม่ใช่คู่มือตั้งค่าที่ได้ทดสอบหรือระบบอัตโนมัติพร้อมใช้งาน ภาพหน้าจอเป็นภาพประกอบจากต้นทาง ยังไม่ได้ยืนยันว่าเป็นระบบจริงหรือเป็นเว็บไซต์ทางการ ตัวเลขความเร็ว ประสิทธิภาพ การประหยัดเงิน การเข้ารหัส คะแนนลีด และการทำงานตลอด 24 ชั่วโมงเป็นคำกล่าวหรือภาพสาธิตที่ยังไม่ได้ตรวจสอบอิสระ บัญชีและข้อความตัวอย่างในภาพไม่ได้รับการยืนยันว่าเป็นลีดจริง และไม่ได้เป็นการรับรองให้ติดต่อบุคคลเหล่านั้น การเชื่อมระบบ ส่งข้อความ หรือนำข้อมูลลูกค้าไปใช้ต้องได้รับอนุญาตและมีความยินยอมที่เหมาะสม ควรให้คนตรวจและอนุมัติงานภายนอก เก็บกุญแจ API อย่างปลอดภัย และทดสอบสิทธิ์ ความแม่นยำ ต้นทุนรวม และการส่งต่องานก่อนใช้งานจริง ต้นทางไม่มี iframe วิดีโอ จึงอ้างอิงหน้าบทความและยังไม่ยืนยันตัวตนวิดีโอต้นฉบับ · แหล่งอ้างอิงในบทความต้นทาง
หลังจากได้เห็นแนวคิดการผสาน OpenClaw กับ Gemini 3.1 Flash Lite แล้ว ความรู้สึกแรกที่ตามมาคือ “มันควรจะทำงานได้มากกว่าการตอบแชต” เพราะคำว่า agent ในที่นี้ไม่ได้หมายถึงแค่คุยเก่ง แต่มันคือการวางระบบให้ทำงานต่อเนื่อง โดยเฉพาะงานที่ต้องรันซ้ำๆ ทุกวัน เช่น วิจัยเนื้อหา คัดกรองลีด ตอบคำถามลูกค้า หรือจัดการเอกสาร
บทความนี้สรุปและวิเคราะห์ภาพรวมของแนวทางที่นำเสนอ โดยเจาะ 3 แกนหลัก ได้แก่ ทำไม agent เคยช้าและไปไม่สุด, Gemini 3.1 Flash Lite แก้จุดนั้นตรงไหน และ OpenClaw ทำให้ “ทำงานอัตโนมัติ” เป็นรูปธรรมอย่างไร รวมถึงมุมมองเชิงลึกเรื่องการออกแบบระบบให้ไวพอ และยังไว้ใจได้พอที่จะใช้งานจริง
แหล่งอ้างอิงที่ต้นทางแนบ: model routing · thinking levels
ทำไม “AI agent” ที่เคยเห็นมาถึงยังไม่ไปถึงฝั่ง 24/7
ปัญหาที่คนทำงานสาย automation เจอเหมือนกันคือ “ตัว agent ทำงานได้ แต่ไม่คุ้มเวลารัน” โดยเฉพาะเมื่อมีงานปริมาณมากหรือมีหลายขั้นตอนต่อ 1 เควส ระบบมักสะดุดที่ความเร็วและต้นทุนทรัพยากร
ภาพที่มักเกิดขึ้นคือถ้าใช้โมเดลที่หนักมาก (quality สูงแต่ช้า) ทุกขั้นตอนก็จะช้าไปหมด บางทีงานง่ายๆ เช่น จัดหมวดหมู่ จับคู่คำสำคัญ หรือสรุปประเด็น กลายเป็นถูกประมวลผลด้วยโมเดลระดับสูง ทำให้เกิดต้นทุนโดยไม่จำเป็น
แล้วถ้าจะประหยัดด้วยการใช้โมเดลเบา ความกังวลก็มักตามมาว่า “เบาแล้วจะลดความฉลาดไหม” นั่นแหละคือช่องว่างที่แนวทาง OpenClaw + Gemini 3.1 Flash Lite พยายามอุดด้วยการออกแบบให้โมเดลที่เหมาะกับงานนั้นทำงานแทนโมเดลเดียวที่ต้องรับทุกอย่าง
OpenClaw คืออะไร และทำไมมันถึงเหมาะกับการทำ agent ที่รันอยู่กับที่
OpenClaw ถูกวางตัวเป็นเฟรมเวิร์กสำหรับสร้าง AI agent แบบโอเพนซอร์ส โดยสาระสำคัญของมันไม่ได้อยู่แค่คำว่าโอเพนซอร์ส แต่คือ “มันรันบนเครื่องเรา” และเชื่อมกับสิ่งที่ใช้งานจริงได้หลายช่องทาง
แก่นของ OpenClaw ที่ถูกกล่าวถึง มีทั้งความสามารถในการเชื่อมต่อระบบสื่อสาร เช่น WhatsApp, Telegram, Slack, Discord และรวมถึง integration มากกว่า 50 แบบ รวมถึงงานประเภทอ่านข้อความไฟล์ รันโค้ด เปิดเว็บ ส่งข้อความ และทำงานเป็นลูปต่อเนื่อง
สิ่งที่น่าสนใจในมุมปฏิบัติ คือ OpenClaw ถูกยกให้เป็นเหมือน digital employee ที่ทำงาน 24/7 ได้ จริงอยู่ที่ “การจ้าง” ในที่นี้ไม่ใช่ HR แต่เป็นการวางขั้นตอนและเงื่อนไข ให้ agent ทำหน้าที่แทนมนุษย์ตามกติกา
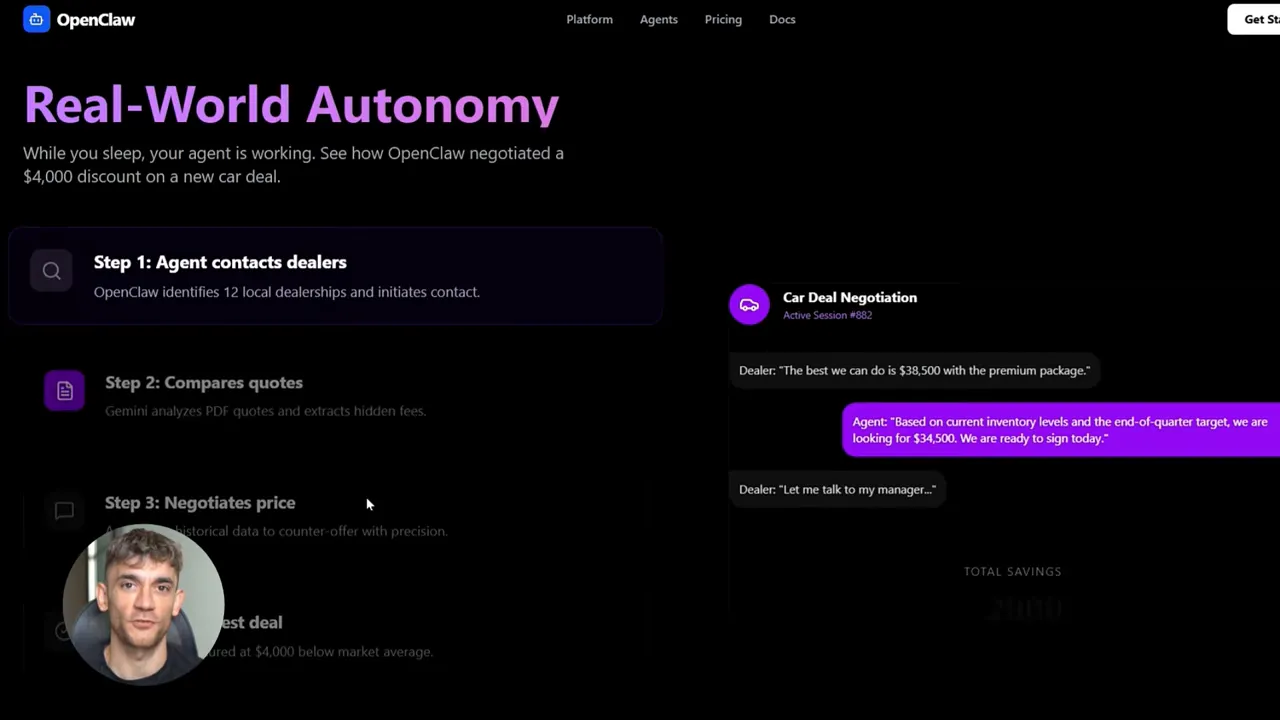
อีกตัวอย่างที่ทำให้เห็นภาพคือกรณีการใช้งานจริงของผู้ทดสอบรายหนึ่งที่ให้ agent ไปเจรจากับดีลเลอร์ เปรียบเทียบข้อมูล และช่วยหาข้อเสนอที่ดีที่สุด ทั้งที่ผู้ใช้งานอยู่ในสภาวะไม่ได้ขยับตลอดเวลา ตรงนี้สะท้อนจุดที่ agent เชิงปฏิบัติทำได้ เมื่อระบบจัดการ “งานที่ต้องทำซ้ำ” และ “งานที่มีเกณฑ์ตัดสิน” ให้เป็นอัตโนมัติ
Gemini 3.1 Flash Lite: โมเดลที่โฟกัสความเร็ว แล้วมี “thinking levels” แก้โจทย์คุณภาพ
หาก OpenClaw คือ “ระบบทำงาน” Gemini 3.1 Flash Lite คือ “สมองที่ทำงาน” โดยโมเดลนี้ถูกยกขึ้นมาในฐานะตัวที่เร็วและประหยัด เพื่อให้ agent ทำงานได้ต่อเนื่องในปริมาณมาก
สิ่งที่ถูกเน้นมี 4 ส่วน
- ความเร็ว มีการระบุว่าไวต่อการตอบกลับครั้งแรกมากขึ้น และเร็วขึ้นโดยรวมในการประมวลผลข้อความ
- รองรับหลายสื่อ ตั้งแต่ข้อความ รูปภาพ เสียง วิดีโอ และไฟล์อย่าง PDF พร้อมด้วยบริบทยาวระดับ 1 ล้านโทเคน
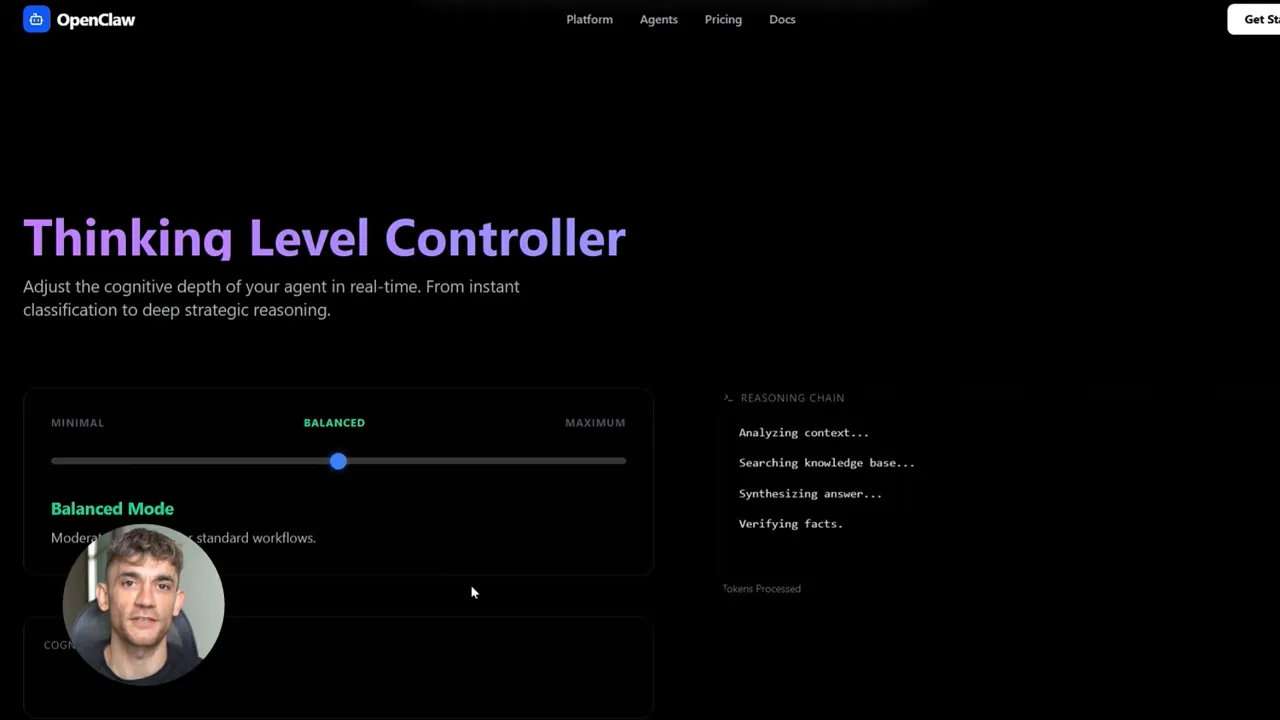
- คิดระดับต่างกันด้วย thinking levels จุดนี้สำคัญมาก เพราะช่วยปรับสมดุลระหว่างความเร็วกับคุณภาพ โดยไม่ต้องสลับโมเดลไปมา
- เหมาะกับงาน scale ในเชิงระบบคือมันถูกออกแบบให้รองรับการเรียกใช้งานจำนวนมากได้
โครงคิดของ thinking levels ทำให้เห็นภาพทันทีว่า agent ไม่จำเป็นต้องใช้ “ความพยายามสูงสุด” กับทุกคำขอ สมมติว่าเรามีงานจัดหมวดหมู่ข้อมูลจำนวนมาก หรือดึงตัวแปรจากข้อความ มันไม่ต้องใช้การคิดหนักๆ แต่ถ้าเป็นงานที่ต้องวิเคราะห์เหตุผล สร้างแผน หรือสังเคราะห์หลายแหล่ง ค่อยเพิ่มระดับการคิด
ในเชิงวิศวกรรม นี่คือแนวคิดเดียวกับการจัดลำดับความสำคัญของ compute เหมือนระบบที่ต้องประมวลผลหลายงานพร้อมกัน การจัดระดับการคิดช่วยให้ “ตอบไว” โดยไม่ทำให้คุณภาพตกจนใช้ไม่ได้
พลังของการรวมกัน: model routing ทำให้ agent ใช้โมเดลแบบพอดีงาน
ประโยคที่ทำให้ทุกอย่างเข้ารูปคือ “model routing” แนวคิดคือให้ agent ตัดสินใจว่าเควสไหนควรใช้โมเดลเร็ว และเควสไหนควรถูกส่งต่อไปยังโมเดลที่หนักกว่าเพื่อความแม่นยำหรือความลึก
OpenClaw รองรับการใช้งานหลายโมเดล และแนวทางที่ถูกยกคือใช้ Flash Lite เป็นตัวหลักสำหรับงานเบื้องต้น เช่น จัดหมวดหมู่ ดึงข้อมูล และตัดสินใจเบื้องต้น จากนั้นถ้างานซับซ้อนก็ route ไปยังโมเดลที่ทรงพลังกว่า เช่น Gemini 3.1 Pro
ผลลัพธ์ที่ต้องการคือระบบยัง “ลื่น” เพราะงานส่วนใหญ่ถูกดูแลด้วยโมเดลที่ไว และเฉพาะงานที่ต้องการคุณภาพสูงจริงๆ เท่านั้นที่จะจ่ายต้นทุนเพิ่ม
ในระบบจริง ความแตกต่างระหว่าง “ใช้โมเดลเดียว” กับ “routing ตามระดับงาน” คือการควบคุมต้นทุนและเวลาตอบกลับได้ตามสัดส่วน ไม่ใช่ตามความจงใจของคนที่ตั้งค่าตั้งแต่แรกอย่างเดียว
ทำไมเรื่องความเร็วถึงสำคัญกว่าที่คิด
คนจำนวนไม่น้อยมองว่าโมเดลที่ฉลาดกว่าเป็นคำตอบสุดท้าย แต่สำหรับงานแบบ agent สิ่งที่กระทบที่สุดคือ “latency” และ “throughput” เพราะถ้ามันช้า แม้คุณภาพจะดี การทำงานต่อเนื่องเป็นจำนวนมากก็ยังไม่รอด
ถ้าอยากให้ agent ทำงานทั้งวันทั้งคืน ต้องรองรับ pipeline ที่มีหลายขั้นตอน และมีโอกาสเกิดเควสใหม่ตลอดเวลา ความเร็วจึงเป็นคอขวดหลัก ถ้าตัดคอขวดนี้ได้ เรื่องอื่นจะเดินง่ายขึ้นเอง
เวิร์กโฟลว์ตัวอย่าง 1: คอนเทนต์ SEO แบบออโต้พิลอต
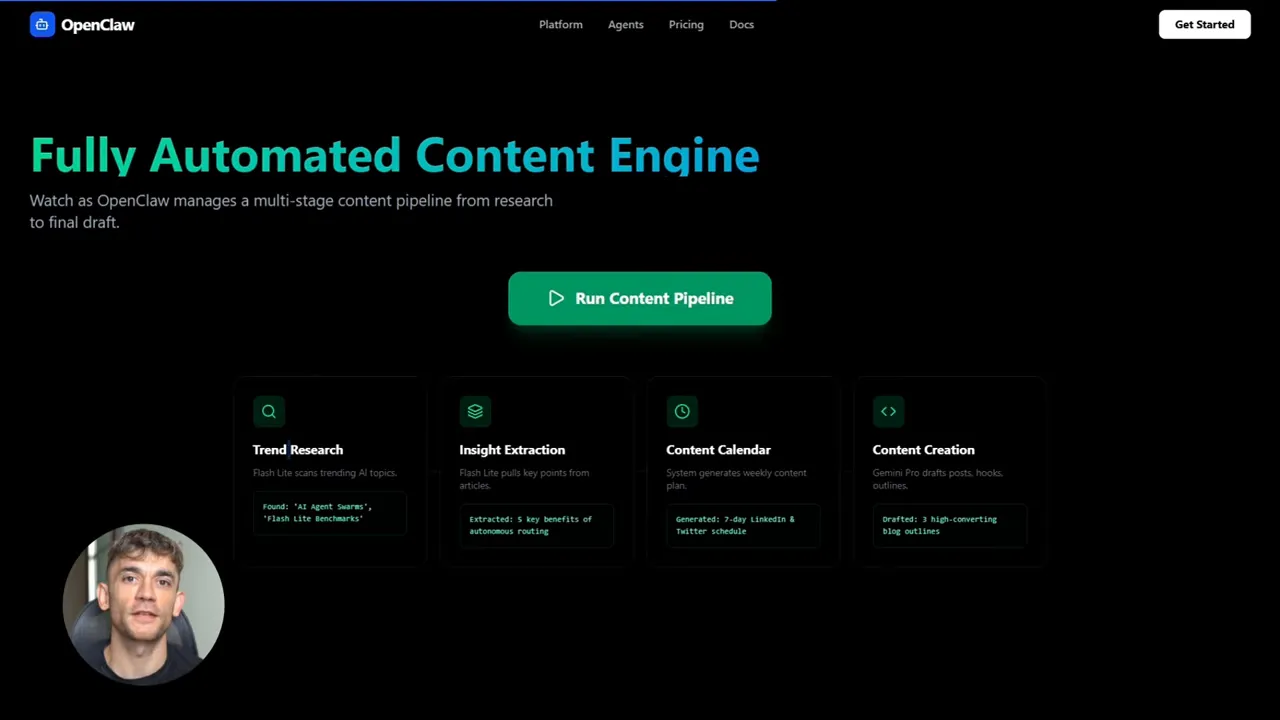
หนึ่งในตัวอย่างที่เห็นภาพที่สุดคือระบบทำคอนเทนต์สำหรับชุมชนด้าน AI โดยทำเป็นขั้นตอนเป็นท่อ (pipeline)
แนวคิดการทำงานเริ่มจากงานที่ “ไม่ต้องคิดหนัก” แล้วค่อยยกระดับเฉพาะส่วนที่สร้างผลลัพธ์สุดท้าย
ขั้นที่ 1: วิจัยหัวข้อที่กำลังมาแรง งานนี้ให้ Flash Lite รับไปทำ เพราะเป็นงานดึงข้อมูลและจัดกรอบประเด็นอย่างรวดเร็ว
ขั้นที่ 2: ดึง key points จากบทความ อีกครั้งเป็นงานที่เหมาะกับโมเดลเร็ว เพราะหลักๆ คือการสกัดข้อมูลและสรุปโครง
ขั้นที่ 3: สร้าง content calendar ตรงนี้เริ่มมีความต้องการโครงสร้างและการวางแผนมากขึ้น จึงส่งต่อไปยังโมเดลที่หนักกว่าเพื่อจัดรูปแบบแคมเปญ เช่น บล็อกโพสต์ โพสต์โซเชียล และอีเมลซีเควนซ์
ขั้นที่ 4: เขียนฉบับจริง การร่างบทความ แบบจัดหัวข้อ hooks และ outline พร้อมปรับให้เข้ากับคุณค่าเฉพาะของชุมชน เป็นงานที่ควบคุมคุณภาพได้มากกว่า จึงใช้โมเดลที่จริงจังกว่าในขั้นสุดท้าย
ภาพรวมคือ Flash Lite ทำแรงงานส่วนใหญ่ให้ระบบไหลตลอด แล้วโมเดลหนักจะถูกใช้เท่าที่จำเป็น จุดนี้ทำให้ “อัตโนมัติแบบไม่สะดุด” เกิดขึ้นได้จริงในเชิงระบบ
เวิร์กโฟลว์ตัวอย่าง 2: Lead generation จากโซเชียลด้วยการคัดกรอง
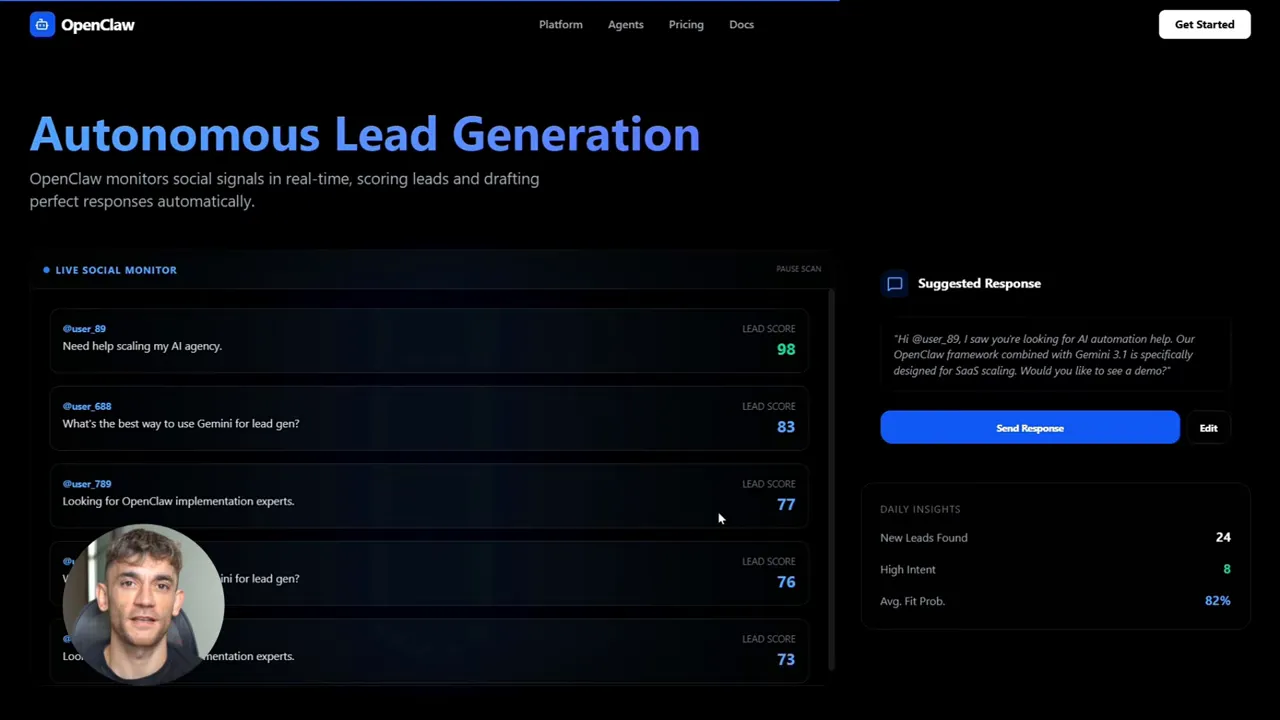
ตัวอย่างถัดมาคือระบบหาลีดจากโซเชียล โดยให้อ agent เฝ้าดูโพสต์ที่เกี่ยวกับ AI automation และประเมินว่าใคร “น่าจะใช่” หรือไม่
แนวทางที่ถูกกล่าวถึงเรียบง่ายแต่ใช้ได้จริง: Flash Lite ทำหน้าที่จัดกลุ่มและให้คำตอบแบบ yes หรือ no
ถ้าผู้ใช้งานเข้าข่าย ระบบจะร่างข้อความตอบกลับแบบเฉพาะบุคคล หากข้อความที่ร่างต้องการความลึกกว่านี้ ก็ route ไปยังโมเดลที่ทรงพลังกว่าเพื่อเพิ่มรายละเอียด จากนั้นส่งรายงานให้ทุกวันพร้อมรายชื่อที่เป็นลีด
สิ่งที่ควรสังเกตคือ agent ไม่ได้ “สแปมตอบทุกคน” แต่ทำคัดกรองก่อน ลดทั้งความเสี่ยงด้านแบรนด์และต้นทุนเวลาในการตอบ
มุมมองส่วนตัว: งานแบบนี้คือจุดที่ agent โชว์คุณค่าได้ดีที่สุด
งานประเภทนี้มักมีสัญญาณชัดเจน เช่น มีคำถาม มีความสนใจ มีบริบทที่บอกว่าเขาต้องการอะไร พอมีสัญญาณแล้ว agent สามารถใช้ rule-based หรือ model-based classification เพื่อบอกว่าใครควรถูกติดตามต่อ
ถ้าระบบตัดสินใจดี จะช่วยให้ทีมขายหรือทีมคอนเทนต์ไม่ต้องไล่ตามทุกข้อความเอง ซึ่งเป็นงานที่เหนื่อยและทำซ้ำเกินไป
เวิร์กโฟลว์ตัวอย่าง 3: Customer support ใน WhatsApp หรือ Telegram
อีกกรณีที่ทำให้เห็นภาพ agent ทำงานได้ทั้งวันคือระบบซัพพอร์ตลูกค้า แบบรับข้อความผ่านแพลตฟอร์ม เช่น WhatsApp หรือ Telegram
หลักการคล้ายเดิม: Flash Lite รับคำถามที่เป็น FAQ และตอบอย่างรวดเร็วสำหรับสิ่งที่พบบ่อย เช่น มีอะไรบ้าง วิธีการเข้าร่วม หัวข้อที่ครอบคลุม
ถ้าคำถามยาก ต้องการรายละเอียดที่เกิน FAQ ก็ route ไปยังโมเดลที่หนักกว่า
ผลลัพธ์ที่ตั้งใจคือระบบทำงาน “เงียบๆ” ในเบื้องหลัง และช่วยลดภาระทีมตอบคำถาม ข้อความส่วนใหญ่ถูกจัดการด้วยโมเดลเร็ว ทำให้ต้นทุนรวมลดลงและเวลาตอบกลับดีขึ้น
แล้วระบบแบบนี้ใช้กับธุรกิจประเภทไหนได้บ้าง
จุดที่บทความนี้อยากขยายคือ “ไม่ได้จำกัดแค่งานคอนเทนต์หรือ agency” เพราะแก่นของระบบคือการออกแบบ pipeline ที่แบ่งงานตามระดับความยาก
แนวคิดที่นำไปใช้ต่อได้กว้างมาก เช่น
- E-commerce ใช้ agent เขียนคำอธิบายสินค้า สร้างหมวดหมู่ หรือแท็กสินค้าให้สม่ำเสมอ
- โค้ชและครีเอเตอร์ ทำ content pipeline ต่อเนื่อง สร้างหัวข้อ วางปฏิทิน และร่างคอนเทนต์ตามธีม
- SaaS ใช้เป็น onboarding bot ตอบคำถามผู้ใช้ช่วงเริ่มต้น ช่วยแนะนำการใช้งาน
- ที่ปรึกษา ใช้ช่วยงานวิจัย สรุปข้อมูล และช่วยเตรียมรายงาน
สิ่งที่ทำให้ agent “ไปต่อ” ไม่ใช่แค่ความสามารถของโมเดล แต่คือการทำงานเป็นชุดขั้นตอนที่ชัดเจน และมีเส้นทางให้ถูกเลือกตามความยากของงาน
ความพร้อมใช้งานจริง: การได้ output แบบมีโครงสร้างและ streaming ที่ไว
อีกมุมที่ช่วยให้แนวทางน่าเชื่อถือ คือมีการอ้างถึงผลการทดสอบจากผู้ใช้งานที่รายงานว่าได้ output แบบมีโครงสร้าง (structured outputs) และมีการ streaming แบบค่อนข้างใกล้เคียงคำตอบทันใจ รวมถึงรายงานเรื่องความแม่นในการ tagging สินค้า
อย่างไรก็ตาม ในการใช้งานจริง เราควรมองเป็น “สัญญาณ” มากกว่า “การันตี” เพราะผลลัพธ์ขึ้นกับ prompt, data, เงื่อนไข และการตั้งค่าระดับการคิด (thinking levels) ด้วย
สิ่งที่ควรทำคือเริ่มเล็ก วัดผล และค่อยขยายงานที่ซับซ้อนขึ้น ทีละขั้น เพื่อให้แน่ใจว่า agent ทำในสิ่งที่ต้องการ ไม่ใช่แค่ตอบได้
ข้อควรระวัง: OpenClaw เป็นเครื่องมือฝั่งนักพัฒนา และเรื่องความปลอดภัยห้ามมองข้าม
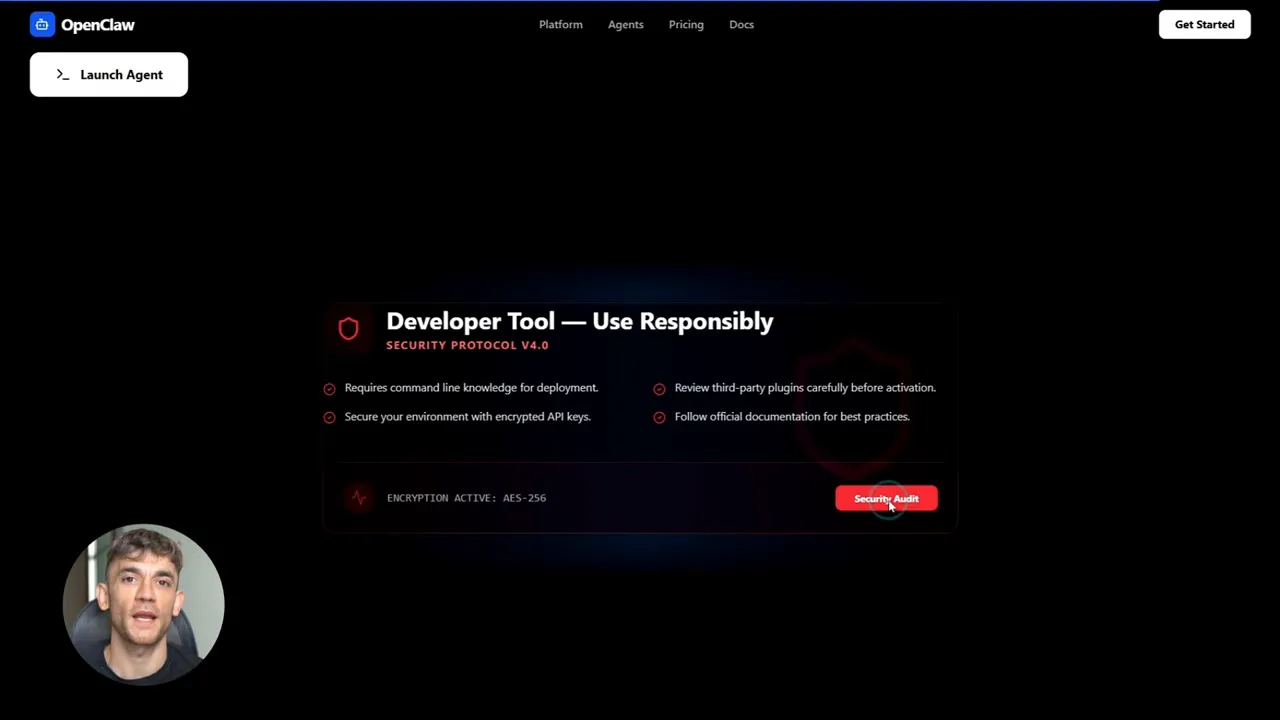
แม้แนวทางจะดูง่าย แต่ต้องยอมรับว่า OpenClaw ถูกมองเป็นเครื่องมือสาย developer การตั้งค่าบนเครื่องต้องเข้าใจพื้นฐาน เช่น การจัดการ dependencies, การกำหนดค่าผ่าน command line และการทำงานกับ API keys
นอกจากนี้ยังมีการพูดถึงประเด็นความปลอดภัยในชุมชน เช่น การล็อกดาวน์ระบบให้เหมาะสม ไม่ให้ปลั๊กอินสุ่มเข้ามาโดยไม่ตรวจสอบ
มุมมองส่วนตัวคือ “ความกลัว” ในที่นี้ควรใช้ให้เป็นประโยชน์ อย่าให้เป็นอุปสรรคจนไม่เริ่ม แต่ก็อย่าให้ความตื่นเต้นทำให้ข้ามขั้นพื้นฐาน เช่น
- อ่านเอกสารก่อนติดตั้งหรือเพิ่ม integration ใดๆ
- จำกัดสิทธิ์การเข้าถึงข้อมูลและระบบภายในเท่าที่จำเป็น
- เก็บ API keys อย่างปลอดภัย และไม่ hardcode ในโค้ด
- ทำการทดสอบในสภาพแวดล้อมจำลองก่อนนำไปใช้งานกับช่องทางลูกค้าจริง
ถ้าทำครบ ระบบจะกลายเป็นเครื่องมือที่ทรงพลังมากจริงๆ แต่ถ้าข้าม การใช้งานอาจเสี่ยงทั้งข้อมูลและชื่อเสียง
ความคิดเชิงกลยุทธ์: agent ไม่ได้มาแทน “การวางระบบ” แต่มาแทน “การทำซ้ำของมนุษย์”
สิ่งที่น่าคิดคือหลายคนเข้าใจ agent แบบผิดๆ คิดว่าคือการขอให้ AI ทำงานแทนทั้งหมดในหนึ่งคำสั่ง แต่สิ่งที่แนวทางนี้ชี้ให้เห็นคือ agent ที่ดีมาจากการออกแบบ
การออกแบบที่สำคัญมี 2 อย่าง
- เลือกสิ่งที่ให้โมเดลเร็วทำ งานส่วนใหญ่ควรเป็นงานที่ pattern ชัด เช่น classification, extraction, การจัดรูปแบบข้อมูล
- กันงานยากไว้สำหรับโมเดลหนัก งานที่ต้องใช้เหตุผลลึกหรือคุณภาพสูงจริงๆ ถึงค่อยส่งต่อ
เมื่อระบบทำแบบนี้ ต้นทุนจะไม่บาน การตอบกลับจะไว และยังควบคุมคุณภาพปลายทางได้
แล้วเราจะเริ่มจากตรงไหนดี
คำถามยอดฮิตคือ “ควรเริ่มทำ agent ประเภทไหนก่อน” ในมุมของการใช้งานจริง สิ่งที่เริ่มง่ายมักเป็นงานที่มีข้อมูลเข้าแบบชัด เช่น
- คำถาม FAQ ที่เคยตอบบ่อย
- ข้อความจากโซเชียลที่มีคำสำคัญชัด
- งานจัดหมวดหมู่และสรุปเอกสาร
พอเห็นผลที่วัดได้ แล้วค่อยยกระดับไปงานที่ต้องสร้างสรรค์มากขึ้น เช่น การเขียนแคมเปญ หรือการสังเคราะห์กลยุทธ์
คำศัพท์เฉพาะที่น่าสนใจ
AI Agent: ระบบที่รับงานตามคำสั่งหรือเงื่อนไข แล้วทำหลายขั้นตอนแทนมนุษย์ เช่น ตรวจข้อมูล สรุป ตัดสินใจ และส่งผลลัพธ์ไปยังช่องทางที่กำหนด
Model Routing: การส่งงานไปยังโมเดลที่เหมาะสมตามความยาก โดยอาจใช้โมเดลเร็วตัดสินใจว่าเควสไหนควรส่งต่อให้โมเดลหนัก
Thinking Levels: ระดับการคิดหรือความพยายามของโมเดลก่อนตอบ ยิ่งสูงมักใช้เวลาและทรัพยากรมากขึ้น แต่คุณภาพอาจดีขึ้นในงานยาก
Structured Output: ผลลัพธ์ที่จัดรูปแบบให้ใช้งานต่อได้ง่าย เช่น JSON หรือฟิลด์ชัดเจน ไม่ใช่แค่ข้อความยาว
Streaming: การส่งผลตอบกลับแบบทยอยปรากฏทีละส่วน ทำให้ผู้ใช้รู้สึกว่าเร็ว แม้เวลารวมยังเท่าเดิม
สิ่งที่ได้จากคลิปนี้
ภาพที่ได้จากแนวทาง OpenClaw + Gemini 3.1 Flash Lite คือ “agent ที่รัน 24/7 ไม่ใช่ฝัน” ถ้ามองอย่างถูกมุม นั่นคือการแก้ปัญหาคอขวดเรื่องความเร็วและต้นทุน ด้วยการแบ่งงานตามระดับความยาก แล้วใช้โมเดลที่เหมาะสมกับแต่ละช่วง
สิ่งที่ถือว่าเป็นจุดเปลี่ยนของระบบนี้คือการรวม 2 อย่างเข้าด้วยกันอย่างมีเหตุผล OpenClaw ทำให้ agent เชื่อมงานและช่องทางจริงได้ต่อเนื่อง ส่วน Gemini 3.1 Flash Lite ทำให้การตัดสินใจและงานเบื้องต้นทำได้เร็ว โดยมี thinking levels ช่วยคุมสมดุลคุณภาพให้ยืดหยุ่น จากนั้น model routing ก็ทำหน้าที่เป็นผู้จัดการงาน ส่งเรื่องไปหาโมเดลที่เหมาะสมจริงๆ
และสุดท้าย ต่อให้เทคโนโลยีดีแค่ไหน ถ้าไม่วางความปลอดภัยและการตั้งค่าที่รอบคอบ ระบบก็จะเสี่ยง ไม่คุ้มในระยะยาว แต่ถ้าตั้งให้ถูกทาง agent จะกลายเป็น “แรงงานดิจิทัล” ที่ทำงานเงียบๆ แทนส่วนที่ซ้ำและน่าเบื่อให้มนุษย์กลับไปโฟกัสงานที่ต้องใช้วิสัยทัศน์
