

บทความนี้ถ่ายทอดบทความต้นทางลงวันที่ 8 ตุลาคม 2026 จากคลิป Grok Bot Just Got 2 Massive Upgrades. Do These Things Now. ของ Nate Herk | AI Automation ความสามารถ ชื่อโมเดล ค่าใช้จ่าย และสิทธิ์ใช้งานเป็นสิ่งที่ผู้สาธิตรายงานในช่วงทดลอง ยังไม่ได้ตรวจยืนยันสถานะบริการปัจจุบัน ตัวอย่างธุรกิจไทยและเช็กลิสต์เป็นแนวทางประยุกต์จากบทความเดิม วันที่ข้างต้นเป็นวันที่บทความต้นทาง ไม่ใช่วันที่อัปโหลดวิดีโอซึ่งยังไม่ทราบ
ในคำอธิบายของ Nate Grok Bot เลือก AI ให้เองได้ และค้นหา X ได้ในตัว แต่สิ่งที่ธุรกิจควรรีบปรับอาจไม่ใช่การเปลี่ยนเครื่องมือ เป็นการแบ่งงานให้ AI ชัดขึ้น เพราะเมื่อระบบเลือก model เบื้องหลังอัตโนมัติ วิธีสั่งงานแบบก้อนเดียวจบอาจไม่เหมาะกับทุกงานอีกต่อไป
คลิปของ Nate Herk จากช่อง Nate Herk | AI Automation เล่าถึงสองอัปเกรด ได้แก่ การเลือก model ตามลักษณะงาน และการค้นหา อ่าน รวมถึงติดตามข้อมูลบน X โดยไม่ต้องเรียก X API แบบเสียเงินในตัวอย่างที่เขาทดลอง พร้อมสาธิตการเปิด Claude Code ภายในคอมพิวเตอร์คลาวด์ของ Grok Bot ผ่านบัญชีสมาชิกที่มีอยู่แล้ว
ประเด็นที่ควรวิเคราะห์ต่อคือ เราจะใช้ความสะดวกเหล่านี้โดยไม่เสียการควบคุมได้อย่างไร ทั้งเรื่องค่าใช้จ่าย ความสม่ำเสมอของงาน และสิทธิ์เข้าถึงข้อมูล บทเรียนนี้เกี่ยวกับเจ้าของธุรกิจและคนทำงานโดยตรง แม้จะไม่ได้เขียนโปรแกรมก็ตาม
เข้าใจการเลือก model อัตโนมัติของ Grok Bot ก่อนปรับงาน
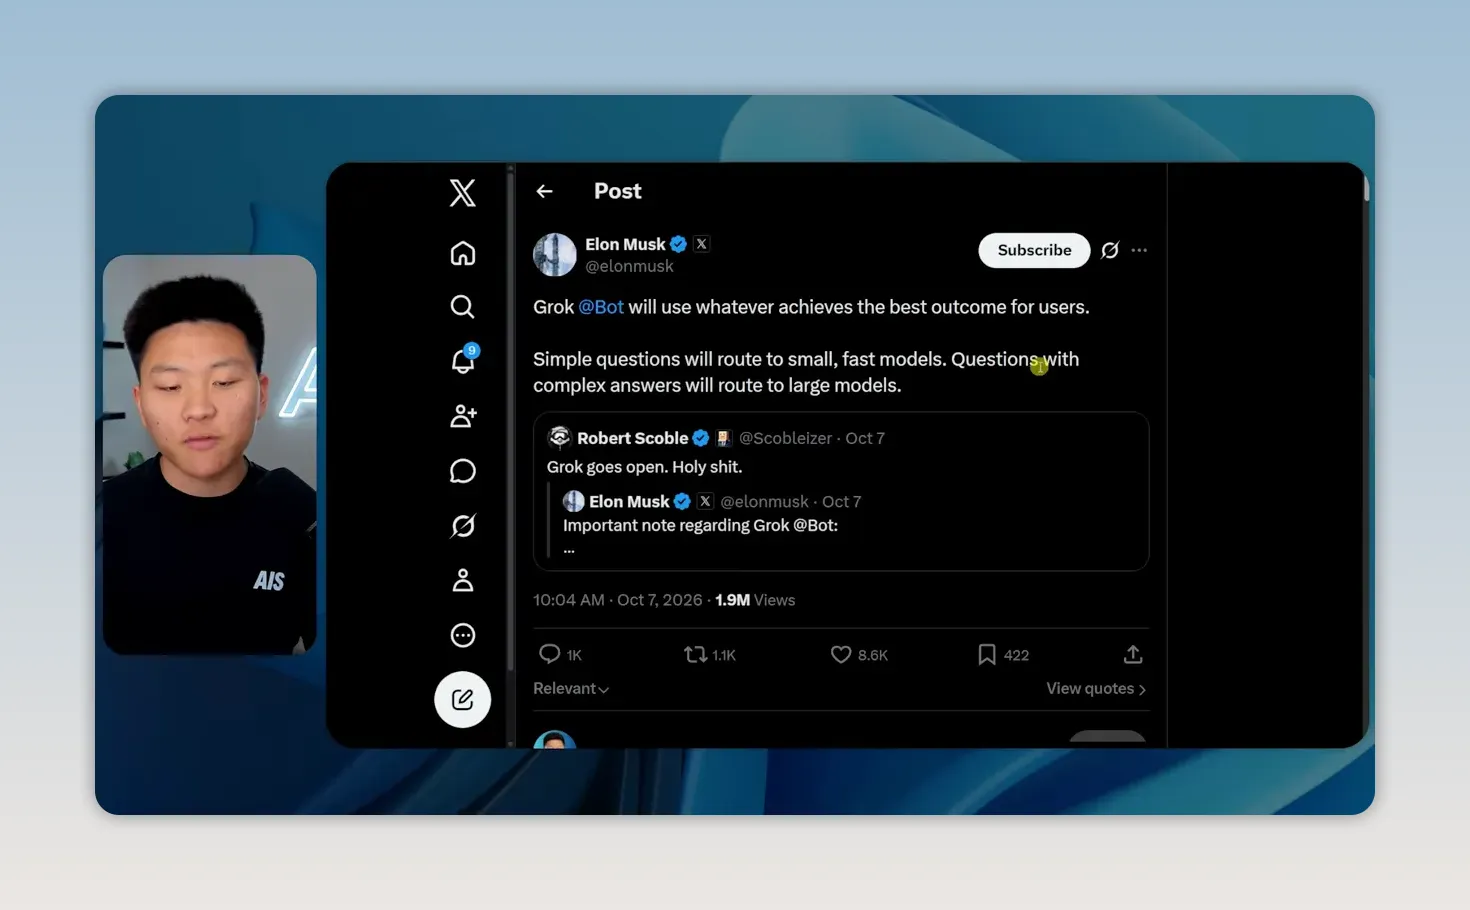
อัปเกรดแรกตามที่ Nate รายงานคือ Grok Bot จะประเมินงานแล้วส่งต่อไปยัง model ที่ระบบเห็นว่าเหมาะสม แทนการใช้ model เดียวกับทุกคำขอ แนวทางที่ Nate ยกมาจากประกาศของ Elon Musk คือ คำถามง่ายใช้ model ขนาดเล็กและเร็ว ส่วนงานซับซ้อนใช้ model ขนาดใหญ่กว่า
ประกาศที่นำมาเล่ายังกล่าวถึงการใช้ model และบริการจากผู้ให้บริการอื่น รวมถึง Claude, Midjourney สำหรับภาพ และ Suno สำหรับเพลง จึงควรมอง Grok Bot เป็น platform ที่ประสานการทำงานของ AI หลายตัว ไม่ใช่แค่ช่องทางสนทนากับ Grok เพียง model เดียว
สำหรับธุรกิจ เหตุผลของแนวทางนี้เข้าใจได้ง่าย งานรวบรวมข้อมูลไม่จำเป็นต้องใช้ความสามารถเท่ากับงานวิเคราะห์ทางเลือกเชิงกลยุทธ์ หากระบบเลือกได้เหมาะสม ก็มีโอกาสช่วยให้ได้ทั้งความเร็วและการใช้โควตาที่คุ้มขึ้น แต่ยังไม่ควรตีความว่าอัปเกรดนี้ทำให้ค่าใช้จ่ายลดลงแน่นอน
ข้อจำกัดคือความสะดวกที่ยังมองไม่เห็นเบื้องหลัง
ในช่วงที่ Nate ทดลอง เขายังไม่เห็นชัดว่าคำขอแต่ละครั้งใช้ model ใด ใช้ระดับการประมวลผลเท่าไร หรือควบคุมการเลือกได้มากน้อยแค่ไหน การกล่าวถึง model บางรุ่นในคลิปจึงไม่เท่ากับการยืนยันว่าทุกงานกำลังใช้รุ่นนั้นอยู่
Nate มองทิศทางนี้ในแง่บวก แต่ก็อยากได้ความโปร่งใสและตัวเลือกมากขึ้น ซึ่งเป็นข้อเรียกร้องที่สมเหตุสมผล บางคนสมัคร Grok Bot เพราะต้องการใช้ Grok โดยเฉพาะ จึงไม่พอใจเมื่อคำขออาจถูกส่งไปยังผู้ให้บริการอื่น
ข้อเสนอในบทความต้นทางคือ ธุรกิจควรให้ความสำคัญกับงานที่ตรวจสอบได้ มากกว่าชื่อ model ที่ดูเก่งที่สุด หากยังเลือกหรือดู model ไม่ได้ เราควรเริ่มจากงานความเสี่ยงต่ำ กำหนดรูปแบบผลลัพธ์ให้ชัด และทดสอบด้วยโจทย์เดิมหลายครั้งก่อนนำไปเป็นขั้นตอนหลักของทีม
เปลี่ยนงานค้นหา X มาใช้ความสามารถในตัว แล้วตรวจค่าใช้จ่าย
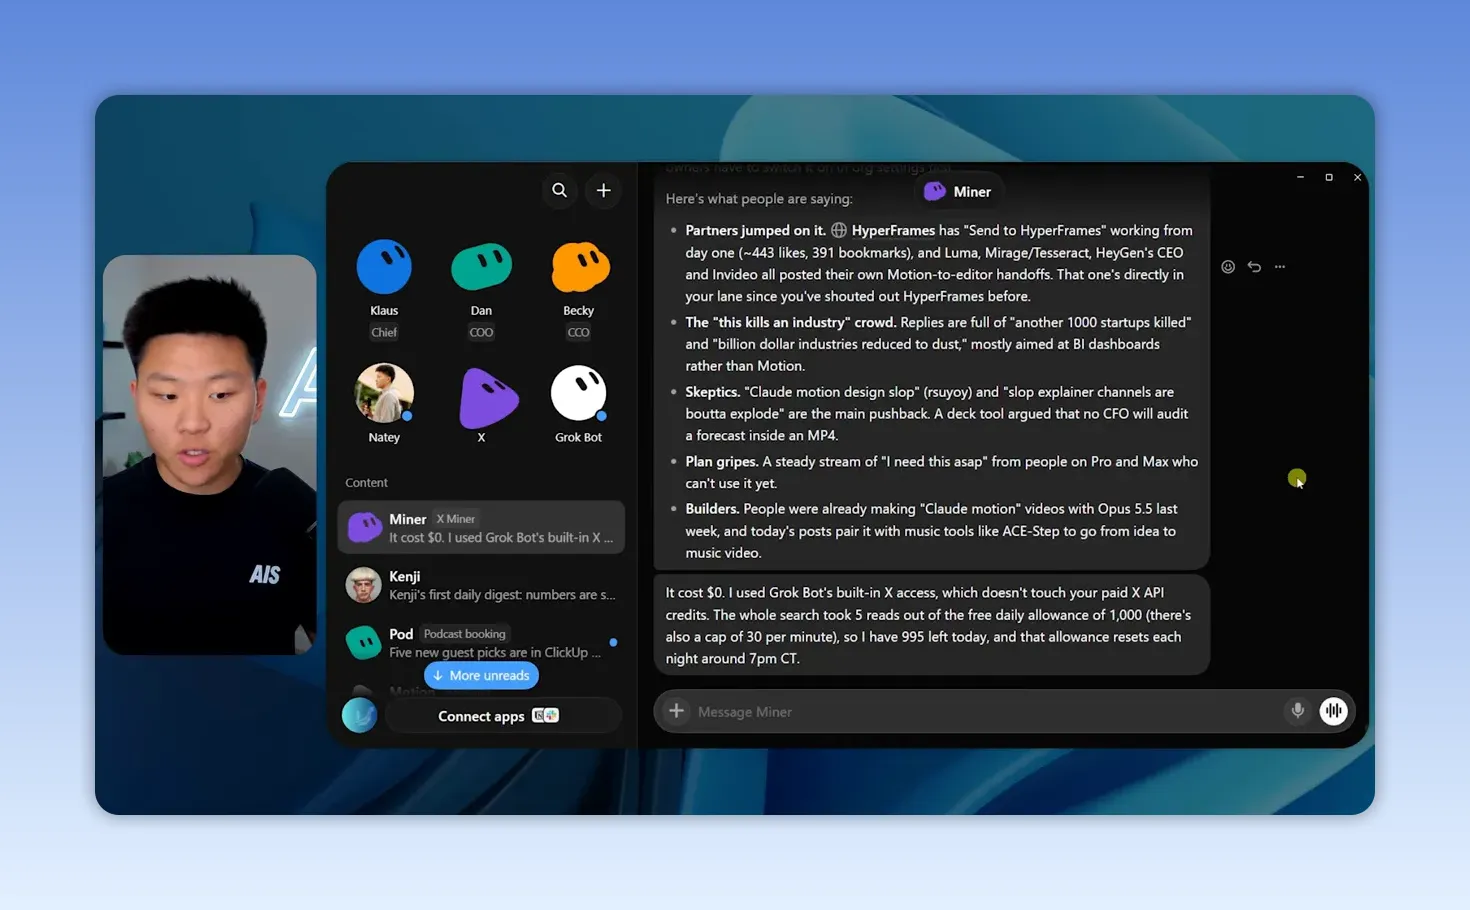
อัปเกรดที่สองตามที่ Nate รายงานคือ Grok Bot สามารถค้นหา อ่าน และติดตาม X ได้ในตัว ตัวอย่างของ Nate มีบอทชื่อ X ทำหน้าที่ค้นหาโพสต์และส่งข่าวอัปเดต เดิมบอทนี้เรียก X API แบบเสียเงิน จึงมีค่าใช้จ่ายจากการดึงข้อมูล
หลังทราบเรื่องอัปเกรด เขาสั่งให้บอทเปลี่ยนงานประจำไปใช้การค้นหา X ในตัว และแจ้งบอทอื่นที่เกี่ยวข้องกับการวิจัยหรือเก็บข้อมูลให้ใช้วิธีเดียวกัน ประเด็นสำคัญคือ การเปลี่ยนเครื่องมือของบอทหนึ่งตัว ไม่ได้แปลว่า workflow ทั้งหมดเปลี่ยนตามแล้ว
เราสามารถนำแนวทางนี้ไปทำตามเป็นลำดับได้ดังนี้
- รวบรวมรายชื่อบอทและงานประจำที่ค้นหาข้อมูลจาก X
- สั่งให้เปลี่ยนมาใช้ความสามารถค้นหา X ในตัว แทน X API แบบเสียเงินสำหรับงานทดลอง
- แจ้งบอทที่เกี่ยวข้องให้รับรู้แนวทางใหม่ และตรวจคำสั่งประจำของแต่ละตัว
- ทดลองค้นหาข้อมูลจำนวนน้อย แล้วตรวจว่าดึงข้อมูลได้ตรงโจทย์หรือไม่
- ตรวจยอดใช้งานหรือบันทึกค่าใช้จ่ายของบริการเดิม เพื่อยืนยันว่าไม่ได้ถูกเรียกต่อโดยไม่ตั้งใจ
Nate เล่าว่าระบบเดิมของเขามีค่าใช้จ่ายค้นหา X ราว 5 ดอลลาร์ต่อสัปดาห์ จึงไม่ใช่การประหยัดเงินก้อนใหญ่ในกรณีนี้ แต่เป็นการลดบริการที่ต้องดูแลและลดค่าใช้จ่ายซ้ำซ้อน ซึ่งมีประโยชน์เมื่อมีบอทหลายตัวทำงานร่วมกัน
อย่าตีความคำว่าใช้ฟรีเป็นไม่จำกัด
ในการทดสอบอีกครั้ง เขาให้บอท Miner ค้นหาโพสต์เกี่ยวกับ Claude Motion บอทรายงานว่าพบ 5 โพสต์ ใช้การเข้าถึง X ในตัว และไม่ได้แตะเครดิต X API แบบเสียเงิน พร้อมแจ้งว่าโควตาอ่านฟรีอยู่ที่ 1,000 ครั้งต่อวัน และเหลือ 995 ครั้ง
อย่างไรก็ตาม Nate เตือนเองว่าบอทอาจอธิบายกลไกของระบบไม่ถูกต้องเสมอ ตัวเลขโควตาและเวลารีเซ็ตที่บอทแจ้งจึงควรถือเป็นข้อมูลจากการทดลองครั้งนั้น ไม่ใช่เงื่อนไขบริการที่ยืนยันแล้วสำหรับทุกบัญชี
หากนำมาใช้กับธุรกิจไทย ตัวอย่างที่เหมาะจะเริ่มคือรายงานการพูดถึงแบรนด์หรือหัวข้อในอุตสาหกรรมบน X โดยให้แนบลิงก์ต้นทางและเวลาของโพสต์ด้วย แต่ผลค้นหาเหล่านี้ควรเป็นข้อมูลประกอบการตัดสินใจ ไม่ใช่ตัวแทนความคิดเห็นของลูกค้าทั้งหมด
จัดพื้นฐานระบบ AI ให้ครบ ก่อนเพิ่มจำนวนบอท
Nate แนะนำชุดเริ่มต้น AI OS ของเขา ซึ่งใช้กรอบ Herc Loop ประกอบด้วย context, การเชื่อมต่อ, ความสามารถ และรอบการทำงาน ชุดดังกล่าวมี 6 skills และช่วยรวบรวมข้อมูลพื้นฐาน รวมถึงจัดลำดับความสำคัญของธุรกิจผ่านการถามตอบ
สำหรับคนที่ไม่ได้ต้องการสร้างระบบใหญ่ทันที เราสามารถใช้กรอบนี้เป็นคำถามตรวจความพร้อมได้ โดยไม่จำเป็นต้องติดตั้งทุกอย่างตามต้นแบบ
- Context: AI รู้เป้าหมายธุรกิจ กลุ่มลูกค้า และข้อจำกัดของงานมากพอหรือยัง
- การเชื่อมต่อ: AI เข้าถึงแหล่งข้อมูลและเครื่องมือที่ต้องใช้ได้จริงหรือไม่
- ความสามารถ: มีคำสั่งหรือ skill ที่บอกวิธีทำงานชัดเจนแล้วหรือยัง
- รอบการทำงาน: งานนี้ควรทำเมื่อได้รับคำสั่ง ทุกวัน หรือเมื่อมีเหตุการณ์ใหม่
ข้อคิดที่สำคัญกว่าการมีบอทหลายตัวคือ ทุกตัวควรมีหน้าที่และขอบเขตที่อธิบายได้ บอทค้นข่าวกับบอทวิเคราะห์ข่าวอาจทำงานต่อกันได้ แต่ต้องรู้ว่าจะส่งข้อมูลอะไรให้กัน และเมื่อไรต้องหยุดให้คนตรวจ
ในมุมธุรกิจขนาดเล็ก การเริ่มจาก workflow เดียวที่ใช้ซ้ำได้ มีประโยชน์กว่าการสร้างผู้ช่วยจำนวนมากแต่ยังไม่มีงานประจำรองรับ เราควรพิสูจน์ให้ได้ก่อนว่า AI ช่วยลดขั้นตอนใด ไม่ใช่เพียงเพิ่มช่องสนทนาอีกหลายช่องให้ทีมดูแล
แยก skill ก้อนใหญ่ตามชนิดของงาน
การเลือก model อัตโนมัติทำให้ Nate กลับมาคิดเรื่องโครงสร้าง skills ใหม่ ตัวอย่างของเขาคือ skill ผลิตวิดีโอ YouTube ที่ทำหลายอย่างในคำสั่งเดียว ตั้งแต่คิดหัวข้อ วิจัย ดึงความคิดเห็น ทำภาพเคลื่อนไหว ไปจนถึงเตรียมองค์ประกอบสำหรับเผยแพร่
คำสั่งแบบนี้สะดวกเมื่อ agent ตัวเดียวทำทุกอย่าง แต่แต่ละช่วงต้องการความสามารถไม่เท่ากัน งานดึงข้อมูลอาจเหมาะกับ model ที่เร็วกว่า ส่วนงานวิเคราะห์ ออกแบบ หรือใช้วิจารณญาณอาจต้องการ model ที่คิดได้มากกว่า
Nate ตั้งสมมติฐานว่าระบบอาจเลือก model หนึ่งครั้งต่อ prompt มากกว่าสลับระหว่างทำงาน เขาให้เหตุผลเรื่องการส่งต่อ context และการจัดการข้อมูลที่เก็บไว้ระหว่างประมวลผล แต่ นี่เป็นข้อสันนิษฐาน ไม่ใช่รายละเอียดสถาปัตยกรรมที่ยืนยันจากทีม Grok Bot
แยกตามงานที่ตรวจรับได้ ไม่ใช่แยกทุกประโยค
สำหรับทีมการตลาดไทย เราอาจประยุกต์ตัวอย่างการผลิตวิดีโอเป็น workflow ดังนี้ โดยถือเป็นแนวทางทดลอง ไม่ใช่ผลลัพธ์ที่ Nate ทดสอบไว้แล้ว
- เก็บข้อมูล: ค้นหาโพสต์และรวบรวมลิงก์ที่เกี่ยวข้อง
- จัดหมวดหมู่: แยกประเด็นซ้ำ คำถาม และความเห็นที่แตกต่างกัน
- วิเคราะห์: เลือกประเด็นที่เกี่ยวข้องกับเป้าหมายของธุรกิจ
- ร่างเนื้อหา: เขียนบทความหรือสคริปต์จากข้อมูลที่ตรวจแล้ว
- เตรียมเผยแพร่: สร้างชื่อเรื่องและองค์ประกอบประกอบเนื้อหา
แต่ละขั้นควรระบุข้อมูลเข้า ผลลัพธ์ที่ต้องส่ง และเกณฑ์ตรวจรับ เช่น ขั้นเก็บข้อมูลต้องมีลิงก์ต้นทาง ส่วนขั้นวิเคราะห์ต้องแยกข้อเท็จจริงออกจากข้อเสนอ วิธีนี้ช่วยให้เรารู้ว่าความผิดพลาดเกิดตรงไหน แม้จะยังมองไม่เห็น model เบื้องหลังก็ตาม
จุดที่ควรระวังคือ การแยกงานมากเกินไปเพิ่มภาระส่งต่อข้อมูล หากสองขั้นใช้ข้อมูลเดียวกันและต้องตัดสินใจร่วมกันตลอด อาจเหมาะจะอยู่ใน skill เดียว เป้าหมายจึงไม่ใช่จำนวน skills ที่มากขึ้น แต่คือ งานที่มีขอบเขตชัดและตรวจสอบได้ง่ายขึ้น
ทดลองเปิด Claude Code ใน Grok Bot ผ่านบัญชีที่มีอยู่
เทคนิคช่วงท้ายคือการติดตั้ง Claude Code หรือ Codex ภายในคอมพิวเตอร์คลาวด์ของ Grok Bot แล้วเข้าสู่ระบบด้วยบัญชีของบริการนั้น จุดนี้ต้องแยกจากการเลือก model อัตโนมัติให้ชัด
- การเลือก model อัตโนมัติ: Grok Bot จัดการเลือก model เบื้องหลังให้
- การเปิด Claude Code หรือ Codex: บอทใช้เครื่องมือที่ติดตั้งในคอมพิวเตอร์ และเชื่อมบัญชีสมาชิกของบริการนั้นโดยตรง
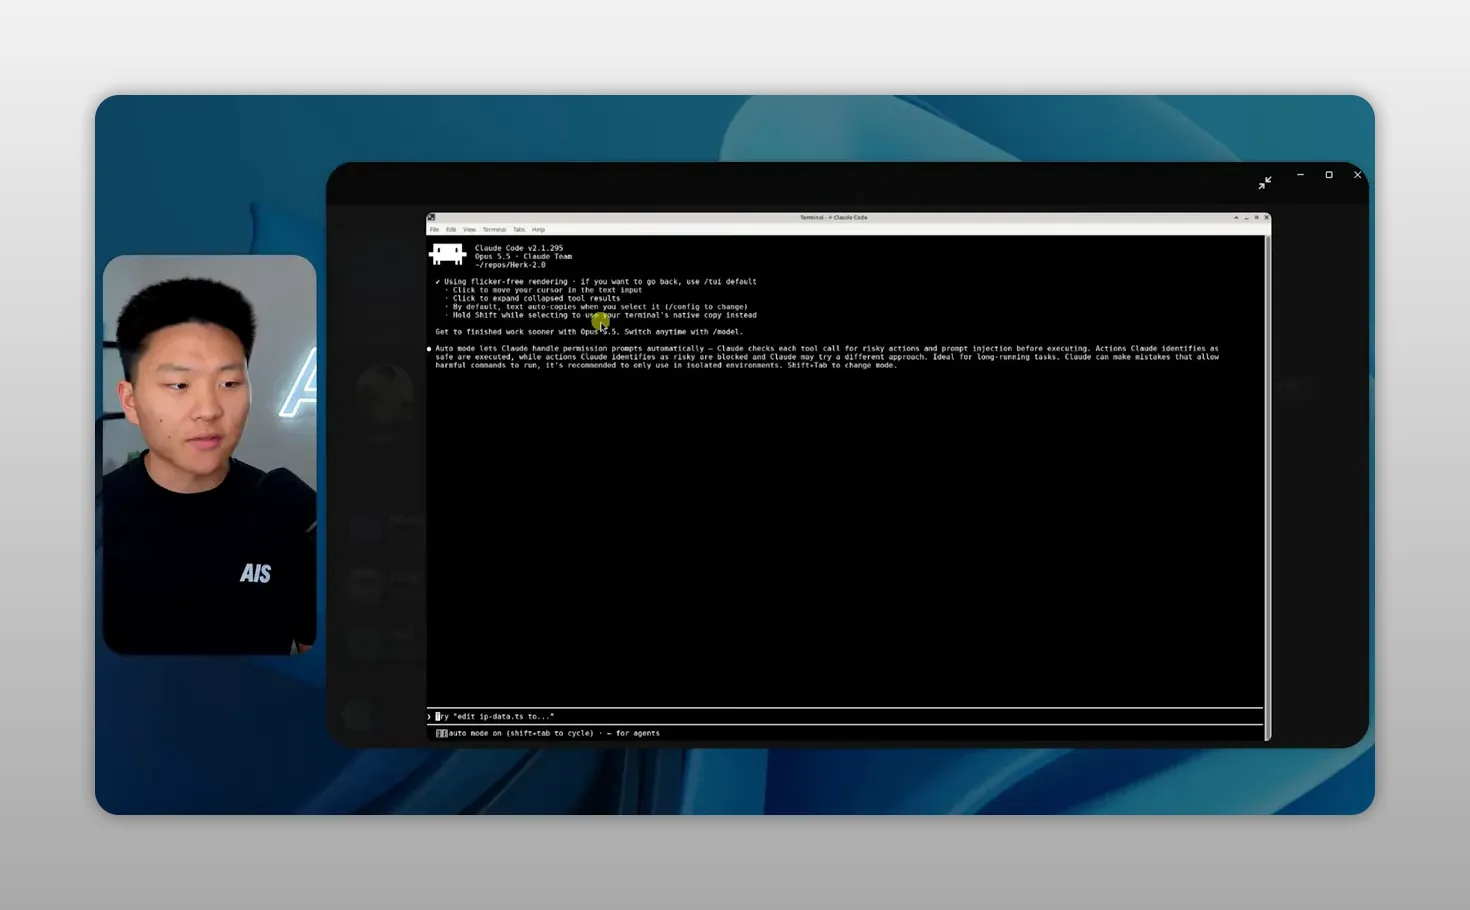
Nate อธิบายว่าบอทมีหน้าจอทำงานของตัวเอง แต่ใช้ระบบไฟล์ร่วมกัน และสามารถเปิด terminal เพื่อติดตั้งเครื่องมือแบบบรรทัดคำสั่งได้ ในตัวอย่าง เขาเปิด Claude Code ภายในโครงการของตัวเองและใช้บัญชีทีมที่มีอยู่
ลำดับการตั้งค่าที่ควรเข้าใจ
- เลือก agent ที่จะรับผิดชอบ หรือแยก agent สำหรับ Claude Code และ Codex โดยเฉพาะ
- สั่งให้เปิด terminal และติดตั้งเครื่องมือที่ต้องการ
- เมื่อระบบขอเข้าสู่ระบบ ให้คนเข้าควบคุมหน้าจอและอนุญาตการเชื่อมบัญชีด้วยตัวเอง
- นำโฟลเดอร์โครงการหรือคลังไฟล์งานเข้ามาในคอมพิวเตอร์คลาวด์
- ตรวจว่าไฟล์คำสั่ง skills และข้อมูลประกอบที่จำเป็นอยู่ครบ
- ตั้งค่าการเชื่อมต่อบริการที่งานนั้นต้องใช้ แล้วทดลองกับงานขนาดเล็ก
ประโยชน์ที่ Nate เน้นคือเข้าถึงโครงการผ่าน agent จากโทรศัพท์ได้ เพราะเครื่องคลาวด์ของเขาเปิดอยู่ สำหรับเจ้าของธุรกิจ นี่คือแนวคิดการแยกพื้นที่ทำงานออกจากคอมพิวเตอร์ส่วนตัว แต่ไม่ใช่หลักฐานว่าโครงการทุกชนิดจะย้ายแล้วทำงานได้ทันที
ก่อนเชื่อมบัญชี ควรตรวจข้อกำหนดและวิธีเข้าสู่ระบบล่าสุดจาก เอกสารทางการของ Claude Code หรือ เอกสารทางการของ Codex แทนการสมมติว่าบัญชีทุกแผนรองรับวิธีเดียวกัน การตั้งค่านี้ก็ไม่ได้ทำให้ทุกบริการที่เชื่อมต่อกลายเป็นใช้ฟรี
ย้ายการตั้งค่าได้ แต่ไม่ควรย้ายความลับทั้งหมดโดยไม่ตรวจ
Nate แนะนำให้นำไฟล์ .env ซึ่งมักเก็บการตั้งค่าและ API keys ไปด้วย เขาชอบใช้ API keys มากกว่าพึ่งส่วนเสริมในแอปเดสก์ท็อป เพราะย้ายระบบระหว่างเครื่องได้สะดวกกว่า
ประเด็นนี้มีเหตุผลในแง่การพกพาระบบ แต่สำหรับธุรกิจ เราไม่ควรคัดลอกไฟล์ความลับทั้งหมดขึ้นคลาวด์โดยอัตโนมัติ โดยเฉพาะเมื่อบอทใช้ระบบไฟล์ร่วมกัน ควรเลือกเฉพาะการเชื่อมต่อที่จำเป็น จำกัดสิทธิ์ และไม่ส่งค่าความลับลงในช่องสนทนาหรือคลังไฟล์ที่แชร์ แนวทางเพิ่มเติมอ่านได้จาก คำแนะนำการจัดการข้อมูลลับของ OWASP
สำหรับคนไม่ใช่ developer ขั้นตอนนี้ควรมีผู้ดูแลระบบช่วยตรวจ การสั่งติดตั้งอาจง่าย แต่ความรับผิดชอบเรื่องบัญชี สิทธิ์ และข้อมูลยังเป็นของทีมเรา
เลือกข้อคิดที่นำไปทำได้ทันที
- ตรวจงานค้นหา X ก่อน: เลือกงานประจำหนึ่งงาน ทดลองเปลี่ยนวิธีค้นหา แล้วตรวจยอด API เดิมก่อนขยายไปบอทอื่น
- แตกงานใหญ่หนึ่งชุด: แยกงานเก็บข้อมูลออกจากงานวิเคราะห์ พร้อมระบุผลลัพธ์ที่ต้องส่งต่อ
- ตั้งเกณฑ์ตรวจรับ: ให้รายงานมีแหล่งข้อมูล ข้อจำกัด และรายการที่ต้องให้คนตัดสินใจ
- ทดสอบความสม่ำเสมอ: ใช้โจทย์เดิมหลายครั้ง ตรวจทั้งความถูกต้องและรูปแบบ ไม่ประเมินจากคำตอบครั้งเดียว
- จำกัดสิทธิ์ก่อนเชื่อมบัญชี: เริ่มด้วยโครงการทดลองและการเชื่อมต่อเท่าที่จำเป็น ก่อนเปิดให้เข้าถึงงานจริง
แก้ปัญหาที่อาจเจอระหว่างนำไปใช้
รายการต่อไปนี้เป็นจุดตรวจจากข้อจำกัดและขั้นตอนที่กล่าวมา ไม่ใช่สถิติปัญหาที่เกิดกับทุกบัญชี
ปัญหา: สั่งเปลี่ยนแล้ว แต่ X API เดิมยังมีค่าใช้จ่าย
- สาเหตุ: อาจมีบอทหรืองานประจำบางส่วนยังเรียกวิธีเดิมอยู่
- วิธีแก้: ตรวจรายชื่อ workflow ที่ใช้ X แก้คำสั่งทีละชุด ทดลองค้นหาจำนวนน้อย และตรวจยอด API หลังทำงาน
ปัญหา: บอทบอกโควตาค้นหา แต่ตรวจแล้วไม่ตรง
- สาเหตุ: บอทอาจอธิบายข้อจำกัดของระบบจากข้อมูลที่ไม่ครบ
- วิธีแก้: ขอให้แยกข้อมูลที่ตรวจพบออกจากข้อสันนิษฐาน ตรวจหน้าบัญชีหรือเอกสารบริการ และอย่าตั้งรอบงานจากคำตอบของบอทเพียงอย่างเดียว
ปัญหา: skill เดิมให้ผลลัพธ์ไม่สม่ำเสมอ
- สาเหตุ: งานอาจรวมหลายหน้าที่ หรือใช้ model ต่างกันโดยที่เราไม่เห็น
- วิธีแก้: ลดขอบเขต prompt แยกงานค้นหากับงานวิเคราะห์ ระบุรูปแบบผลลัพธ์ และทดสอบด้วยข้อมูลชุดเดิม
ปัญหา: ติดตั้ง Claude Code แล้ว แต่ยังใช้งานไม่ได้
- สาเหตุ: การติดตั้งเครื่องมือไม่เท่ากับการเข้าสู่ระบบและอนุญาตบัญชีสำเร็จ
- วิธีแก้: เข้าควบคุมหน้าจอ ตรวจขั้นตอนเข้าสู่ระบบ ตรวจบัญชีที่ใช้งาน แล้วทดลองงานเล็กก่อนเริ่มโครงการจริง
ปัญหา: ย้ายโครงการแล้ว การเชื่อมต่อบางอย่างหายไป
- สาเหตุ: ไฟล์งานย้ายมาแล้ว แต่การตั้งค่าหรือสิทธิ์ของบริการยังไม่ครบ หรือเคยพึ่งส่วนเสริมบนเครื่องเดิม
- วิธีแก้: ทำรายการบริการที่ต้องใช้ ตรวจการตั้งค่าทีละรายการ และย้ายเฉพาะข้อมูลลับที่จำเป็นด้วยช่องทางที่เหมาะสม
ต่อยอดจากงานทดลองไปสู่งานประจำ
- รายงาน X ที่เชื่อมกับการตัดสินใจ: ไม่หยุดที่สรุปโพสต์ แต่ให้แยกประเด็นที่ควรตรวจต่อ พร้อมลิงก์หลักฐานและรายการงานที่ทีมต้องตัดสินใจ
- ชุด skills สำหรับงานเนื้อหา: เก็บขั้นค้นหา วิเคราะห์ และร่างเนื้อหาเป็นชุดที่ใช้ซ้ำได้ แล้วปรับคำสั่งจากข้อผิดพลาดที่พบจริง
- พื้นที่โครงการบนคลาวด์: ทดลองหนึ่งโครงการที่ข้อมูลไม่อ่อนไหว เพื่อเรียนรู้เรื่องการย้ายไฟล์ การเชื่อมบัญชี และขอบเขตสิทธิ์ก่อนขยายระบบ
ทั้งสามแนวทางควรเริ่มจากคำถามเดียวกันว่า งานส่วนไหนยังต้องให้คนรับผิดชอบ หากตอบไม่ได้ชัด การเพิ่ม automation อาจเพียงทำให้ความผิดพลาดเกิดเร็วขึ้น
สรุป Checklist ทั้งหมดก่อนใช้งานจริง
- ☐ เข้าใจว่า Grok Bot อาจเลือก model จากผู้ให้บริการอื่นตามงาน
- ☐ แยกข้อประกาศ ข้อสังเกตจากการทดลอง และข้อสันนิษฐานออกจากกัน
- ☐ รวบรวมบอทและงานประจำที่ยังเรียก X API แบบเสียเงิน
- ☐ ทดลองใช้การค้นหา X ในตัว พร้อมตรวจผลค้นหาและค่าใช้จ่ายเดิม
- ☐ ตรวจโควตาและเงื่อนไขบริการจากแหล่งที่ยืนยันได้
- ☐ เตรียม context การเชื่อมต่อ skills และรอบการทำงานให้ครบ
- ☐ แยก skill ก้อนใหญ่ตามชนิดงานและจุดตรวจรับ
- ☐ กำหนดข้อมูลเข้า ผลลัพธ์ และเกณฑ์ตรวจสอบของแต่ละขั้น
- ☐ หากใช้ Claude Code หรือ Codex ให้ตรวจบัญชีและเข้าสู่ระบบด้วยตัวเอง
- ☐ ย้ายไฟล์โครงการและตรวจการเชื่อมต่อ โดยไม่เปิดเผย API keys
- ☐ เริ่มด้วยสิทธิ์เท่าที่จำเป็นและโครงการความเสี่ยงต่ำ
- ☐ ทดสอบซ้ำก่อนเปลี่ยนงานทดลองเป็น workflow ประจำของทีม
สองอัปเกรดของ Grok Bot ตามที่คลิปนำเสนอเพิ่มความสะดวก แต่บทเรียนสำหรับธุรกิจคือการออกแบบงานให้ชัดกว่าเดิม การค้นหา X ในตัวช่วยลดการพึ่งบริการแยก ส่วนการเลือก model อัตโนมัติทำให้เราต้องสนใจขอบเขตของ skills และวิธีตรวจรับงานมากขึ้น
เราไม่จำเป็นต้องตั้งระบบทั้งหมดในครั้งเดียว จุดเริ่มต้นที่เหมาะคือเลือกงานหนึ่งงานซึ่งทำซ้ำบ่อย วัดผลได้ และความเสี่ยงต่ำ จากนั้นพิสูจน์ว่าระบบช่วยลดภาระได้จริงก่อนเพิ่มบอท เพิ่มการเชื่อมต่อ หรือย้ายโครงการสำคัญขึ้นคลาวด์
แหล่งที่มา: Grok Bot Just Got 2 Massive Upgrades. Do These Things Now. · บทความต้นทาง
