

บทความนี้ถ่ายทอดบทความต้นทางลงวันที่ 8 ตุลาคม 2026 และคลิป Anthropic Engineers Just 10x'd Everyone's Claude Code ของ Nate Herk | AI Automation ตัวเลขงานวิจัย การลด system prompt และผลตรวจระบบเป็นข้อมูลที่ผู้บรรยายนำมาเล่าหรือทดลองในระบบของเขา ยังไม่ได้ตรวจยืนยันกับงานต้นฉบับหรือทดสอบซ้ำ คำว่า 10x ในชื่อคลิปไม่ใช่ผลรับรองของบทความ ตัวอย่างทีมไทยและเช็กลิสต์คงจากบทความเดิม วันที่ข้างต้นเป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ทราบ คลิปมีช่วงผู้สนับสนุน Hyperagent
ถ้าเราเพิ่มกฎให้ Claude Code ทุกครั้งที่ AI ทำงานพลาด สุดท้ายระบบอาจเต็มไปด้วยคำสั่งที่เคยมีประโยชน์ แต่วันนี้กลับขวางการทำงานของ model รุ่นใหม่ ปัญหาจึงอาจไม่ใช่ AI รู้เรื่องธุรกิจน้อยเกินไป แต่เป็นการได้รับข้อมูลและขั้นตอนที่ไม่จำเป็นมากเกินไป
คลิปจากช่อง Nate Herk | AI Automation หยิบแนวคิดการจัดการ context ของ Anthropic มาทดลองกับระบบงานของตัวเอง ทั้งการลดคำสั่ง ตรวจสอบ skills และแก้ workflow ผลิตเนื้อหา ประเด็นที่น่าสนใจสำหรับเจ้าของธุรกิจและคนทำงานคือ เราจะเก็บความรู้เฉพาะขององค์กรไว้ได้อย่างไร โดยไม่บังคับให้ AI ทำตามคู่มือเก่าทุกบรรทัด
แม้ชื่อคลิปจะใช้คำว่าเก่งขึ้นสิบเท่า แต่รายละเอียดไม่ได้พิสูจน์ว่าทุกงานจะเร็วขึ้นหรือดีขึ้นสิบเท่า สิ่งที่นำไปใช้ได้มากกว่าคือหลักคิดนี้: ให้ AI รู้เป้าหมาย เหตุผล และข้อจำกัด แล้วทดสอบว่าขั้นตอนใดไม่จำเป็นอีกต่อไป
เข้าใจว่าทำไม Claude Code ไม่ได้ต้องการคำสั่งเพิ่มเสมอไป
System prompt เปรียบเหมือนคู่มือหลักที่กำหนดการทำงานของ AI ส่วนคำสั่งของเรา ไฟล์ความรู้ และข้อมูลของงาน เป็น context ที่เข้ามาประกอบการตัดสินใจ เมื่อทุกอย่างถูกโหลดพร้อมกัน model ต้องประมวลผลทั้งส่วนที่เกี่ยวข้องและส่วนที่ไม่ได้ช่วยให้งานสำเร็จ
Nate อ้างถึงการปรับระบบของทีม Anthropic ซึ่งลด system prompt ของ Claude Code มากกว่า 80% โดยไม่พบการสูญเสียผลลัพธ์ที่วัดได้ในชุดประเมินงานเขียนโค้ดที่ใช้ทดสอบ จุดสำคัญคือกฎบางข้อถูกสร้างขึ้นเพื่อชดเชยข้อจำกัดของ model รุ่นเก่า เมื่อ model พัฒนาขึ้น กฎเดิมอาจกลายเป็นข้อจำกัดเสียเอง
ตัวอย่างคือการควบคุมความยาวของคำอธิบายในโค้ดแบบตายตัว บางโครงการต้องการคำอธิบายมากกว่าที่กฎอนุญาต แนวทางใหม่จึงเปลี่ยนจากการกำหนดจำนวนหรือความยาว ไปเป็นการให้ทำตามรูปแบบของโค้ดที่อยู่รอบข้าง
สำหรับธุรกิจไทย เราอาจพบปัญหาคล้ายกันในคู่มือเขียนคอนเทนต์ที่กำหนดจำนวนหัวข้อทุกชิ้น หรือคู่มือทำรายงานที่บังคับโครงสร้างเดียวกันทุกกรณี มาตรฐานยังจำเป็น แต่รูปแบบที่ตายตัวไม่ควรถูกเข้าใจว่าเป็นมาตรฐานเสมอไป
ตัวเลขที่สนับสนุนแนวคิดนี้ต้องอ่านพร้อมเงื่อนไข
คลิปยกตัวอย่างการโหลดคำอธิบายเครื่องมือ MCP เฉพาะเมื่อจำเป็น ซึ่ง Nate อ้างว่า Anthropic รายงานการลดใช้ token ได้ 85% ในตัวอย่างนั้น ตามตัวเลขที่เขานำมาเล่า คะแนนประเมิน MCP ของ Opus 4 เพิ่มจาก 49% เป็น 74% และ Opus 4.5 เพิ่มจาก 79.5% เป็น 88.1% เครื่องมือยังอยู่ครบ เพียงไม่ได้โหลดคำอธิบายทั้งหมดตั้งแต่เริ่มงาน
อีกงานวิจัยที่คลิปกล่าวถึงพบผลลัพธ์ลดลงเมื่อข้อมูลขาเข้ายาวขึ้น โดยทดสอบห้า model กับโจทย์คณิตศาสตร์ การตอบคำถาม และการเขียนโค้ด แต่ตัวเลขเหล่านั้นไม่ใช่คำทำนายผลลัพธ์ของระบบเรา งานและเงื่อนไขต่างกัน จึงควรใช้เป็นเหตุผลให้ทดลอง ไม่ใช่เหตุผลให้ลบไฟล์ทันที
แนวคิดพื้นฐานอ่านเพิ่มเติมได้จาก บทความการจัดการ context สำหรับ AI agents ของ Anthropic และ แนวทางการใช้เครื่องมือขั้นสูงของ Anthropic
กำหนดว่า “งานเสร็จ” ต้องมีหน้าตาแบบไหน
ก่อนลดคำสั่ง เราต้องมีเกณฑ์ตัดสินผลลัพธ์ ไม่เช่นนั้น prompt ที่สั้นลงอาจดูดีเพียงเพราะอ่านง่ายกว่า แต่ไม่ได้ทำให้งานใช้ได้จริง
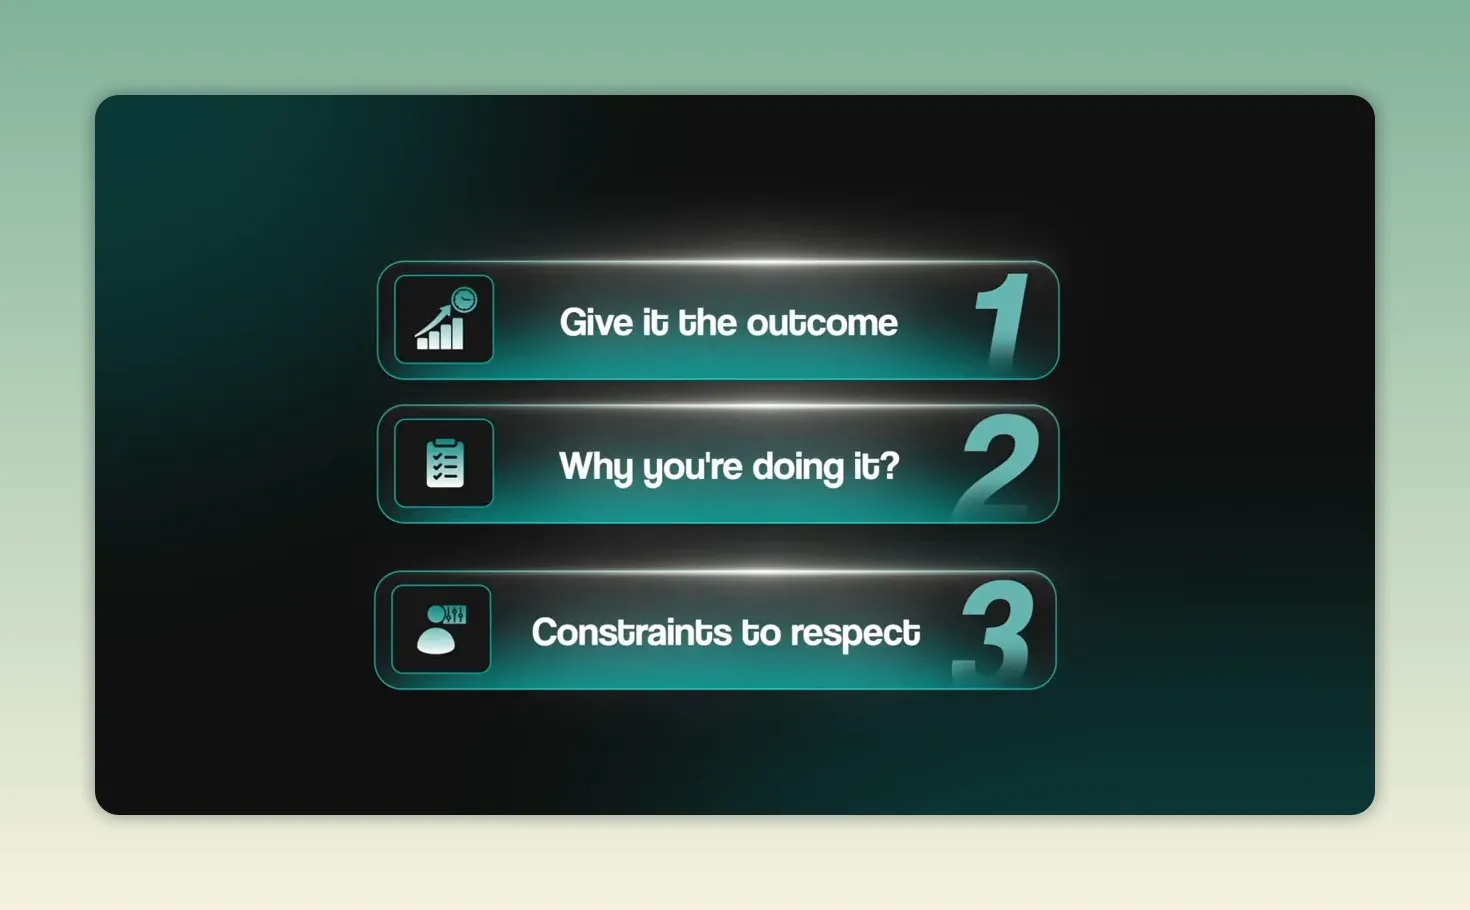
กรอบที่ Nate ใช้มีสามส่วน ซึ่งนำมาใช้กับงานธุรกิจได้ตรงไปตรงมา:
- ผลลัพธ์: ต้องการเอกสารหรือชิ้นงานอะไร และต้องพร้อมนำไปใช้ระดับไหน
- เหตุผล: งานนี้ทำเพื่อใคร และช่วยให้คนรับงานทำอะไรต่อได้
- ข้อจำกัด: สิ่งใดห้ามเปลี่ยน ข้อมูลใดต้องตรวจสอบ และการกระทำใดต้องขออนุมัติ
ตัวอย่างประยุกต์สำหรับทีมไทยคือการสั่งให้สร้างคู่มือจากบทสัมภาษณ์ แทนที่จะบอกเพียงว่า “สรุปให้ละเอียด” เราอาจกำหนดว่าต้องเป็นคู่มือสำหรับพนักงานใหม่ ช่วยให้เข้าใจแนวคิดและนำไปใช้ได้ พร้อมระบุแหล่งข้อมูล และยังไม่แก้ไฟล์ต้นฉบับ
เมื่อเหตุผลชัด AI มีข้อมูลสำหรับเลือกว่าจะใช้คำอธิบายง่าย ตัวอย่าง หรือการจัดหมวดหมู่แบบไหน โดยเราไม่ต้องกำกับทุกย่อหน้า นี่ไม่ใช่การปล่อยให้ทำอะไรก็ได้ แต่เป็นการเปลี่ยนจากควบคุมวิธีทำทุกจุด ไปสู่ควบคุมผลลัพธ์และขอบเขต
แยกข้อมูลธุรกิจที่ต้องเก็บออกจากขั้นตอนที่ควรทบทวน
การลด context ไม่ได้หมายถึงทำให้ทุกอย่างสั้นที่สุด ข้อมูลที่จำเป็นต่อการตัดสินใจต้องอยู่ครบ แม้จะยาวก็ตาม เป้าหมายคือ ข้อมูลน้อยที่สุดที่ยังทำให้งานผ่านเกณฑ์ ไม่ใช่จำนวนบรรทัดน้อยที่สุด
Nate เน้นข้อมูลสี่กลุ่มที่ AI ไม่ควรต้องเดาเอง ได้แก่ น้ำเสียง เป้าหมาย กลุ่มผู้อ่าน และวิธีดำเนินธุรกิจ ข้อมูลเหล่านี้ต่างจากคำแนะนำทั่วไป เพราะสะท้อนตัวตนและเงื่อนไขเฉพาะขององค์กร
ข้อมูลที่ควรเก็บไว้
- โครงการนี้มีไว้ทำอะไร และใครเป็นผู้รับผลงาน
- น้ำเสียงของแบรนด์และข้อกำหนดด้านรูปแบบที่ต้องรักษา
- เหตุผลเบื้องหลังงาน เช่น ใช้สอนผู้เริ่มต้นหรือใช้ประกอบการตัดสินใจ
- ข้อควรระวังและขอบเขตสิทธิ์ในการแก้ไขข้อมูล
- ตำแหน่งของคู่มือเฉพาะทางที่ต้องเปิดอ่านเมื่อถึงงานนั้น
ข้อมูลที่ควรตรวจสอบก่อนโหลดทุกครั้ง
- กฎเดียวกันที่เขียนซ้ำในหลายไฟล์
- ขั้นตอนละเอียดที่ใช้กับงานเฉพาะประเภท
- รายการโฟลเดอร์ยาวที่ AI สามารถตรวจจากไฟล์จริงได้
- ข้อห้ามที่เพิ่มหลังความผิดพลาดครั้งเดียวและไม่เคยทดสอบใหม่
ไฟล์ CLAUDE.md จึงควรเป็นจุดเริ่มต้นที่บอกเป้าหมาย ข้อควรระวัง และทางไปยังคำสั่งเชิงลึก ไม่จำเป็นต้องเป็นสารานุกรมของทุก workflow เช่น งานช่วยเขียนบทไม่ควรต้องแบกคู่มือตัดต่อวิดีโอทั้งหมดไปด้วย
มุมที่ต้องระวังคือ อย่าจัดข้อกำหนดสำคัญของธุรกิจเป็น “กฎเก่าที่น่าจะลบได้” เพียงเพราะมันยาว การลดคำสั่งควรเริ่มจากส่วนซ้ำและส่วนไม่เกี่ยวข้อง ก่อนแตะข้อจำกัดที่ป้องกันความเสียหาย
ทดลองเปรียบเทียบก่อนลบ skills
Nate ทดลองทำสำเนาระบบ AI OS ของตัวเอง แล้วนำ CLAUDE.md และ skills ออก เพื่อเปรียบเทียบการทำงานเดียวกัน ตัวอย่างที่เล่าคือการเปลี่ยนบทสัมภาษณ์ Boris Cherny ให้เป็นคู่มือสำหรับผู้เรียน
ระบบเดิมสร้างเอกสารที่สวยกว่า เพราะรู้แบรนด์ รูปแบบหัวข้อ และลิงก์ที่มักใช้ แต่ระบบที่ลดคำสั่งกลับจัดเนื้อหาได้ดีกว่าในความเห็นของ Nate ทั้งรายละเอียด การแบ่งแนวคิด และการใส่เวลาของประเด็นสำคัญ
ข้อสรุปจึงไม่ใช่ “ไม่มี skills ดีกว่า” แต่เป็นการแยกสองเรื่องออกจากกัน: รูปแบบแบรนด์ควรคงที่ ส่วนโครงสร้างเนื้อหาควรปรับตามงาน เขาจึงเสนอให้สร้าง skill ใหม่ที่รักษาหัวเอกสาร ฟอนต์ ท้ายเอกสาร และโลโก้ แต่เปิดพื้นที่ให้ model จัดเนื้อหาเอง
สำหรับทีมธุรกิจ วิธีทดลองที่เหมาะสมคือใช้ชิ้นงานเดิม เป้าหมายเดิม และ model เดียวกัน เปรียบเทียบระบบปัจจุบันกับสำเนาที่ลดคำสั่ง แล้วดูอย่างน้อยสามด้าน:
- ความถูกต้อง: ข้อมูลครบและไม่เพิ่มข้อเท็จจริงที่ไม่มีหลักฐานหรือไม่
- ความพร้อมใช้งาน: คนรับงานต้องแก้โครงสร้างหรือเนื้อหามากแค่ไหน
- ความสม่ำเสมอ: น้ำเสียง แบรนด์ และข้อจำกัดยังอยู่ครบหรือไม่
การทดลองครั้งเดียวเป็นเพียงสัญญาณ ไม่ใช่ข้อพิสูจน์ว่าคำสั่งเดิมทั้งหมดไร้ประโยชน์ หากผลดีขึ้น ค่อยนำส่วนที่จำเป็นกลับมาอย่างเลือกสรร
ตรวจสุขภาพระบบและหาคำสั่งที่โหลดโดยไม่รู้ตัว
ในตัวอย่างของ Nate การเรียก /doctor นำไปสู่รายงานตรวจระบบ ครอบคลุม skills ความจำ ปลั๊กอิน การตั้งค่า และการติดตั้ง อย่างไรก็ตาม รายงานละเอียดในคลิปเป็นผลจากชุดระบบที่เขาใช้อยู่ ไม่ควรคาดหวังว่าทุกการติดตั้งจะได้ตารางและสถิติแบบเดียวกัน หากผลลัพธ์ต่างกัน เราสามารถขอให้ AI ตรวจไฟล์คำสั่งและ workflow เพิ่มโดยตรง
สิ่งที่รายงานของเขาพบมีทั้ง skills เก่า 18 รายการที่ไม่มีบันทึกการใช้ คำสั่งซ้ำ และไฟล์ที่ตั้งค่าไม่ถูกต้อง รายงานยังประเมินว่าการตัดข้อความซ้ำประมาณ 2,250 ตัวอักษรช่วยลดได้ราว 563 token
ตัวเลข token ของรายการ skill ไม่ได้แปลว่าเนื้อหาทั้ง skill ถูกโหลดแล้ว ส่วนคำอธิบายสั้นด้านบนไฟล์ที่เรียกว่า front matter ช่วยให้ระบบเลือก skill ก่อน ส่วนคำสั่งเต็มจะถูกอ่านเมื่อจำเป็นต้องใช้งาน ความต่างนี้สำคัญ เพราะเราไม่ควรตัดสินภาระของระบบจากขนาดไฟล์เพียงอย่างเดียว
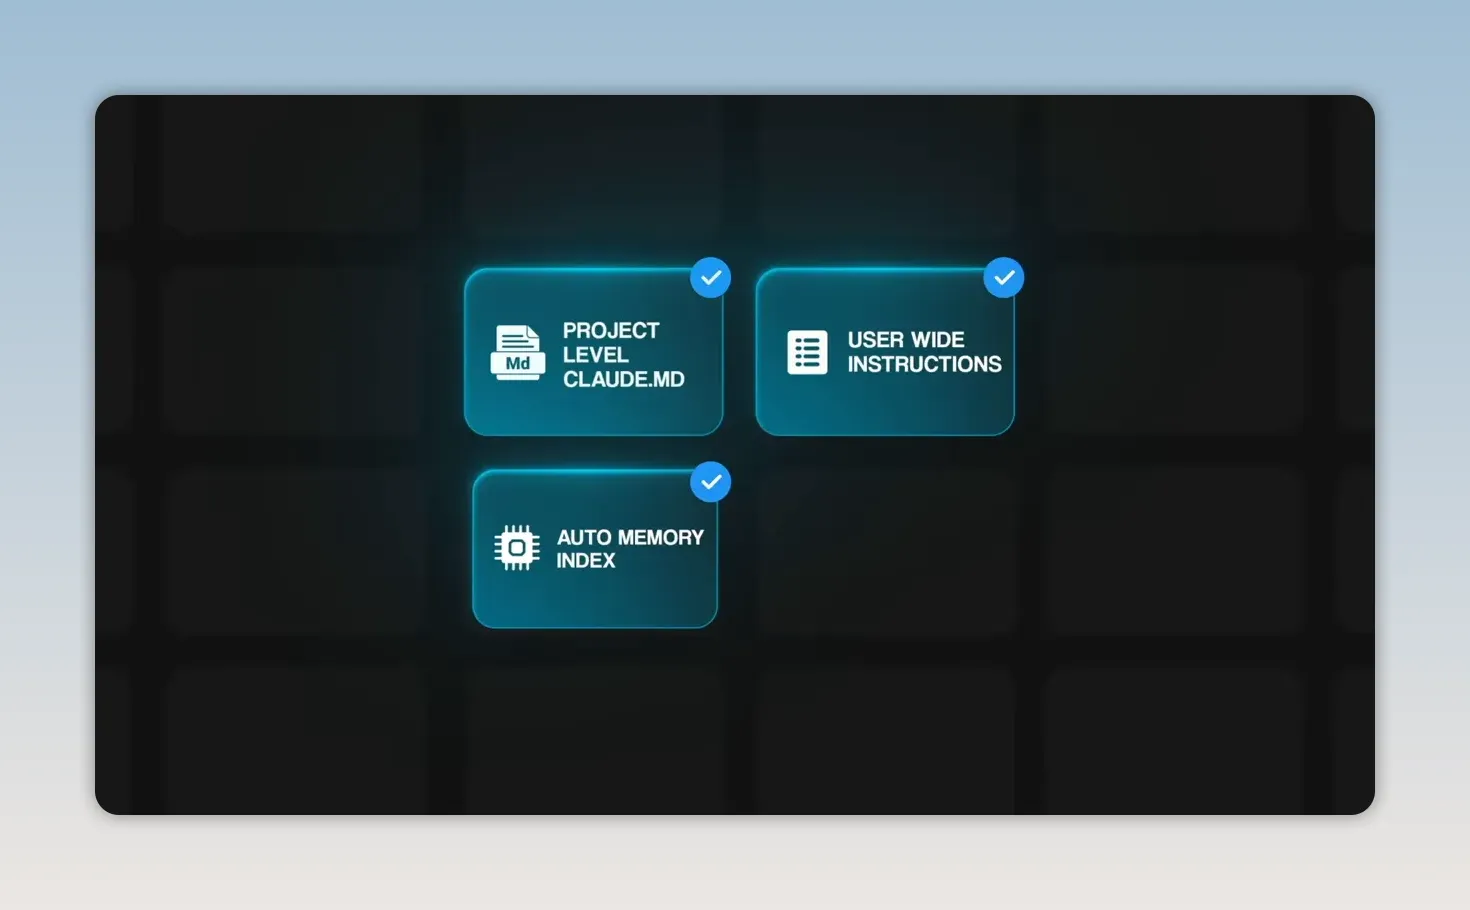
รายงานยังพบคำสั่งจากหลายระดับ ทั้งไฟล์ของโครงการ คำสั่งระดับผู้ใช้ ดัชนีความจำอัตโนมัติ และไฟล์เฉพาะเครื่อง รวมถึง CLAUDE.md ในโฟลเดอร์แม่ที่เพิ่ม context อีกประมาณ 2,000 token การทำความสะอาดไฟล์เดียวจึงอาจยังไม่แก้ปัญหาทั้งหมด
สำหรับเจ้าของธุรกิจ ประเด็นนี้คล้ายการมีคู่มือหลายฉบับที่ไม่มีใครรู้ว่าฉบับไหนมีผลอยู่ งานแรกของการตรวจระบบคือทำให้เห็นว่า AI กำลังรับคำสั่งจากที่ใดบ้าง แล้วค่อยตัดสินใจรวม ย้าย หรือปิดส่วนใด
บันทึกการใช้เป็นข้อมูลประกอบ ไม่ใช่คำสั่งให้ลบ หากทีมเรียก skill ผ่านเครื่องมืออื่น หรือ skill ใช้กับงานที่เกิดไม่บ่อย สถิติที่ตรวจได้อาจไม่สะท้อนการใช้งานทั้งหมด
แก้จุดส่งต่องาน ก่อนสร้างระบบใหม่
ส่วนที่นำไปใช้กับธุรกิจได้ชัดที่สุดคือการตรวจ workflow จากไอเดีย YouTube ไปสู่บทที่พร้อมถ่ายทำ Nate ขอให้ Claude หา “การเปลี่ยนแปลงที่เล็กที่สุด” ใช้ระบบที่มีอยู่ อ้างไฟล์ให้ชัด และยังไม่แก้ไขอะไร
เราสามารถนำหลักเดียวกันมาปรับเป็น prompt สำหรับงานของทีมได้:
ตรวจ workflow และไฟล์ในโครงการนี้ แล้วเสนอการเปลี่ยนแปลงที่เล็กที่สุดเพื่อให้งานจากข้อมูลตั้งต้นไปสู่ชิ้นงานพร้อมใช้ลื่นขึ้น ใช้ระบบที่มีอยู่ ระบุไฟล์ที่จะนำกลับมาใช้พร้อมเหตุผล และยังไม่แก้ไขไฟล์ใดจนกว่าจะได้รับอนุมัติ
ระบบของ Nate มีลำดับตั้งแต่หาไอเดีย ค้นข้อมูล ทำโครงเรื่อง เขียนบท จนถึงไฟล์สำหรับเครื่องแสดงบทพูด ปัญหาที่พบไม่ได้อยู่ที่ขาด skill ใหม่ แต่เป็นการส่งต่อหลักฐานไม่สม่ำเสมอ
Skill ทำโครงเรื่องค้นข้อเท็จจริงได้ แต่ไม่ได้กำหนดให้บันทึกหลักฐานลงไฟล์ ส่วน skill เขียนบทถูกสั่งให้ตรวจข้อเท็จจริงใหม่อีกครั้ง ผลคือขั้นตอนถัดไปอาจต้องทำงานซ้ำ เพราะไม่เห็นสิ่งที่ตรวจไว้แล้ว
การตรวจพบโฟลเดอร์วิดีโอ 25 แห่งที่มีบท แต่มีเพียงสามแห่งที่มีไฟล์ชื่อ sources.md ไม่ได้แปลว่าอีก 22 แห่งไม่มีการค้นข้อมูล แต่สะท้อนว่าช่องทางส่งต่อหลักฐานนี้ยังไม่เป็นมาตรฐาน ข้อเสนอจึงเป็นการแก้สามจุดในสอง skills เดิม แทนการสร้างระบบใหม่ทั้งหมด
หากประยุกต์กับทีมไทย เช่น ทีมคอนเทนต์หรือทีมทำข้อเสนอขาย เราควรถามว่า “ข้อมูลที่ตรวจแล้วถูกส่งไปกับงานหรือไม่” ก่อนถามว่า “ต้องเพิ่ม AI ตัวไหน” ขั้นตอนถัดไปควรได้รับทั้งชิ้นงาน หลักฐาน และประเด็นที่ยังไม่ยืนยัน
การใช้หลักฐานร่วมกันไม่ได้หมายถึงเลิกตรวจสอบ แต่ช่วยให้การตรวจครั้งถัดไปมุ่งไปที่ช่องว่าง ข้อขัดแย้ง หรือข้อมูลที่เปลี่ยนแปลง แทนเริ่มค้นใหม่ทั้งหมด
จัดรอบตรวจระบบให้เป็นงานประจำ
Nate แนะนำให้ตรวจทุกเดือนหากเพิ่ม skills และเปลี่ยน workflow บ่อย หรือทุกไตรมาสหากระบบค่อนข้างคงที่ อีกจังหวะที่ควรตรวจคือเมื่อเปลี่ยน model เพราะคำสั่งเดิมอาจถูกตีความต่างไป
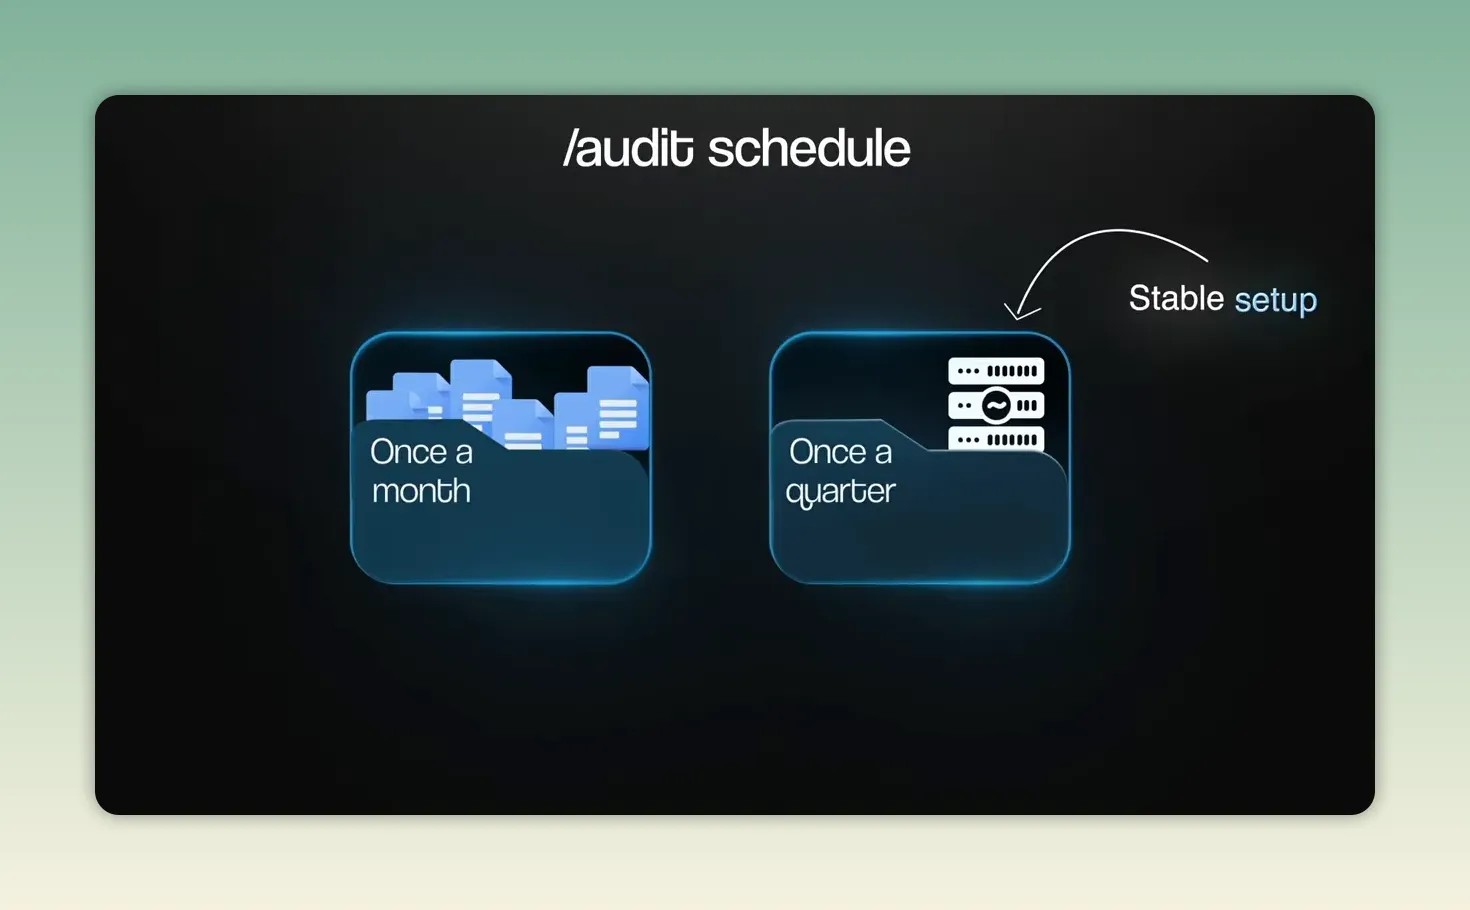
เมื่อเริ่มเชื่อถือกระบวนการตรวจ เราสามารถตั้งงานตามเวลาให้รวบรวมข้อเสนอแนะได้ โดยงานตรวจไฟล์ในเครื่องต้องทำงานในสภาพแวดล้อมที่เข้าถึงไฟล์และการตั้งค่าเหล่านั้นได้ แนวคิดในคลิปคือให้ AI เสนอ แล้วคนอนุมัติหรือปฏิเสธ ไม่ใช่ลบทุกอย่างอัตโนมัติ
สำหรับทีม ควรมีผู้รับผิดชอบคำสั่งส่วนกลางด้วย ไม่เช่นนั้นแต่ละคนอาจแก้ปัญหาด้วยการเพิ่มกฎของตัวเอง จนเกิดคู่มือหลายชุดที่ขัดกัน ระบบ AI OS จะมีประโยชน์มากขึ้นเมื่อทีมใช้ความรู้ร่วมกัน ไม่ใช่ต่างคนต่างสะสมคำสั่ง
เลือกสิ่งที่ลงมือทำได้ทันที
- เลือกหนึ่งงานประจำ: เริ่มจากงานที่มีผลลัพธ์เดิมให้เปรียบเทียบ ไม่ปรับทั้งองค์กรพร้อมกัน
- เขียนเกณฑ์งานเสร็จ: ระบุผลลัพธ์ เหตุผล และข้อจำกัดก่อนแก้ prompt
- ลดส่วนซ้ำก่อน: รวมกฎที่เหมือนกัน และย้ายคู่มือเฉพาะงานออกจากคำสั่งหลัก
- กำหนดจุดส่งต่อหลักฐาน: ให้ขั้นตอนถัดไปเห็นข้อมูลที่ตรวจแล้วและข้อที่ยังไม่ยืนยัน
- นัดรอบทบทวน: ตรวจทุกเดือนหรือไตรมาส และตรวจเพิ่มเมื่อเปลี่ยน model
แก้ปัญหาที่พบบ่อยระหว่างปรับระบบ
ปัญหา: ลดคำสั่งแล้วงานไม่ตรงแบรนด์
- สาเหตุ: ตัดข้อมูลเฉพาะธุรกิจออกพร้อมกับขั้นตอนที่ไม่จำเป็น
- วิธีแก้: คืนข้อกำหนดน้ำเสียง กลุ่มผู้อ่าน และรูปแบบแบรนด์ จากนั้นทดสอบใหม่โดยยังไม่บังคับโครงสร้างเนื้อหาทุกจุด
ปัญหา: ติดตั้ง skill แล้ว AI ไม่เรียกใช้
- สาเหตุ: ในตัวอย่างของ Nate มีทั้งชื่อไฟล์ผิดและ front matter ที่อ่านไม่ได้ ทำให้ระบบไม่เห็นคำอธิบาย skill ตามที่ควร
- วิธีแก้: ให้ตรวจชื่อไฟล์และส่วนคำอธิบายด้านบน เทียบกับ คู่มือ skills ของ Claude Code แล้วทดลองกับงานที่ตรงกับ skill นั้น
ปัญหา: ล้างไฟล์โครงการแล้ว context ยังเยอะ
- สาเหตุ: มีคำสั่งจากระดับผู้ใช้ ความจำอัตโนมัติ หรือโฟลเดอร์แม่ถูกโหลดร่วมด้วย
- วิธีแก้: ขอรายการแหล่งคำสั่งทั้งหมด ตรวจส่วนซ้ำทีละแหล่ง แล้วเริ่มงานใหม่เพื่อเปรียบเทียบผล
ปัญหา: AI ตรวจข้อมูลซ้ำทุกขั้นตอน
- สาเหตุ: ขั้นตอนก่อนหน้าไม่ได้บันทึกหรือส่งต่อหลักฐานอย่างสม่ำเสมอ
- วิธีแก้: กำหนดไฟล์หลักฐานร่วมกัน ให้ขั้นตอนถัดไปอ่านก่อน และระบุเรื่องที่ต้องตรวจเพิ่มแทนการเริ่มใหม่ทั้งหมด
ปัญหา: ระบบแนะนำให้ลบ skill ที่ทีมยังต้องใช้
- สาเหตุ: สถิติไม่ครอบคลุมทุกช่องทาง หรือเป็นงานที่ใช้ไม่บ่อย
- วิธีแก้: ตรวจสอบกับทีมและเก็บสำเนาก่อนปิดใช้งาน ทดลองกับงานจริง แล้วค่อยตัดสินใจลบถาวร
วางแผนการต่อยอดและสรุปรายการตรวจสอบ
แนวทางต่อยอด
- สร้างแหล่งคำสั่งกลางของทีม: แยกมาตรฐานแบรนด์ออกจากคู่มือเฉพาะงาน พร้อมระบุผู้รับผิดชอบแต่ละส่วน
- ทำรายงานตรวจระบบตามเวลา: ให้ AI รวบรวมคำสั่งซ้ำ ไฟล์ที่มีปัญหา และข้อเสนอปรับ workflow เพื่อรออนุมัติ
- แยกพื้นที่งานเมื่อต้องดูแลหลายลูกค้า: ช่วงผู้สนับสนุนในคลิปนำเสนอ Hyperagent ซึ่งแยกพื้นที่ลูกค้าและสิทธิ์แก้ไข แนวคิดที่นำไปต่อยอดได้คือการแยกข้อมูลและแยกสิทธิ์ผู้ใช้งานออกจากผู้ดูแลระบบ ไม่จำเป็นต้องเลือก platform ตามคลิป
สรุป Checklist ทั้งหมด
- ☐ เลือก workflow ที่ต้องการปรับและเก็บผลลัพธ์เดิมไว้เปรียบเทียบ
- ☐ ระบุผลลัพธ์ เหตุผล และข้อจำกัดของงาน
- ☐ ทำสำเนาไฟล์คำสั่งและ skills ก่อนทดลอง
- ☐ เก็บข้อมูลแบรนด์ เป้าหมาย กลุ่มผู้อ่าน และเงื่อนไขธุรกิจ
- ☐ รวมกฎซ้ำและทบทวนข้อห้ามจาก model รุ่นเก่า
- ☐ ย้ายคู่มือเฉพาะงานไปโหลดเมื่อจำเป็น
- ☐ ตรวจแหล่งคำสั่งทุกระดับ ไม่ใช่เฉพาะไฟล์โครงการ
- ☐ ตรวจชื่อไฟล์ คำอธิบาย skill และข้อผิดพลาดในการตั้งค่า
- ☐ ตรวจการใช้งานจริงก่อนปิดหรือลบ skill
- ☐ กำหนดวิธีส่งต่อหลักฐานระหว่างขั้นตอน
- ☐ เปรียบเทียบความถูกต้อง ความพร้อมใช้ และความสม่ำเสมอ
- ☐ อนุมัติการแก้ไขเป็นจุดเล็ก ๆ และเก็บทางย้อนกลับ
- ☐ นัดตรวจระบบรายเดือน รายไตรมาส และเมื่อเปลี่ยน model
บทเรียนของ Claude Code ไม่ใช่ “prompt สั้นชนะเสมอ” แต่คือ “คำสั่งทุกส่วนต้องมีเหตุผลที่ยังอยู่” ข้อมูลธุรกิจที่ AI เดาไม่ได้ควรเก็บไว้ ส่วนกฎซ้ำ ขั้นตอนล้าสมัย และข้อมูลที่ไม่เกี่ยวกับงานควรถูกทบทวน การเริ่มจากการแก้จุดเล็กที่สุดพร้อมวัดผล จะช่วยให้เราได้ระบบที่ดูแลง่ายขึ้น โดยไม่แลกความถูกต้องกับความสั้น
แหล่งที่มา: Anthropic Engineers Just 10x'd Everyone's Claude Code · บทความต้นทาง
