

วันที่บทความต้นทางใน VideoToBlog: 2026-04-07 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว แนวคิดเรื่อง context window และตัวอย่างความเร็วเป็นคำอธิบายในต้นทาง ไม่ใช่ผลทดสอบอิสระหรือเกณฑ์ที่ใช้ได้กับทุกโมเดล การตัดสินใจและการตรวจโค้ดยังอยู่กับมนุษย์ · วิดีโอต้นทาง
ช่วงที่วงการ AI ย้ายจาก “พิมพ์คำสั่งแล้วได้ผลลัพธ์” ไปสู่ “ให้โมเดลทำงานเป็นขั้นตอนและลงมือเปลี่ยนระบบให้จริง” ความคาดหวังก็เปลี่ยนตามอย่างรวดเร็ว หลายทีมเริ่มเห็นภาพผ่านเดโมที่ดูเหมือนเวทมนตร์ แต่พอเข้าไปทำงานกับโค้ดจริง เวิร์กโฟลว์จริง และข้อจำกัดจริง ปัญหาก็โผล่ทันที: บริบทไม่พอ ผลลัพธ์หลุดกรอบ ตัดสินใจผิดบริบท หรือบางครั้งเอาแนวทางเดโมไปใช้ในโปรดักชันแล้ว “พังเงียบ”
แนวคิดที่ช่วยแก้ช่องว่างนี้คือ agentic engineering หรือการออกแบบกระบวนการทำงานร่วมกับ “coding agents” ให้เหมือนการทำงานกับวิศวกรคนหนึ่ง แต่มีมนุษย์เป็นผู้กำกับ ท้ายที่สุดเป้าหมายไม่ใช่ให้ AI เขียนทุกบรรทัด แต่คือทำให้ทีม ใช้ได้ผลดี และ ควบคุมได้ ในระดับที่เหมาะกับความเสี่ยงของงาน
จากผู้ช่วยพิมพ์โค้ดสู่ “ผู้ลงมือทำงาน”
ภาพจำช่วงแรกของการใช้ AI ในซอฟต์แวร์คือการช่วยเติมข้อความหรือแนะนำโค้ดแบบ autocomplete เมื่อพูดถึง Copilot หรือเครื่องมือแนวเดียวกัน โดยหลักมันช่วยลดแรงพิมพ์และเพิ่มความเร็ว
แต่สิ่งที่กำลังเกิดขึ้นในสมัยนี้คือโมเดลจำนวนมากไม่ได้หยุดที่การ “แนะนำ” แล้ว โมเดลสามารถ “execute” งานได้เอง แยกงานเป็นย่อย ดูว่าต้องแก้ไฟล์ใด รันเทสต์ และกลับมาพร้อม pull request ที่พร้อมให้คนตรวจ
การเปลี่ยนนี้ทำให้กรอบคิดแบบเดิมไม่พออีกต่อไป เพราะเรากำลังไม่ได้ใช้เครื่องมือแบบหยิบแล้ววางอย่างค้อน แต่กำลังทำงานกับอีกฝ่ายที่คิดเป็นขั้นเป็นตอนและลงมือกับระบบโดยตรง
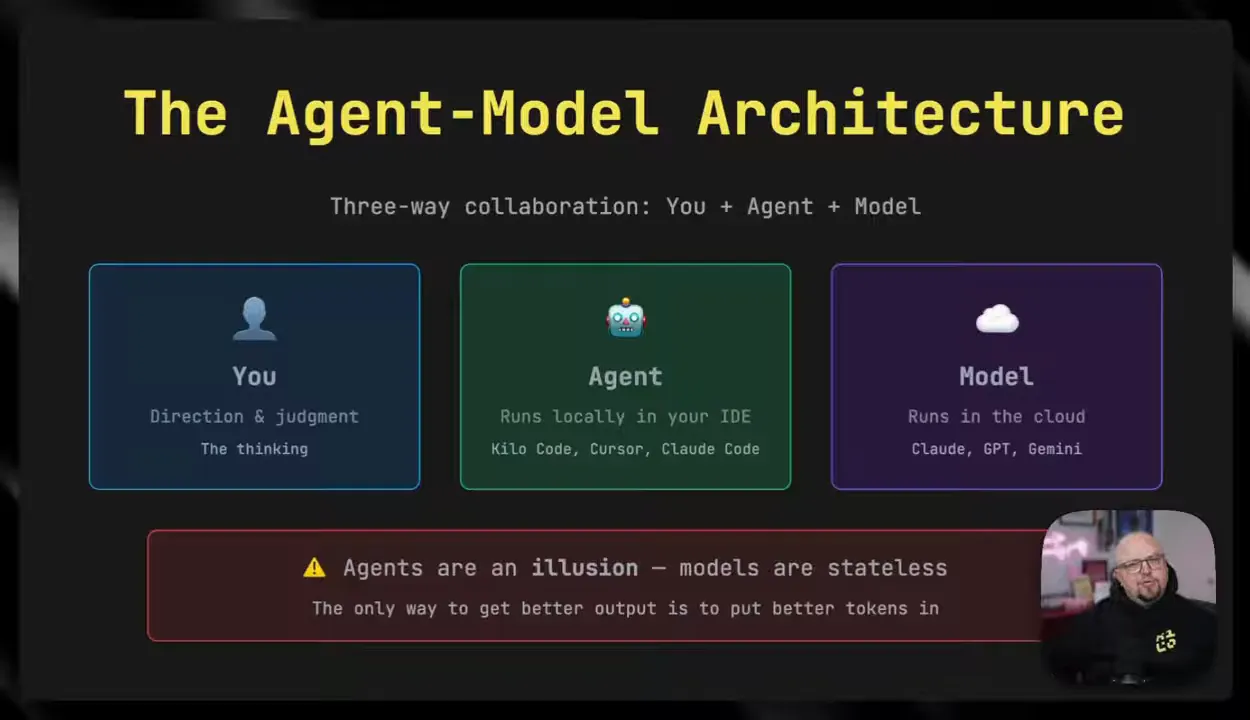
กรอบคิดสำคัญ: คิดว่า AI คือ “จูเนียร์ร่วมทีม” ที่เร็วมากแต่ไม่มี judgment
หนึ่งในคำอธิบายที่ชัดที่สุดที่ใช้ทำให้ทีมปรับมุมมองคือการมองว่า agent เหมือน จูเนียร์วิศวกรที่กระตือรือร้น อ่านมาทุกอย่างในโลกนี้ แต่สิ่งที่ขาดคือ judgment
จุดแข็งของจูเนียร์แบบนี้คือความเร็วและความไม่ถือตัว เขา rewrite ได้หลายรอบ ถามเพื่อความเข้าใจ และกว้างเรื่องเทคโนโลยี แต่ข้อจำกัดคือเขาไม่มีบริบทของธุรกิจ เขาไม่รู้ว่าทำไมสามเดือนก่อนถึงเลือกสถาปัตยกรรมเฉพาะแบบนั้น
ผลลัพธ์ที่ตามมาคือ AI อาจเขียนโค้ดที่ “ถูกทางเทคนิค” แต่ “ผิดทางบริบท” ได้แบบมั่นใจ ดังนั้นส่วนที่มนุษย์ต้องทำไม่ใช่แค่ตรวจโค้ด แต่คือกำกับแนวทางการตัดสินใจ
ในทางปฏิบัติ สิ่งนี้สะท้อนกับความแตกต่างระหว่าง using AI กับ working with AI อันแรกคือปล่อยให้มันช่วยเขียนอย่างอัตโนมัติ อันหลังคือเราเป็นคนกำหนดขอบเขต สิ่งที่ต้องเก็บไว้ และสิ่งที่ควรปล่อยให้ agent ทำ
agentic engineering คือการออกแบบ “ระบบการทำงาน” ไม่ใช่การหาโมเดลที่ฉลาดกว่า
ถ้ามองให้ลึก เราจะเห็นว่า AI ที่ดีขึ้นไม่ได้รับประกันความสำเร็จในโปรดักชัน เพราะปัจจัยที่ทำให้เวิร์กโฟลว์พัง มักมาจากเรื่องที่อยู่ “รอบๆ โมเดล” เช่น บริบทไม่ครบ การตัดสินใจในจังหวะผิด หรือการสะสมข้อมูลผิดทาง
agentic engineering จึงเป็นงานออกแบบที่เกี่ยวกับ:
- วิธีให้ agent รับบริบทเท่าที่จำเป็น
- วิธีแบ่งงานและแยก session
- วิธีให้มนุษย์ตรวจและกำหนดทิศทาง
- วิธีทำให้ขั้นตอนวิจัยและขั้นตอนลงมือทำโค้ดแยกจากกัน
บริบทคือหัวใจ: context engineering (ศิลปะและวิทยาศาสตร์)
หัวใจอันดับหนึ่งของ agentic engineering คือ context engineering แนวคิดคือเติมบริบทให้ agent “พอและถูกต้อง” สำหรับการทำงานรอบถัดไป แต่ไม่ใช่เติมให้มากที่สุด
ทำไม context จึงแพงและไม่เสมอไปว่าจะดีกว่า
บริบทมีต้นทุน เพราะทุก token ที่ใส่กลับเข้าไปใหม่เมื่อมีการส่งข้อความแต่ละครั้ง ทำให้ค่าใช้จ่ายเพิ่มขึ้น และยังมีผลต่อคุณภาพ
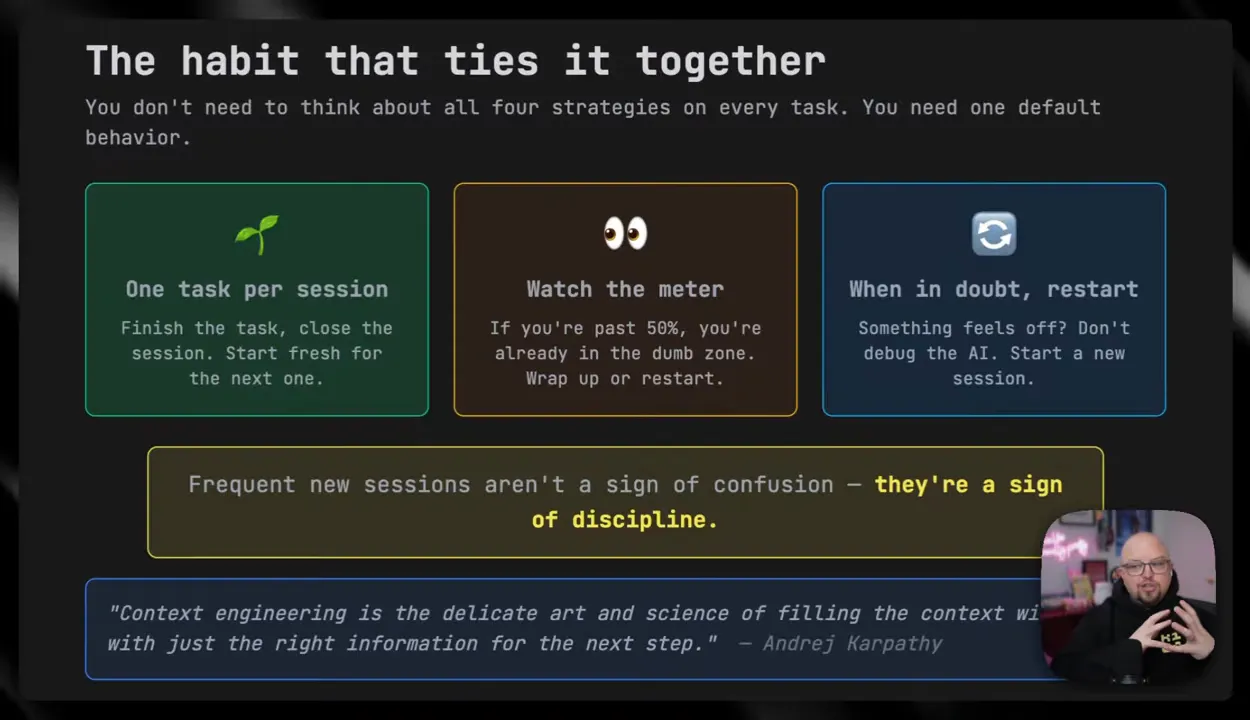
เรื่องที่น่าประหลาดคือ บริบทที่มากขึ้นอาจทำให้โมเดลดูเหมือน “ฉลาดน้อยลง” มีการสังเกตว่าเมื่อบริบทเริ่มอิ่มใกล้ระดับประมาณครึ่งหนึ่ง คุณภาพอาจเริ่มตก และที่สำคัญคือองค์ประกอบบางอย่างของบริบทอาจทำให้เกิด “ความสับสนสะสม”
ยิ่งเมื่อ MCP servers (หรือเครื่องมือเสริมที่เชื่อมต่อข้อมูลกับโลกภายนอก) ได้รับความนิยม การเปิดใช้งานหลายตัวพร้อมกันก็ยิ่งเพิ่มรายละเอียดที่ agent ต้องอ่าน แม้จะไม่เกี่ยวกับงานนั้นโดยตรง
บริบทแย่คือการ “พิษ” ที่ย้อนกลับมาทำลายงาน
บริบทไม่ได้เป็นแค่เรื่องปริมาณ แต่เป็นเรื่องคุณภาพด้วย
ตัวอย่างของบริบทแย่ที่พบได้คือ:
- ผสมงานคนละเรื่องไว้ใน session เดียวจนโมเดลจับทิศทางไม่ถูก
- มีข้อมูลเก่าในโค้ดหรือความเห็นที่เคยทำไปแล้วถูกเปลี่ยน แต่ agent ยัง “เห็น” อยู่ในบริบทเดิม
- เริ่มเดินทางผิดทางแล้วพยายาม steer กลับ แต่ความผิดนั้นยังค้างอยู่ใน context และแทรกกลับมาในรูปแบบแพตเทิร์นที่ไม่ควรกลับมา
ภาพรวมคือ agent ไม่ได้ใช้ “เหตุผลแบบมนุษย์” เช่นการหยุดคิดและลบความเข้าใจผิดออกจากหัว เขากำลังอ่านบริบททุกครั้ง ดังนั้นสิ่งที่ผิดตั้งแต่แรกอาจยังวนกลับมาเป็นแรงดึง
แนวปฏิบัติ: persist อย่างเป็นระบบ, คัดเฉพาะ, สรุปและตัด, และแยก context
วิธีจัดการที่ใช้ได้จริงประกอบด้วยหลายชั้น
- เก็บข้อมูลนอก context window เพื่อดึงกลับมาใช้เฉพาะจุด เช่น scratch pad, memory files, หรือไฟล์ที่ agent ใช้จำรายละเอียดระหว่างรอบ
- เลือกบริบทเฉพาะสิ่งที่เกี่ยวกับขั้นตอนนั้น อย่าดึงทุกอย่างที่อาจจะมีประโยชน์ในอนาคตทันที เช่น อ้างถึงไฟล์เฉพาะที่เกี่ยวกับ step นั้น
- สรุปและบีบอัดเมื่อ session โตเกินไป เมื่อจบการดีบักหรือได้ข้อสรุปแล้ว ให้ compress context เหลือเฉพาะสิ่งที่จำเป็นต่อการแก้ปัญหา
- แยก context ด้วยการใช้หลาย session หรือหลาย agent เพื่อไม่ให้ข้อมูลสะสมผิดทิศและเพื่อให้แต่ละส่วนทำหน้าที่ของตัวเอง
แนวคิดนี้น่าสนใจตรงที่มันคล้ายกับการเป็น engineering manager ที่ต้องให้ “งานจบเป็นชิ้น” แทนการโยนโจทย์ยาวๆ แบบไม่มีกรอบ แล้วคาดหวังให้จูเนียร์เดาได้เองว่าอะไรสำคัญ
บทเรียนจากการเป็นผู้จัดการ: context ที่ไม่ถูกให้ผลลัพธ์ที่ผิดได้เสมอ
มีเรื่องเล่าที่ทำให้เห็นภาพชัด เมื่อผู้เขียนเคยเป็น engineering manager และออกแบบโปรเจกต์ที่ให้ intern ทำต้นแบบบนอุปกรณ์ใหม่ เขากล่าวว่า intern ส่งต้นแบบกลับมา แต่รายละเอียดอย่าง Comic Sans และ emoji placeholder กลายเป็นของจริง เพราะ spec ที่ให้มีสิ่งนั้นอยู่
ความผิดไม่ใช่ของ intern แต่เป็นของผู้จัดการที่ไม่ให้ context ที่ถูกต้องว่าต้องเน้นอะไรและอะไรไม่สำคัญ สิ่งนี้สะท้อนกับ agent engineering โดยตรง เพราะ agent ก็เหมือน intern: ถ้า context ที่ให้ไม่ชัด เขาจะทำตามสิ่งที่เขา “อ่านได้” อย่างซื่อสัตย์ แต่เราคิดว่าเราสื่อสารอย่างอื่น
ดังนั้นกฎในทางปฏิบัติที่ควรติดหัวคือ ทำหนึ่งงานต่อ session และถ้ารู้สึกว่า “off the rails” ให้เริ่ม session ใหม่ดีกว่าค่อยๆ ดึงกลับด้วยคำสั่งทีหลัง
จุดที่น่าช่วยคือให้ agent สรุป session ก่อนเริ่มใหม่ เพราะ agent ทำได้ดีมากกับการเขียน prompt สำหรับ AI อีกตัว หลังสรุปแล้วมนุษย์อ่านและยืนยันว่าตรงความเข้าใจหรือไม่ ก่อนค่อยส่ง context ที่ “สะอาดแล้ว” ให้รอบถัดไป
วิธีทำให้ agent ทำงานได้ดี: Research Plan Implement loop
เมื่อพูดถึง workflow ที่นำไปใช้ได้จริง โครงที่ถูกหยิบมาใช้ซ้ำคือ Research Plan Implement หรือวงจรวิจัยวางแผนและลงมือทำ
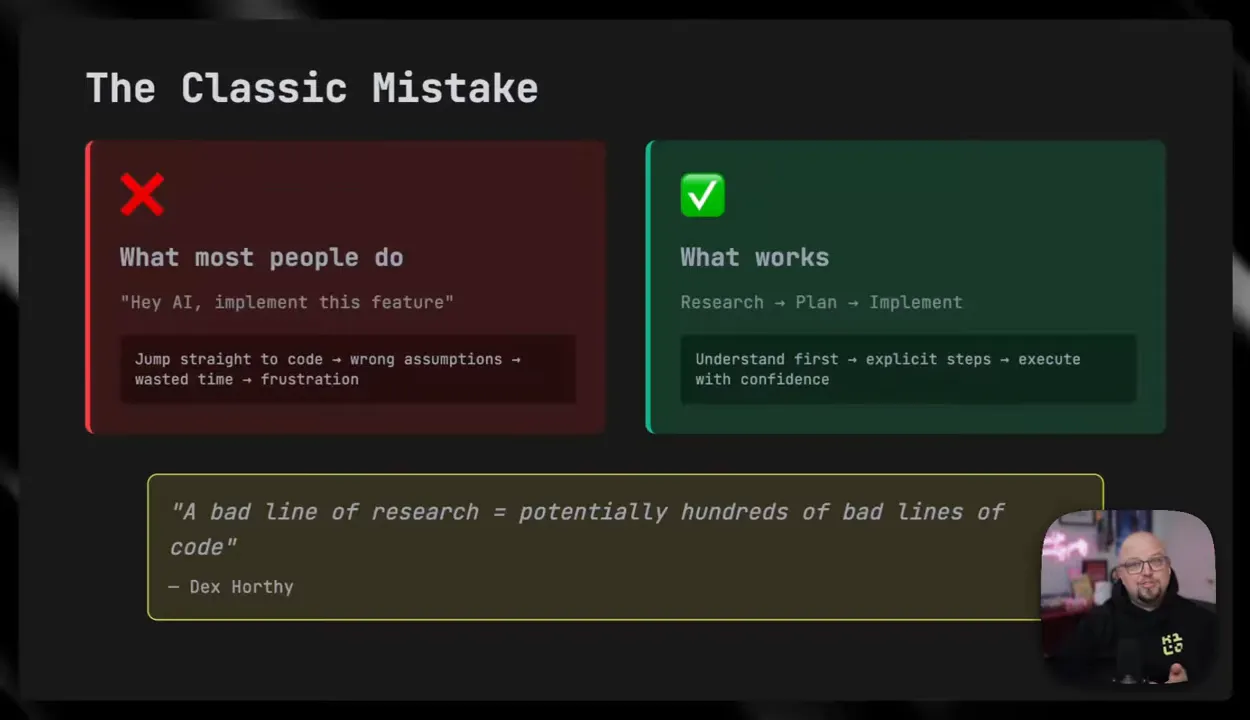
ปัญหายอดฮิตของคนเริ่มต้นคือเริ่มจาก “ขอให้ implement feature เลย” เพราะภาษากับ LLM มักสร้างโค้ดได้เยอะและดูเหมือนจะได้ผลรวดเร็ว แต่จริงๆ แล้วการกระโดดลงเขียนโค้ดตั้งแต่ยังไม่เข้าใจระบบจะทำให้เกิดสมมติฐานผิด และสร้างเวลาเสียมากขึ้น
ผลที่ตามมาคือบางคนเลยกลายเป็นสายต่อต้าน AI เพราะเคยใส่ garbage เข้าไปแล้วได้ garbage ออกมา หรือใช้มาช้าเกินไปจนโมเดลรุ่นเก่าไม่ตอบโจทย์ที่ควรเป็น
วงจร Research Plan Implement ทำหน้าที่ตัดปัญหาเหล่านี้ออกตั้งแต่ต้น: เริ่มจากทำให้ agent เข้าใจปัญหาอย่างถูกต้อง แล้วค่อยลงมือทำตามแผน
เฟส 1: Research (เข้าใจระบบก่อน)
แนวทางคือใช้ agent โหมดที่เน้นการ “คิดและหาความจริง” มากกว่าการเขียนโค้ดทันที ตัวอย่างที่กล่าวถึงคือการมีโหมดที่เรียกว่า Ask mode ซึ่งมีจุดสำคัญคือ “ทำอะไรไม่ได้” ยกเว้นคุยและอ่านข้อมูล (อ่านไฟล์ได้ในขอบเขตที่อนุญาต) แต่ไม่เริ่มเขียนไฟล์หรือแก้ระบบ
เป้าหมายของ research คือ:
- เข้าใจว่าระบบทำงานอย่างไรในปัจจุบัน
- ค้นหาไฟล์ที่เกี่ยวข้องจริง
- ระบุแพตเทิร์นหรือแนวทางที่ควรเลียนแบบ
- เข้าใจการไหลของข้อมูลและผลกระทบจากการเปลี่ยนแปลง
- คิดถึง edge cases ที่ต้องระวัง
และเมื่อ research จบ สิ่งที่ได้ควรออกมาเป็นเอกสารวิจัยที่อธิบายรายละเอียดให้มนุษย์อ่านและยืนยันได้ว่าตรงกับความเข้าใจหรือไม่ AI ช่วย “ระดมความคิด” ได้ แต่เราต้องยอมรับผ่านความเห็นชอบของมนุษย์ก่อนก้าวต่อ
เฟส 2: Plan (แปลงความเข้าใจเป็นแผนที่ทำตามได้)
หลังมนุษย์เห็นด้วยกับ research แล้วจึงเข้าสู่การวางแผน
แผนที่ดีไม่ใช่แค่รายการงาน แต่ควรมีความชัดว่า:
- จะสร้างหรือแก้ไฟล์ใด
- มีโค้ด snippet จำเป็นไหม (บางครั้งการยึด snippet อาจทำให้ผิดทิศได้)
- จะตรวจอย่างไรว่าเปลี่ยนแล้วถูกต้อง รวมถึง test commands
- ระบุ in scope และ out of scope อย่างชัดเจน ว่าจะเปลี่ยนอะไรและจะไม่เปลี่ยนอะไร
ในทางปฏิบัติมักจัดเก็บเป็นไฟล์ใน repo เช่น folder ที่เป็น “plans” เพื่อทำให้ trace ได้ง่าย และทำให้คนอื่นอ่านต่อได้
สิ่งที่น่าสนใจคือ plan ที่ชัดยังทำให้ทีมสามารถใช้โมเดลที่เล็กลงหรือถูกลงในขั้น implement ได้ เพราะ hard thinking ไปอยู่ใน research และ plan แล้ว
เฟส 3: Implement (ลงมือทำแบบควบคุมบริบทน้อย)
เมื่อถึงขั้น implement ต้องเริ่ม session ใหม่อีกครั้ง เพื่อให้ context ต่ำลงและลดความเสี่ยงจากบริบทสะสม
แนวปฏิบัติอื่นที่ถูกแนะนำคือ:
- ทบทวนทีละ change
- commit ถี่ๆ เพื่อให้แก้และย้อนกลับได้ง่าย
- ใช้ Git ในเครื่องเพื่อทำเหมือนขั้นตอน review pull request แรกสำหรับงานที่ agent ทำ
และจุดที่ย้ำคือเวลามนุษย์ในเฟส research และ plan เป็น “เวลาที่คุ้มที่สุด” เพราะเมื่อเริ่มเขียนโค้ดแล้ว จะเริ่มเจอค่าใช้จ่ายของการแก้ความเข้าใจผิดในทีหลัง
แนวคิดที่อ้างถึงคือ AI ไม่สามารถแทนที่การคิดได้ มันแค่ขยายการคิดที่เราทำไว้แล้วหรือขยายความไม่คิดของเราให้ใหญ่ขึ้น ดังนั้นถ้าเรายังไม่คิด Research และ Plan ก็อย่าหวังว่า implement จะรอด
โหมดและการกำหนดขอบเขต: Ask, Code, Architect และกฎของ workspace
เมื่อวงจรหลักถูกวางแล้ว ขั้นถัดไปคือการ “กำหนดพฤติกรรมของ agent” ให้เหมาะกับงาน
มีแนวคิดเรื่อง modes ซึ่งทำให้ agent มีบทบาทต่างกัน เช่น:
- Architect สำหรับการวางแผน
- Ask สำหรับการวิจัย
- Code สำหรับการลงมือเขียนและแก้โค้ด
แต่ mode ยังไม่พอ ต้องมี “กฎของ workspace” เช่น conventions, คำสั่งที่ใช้ build/test และเงื่อนไขการทำงานที่ต้องผ่านก่อน commit
เครื่องมืออาจโหลดกฎได้ถ้าเราจัดไว้เป็นไฟล์ใน context เช่น agents.md และ skills.md (ซึ่งกำลังกลายเป็นมาตรฐานโดยปริยาย)
agents.md: สถานที่ของกฎประจำโครงการ
agents.md ควรมีข้อมูลขั้นต่ำที่ agent จำเป็นต้องรู้เสมอ เช่น:
- conventions ของโปรเจกต์
- คำสั่ง build และ test
- เงื่อนไขความพร้อมก่อน commit
skills.md: เวิร์กโฟลว์สำเร็จรูปสำหรับงานที่ทำซ้ำ
skills คือ playbooks ที่เอาไว้เรียกใช้งานเมื่อมีงานแบบเดิมซ้ำๆ มากกว่าการใส่ทุกอย่างไว้ใน agents.md
แนวคิดคือถ้ามีงานที่ทีมทำบ่อย เช่น การเตรียม changelog หรือ workflow เฉพาะอื่นๆ สามารถทำเป็น skill และให้ agent เปิดใช้เฉพาะตอนที่ต้องใช้เท่านั้น
การควบคุม autonomy: ปรับระดับว่าอะไรให้ทำเองได้ อะไรต้องขออนุมัติ
การตั้งค่า agent สามารถกำหนดระดับของความเป็นอิสระได้ เช่น จำนวน agent ที่ทำงานพร้อมกัน การใช้ work trees เพื่อแยกงานแล้ว merge เข้ากับ repo หลัก และความสามารถในการอ่าน/เขียนไฟล์หรือรัน tests โดยไม่ต้องขอคนก่อน
ส่วนสำคัญคือทำให้ทีม “สบายใจ” กับระดับ autonomy ในช่วงแรก และยอมรับว่าต้องปรับเพิ่มเมื่อเรียนรู้จากการใช้งานจริง
มองแบบ buckets เพื่อช่วยจัดระบบก็ได้ โดยแยกอย่างน้อยสามชั้น:
- mode ตามบทบาท
- ความสามารถของ agent ที่ทำได้เอง (อ่านไฟล์ รันเทสต์ เปลี่ยนไฟล์)
- สิ่งที่ต้องให้มนุษย์ approve ทุกครั้ง (เช่น การตัดสินใจบางประเภทหรือการกระทบกับระบบเสี่ยง)
ทิปส์สำหรับการใช้งานจริง: mentioning, slash commands, และการดึง context จาก IDE
เพื่อให้เวิร์กโฟลว์ลื่น แนะนำให้จัดวิธีดึง context ที่รวดเร็ว เช่น:
- mentioning ไฟล์หรือ commit หรือเอาตัวอย่างจาก terminal output เข้ามาในบริบท
- ใช้ slash commands เพื่อเริ่มงานใหม่ หรือบีบ context เมื่อเริ่มอิ่ม
- ใน IDE เช่น VS Code สามารถเลือกส่วนโค้ดแล้ว “add to agent workspace” เพื่อให้ agent เห็นเฉพาะส่วนที่เกี่ยวข้อง
และในสมัยนี้ยังเห็นการขยับจากการใช้งานใน IDE อย่างเดียวไปสู่การใช้งานผ่านหลายช่องทาง เช่น CLI จากมือถือ, cloud agent, หรือแม้แต่ใน Slack ทำให้ภาพของ agent เป็น “collaborator ที่อยู่ได้ทุกที่” มากขึ้น
MCP และการเพิ่ม context จากเครื่องมือภายนอก: ประโยชน์มหาศาล แต่ต้องระวัง token และความสับสน
แนวคิดของ Model Context Protocol (MCP) คือการขยายสิ่งที่โมเดลทำได้จากแค่รับ input tokens และสร้าง output tokens ไปสู่การเรียกใช้เครื่องมือในสภาพแวดล้อม เช่น รัน tests หรือไปอ่านข้อมูลจากระบบภายนอก
ตัวอย่างที่กล่าวถึงคือ MCP สำหรับ GitHub ที่ช่วยให้ agent เรียก API เพื่อดู pull requests, comments และ issues และมี MCP อื่นๆ ที่ช่วยให้ agent ดึงเอกสารเฟรมเวิร์กที่อัปเดต
แต่เรื่องสำคัญคือทุก MCP server ที่เปิดอยู่จะเพิ่มรายละเอียดที่ต้องถูกส่งเข้า prompt ทุกครั้ง ทำให้เกิดการใช้ token เพิ่ม และบางครั้งทำให้ agent “สับสน” ได้ หาก MCP นั้นไม่เกี่ยวกับงานที่กำลังทำ
ตัวอย่างในบทเรียนคือถ้ามี MCP ที่เชื่อมต่อ Postgres แต่ทำงานเฉพาะส่วน front-end ที่ไม่แตะฐานข้อมูล การเปิด MCP database ก็ทำให้ token สูญและอาจทำให้ agent เข้าใจผิดว่าควรแตะ database ตอนนั้นหรือไม่ควรแตะ
คำแนะนำคือปิดสิ่งที่ไม่ใช้ และเปิดเฉพาะเมื่อมีเหตุผลจริง
การทำงานกับ API ภายในองค์กร: เลือกวิธีให้เหมาะกับความเปลี่ยนแปลง
อีกประเด็นที่เจอบ่อยในองค์กรคือการให้ agent ใช้กับ platform APIs ภายใน ซึ่งมักไม่มีเอกสารที่เป็นมาตรฐาน
แนวทางที่กล่าวถึงมีหลายแบบ:
- ถ้ามี open API spec หรือ Swagger spec อยู่แล้ว ให้ใช้เอกสารนั้น
- ถ้าไม่มี ให้แปลงเป็น markdown แล้วเก็บไว้ให้ agent อ้างอิง เช่น ใน agents.md
- ถ้า API เปลี่ยนบ่อย อาจต้องอ้างอิง URL ให้ agent ดึงข้อมูลล่าสุดทุกครั้งเมื่อทำงาน
- บางองค์กรที่มี workflow หลายขั้นหลายระบบ อาจต้องสร้าง MCP server เอง
และแม้ทำไปได้แค่ไหน หลักการที่ถูกย้ำคือให้ แยกงาน agent ออกจากงานคน แล้วทบทวนผลลัพธ์ของ agent ในรูปแบบ pull request เสมอ การทำแบบนี้ทำให้เราตรวจได้เหมือนตรวจโค้ดของวิศวกรรุ่นน้อง
ทำให้ “คิด-วางแผน-ลงมือ” กลายเป็นนิสัย: แล้วทีมจะได้อะไร
ทิศทางทั้งหมดชี้ไปที่แนวคิดเดียวกัน: AI จะทำให้เร็วขึ้นจริง แต่ความเร็วจะเกิดเมื่อเราออกแบบกระบวนการให้รองรับข้อจำกัดของมัน
การเริ่มต้นจึงควรเป็นการเลือกเครื่องมือและ “ฝึกซ้ำ” เพื่อรู้ขอบเขตความน่าเชื่อถือของแต่ละโมเดลและแต่ละ agent ว่าอะไรทำได้ดีและอะไรควรให้คนตัดสิน
และเมื่อเริ่มใช้วงจร Research Plan Implement อย่างมีวินัย อาจเกิดสิ่งที่หลายคนรู้สึกได้จริงคือ “ความสนุกกลับมา” เพราะเราสามารถปล่อยงานที่น่าเบื่อและทำซ้ำให้ agent ช่วย แล้วสมองไปอยู่กับปัญหายากและงานออกแบบที่มีคุณค่าจริง
คำศัพท์เฉพาะทางเพิ่มเติม
Agentic Engineering
แนวทางออกแบบเวิร์กโฟลว์ที่ทำงานร่วมกับ coding agents โดยมนุษย์กำกับการตัดสินใจ เน้นเรื่องบริบท การแบ่งงาน และ human-in-the-loop แทนการหวังผลจาก “เขียนโค้ดอัตโนมัติ” แบบตรงๆ
Context Engineering
การคุม “สิ่งที่ agent ได้รับ” เพื่อให้ทำงานได้ถูกขั้นตอน โดยคัดเฉพาะสิ่งที่จำเป็น ป้องกันบริบทสกปรก และจัดการการสะสมบริบทด้วยการสรุป ตัด และแยก session
MCP (Model Context Protocol)
โปรโตคอลที่ช่วยให้โมเดลเรียกใช้เครื่องมือภายนอกได้มากกว่าการรับข้อความและตอบกลับ เช่น ไปอ่านข้อมูลจาก GitHub หรือดึงเอกสารจากแหล่งอื่น เพื่อทำให้ agent มีความรู้และความสามารถในโลกจริงมากขึ้น
อ้างอิงเพิ่มเติม: https://en.wikipedia.org/wiki/OpenAI
Research Plan Implement loop
วงจรทำงานที่แยกความคิดออกจากการเขียนโค้ด เริ่มจากทำความเข้าใจระบบ (Research) จากนั้นแปลงเป็นแผนที่ตรวจสอบได้ (Plan) แล้วจึงค่อยให้ agent ลงมือทำ (Implement) ใน session ใหม่เพื่อคุมบริบท
บทสรุปส่งท้าย
- ช่องว่างไม่ได้อยู่ที่ว่า “ทีมใช้ AI แล้วหรือยัง” แต่อยู่ที่ทีม ใช้ได้ผลดีไหม และอธิบายเวิร์กโฟลว์ได้หรือไม่
- การมอง agent เป็นเหมือน “จูเนียร์ที่เร็วแต่ไม่มี judgment” ทำให้การกำกับมนุษย์มีเหตุผลและไม่ใช่แค่กังวล
- context engineering คือทักษะหลัก: บริบทต้องถูกต้องพอ คัดเฉพาะ และไม่ควรสะสมจนคุณภาพตก
- Research Plan Implement loop ช่วยกันพลาดแบบคลาสสิก ที่กระโดดเข้าเขียนโค้ดก่อนเข้าใจปัญหา
- การออกแบบ modes, agents.md, skills.md และระดับ autonomy ช่วยให้ agent ทำงานเป็นขั้นเป็นตอนและตรวจสอบได้เหมือน junior engineer
- MCP เพิ่มพลังจริง แต่ต้องเปิดใช้แบบมีวินัย ป้องกัน token สูญและความสับสนจากเครื่องมือที่ไม่เกี่ยว
อ้างอิงเพิ่มเติม: context window
