

ที่มา: คลิป The Missing Layer After Launch ของ Raphael Kalandadze, Wandero AI ทางช่อง AI Engineer และบทความ VideoToBlog วันที่ 2026-07-04 (วันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอที่ตรวจยืนยันแล้ว) สถาปัตยกรรม รอบเวลาตรวจและผลลัพธ์เป็นคำอธิบายของผู้บรรยาย ยังไม่ได้ทดสอบระบบซ้ำ ภาพสถาปัตยกรรมระบุ QA/computer-use เป็น roadmap แม้มีช่วงเดโมในคลิป จึงไม่ควรสรุปว่าทั้งสี่บทบาททำงานใน production ครบวงจรแล้ว การเสนอ PR ยังควรมีผู้รับผิดชอบตรวจและอนุมัติก่อนใช้กับระบบจริง · วิดีโอต้นทาง
ปัญหาของ AI Agent ในธุรกิจไม่ได้เริ่มตอน build ไม่เสร็จ แต่มักเริ่มตอนทุกอย่างดูเหมือนเสร็จแล้วต่างหาก ระบบตอบได้ เดโมผ่าน ทีมพอใจ แล้วก็เปิดใช้งานจริง แต่หลังจากนั้นคำถามสำคัญกลับโผล่มาเป็นชุด เราจะรู้ได้อย่างไรว่า agent ช่วยลูกค้าได้จริง เราจะตามดูบทสนทนาจำนวนมากได้อย่างไร และเราจะรู้ได้อย่างไรว่าระบบกำลังค่อยๆ พังในจุดที่ยังไม่แสดง error
คลิป The Missing Layer After Launch จากช่อง AI Engineer หยิบประเด็นที่คนทำ AI product มักมองข้าม นั่นคือชั้นการปฏิบัติการหลัง launch หรือชั้นที่คอยเฝ้า ดูแล วิเคราะห์ และปิดวงจรการปรับปรุงอย่างต่อเนื่อง มุมนี้น่าสนใจมากสำหรับเจ้าของธุรกิจและคนทำงาน เพราะมันเตือนเราว่า AI ที่ใช้งานจริงไม่ใช่แค่เรื่อง prompt ดีหรือ model เก่ง แต่คือเรื่องการคุมคุณภาพหลังระบบออกไปเจอลูกค้าจริงด้วย
ถ้าธุรกิจไทยกำลังคิดจะเอา AI Agent ไปใช้กับงานขาย งานบริการลูกค้า งานจองคิว งานเอกสาร หรือ workflow ภายในองค์กร บทเรียนนี้แทบเลี่ยงไม่ได้เลย
สารบัญ
- Step 1: เริ่มจากยอมรับก่อนว่า Launch ไม่ใช่เส้นชัย
- Step 2: เข้าใจว่าทำไม AI Agent ถึงดูแลยากกว่าซอฟต์แวร์ทั่วไป
- Step 3: แยกให้ออกว่า “ทำเสร็จ” ไม่เท่ากับ “ช่วยได้จริง”
- Step 4: อย่าหวังพึ่ง unit test อย่างเดียว เพราะ production คือที่สอนเราว่าควร test อะไร
- Step 5: สร้าง agent สำหรับ “เฝ้าระบบ” ไม่ใช่มีแค่ agent สำหรับ “ให้บริการ”
- Step 6: ทำ Fast Loop ให้เจอปัญหาและออก PR ได้เร็วที่สุด
- Step 7: ใช้ Review Agent เพื่อกันการแก้ปลายเหตุ
- Step 8: สร้างมุมมองระดับระบบด้วย Session Analyzer
- Step 9: ใส่มุมมองผู้ใช้จริงผ่าน Computer Use Agent
- Step 10: เชื่อมทุกอย่างเป็นระบบเดียวที่คอยส่องตัวเอง
- Step 11: แปลงบทเรียนนี้เป็น Actionable Insights สำหรับธุรกิจ
- Step 12: Troubleshooting ปัญหาที่มักเจอเมื่อเริ่มใช้ AI Agent จริง
- Step 13: การต่อยอดที่น่าลองต่อ
- Step 14: สรุป Checklist ทั้งหมด
Step 1: เริ่มจากยอมรับก่อนว่า Launch ไม่ใช่เส้นชัย
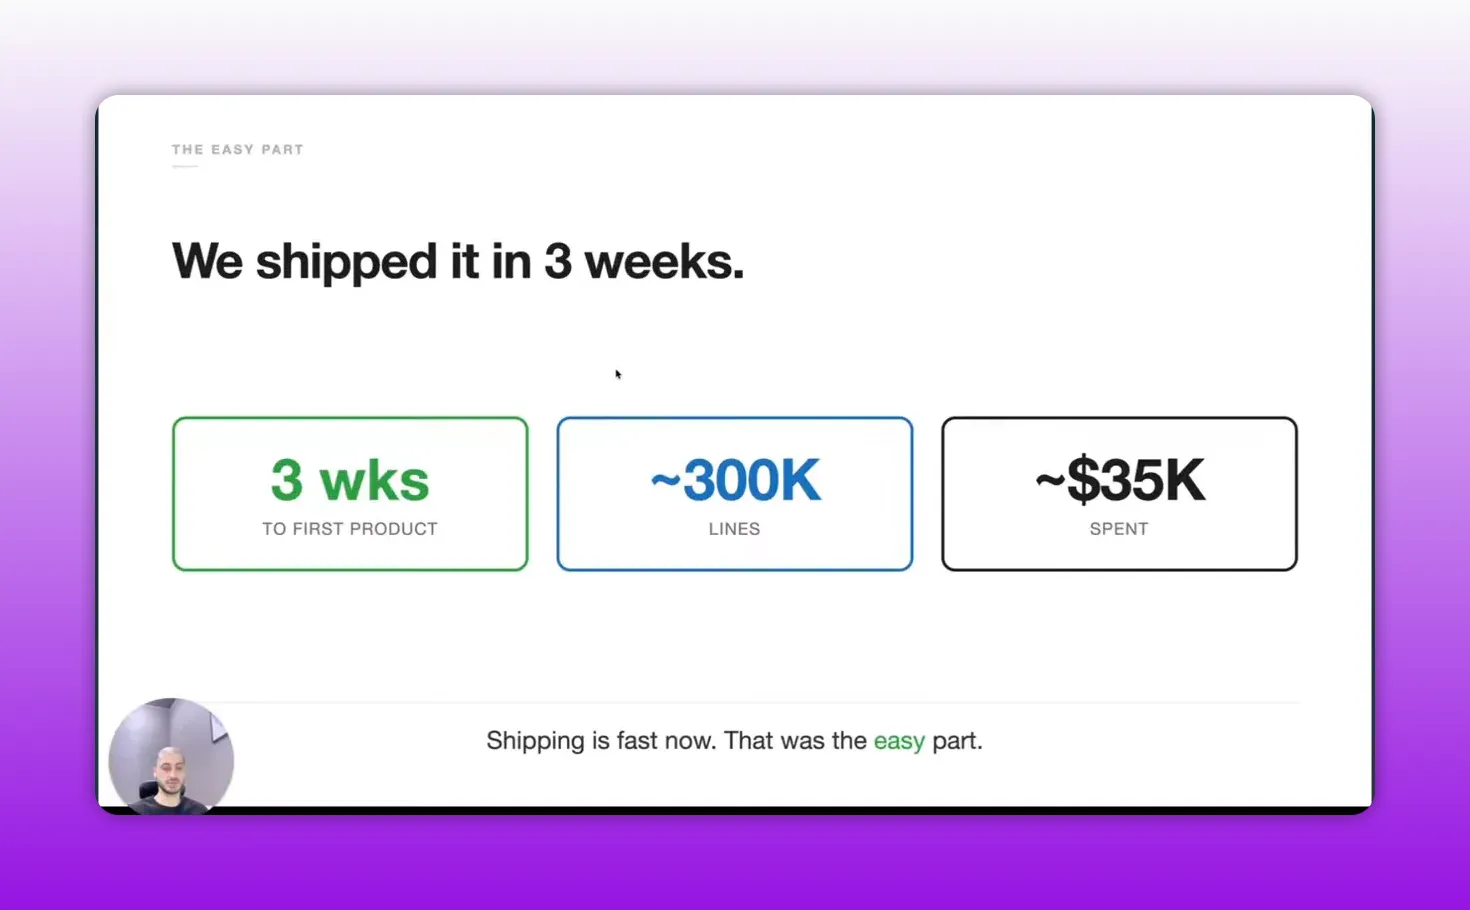
ใจความสำคัญที่สุดของคลิปคือ การส่งระบบขึ้น production กลายเป็นส่วนที่ง่ายที่สุดไปแล้ว เมื่อ model ดีขึ้น การสร้าง prototype เร็วขึ้น เขียนโค้ดได้เร็วขึ้น และต่อ tool ได้ง่ายขึ้น สิ่งที่ยากกว่าคือการตอบคำถามหลังบ้านว่า ระบบยังดีอยู่ไหม
นี่เป็นมุมที่หลายทีมพลาด โดยเฉพาะทีมที่เพิ่งเริ่มใช้ AI พอเดโมทำงานได้ ก็รีบวัดผลจากการเปิดใช้ แต่ลืมสร้าง feedback loop ที่จะทำให้รู้ว่าควรแก้อะไรต่อ ผลลัพธ์คือระบบดูเหมือนเดินได้ แต่ไม่มีใครตอบได้ชัดว่าให้คุณค่าจริงแค่ไหน
สำหรับธุรกิจไทย ความเสี่ยงนี้ชัดมาก เช่น
- AI ตอบลูกค้าได้เร็วขึ้น แต่ปิดการขายไม่ได้
- AI ช่วยทำใบเสนอราคาได้ แต่ตัวเลขบางครั้งผิด
- AI รับ requirement ได้ แต่หลุดเงื่อนไขสำคัญของลูกค้า
- AI สรุปเคสบริการลูกค้าได้ แต่สรุปผิดประเด็นจนทีมทำงานต่อพลาด
ระบบพวกนี้ไม่จำเป็นต้องล่มถึงจะถือว่าล้มเหลว บางครั้งมัน “ทำงานครบ” แต่ “ไม่ได้ช่วย” ซึ่งอันตรายกว่า เพราะปัญหาจะเงียบ
Step 2: เข้าใจว่าทำไม AI Agent ถึงดูแลยากกว่าซอฟต์แวร์ทั่วไป
ซอฟต์แวร์แบบเดิมมักมี flow ชัด ปุ่มชัด เส้นทางการใช้งานพอคาดเดาได้ แต่ agent ไม่เหมือนกัน มันไม่ได้มีแค่ไม่กี่ feature และไม่ได้เดินตามเส้นทางที่เขียนไว้ตายตัว ผู้ใช้ถามต่างกันนิดเดียว เส้นทาง reasoning หรือการเรียกใช้ tool ก็อาจเปลี่ยนไปแล้ว
นั่นทำให้การทดสอบก่อนปล่อยใช้งานมีขอบเขตไม่สิ้นสุด ทีมงานไม่มีทางเขียนทุกบทสนทนาที่เป็นไปได้ล่วงหน้าได้หมด
ในคลิปชี้จุดที่น่ากลัวมาก 3 เรื่อง
- ระบบไม่ deterministic คือ input คล้ายกันอาจได้ผลลัพธ์คนละทาง
- ความผิดพลาดซ่อนตัวเก่ง ระบบอาจรอดจากปัญหากลางทางได้เอง จน dashboard ดูปกติ ทั้งที่จริงมีบาดแผลอยู่
- พื้นผิวของ tool ใหญ่มาก ยิ่ง task ยาว ยิ่งมี terminal, service ภายนอก, sub-agent, code และ summary หลายชั้นเข้ามาเกี่ยว
ประเด็นนี้สำคัญกับธุรกิจที่ใช้ AI ต่อกับหลายระบบมาก เช่น CRM, ERP, ระบบสต๊อก, POS, Google Sheets หรือฐานข้อมูลภายใน เพราะการผิดพลาดไม่ได้อยู่แค่คำตอบสุดท้าย แต่อาจอยู่ในขั้นตอนย่อยระหว่างทาง
Step 3: แยกให้ออกว่า “ทำเสร็จ” ไม่เท่ากับ “ช่วยได้จริง”
นี่คือประโยคที่ควรติดไว้หน้าห้องประชุมทุกทีม AI ระบบอาจตอบกลับครบถ้วน เรียก tool สำเร็จ และปิด task ได้ทางเทคนิค แต่ยังทำให้ลูกค้าไม่พอใจได้อยู่ดี
ตัวอย่างในคลิปมาจาก use case ด้านท่องเที่ยว เช่น ลูกค้าขอให้จัด itinerary ระบบอาจสร้างทริปได้จริง แต่ไปจองบริการผิด คำนวณราคาผิด หรือหลุดข้อจำกัดสำคัญบางอย่าง จากฝั่งระบบอาจมองว่า success แต่จากฝั่งลูกค้าคือ fail เต็มๆ
ถ้าแปลมาเป็นธุรกิจไทย ภาพจะชัดมาก เช่น
- AI ฝ่ายขายตอบไว แต่แนะนำแพ็กเกจไม่ตรงความต้องการ
- AI ฝ่าย HR สรุปใบสมัครได้ แต่คัดคนผิดเพราะตีความ requirement เพี้ยน
- AI ฝ่ายบัญชีช่วยตอบคำถามเอกสาร แต่ดึงข้อมูลผิด version
จุดนี้ทำให้ metric แบบเดิมอย่าง error rate หรือ uptime ไม่พออีกต่อไป เราต้องมีตัวชี้วัดเชิงคุณภาพของบทสนทนาด้วย เช่น ระบบเข้าใจเจตนาหรือไม่ หลุด constraint หรือไม่ ทำให้ลูกค้าติดขัดหรือเปล่า
Step 4: อย่าหวังพึ่ง unit test อย่างเดียว เพราะ production คือที่สอนเราว่าควร test อะไร
คลิปพูดตรงมากว่า unit tests ช่วยได้แค่บางเสี้ยว ทีมอาจมี regex มี rule based checks หรือมี script จำลองบทสนทนา แต่นั่นยังเป็นเพียงชิ้นบางๆ ของปัญหาทั้งหมด
มุมนี้เราเห็นด้วยมาก แต่ขอเติมว่า ไม่ได้แปลว่า test ไม่มีค่า เพียงแต่ test สำหรับ AI Agent ต้องเปลี่ยนบทบาท จากเครื่องยืนยันว่า “ระบบดีแน่” ไปเป็นเครื่องมือกันความพังในส่วนที่เรารู้แล้วว่าควรระวัง
พูดอีกแบบคือ production จะเป็นครู มันจะบอกเราว่า edge case จริงหน้าตาแบบไหน แล้วค่อยเอาสิ่งนั้นกลับมาทำเป็น test เพื่อป้องกันไม่ให้พังซ้ำ
สำหรับองค์กรที่ยังไม่มีทีม AI เต็มตัว แนวคิดนี้แปลเป็นภาษาง่ายๆ ได้ว่า อย่ารีบตั้ง KPI ว่า AI ต้องแม่น 100% ตั้งแต่วันแรก ให้ตั้งระบบเรียนรู้จากเคสจริงให้เร็วกว่าแทน
Step 5: สร้าง agent สำหรับ “เฝ้าระบบ” ไม่ใช่มีแค่ agent สำหรับ “ให้บริการ”
หัวใจของคลิปคือ operating an agent is itself an agent problem ถ้าการใช้งานจริงมี log จำนวนมาก มี conversation จำนวนมาก และมี pattern ซ่อนอยู่จำนวนมาก มนุษย์อย่างเดียวตามไม่ทันอยู่แล้ว ดังนั้นทางออกคือใช้ agent มาช่วยเฝ้า agent อีกชั้น
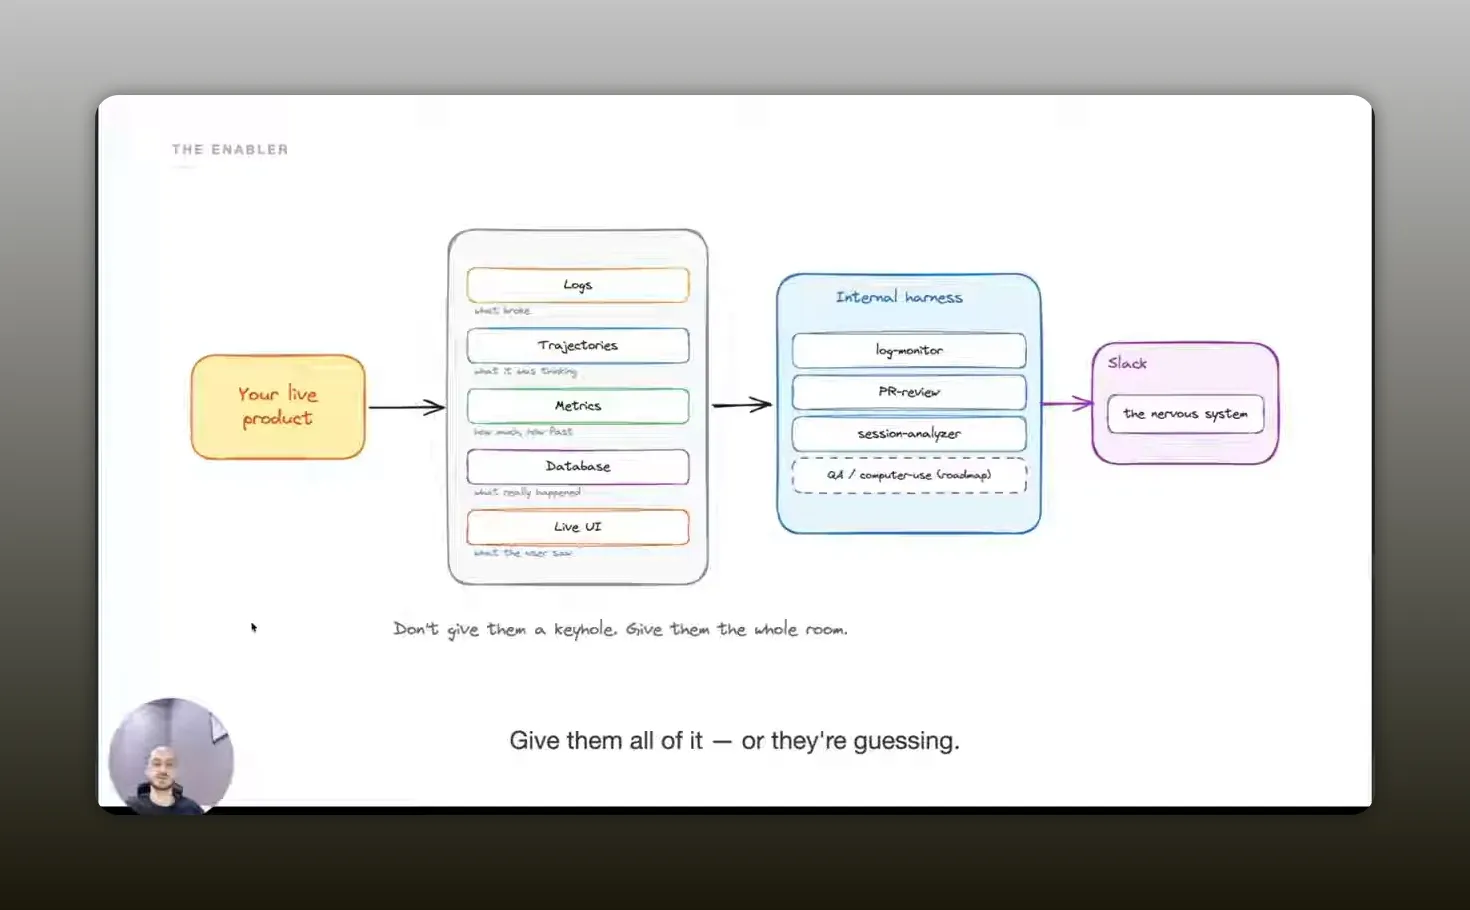
โครงสร้างที่เล่ามามี 4 บทบาทหลัก โดยภาพสถาปัตยกรรมระบุ QA/computer-use เป็น roadmap แม้คลิปมีช่วงเดโมบทบาทนี้ให้ดู
- log-monitor คอยตรวจ log และ trace เพื่อหาเรื่องที่ควรรีบแก้
- PR-review คอยวิจารณ์ pull request ว่าแก้ที่ต้นเหตุจริงหรือยัง
- session-analyzer คอยวิเคราะห์ภาพรวมของ conversation จำนวนมาก เพื่อดูสุขภาพระบบ
- QA หรือ computer-use agent คอยลองใช้งานระบบจากมุมผู้ใช้จริงผ่าน browser
นี่คือจุดที่หลายธุรกิจไทยอาจต้องปรับความคิด เดิมเราอาจมองว่า AI 1 ตัวมาแทนงาน 1 ส่วน แต่ระบบที่ใช้จริงมักต้องมี AI หลายบทบาททำงานร่วมกัน บางตัวคุยกับลูกค้า บางตัวคอยตรวจสอบ บางตัวคอยสรุป บางตัวคอยแจ้งเตือน
Step 6: ทำ Fast Loop ให้เจอปัญหาและออก PR ได้เร็วที่สุด
ในคลิป ระบบแรกที่สำคัญมากคือ log monitoring agent มันรันทุกชั่วโมงหรือทุก 15 นาที อ่าน trajectories และ log จากช่วงเวลาสั้นๆ เพื่อไล่ดูว่ามีผู้ใช้ติดอยู่ตรงไหน มีพฤติกรรมผิดปกติหรือไม่ แล้วสรุปปัญหาออกมาเป็น PR หรือแจ้งเตือนผ่าน Slack
ตรงนี้น่าสนใจมาก เพราะไม่ได้หยุดแค่ “เจอปัญหา” แต่ต่อยอดไปถึง “เสนอวิธีแก้” เลย ทำให้ feedback loop สั้นมาก
สิ่งที่ควรหยิบไปใช้กับธุรกิจคือแนวคิดเรื่อง local fixes หรือการซ่อมจุดเล็กให้ไว เช่น
- prompt บางชุดทำให้ AI ลืมถามข้อมูลสำคัญ
- mapping field ผิด ทำให้ดึงราคาจาก table ผิดคอลัมน์
- การเรียก tool บางลำดับทำให้สรุปก่อนงานเสร็จ
ถ้าทีมรอรวมปัญหาเป็นก้อนใหญ่ค่อยแก้ ระบบจะค่อยๆ เสียความน่าเชื่อถือ แต่ถ้า loop สั้น ทีมจะรู้สึกว่าระบบ “มีคนดูแลอยู่ตลอด”
Step 7: ใช้ Review Agent เพื่อกันการแก้ปลายเหตุ
อีกส่วนที่ลึกและดีมากคือการมี review agent แยกจากตัวที่สร้าง PR เพราะ agent ที่เจอปัญหามักอยากรีบแก้ และอาจติดกับดักว่ามองปัญหาจากมุมเดิมจนแก้แค่อาการ
review agent จึงเข้ามาตรวจอีกทีแบบมี context ใหม่ ถามคำถามสำคัญว่า
- นี่คือ root cause หรือแค่ symptom
- มี edge case อะไรที่ยังไม่ครอบคลุม
- ควรปิด PR นี้ทิ้งหรือส่งกลับไปแก้ต่อ
นี่เป็นบทเรียนที่องค์กรไทยใช้ได้ทันที ต่อให้ยังไม่มี agent review แบบเต็มรูปแบบ อย่างน้อยเราควรแยกขั้นตอน “คนทำ” กับ “คนตรวจ” ออกจากกันเสมอใน workflow ของ AI ไม่เช่นนั้นเราจะได้ patch เยอะ แต่คุณภาพไม่ขึ้น
Step 8: สร้างมุมมองระดับระบบด้วย Session Analyzer
Fast loop ดีสำหรับการไล่แก้ปัญหาเฉพาะหน้า แต่ยังไม่พอสำหรับการบริหารระบบในภาพใหญ่ จึงต้องมีอีกชั้นที่คอย zoom out ดูสุขภาพโดยรวมของระบบจากบทสนทนาจำนวนมาก
session analyzer ตามที่เล่าไว้จะให้คะแนนแต่ละ conversation ดู success rate ค่าใช้จ่าย จำนวน tool calls จำนวน summaries รวมถึง AI insights ที่พยายามเชื่อม pattern ว่าปัญหาแบบไหนเกิดซ้ำ และกระทบเซสชันใดบ้าง
จุดนี้มีค่ามากสำหรับเจ้าของธุรกิจ เพราะมันแปลงข้อมูลกองมหาศาลให้กลายเป็นคำตอบเชิงบริหาร เช่น
- ช่วงนี้คุณภาพระบบตกลงเพราะอะไร
- ปัญหาเกิดกับลูกค้ากลุ่มไหน
- ต้นทุน token สูงขึ้นเพราะ workflow ส่วนใด
- ความสำเร็จดีขึ้นจริงหรือแค่ระบบตอบไวขึ้น
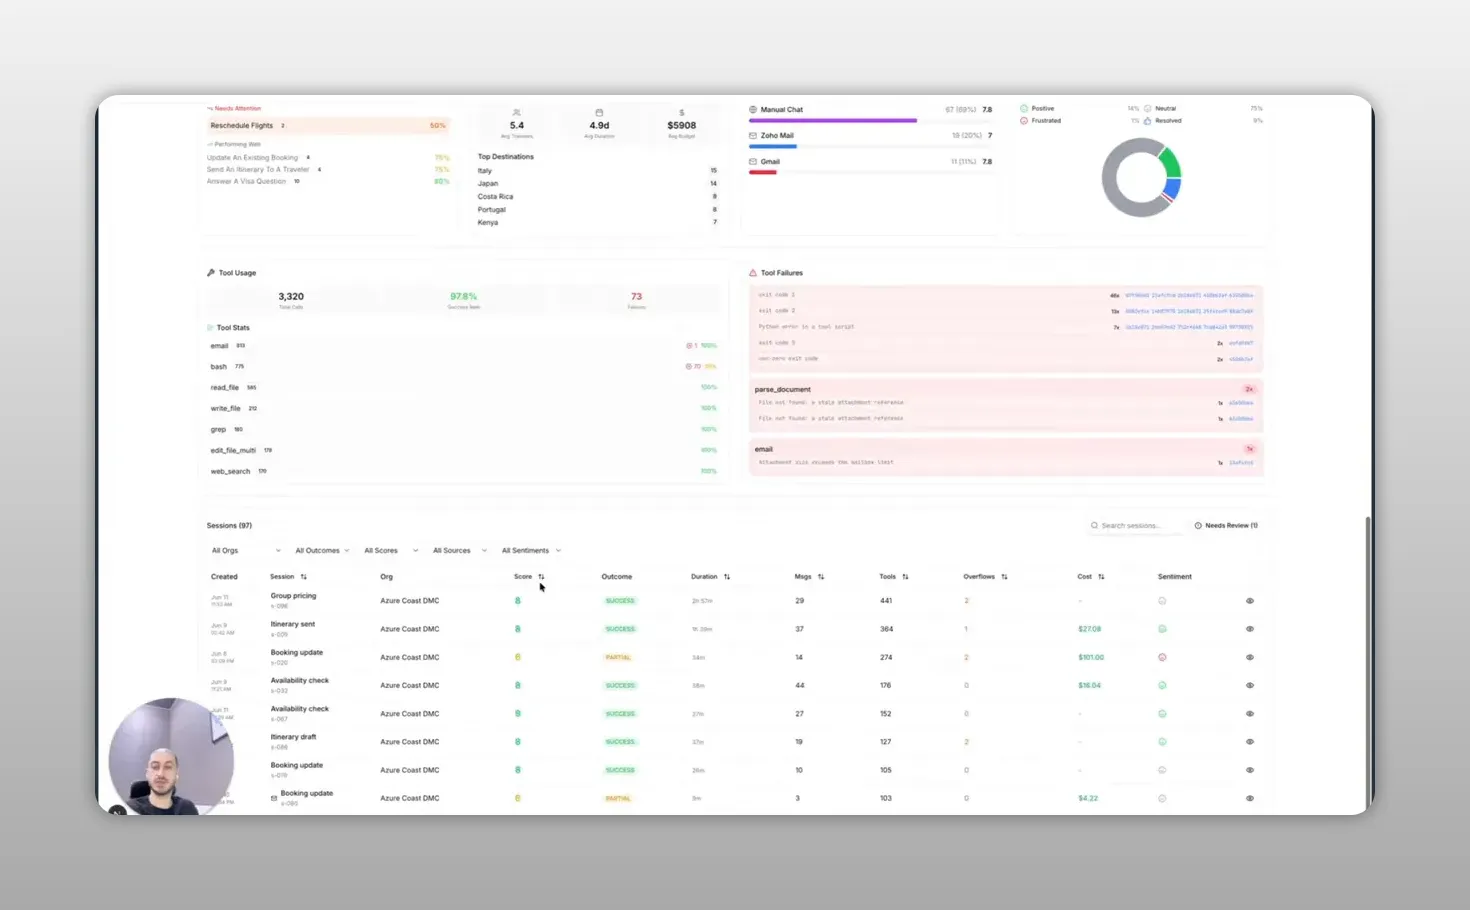
ถ้ามองในธุรกิจไทย ระบบลักษณะนี้เหมาะมากกับ use case ที่มี volume เช่น customer support, lead qualification, call summary, booking assistant หรือ helpdesk ภายในองค์กร เพราะผู้บริหารไม่สามารถเปิดอ่านทุกเคสเองได้ แต่ยังต้องการเห็นภาพว่าระบบกำลังดีขึ้นหรือแย่ลง
อย่างไรก็ตาม เราเห็นข้อจำกัดหนึ่งที่ควรระวัง คือถ้าคะแนนสุขภาพถูกออกแบบไม่ดี มันอาจสร้างความมั่นใจปลอมได้ ดังนั้น score ควรเชื่อมกับ outcome ทางธุรกิจจริง เช่น การปิดการขาย การแก้เคสจบ การลดเวลาทำงาน หรือความพึงพอใจ ไม่ใช่คะแนนสวยแต่ไม่ส่งผลต่อธุรกิจ
Step 9: ใส่มุมมองผู้ใช้จริงผ่าน Computer Use Agent
ทั้ง log และ session มีประโยชน์ แต่ยังเป็นมุมจากระบบ ไม่ใช่มุมจากการใช้งานหน้าเว็บจริง คลิปจึงเพิ่ม computer use agent ที่เปิด browser ล็อกอิน เข้าไปไล่ดูหน้าเว็บ ขยายข้อความ เปิด session และตรวจว่า UI หรือ artifact ต่างๆ ดูผิดปกติหรือไม่
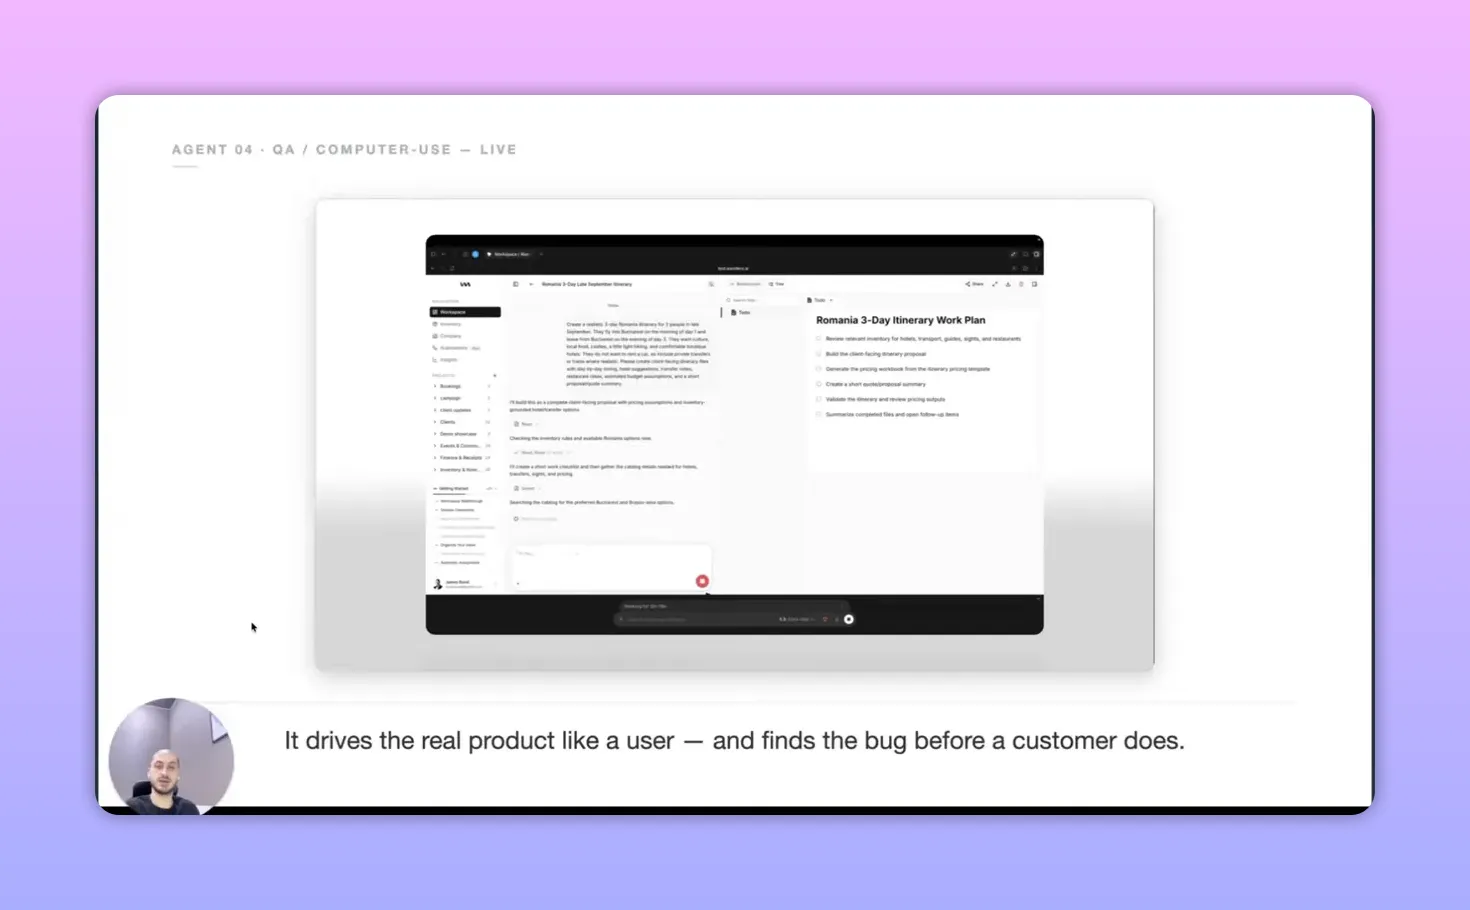
มุมนี้สำคัญกว่าที่คิด เพราะหลายครั้ง log ดูไม่มีปัญหา แต่ประสบการณ์ใช้งานจริงกลับติดขัด เช่น ปุ่มไม่ขึ้น ข้อมูลแสดงผิดช่อง ตารางล้น หรือข้อความสำคัญถูกซ่อนอยู่ใน UI
สำหรับธุรกิจที่ให้ AI ไปอยู่หน้า customer facing interface นี่แทบเป็นของจำเป็น โดยเฉพาะถ้า AI ส่งผลลัพธ์ออกมาในรูปแบบที่ต้องอ่านต่อหรือกดทำงานต่อ เช่น ใบเสนอราคา เอกสาร สรุปรายงาน หรือ itinerary
ข้อแลกเปลี่ยนคือวิธีนี้ใช้ token เยอะและช้ากว่าแบบอื่น จึงอาจไม่เหมาะกับการรันตลอดเวลา แต่เหมาะกับงานตรวจเชิงรุกเป็นรอบๆ หรือรันหลังมีการเปลี่ยนแปลงสำคัญ
Step 10: เชื่อมทุกอย่างเป็นระบบเดียวที่คอยส่องตัวเอง
ตอนท้ายคลิปสรุปคมมากว่า model อย่างเดียวไม่พอ สิ่งที่สร้างความได้เปรียบจริงคือ harness หรือระบบแวดล้อมที่คอยดูตัวเอง เข้าใจตัวเอง และปรับปรุงตัวเองได้
ประโยคนี้มีน้ำหนักในเชิงธุรกิจมาก เพราะถ้าทุกคนใช้ model ใกล้เคียงกัน ความต่างจะไม่ใช่อยู่ที่ใครเข้าถึง model ก่อน แต่อยู่ที่ใครสร้าง loop การเรียนรู้จาก production ได้ดีกว่า
สำหรับบริษัทไทย นี่อาจกลายเป็นข้อได้เปรียบระยะยาวมากกว่า prompt ลับหรือ feature ล้ำๆ ด้วยซ้ำ เพราะเมื่อระบบเรียนรู้จากข้อมูลจริงในงานจริงได้ต่อเนื่อง มันจะเก่งขึ้นในแบบที่ลอกกันยาก
ถ้าอยากอ่านภาพรวมเรื่องการทำระบบ observability เพิ่มเติม สามารถดูแนวคิดจาก OpenTelemetry และกรณีงานประเมินระบบ LLM จาก Anthropic Engineering เพื่อใช้เป็นกรอบคิดเสริมได้
Step 11: แปลงบทเรียนนี้เป็น Actionable Insights สำหรับธุรกิจ
- วัด outcome ไม่ใช่แค่วัดการตอบได้ ตั้ง metric ที่โยงกับงานจริง เช่น ปิดเคสจบ ลดเวลา ลดความผิดพลาด
- เก็บ log และ session ให้พร้อมตั้งแต่วันแรก เพราะถ้าไม่มีข้อมูลย้อนหลัง เราจะไล่ปัญหาไม่เจอ
- ทำ loop สั้นก่อน เริ่มจากระบบแจ้งเตือนปัญหารายวันหรือรายชั่วโมงก่อนสร้าง dashboard ใหญ่
- แยกบทบาทผู้เสนอแก้กับผู้ตรวจ จะใช้คนหรือ agent ก็ได้ แต่ห้ามรวมเป็นคนเดียวกันตลอด
- ตรวจจากมุมผู้ใช้จริงด้วย โดยเฉพาะระบบที่มี UI หรือมีหลายขั้นตอนหลังคำตอบของ AI
Step 12: Troubleshooting ปัญหาที่มักเจอเมื่อเริ่มใช้ AI Agent จริง
ปัญหา: AI ตอบครบ แต่ทีมงานบอกว่างานยังใช้ต่อไม่ได้
สาเหตุ: วัดผลจากสถานะ success ทางเทคนิค ไม่ได้วัด usefulness
วิธีแก้: เพิ่มเกณฑ์ตรวจเรื่องความถูกต้องของผลลัพธ์ปลายทาง ตรวจ constraint สำคัญ และเก็บตัวอย่างเคส fail มาเป็นเกณฑ์ประเมิน
ปัญหา: ไม่มี error แต่ลูกค้าร้องเรียนเรื่อยๆ
สาเหตุ: ความผิดพลาดซ่อนอยู่ในบทสนทนาหรือการตัดสินใจระหว่างทาง
วิธีแก้: ทำ session review รายสัปดาห์ ให้ agent หรือทีมสรุป pattern ซ้ำ และระบุ root cause ที่กระทบหลายเคส
ปัญหา: ทีมแก้บ่อย แต่ปัญหาเดิมกลับมาอีก
สาเหตุ: แก้ symptom ไม่ได้แก้ต้นเหตุ และไม่เอาเคสจริงกลับไปทำ test
วิธีแก้: หลังเจอปัญหาแต่ละครั้ง ให้สร้าง regression test หรือ checklist เฉพาะจุดทุกครั้ง
ปัญหา: ต้นทุน token พุ่งโดยไม่รู้ตัว
สาเหตุ: workflow ยาวเกินไป มี tool call หรือ summary ซ้ำซ้อน
วิธีแก้: ติดตาม cost ต่อ session วิเคราะห์เส้นทางที่ใช้ token มาก และตัดขั้นตอนที่ไม่สร้างคุณค่าทางธุรกิจ
ปัญหา: Dashboard ดูดี แต่คนใช้งานยังไม่ไว้ใจระบบ
สาเหตุ: metric ใน dashboard ไม่สะท้อนสิ่งที่ทีมหน้างานสนใจจริง
วิธีแก้: ออกแบบ score ร่วมกับทีมปฏิบัติการ ฝ่ายขาย หรือบริการลูกค้า เพื่อให้ตัวเลขตอบโจทย์งานจริง
Step 13: การต่อยอดที่น่าลองต่อ
- สร้าง scorecard เฉพาะธุรกิจ เช่น score ด้านความครบถ้วนของใบเสนอราคา หรือ score ด้านคุณภาพการคัด lead
- เพิ่มระบบจัดลำดับความสำคัญของปัญหา เพื่อให้ทีมแก้เฉพาะเคสที่กระทบรายได้หรือความเชื่อมั่นก่อน
- ทำ knowledge base จากเคส fail จริง เพื่อให้ทั้งคนและ agent เรียนรู้จากความผิดพลาดซ้ำได้เร็วขึ้น
Step 14: สรุป Checklist ทั้งหมด
- ☐ ยอมรับก่อนว่า launch คือจุดเริ่มต้น ไม่ใช่จุดจบ
- ☐ นิยาม metric ที่วัดผลทางธุรกิจ ไม่ใช่แค่ระบบตอบสำเร็จ
- ☐ เก็บ log, trace และข้อมูล session ให้ครบ
- ☐ ระบุเคสที่ “ทำเสร็จแต่ไม่ช่วย” ให้ชัด
- ☐ ใช้ production เป็นแหล่งเรียนรู้ว่าเราควร test อะไรเพิ่ม
- ☐ สร้าง fast loop สำหรับตรวจจับและแก้ปัญหาไว
- ☐ แยก agent หรือคนที่สร้าง PR ออกจากผู้ review
- ☐ ทำ dashboard สุขภาพระบบในภาพรวม
- ☐ ตรวจระบบจากมุมผู้ใช้จริงผ่าน UI หรือ browser flow
- ☐ เชื่อมทุกอย่างเป็น harness ที่คอยดูแลและพัฒนาระบบต่อเนื่อง
สรุปแล้ว ประเด็นใหญ่ของ The Missing Layer After Launch คือความจริงที่หลายทีมยังไม่อยากยอมรับ การทำ AI Agent ให้ใช้งานได้ไม่ใช่งานยากที่สุดอีกต่อไป งานที่ยากกว่าคือการทำให้มันน่าเชื่อถือหลังเปิดใช้จริง และนั่นต้องอาศัยระบบเฝ้าระวัง วิเคราะห์ และปิดวงจรการแก้ปัญหาให้สั้นที่สุด
ถ้าธุรกิจไทยอยากใช้ AI ไปไกลกว่าการทดลอง จุดที่ควรลงทุนไม่ใช่แค่ model หรือ prompt แต่คือชั้นการปฏิบัติการหลัง launch เพราะสุดท้ายแล้ว คนที่ชนะอาจไม่ใช่คนที่ build ได้เร็วที่สุด แต่คือคนที่เรียนรู้จาก production ได้เร็วที่สุด
