คลิป ReviewDebt: a practical framework for scoring every pull request จากช่อง AI Engineer โดย Sachin Gupta ตั้งคำถามว่า เมื่อ AI ช่วยผลิตโค้ดได้มากขึ้น ทีมตรวจทาน เข้าใจ และเชื่อถือการเปลี่ยนแปลงเหล่านั้นได้ทันหรือไม่ เขาเสนอ framework สำหรับให้คะแนนภาระตรวจ pull request หรือ PR
วิดีโอเผยแพร่วันที่ 12 กรกฎาคม 2026 เวลา 19:15:38 น. ตามเวลาไทย (12:15:38 UTC) วันที่นี้เป็นวันเผยแพร่วิดีโอ ไม่ใช่วันที่จัดงานบรรยาย ดูวิดีโอต้นทาง
ผู้พูดใช้คำว่า Review Debt เพื่อชี้ถึงภาระการตรวจที่อาจสะสม แม้ทีมจะเห็นจำนวน PR หรือความเร็วในการส่งงานเพิ่มขึ้น ข้อเสนอของเขาคือให้พิจารณาภาระตรวจควบคู่กับปริมาณงาน ไม่ใช้ throughput เพียงตัวเดียวตัดสินคุณภาพ
บทความนี้สรุปนิยาม สัญญาณ และแนวทางใช้คะแนนที่ผู้พูดเสนอ ตัวอย่างประยุกต์กับธุรกิจไทยเป็นข้อเสนอทางบรรณาธิการสำหรับนำไปทดลองต่อ ไม่ใช่ผลทดลองของผู้พูดหรือหลักฐานว่า framework ลดเวลาและความผิดพลาดได้แล้ว
เข้าใจก่อนว่า Review Debt คืออะไร
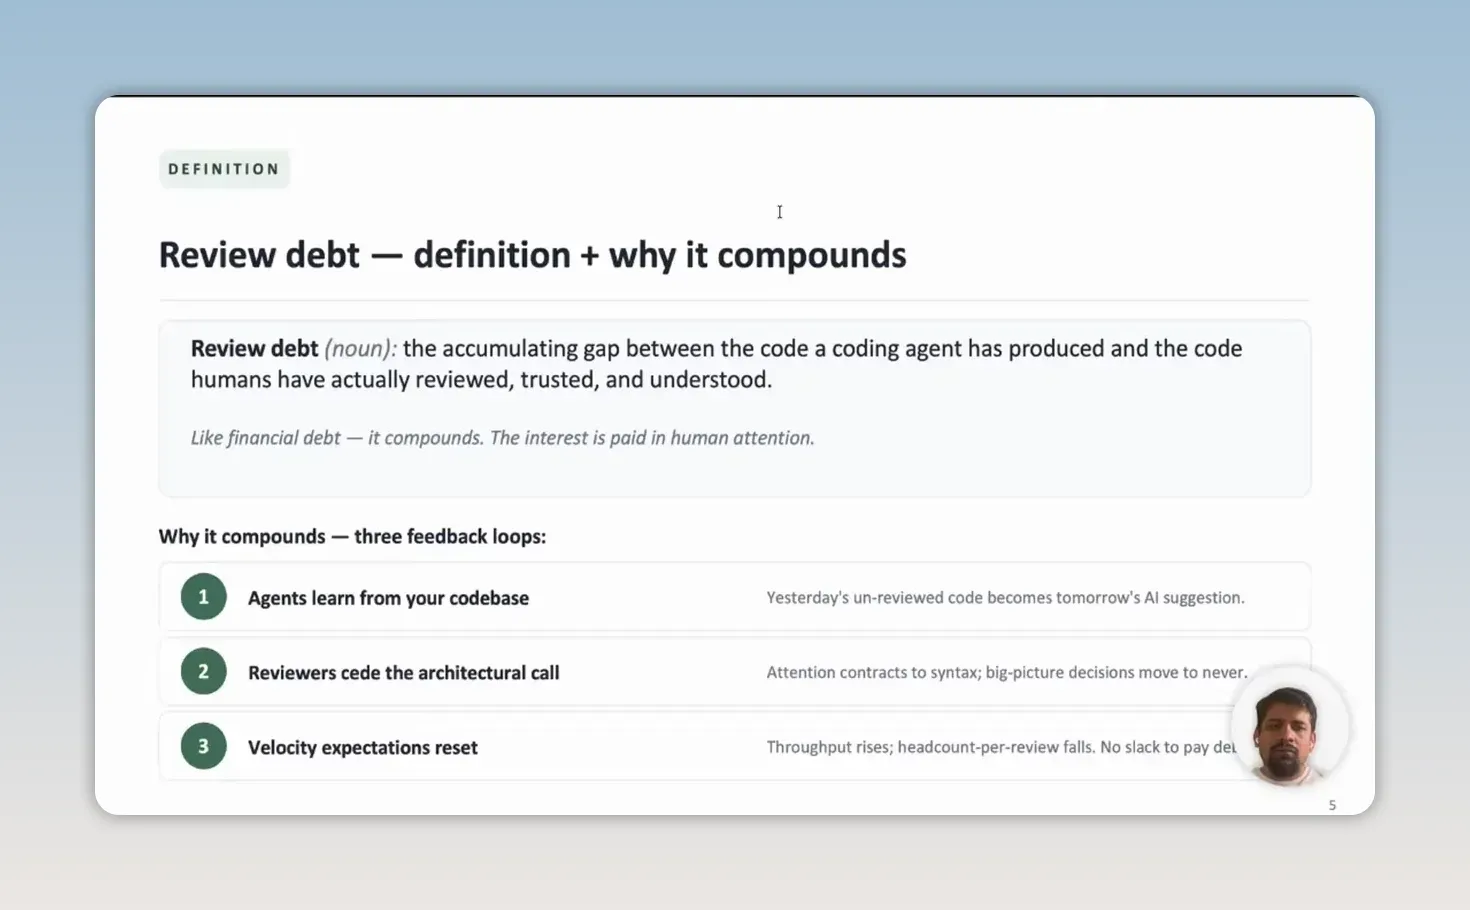
ตามนิยามของผู้พูด Review Debt คือช่องว่างที่ค่อยๆ สะสมระหว่าง โค้ดที่ agent ผลิตออกมา กับ โค้ดที่มนุษย์ได้ตรวจ เข้าใจ และเชื่อถือจริงๆ เขาเปรียบกับหนี้การเงินที่มีดอกเบี้ย โดยใช้ความสนใจและเวลาของคนเป็นภาพเปรียบเทียบ
ดอกเบี้ยของหนี้นี้ไม่ใช่เงิน แต่คือ ความสนใจของคน ทุกครั้งที่ทีม merge งานเร็วเกินกว่าจะตรวจได้ลึกพอ หนี้จะไม่หายไป มันจะเลื่อนไปอยู่ในรูปของเวลาที่ต้องใช้เพิ่มตอนแก้ bug ตอน onboarding คนใหม่ หรือตอนเกิด incident แล้วไม่มีใครแน่ใจว่าของเดิมถูกตัดสินใจไว้เพราะอะไร
ผู้พูดเสนอวงจร 3 แบบที่อาจทำให้ภาระนี้สะสมต่อกัน เป็นคำอธิบายเชิงแนวคิด ไม่ใช่สูตรอัตราการเติบโตของหนี้ที่ตรวจสอบแล้ว
- Agent อาจใช้ codebase เดิมผ่านการฝึก การค้นข้อมูล หรือ context จึงมีโอกาสนำรูปแบบที่ยังไม่ได้ตรวจให้ดีมาใช้ต่อ
- คน review เริ่มดูแค่ syntax หรือ bug ชัดๆ แต่ไม่แตะการออกแบบภาพใหญ่
- เมื่อผู้บริหารเห็นว่าทีมส่งงานได้ไวขึ้น ความคาดหวังก็เพิ่ม แต่จำนวนคนที่ช่วย review ไม่ได้เพิ่มตาม
ในมุมการประยุกต์กับธุรกิจไทย ทีม content หรือ operation ก็อาจทดลองแยกเวลาสร้างงานออกจากเวลาตรวจและแก้ เพื่อดูว่าการเพิ่ม output ส่งผลต่อภาระของทีมอย่างไร
ความเร็วในการผลิตยังไม่บอกภาระตรวจทั้งหมด
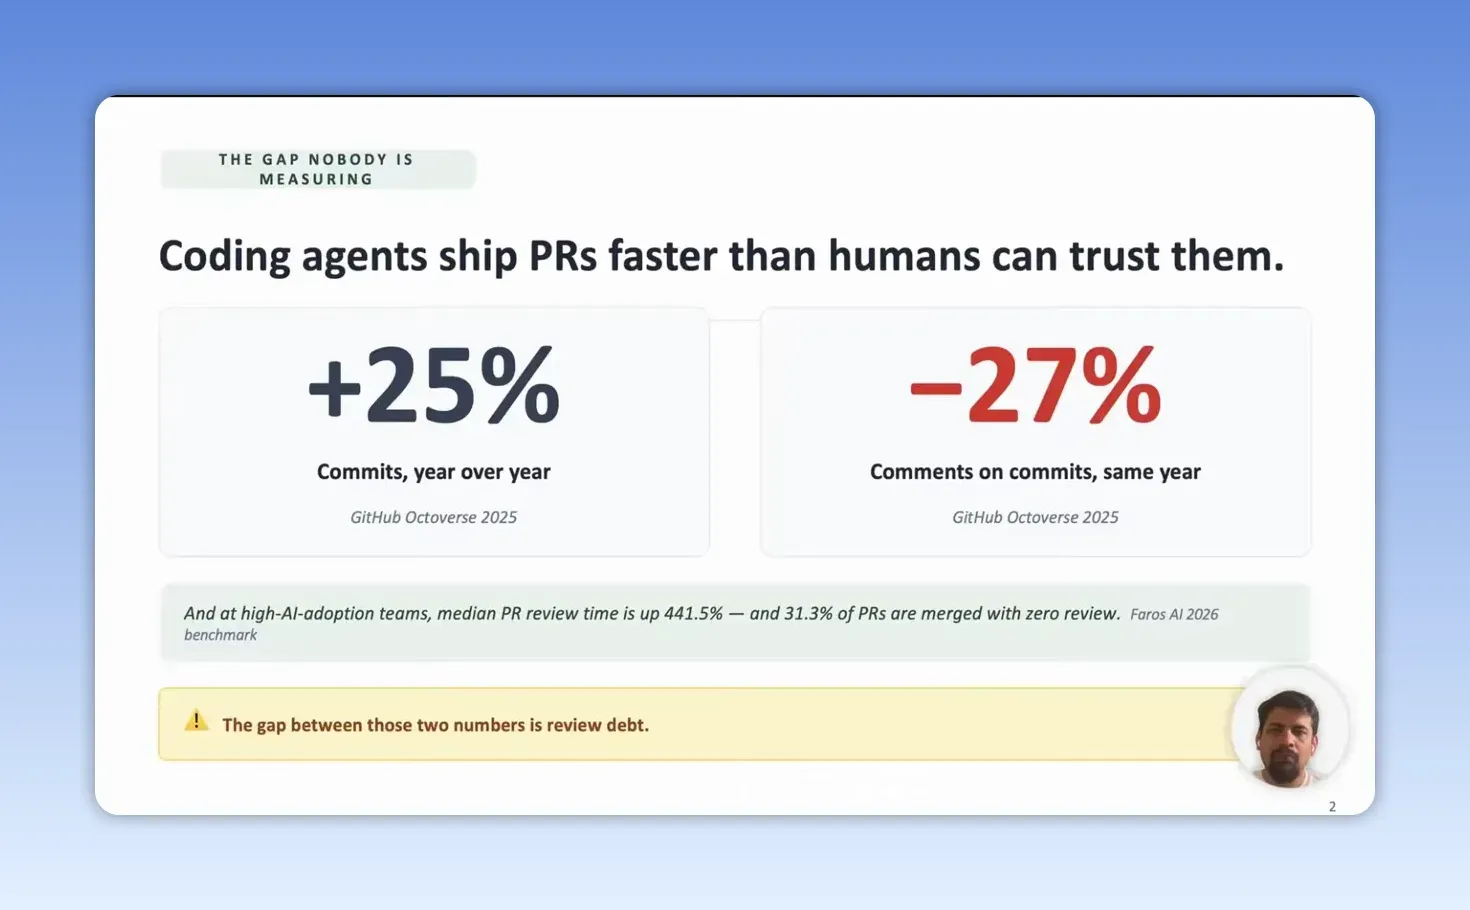
หลายทีมวัดผล AI ด้วยตัวเลขที่ดูดี เช่น PR ต่อคนเพิ่มขึ้น ขนาด PR โตขึ้น หรือเวลาจากเปิด PR ถึง merge ลดลง ปัญหาคือทั้งหมดนี้วัด ความเร็วในการผลิต แต่ไม่ได้วัด ความเร็วในการสร้างความเชื่อมั่น
ผู้พูดอ้างรายงานภายนอกประกอบข้อสังเกตเรื่องการผลิตโค้ดและกิจกรรม review แต่บทความนี้ยังไม่ได้ตรวจรายงานต้นฉบับ จึงไม่ใช้ตัวเลขเหล่านั้นยืนยันผลของ AI และจำนวนคอมเมนต์ก็เป็นเพียงตัวแทนที่ผู้พูดใช้แทนกิจกรรมตรวจ ไม่ใช่การวัดความลึกของ review โดยตรง
ข้อเสนอทางบรรณาธิการคือให้ทีมดูทั้งปริมาณงานและภาระตรวจ โดยเฉพาะเมื่อคนชุดเดียวกันรับหน้าที่ทำ ตรวจ และแก้ การเห็น output เพิ่มขึ้นเพียงอย่างเดียวยังไม่บอกว่าภาระรวมลดลง
รู้จัก 5 สัญญาณที่ใช้วัด Review Debt แบบจับต้องได้
ผู้พูดอธิบายว่า framework ใช้ 5 กลุ่มสัญญาณและ 10 การตรวจ ที่คำนวณแบบ deterministic จาก PR และ repository โดยไม่ใช้ LLM เป็นผู้ให้คะแนน จุดประสงค์คือให้ย้อนดูที่มาของคะแนนได้ ทั้งนี้ยังต้องทดสอบว่าสัญญาณและน้ำหนักเหมาะกับงานของทีมเพียงใด
Diff size and coupling
ดูว่ามีการเปลี่ยนกี่บรรทัด แตะกี่ไฟล์ และกระจายข้ามกี่ส่วนของระบบ ถ้า PR แผ่กว้างเกินไป คนตรวจต้องแบก mental model เยอะขึ้นมาก
ผู้พูดตั้งข้อสังเกตว่า agent อาจแก้หลายจุดที่เรียกใช้งานแทนการแก้ต้นเหตุ ทำให้ผู้ตรวจต้องทำความเข้าใจการเปลี่ยนแปลงข้ามไฟล์มากขึ้น ข้อนี้เป็นเหตุผลที่เขาใช้ประกอบการเลือกสัญญาณ ไม่ใช่คำยืนยันว่า agent ทุกตัวทำเช่นนี้
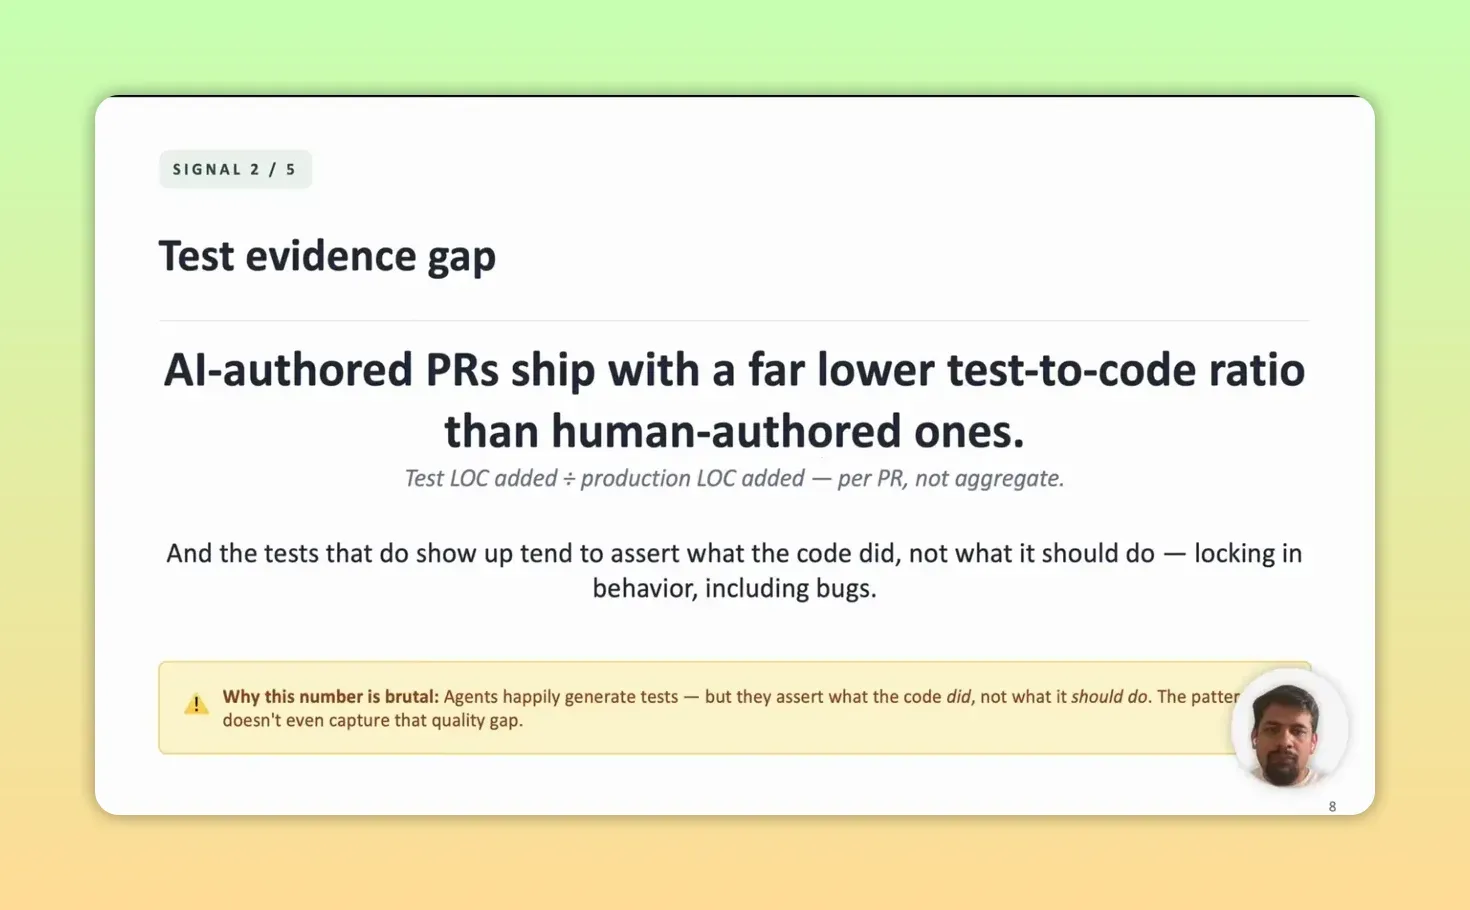
Test evidence gap
ดูสัดส่วนบรรทัด test ที่เพิ่มเทียบกับ production code ที่เพิ่ม ผู้พูดเตือนว่า test อาจยืนยันสิ่งที่โค้ด “กำลังทำอยู่” มากกว่าสิ่งที่โค้ด “ควรทำ” สัดส่วนนี้บอกเพียงว่ามี test เพิ่มเพียงใด ไม่ได้รับรองคุณภาพหรือความครอบคลุมของ test
จึงควรให้ผู้ตรวจอ่านว่า test ตรวจพฤติกรรมที่ต้องการจริงหรือไม่ การมี test หรือ CI ผ่านเพียงอย่างเดียวยังไม่ยืนยันว่าไม่มี bug
Directory and ownership spread
ดูว่าการเปลี่ยนแปลงแตะไฟล์ของกี่ทีมตาม code owners ผู้พูดใช้สัญญาณนี้สะท้อนจำนวนบริบทและการประสานงานที่ผู้ตรวจอาจต้องรับ ไม่ใช่สูตรคำนวณว่าต้นทุนเกินประโยชน์จาก AI เท่าใด
หากทีมยังไม่มี code owners ชัดเจน อาจทดลองบันทึกว่า PR ต้องอาศัยใครร่วมตรวจบ้าง เพื่อเห็นภาระการประสานงานก่อนเลือกตัวชี้วัดที่เหมาะกับทีม
AI authorship indicators
เช็กสัญญาณการใช้ AI เช่น co-author footer ชื่อ branch หรือข้อความใน PR body ผู้พูดย้ำว่าสัญญาณเหล่านี้ ไม่ใช่หลักฐานยืนยันผู้เขียน และไม่ควรตีความเป็นการกล่าวโทษการใช้ AI ในตัวอย่างของเขา สัญญาณ AI ยังมีส่วนต่อคะแนน จึงควรอ่านร่วมกับสัญญาณอื่นและวิธีคำนวณ ไม่ใช้เป็นเหตุลงโทษโดยลำพัง
ผู้พูดใช้ตัวอย่าง PR ที่มี AI ช่วยแต่คะแนนต่ำ เพื่อเสนอให้พิจารณาขอบเขตงาน หลักฐานทดสอบ และเหตุผลประกอบการเปลี่ยนแปลงด้วย
Evidence and rationale gaps
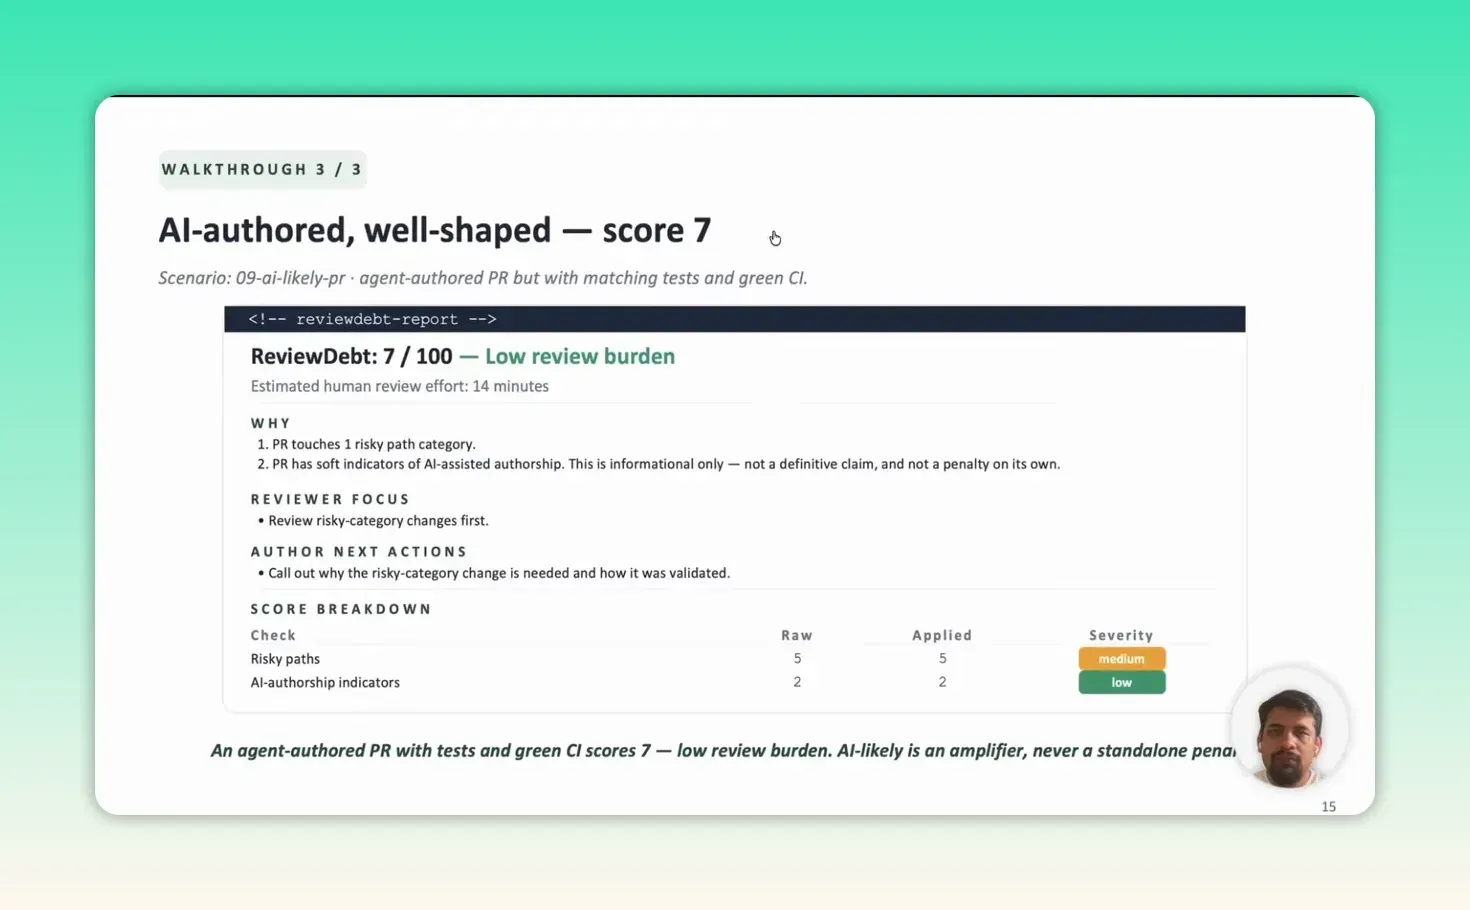
ดูว่า PR อธิบาย ทำไม หรือเล่าแค่ ทำอะไร ผู้พูดเทียบคำอธิบายที่คลุมเครือกับคำอธิบายที่มีอาการปัญหา การวินิจฉัย สิ่งที่แก้ และหลักฐานประกอบ เพื่อให้ผู้ตรวจมีบริบทสำหรับตัดสินใจ
เมื่อนำไปใช้กับงานธุรกิจ อาจเพิ่มคำอธิบายเหตุผลและหลักฐานในงานที่ส่งตรวจ แล้ววัดว่าช่วยลดการถามข้อมูลเพิ่มเติมได้หรือไม่
เปลี่ยน 5 สัญญาณให้เป็นคะแนนเดียวที่คุยกันได้
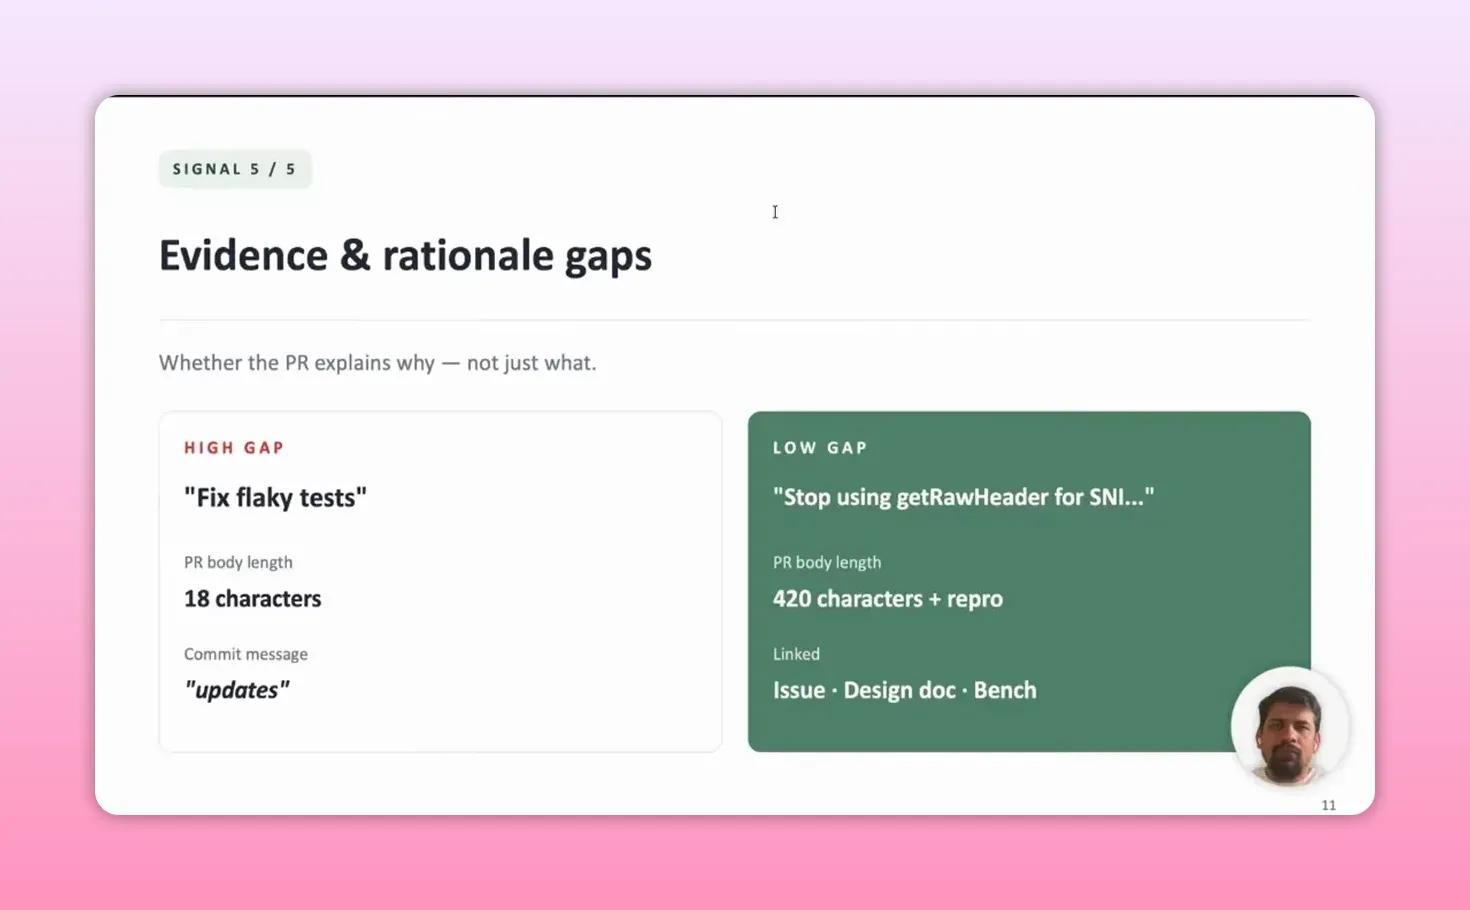
ผู้พูดเสนอให้รวมสัญญาณเป็นคะแนน 0 ถึง 100 โดยสไลด์แสดงเกณฑ์ตั้งต้นสี่ระดับดังต่อไปนี้ เป็นข้อเสนอที่ต้องสอบเทียบกับทีม ไม่ใช่มาตรฐานสากลหรือค่าความน่าจะเป็นที่จะเกิด bug
- 0 ถึง 25 Healthy
- 26 ถึง 50 Watch
- 51 ถึง 75 High debt
- 76 ถึง 100 Reject / refactor
ขอบเขตและชื่อระดับในสไลด์ต่างจากข้อความถอดเสียงที่บันทึกไว้ ซึ่งระบุ 0 ถึง 24 ว่าภาระต่ำ, 25 ถึง 49 ว่าปกติ, 50 ถึง 74 ว่าต้องมีหลักฐานเพิ่ม และ 75 ขึ้นไปว่าภาระสูง บทความนี้จึงแยกข้อมูลสองชุดไว้ และไม่ใช้เป็น policy เดียวกันโดยไม่สอบเทียบกับงานของทีม
ผู้พูดเสนอให้รันย้อนหลังกับ PR ที่ merge แล้ว 200 อัน และปรับน้ำหนักเทียบกับประสบการณ์ review ของทีม การสอบเทียบนี้เป็นจุดเริ่มต้นสำหรับประเมินความเหมาะสม ยังไม่ใช่การยืนยันความแม่นยำของ framework
สำหรับเจ้าของธุรกิจ นี่คือหลักคิดแบบเดียวกับ scorecard ในงานขายหรือการเงิน เราไม่ได้ต้องการตัวเลขที่สมบูรณ์ตั้งแต่วันแรก แต่ต้องการตัวเลขที่สื่อสารกันรู้เรื่อง และใช้ตัดสินใจได้ดีขึ้น
ดูรายงานตัวอย่าง PR สามแบบที่ผู้พูดนำเสนอ
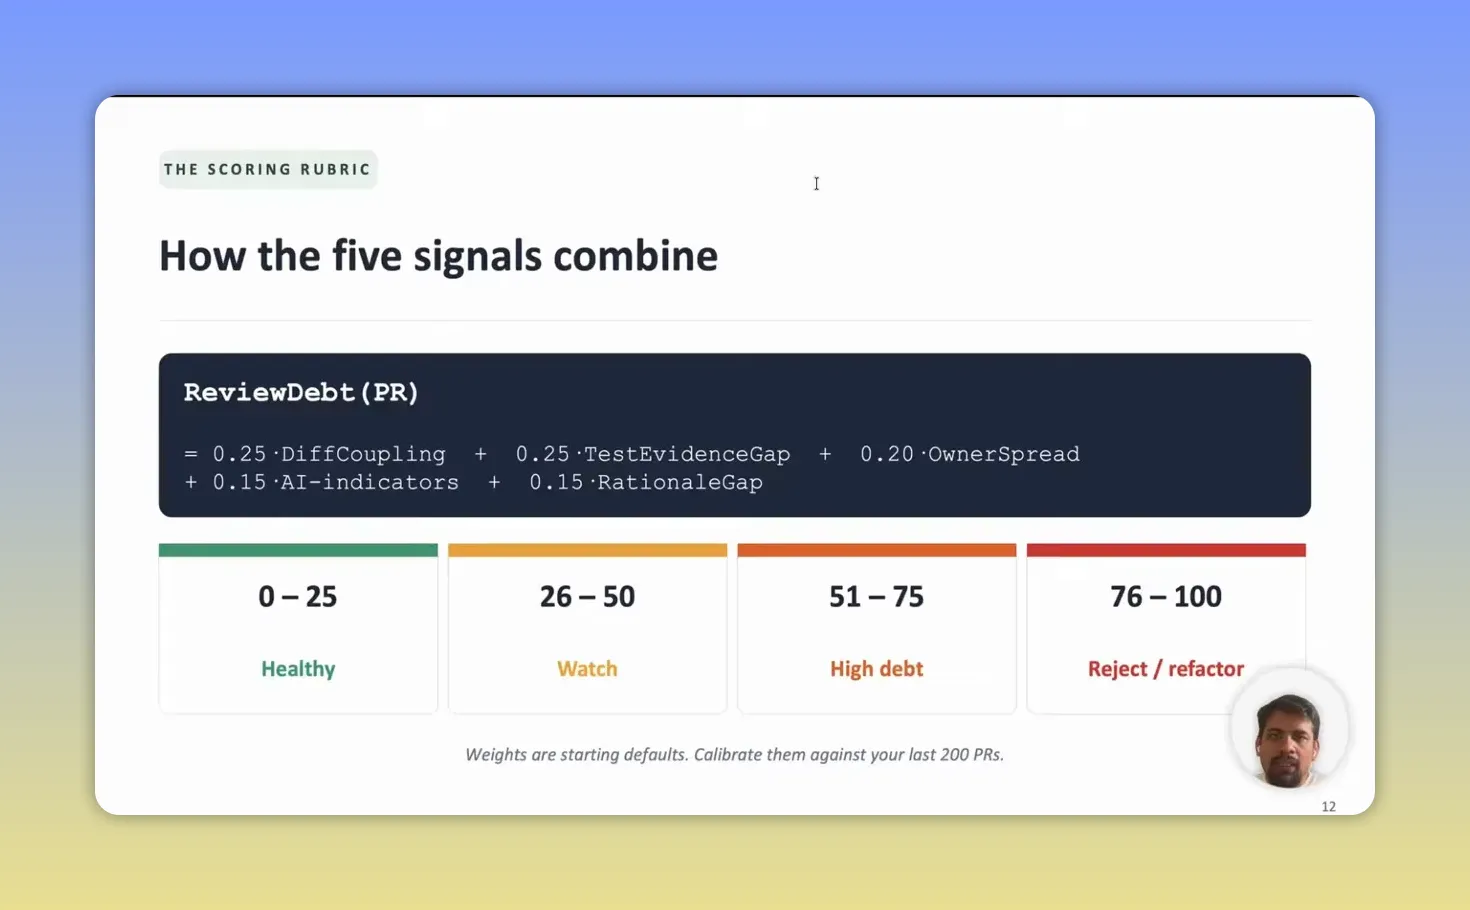
ผู้พูดระบุว่าไม่ได้รัน live demo แต่พาดูรายงานที่ scanner ให้คะแนน PR สามแบบ ตัวเลขต่อไปนี้จึงเป็นผลที่เขานำเสนอในคลิป ไม่ใช่ผลที่บทความนี้รันตรวจเอง และคะแนนต่ำไม่ได้รับรองว่าโค้ดถูกต้อง
กรณีที่ 1 PR สะอาด คะแนน 0
ในรายงานแรก ผู้พูดแสดงคะแนน 0 จาก 100 โดยไม่มีการตรวจใดส่งสัญญาณเตือนตามกฎของ scanner รายงานจึงสั้น ข้อนี้บอกผลของกฎที่ใช้ในตัวอย่าง ไม่ได้ยืนยันว่า PR ไม่มีความเสี่ยง
กรณีที่ 2 PR ที่ต้องมีหลักฐานเพิ่ม คะแนน 60
ในรายงานตัวอย่าง ผู้พูดแสดงคะแนน 60 จาก 100 พร้อมป้าย Needs evidence โดยอธิบายสัญญาณหลายด้าน เช่น diff ใหญ่ เหตุผลไม่ชัด และ test ไม่พอ นี่คือป้ายในรายงานตัวอย่าง ไม่ใช่ชื่อระดับในสไลด์เกณฑ์ตั้งต้น สัญญาณ AI เป็นส่วนหนึ่งของรายงาน แต่ไม่ใช่เหตุผลทั้งหมดของคะแนน
รายงานไม่ได้ให้แค่คะแนน แต่แสดงว่าอะไรทำให้คะแนนสูง reviewer ควรดูอะไร และ author ควรแก้อะไร เป็นโครงสร้างที่ช่วยให้ทีมใช้คะแนนเริ่มบทสนทนาเรื่อง review ได้
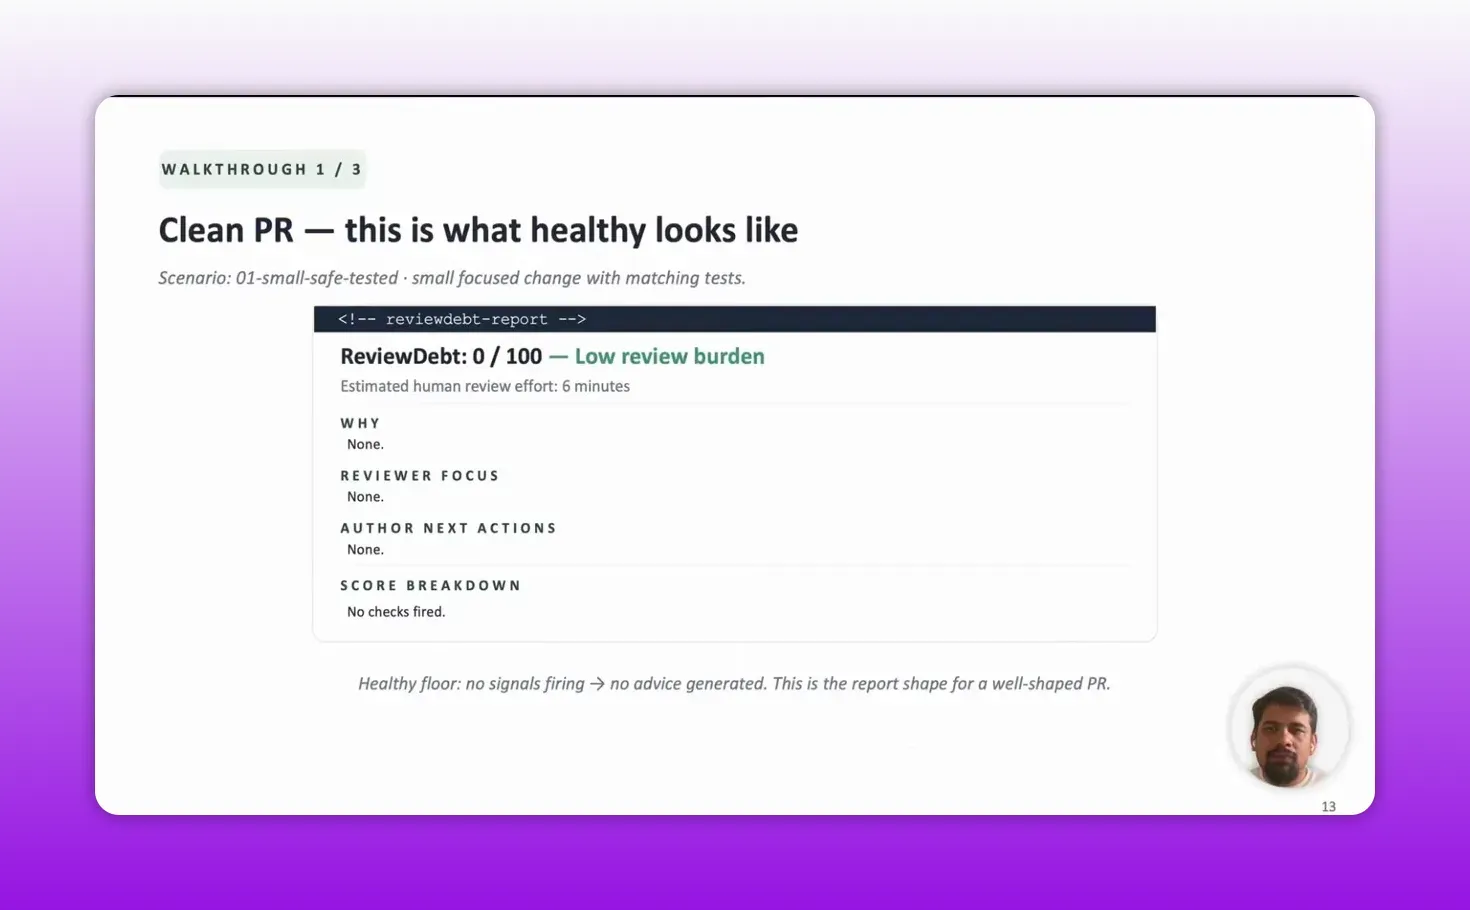
กรณีที่ 3 PR จาก AI ที่จัดรูปดี คะแนน 7
ในรายงานที่สาม ผู้พูดแสดงคะแนน 7 และอธิบายว่ามี test, CI ผ่าน และเรียกส่วนเสี่ยงไว้ในคำอธิบาย PR เขาใช้ตัวอย่างนี้ประกอบข้อเสนอให้ดูรูปแบบของการเปลี่ยนแปลงด้วย ไม่ตัดสินคุณภาพจากการมี AI ช่วยเพียงอย่างเดียว
ข้อเสนอที่นำไปทดลองกับทีมได้คือกำหนดมาตรฐานเรื่องขอบเขตงาน หลักฐาน และคำอธิบายให้ชัด แล้วใช้มาตรฐานเดียวกันกับงานที่มีหรือไม่มี AI ช่วย
อ่านสัญญาณระดับทีมให้เป็น ไม่ใช่ดูแค่ราย PR
ผู้พูดรายงานการสแกน PR ข้าม repository และตีความว่าปริมาณกับความซับซ้อนของการเปลี่ยนแปลงควรถูกพิจารณาควบคู่กับสัญญาณ AI authorship ข้อสังเกตนี้เป็นการตีความจากข้อมูลที่เขานำเสนอ ไม่ใช่หลักฐานแยกสาเหตุของ review burden ในทุกทีม
ชุดข้อมูลที่เขาระบุมี 3 public repos รวม 524 PR แต่ไม่ได้ระบุชื่อ repo ในช่วงที่บรรยาย ส่วนเวลาตรวจเป็นค่าประเมินจาก scanner จึงไม่ควรอ่านเป็นชั่วโมงทำงานจริงที่จับเวลาแล้ว บทความนี้ไม่ใช้ตัวเลขชั่วโมงดังกล่าวยืนยันต้นทุนของทีม
ในมุมการประยุกต์ ทีมอาจติดตามเวลาตรวจจริงควบคู่กับคะแนนและจำนวน PR เพื่อดูว่าภาระงานไปอยู่กับใคร และแยกค่าประเมินจากเวลาที่เกิดขึ้นจริง
ใช้หลัก 5 ข้อเพื่อลด Review Debt ตั้งแต่ต้นทาง
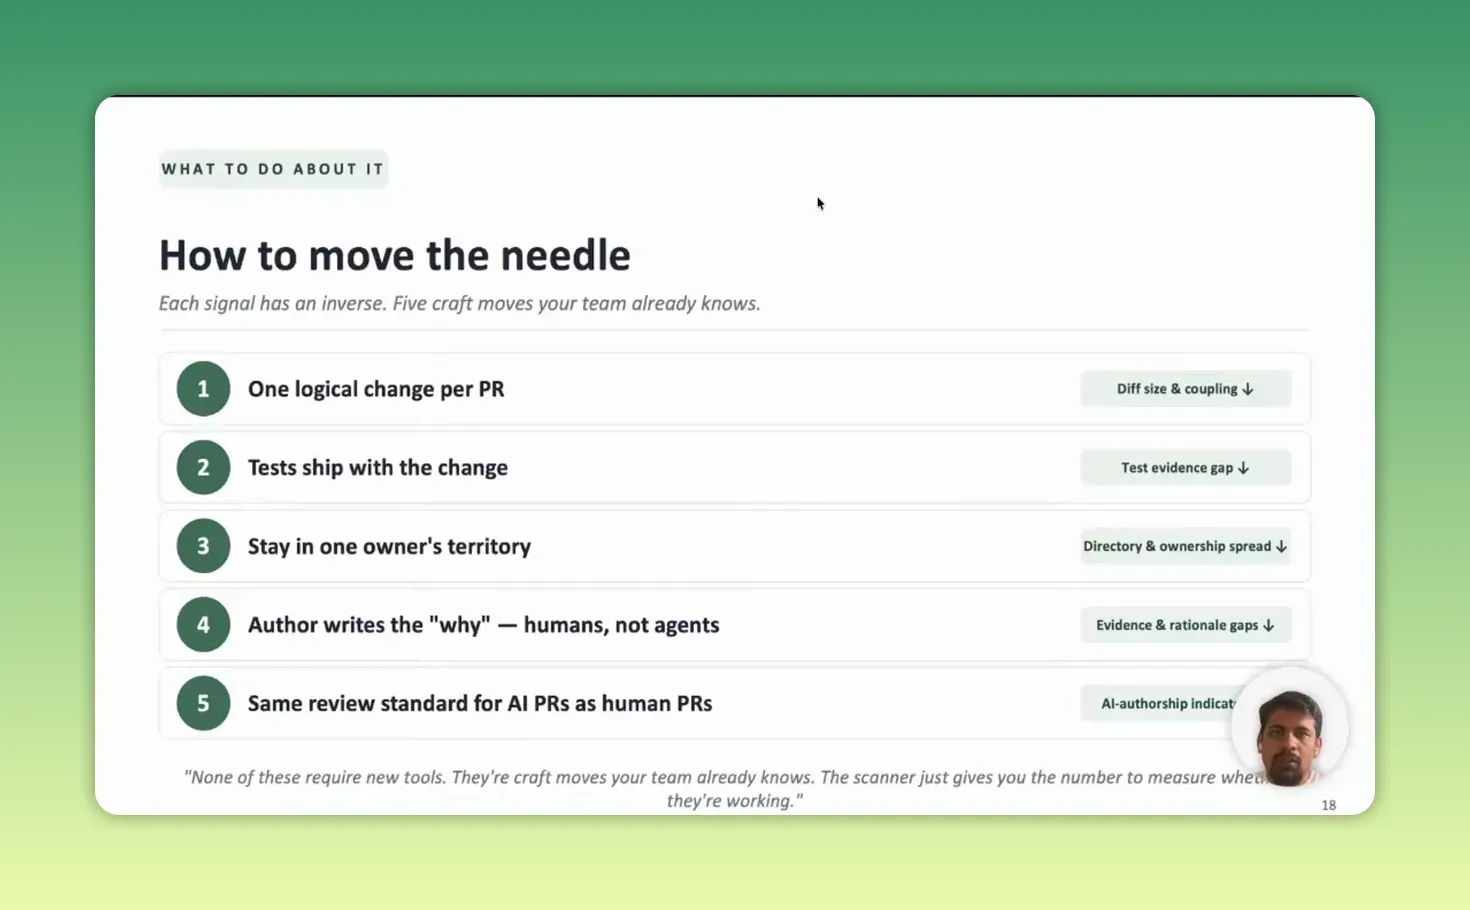
ผู้พูดเสนอวิธีลดภาระ review จากต้นทาง 5 ข้อ ให้ทีมเลือกนำไปทดสอบกับ workflow ของตน
- หนึ่ง PR ต่อหนึ่ง logical change ไม่จำเป็นต้องเล็กทุกครั้ง แต่ต้องมีขอบเขตเดียว
- ส่ง test มาพร้อมการเปลี่ยนแปลง และให้คนยืนยันว่า test ตรวจสิ่งที่ควรเกิด ไม่ใช่สิ่งที่เกิดอยู่แล้ว
- อยู่ใน owner territory เดียวให้มากที่สุด ถ้างานข้ามทีม ให้แยกเป็น PR ตามทีม
- ให้คนเขียนอธิบาย why เอง ไม่โยนให้ agent เขียน PR body ทั้งหมด
- ใช้มาตรฐานเดียวกันกับทุก PR ไม่ผ่อนเพราะเป็นงานจาก AI
ในมุมการประยุกต์กับงานเอกสาร การตลาด หรือการวิเคราะห์ข้อมูล อาจให้ผู้รับผิดชอบยืนยันเหตุผลและหลักฐานของงานที่ส่งต่อ เป็นวิธีเพิ่มบริบทให้ผู้ตรวจ ไม่ใช่การรับประกันว่างานจะถูกต้อง
เริ่มใช้ในทีมแบบไม่ปั่นป่วนเกินไป
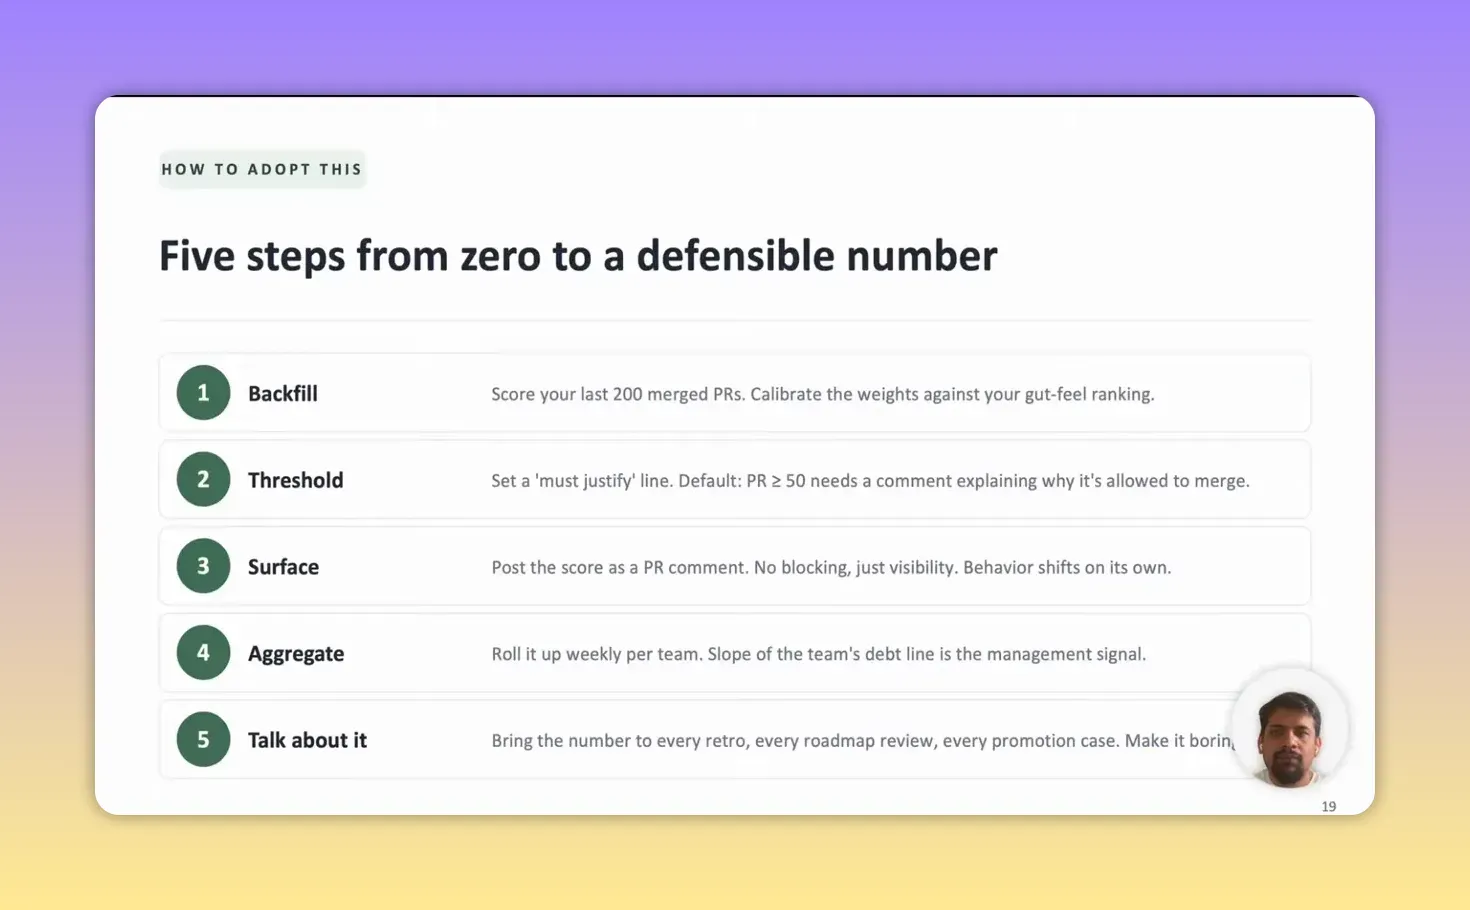
framework นี้ไม่ได้บอกให้รีบสร้างระบบใหญ่ แต่ให้เริ่มจากการทำของง่ายก่อน
- เอาคะแนนนี้ไปรันย้อนหลังกับ PR ที่ merge แล้วประมาณ 200 อัน
- ตั้ง threshold เช่น 50 ขึ้นไปต้องมีคำอธิบายจาก author เพิ่ม
- แสดงคะแนนในทุก PR เพื่อให้ทีมมองเห็น แต่ยังไม่ต้อง block
- รวมผลเป็นรายสัปดาห์ แยกตามทีม
- เอาตัวเลขนี้เข้าไปคุยใน retrospective หรือ meeting ที่เกี่ยวกับคุณภาพงาน
ลำดับนี้เป็นข้อเสนอของผู้พูดสำหรับเริ่มทดลอง ให้ทีมเห็นและคุยถึงคะแนนก่อนใช้เป็นกฎบังคับ ควรประเมินทั้งความเหมาะสมของคะแนนและภาระที่ขั้นตอนใหม่เพิ่มขึ้น